
一个 144.3M 参数的小模型,被开发者拿来回答 Agent 的选择题;另一个 TypeScript 编译器移植项目,作者披露累计消耗了超过 42 万美元的标价 token。两件事放在一起,反差挺大。同样是 AI 编程,有人在减少大模型出场次数,有人在让模型连续干上几周。10 月 8 日这份 AI 热点日报,我们聊六条线,从决策路由、交互界面到代码验收、权限和状态,看看程序员该把预算与注意力放在哪。
一、Agent 降本 95%,真要靠换一个更便宜的模型吗?
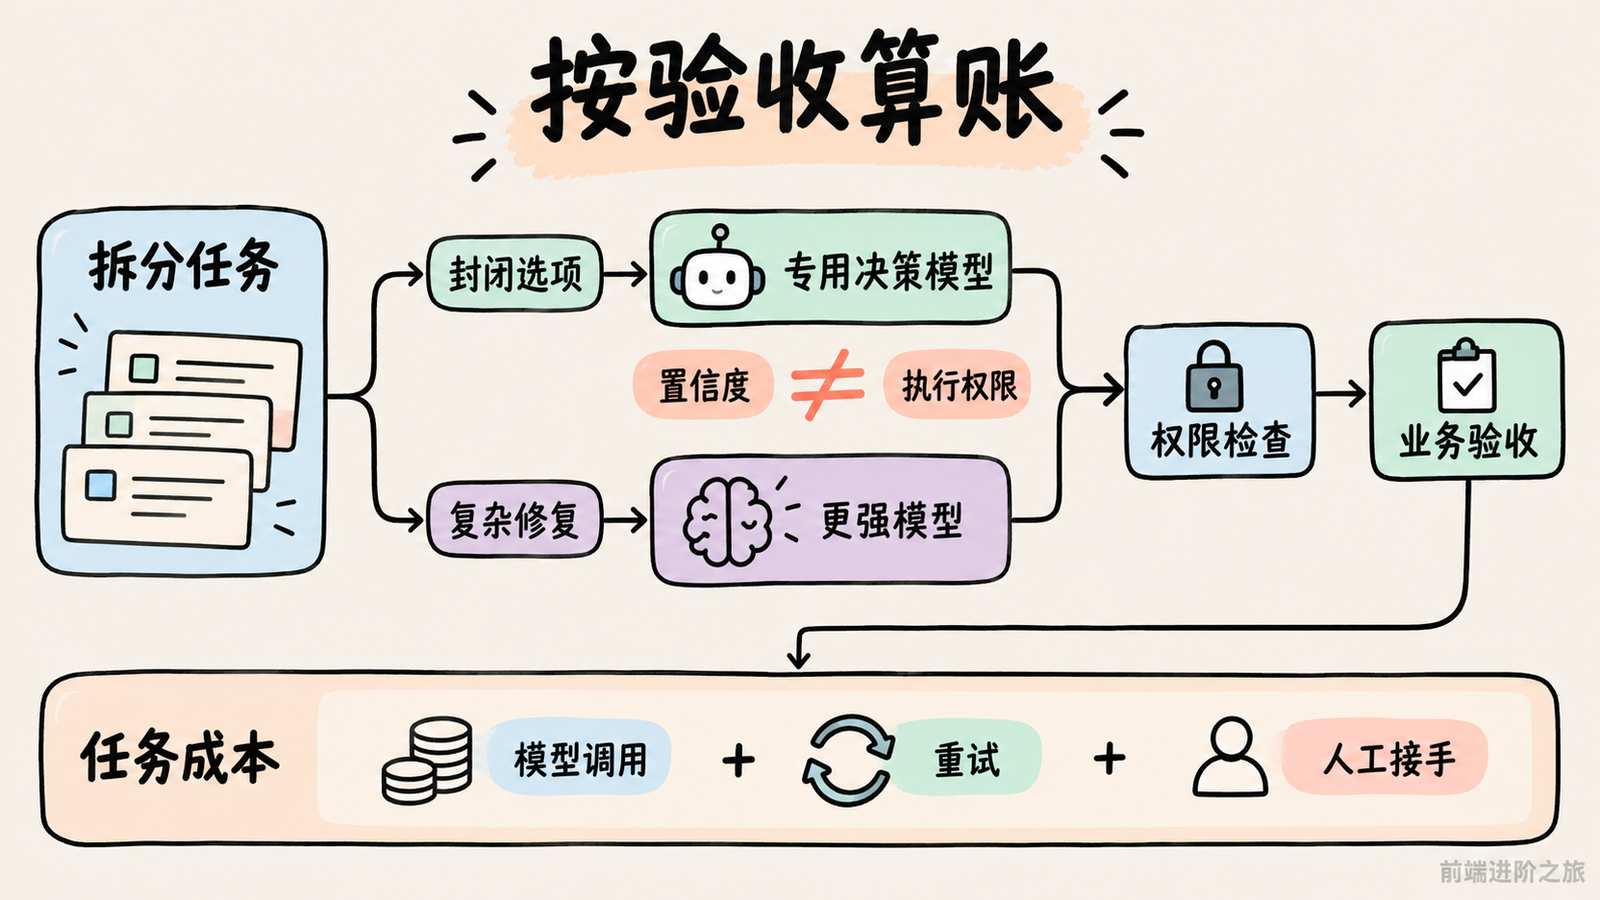
先说结论,我会先拆任务,再选模型。
今天最有意思的案例,是 Phocinae-Largha-150M-v1。按照开发者的介绍,它只有 144.3M 参数,不生成聊天文本,而是接收状态和一组带类型的问题,返回选项判决与置信度。问题可以是是否允许、选哪个工具,或者打多少分。作者给出的 GPU 决策延迟 p50 为 18.6 毫秒,纯 CPU 推理约 1.5 秒,并以 Apache-2.0 协议开源。dev.to
但标题里的「承担 82% 决策调用、降本 95%」,我会带着问号读。给到的正文摘录没有展开这两个数字对应的工作负载、调用次数和账单算法。它们可以作为作者项目的线索,不能直接拿去预测你们公司的收益。
真正值得借鉴的是任务拆分方式。路由只有几个候选,业务状态已经结构化,输出也不需要解释,这种工作确实适合单独评估专用模型。可要是判断依赖长篇上下文,或者选项本身不完整,小模型仍可能非常自信地选错。
同一天,Anthropic 的 Haiku 5.5 发布说明也把重点放在高吞吐、成本敏感的重复任务,包括摘要、分类、数据库查询,以及给更大模型担任编程子 Agent。官方称平均运行成本相比 Haiku 4.5 降低约 75%,还加入了可调节的 effort 设置。Anthropic
这两件事放在业务里,可以形成两条不同路线。封闭选项的判断交给专用决策模型;需要生成短文本、读工具结果的任务,再考虑便宜的通用模型。复杂修复继续留给能力更强的候选。多一层路由会增加维护成本,所以低调用量的小应用,直接用一个模型也可能更省事。
这里有个坑,模型返回的置信度不等于业务允许执行的概率。尤其涉及删除、发布和支付,硬性权限检查仍要由程序完成,不能交给一个分数决定。
省钱要看完成同一个任务花了多少钱。
Sonnet 5.5 的评测正好给了反例。报道列出的输入、输出单价都是 Opus 5.5 的一半,但其引用的 Artificial Analysis 测试在最大努力程度下,Sonnet 每任务成本为 7.67 美元,Opus 为 5.98 美元。另一位作者则用三个任务、每个模型各五次运行来观察成本与一致性。这些结果只覆盖各自的任务和设置,不能推出一个通用赢家。The New Stack
你要是也在做 Agent,我会拿最近 20 个真实任务,固定工具权限和验收条件,比较直接调用大模型与分层路由。把重试、升级到大模型、人工接手都记进账单,当天就能看出低价是否被失败成本吃掉。
二、GPT-6 把回答变成界面,前端还该只做聊天框吗?
GPT-6 的几条消息可以合起来看。量子位报道,付费用户从 10 月 7 日起陆续获得 Sol,免费与 Go 用户从 10 月 8 日起陆续获得 Luna。新版 ChatGPT 能根据问题生成图表、按钮和交互工具,也能在继续思考或调用工具时先呈现部分回答。量子位
The Decoder 的报道同样提到了图形、表单和对话内小工具,例如计算器与小游戏。The Decoder
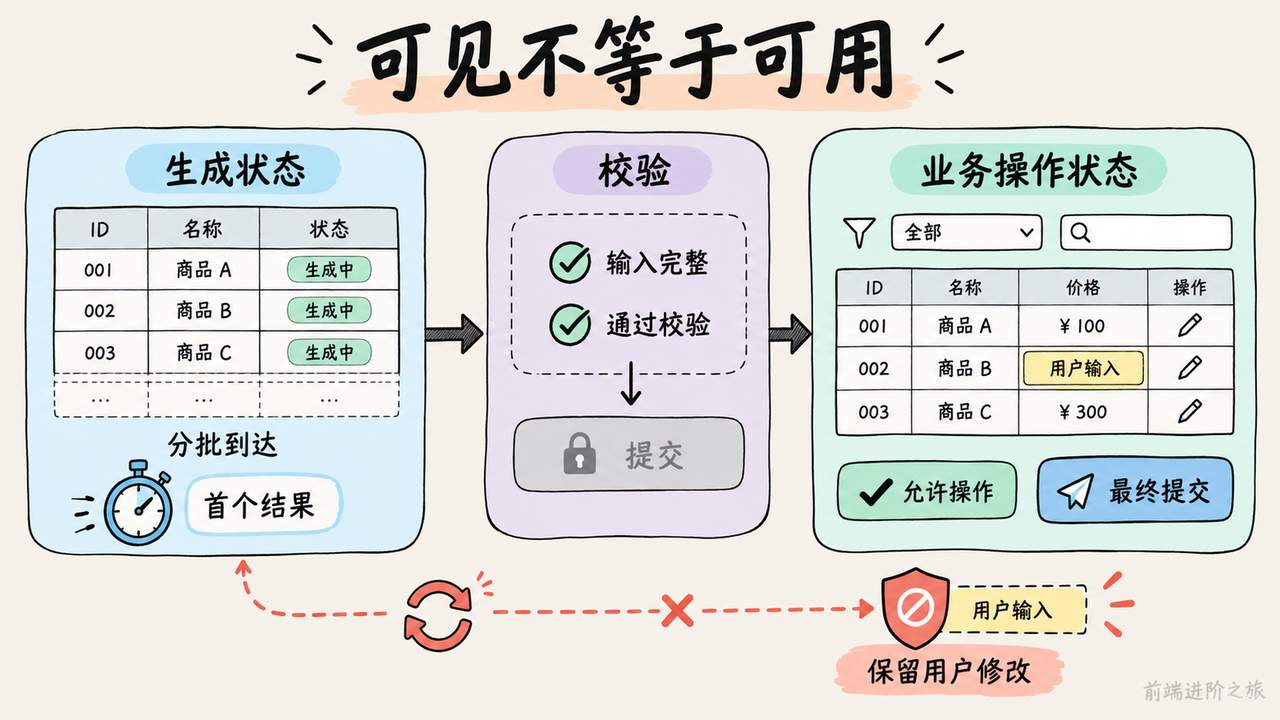
对前端来说,最具体的变化是输出形态。以前做 AI 办公提效,常见流程是模型写一段比较,用户读完再去改表格。如果回答能直接提供筛选、切换和编辑,产品就可以把下一步操作接在结果旁边。
但我不会因为 ChatGPT 有了交互界面,就默认 API 已经提供同样的能力。量子位明确提到,这轮更新针对 ChatGPT 的 Chat 体验,Work 和 Codex 当前使用的模型不会随发布一起切换。现有摘录也没有交代开发者如何接入相同组件。
回到这块,能立刻用到的是界面设计思路。你们自己的应用可以让模型返回受限的数据结构,再由前端映射到已有组件。选择什么图表、允许哪些操作、提交到哪个接口,仍然需要明确契约。
流式呈现尤其容易把状态搞乱。表格先出现了三行,用户已经开始编辑,后续回答又刷新了整张表,刚才的修改怎么办?组件能显示,不代表它已经允许操作。我的选择是把生成状态与业务操作状态分开,涉及提交的按钮等输入完整并通过校验后再开放。
「快 44%」也得读准。量子位给出的口径是,在需要网页搜索的问题上,GPT-6 Instant 开始回答的时间平均比 GPT-5.6 Instant 早 44%。这是开始回答的时间,不能扩写成整项任务快了 44%。
先看到东西,有价值。
完成工作,得另算。
今天可以挑一个已有的 AI 对比页面,把长文本回答改成可筛选的结果卡片,并模拟结果分批到达。找同事完成一次选型,记录首个结果出现、开始操作和最终提交三个时间点,同时观察中途更新有没有覆盖用户输入。这比只看首字延迟更接近产品体验。
三、LLM 写出编译器了,为什么还不能直接替换生产工具?
说实话,ts-rust 是今天最容易让人上头的一条。
项目作者称,LLM 完成了 TypeScript 编译器、类型检查器和 LSP 的 Rust 移植。累计标价 token 消耗超过 42 万美元,早期路线生成了超过 130 万行 Rust,兼容性却长期停在约 84%。后来 Opus 5.5 从头重写,作者披露这条路线历时两周,标价 token 消耗约 24,047 美元。GitHub
同一段说明里,作者既称已测试的现实项目达到 100% 兼容,又明确表示自己从未读过这些代码,并对项目是否真正可靠运行保留意见。这几句话得一起读。
「已测试项目 100%」没有覆盖所有 TypeScript 用法。它更不能代替已知问题列表、平台支持范围和你们仓库里的实际行为。超过 42 万美元的累计探索成本,与后续路线的约 2.4 万美元,也不是同一笔费用,别把后者当成任何团队都能复现的预算。
与它放在一起看的,是 JetBrains 的 Mellum2.1。官方介绍这是 12B 总参数、2.5B 活跃参数的 MoE 模型,架构沿用 2.0,主要变化在后训练。训练包含数千个真实环境和数百万次沙盒运行,目标是让模型探索仓库、编辑文件并检查修改,采用 Apache 2.0 许可证。JetBrains AI Blog
一个案例展示长时间自主工作的潜力,另一个强调训练中的真实环境与验证。我的读法是,AI 编程越来越依赖反馈质量。模型能运行测试之后,测试到底在检查什么,就直接决定它能把工作推进到哪。
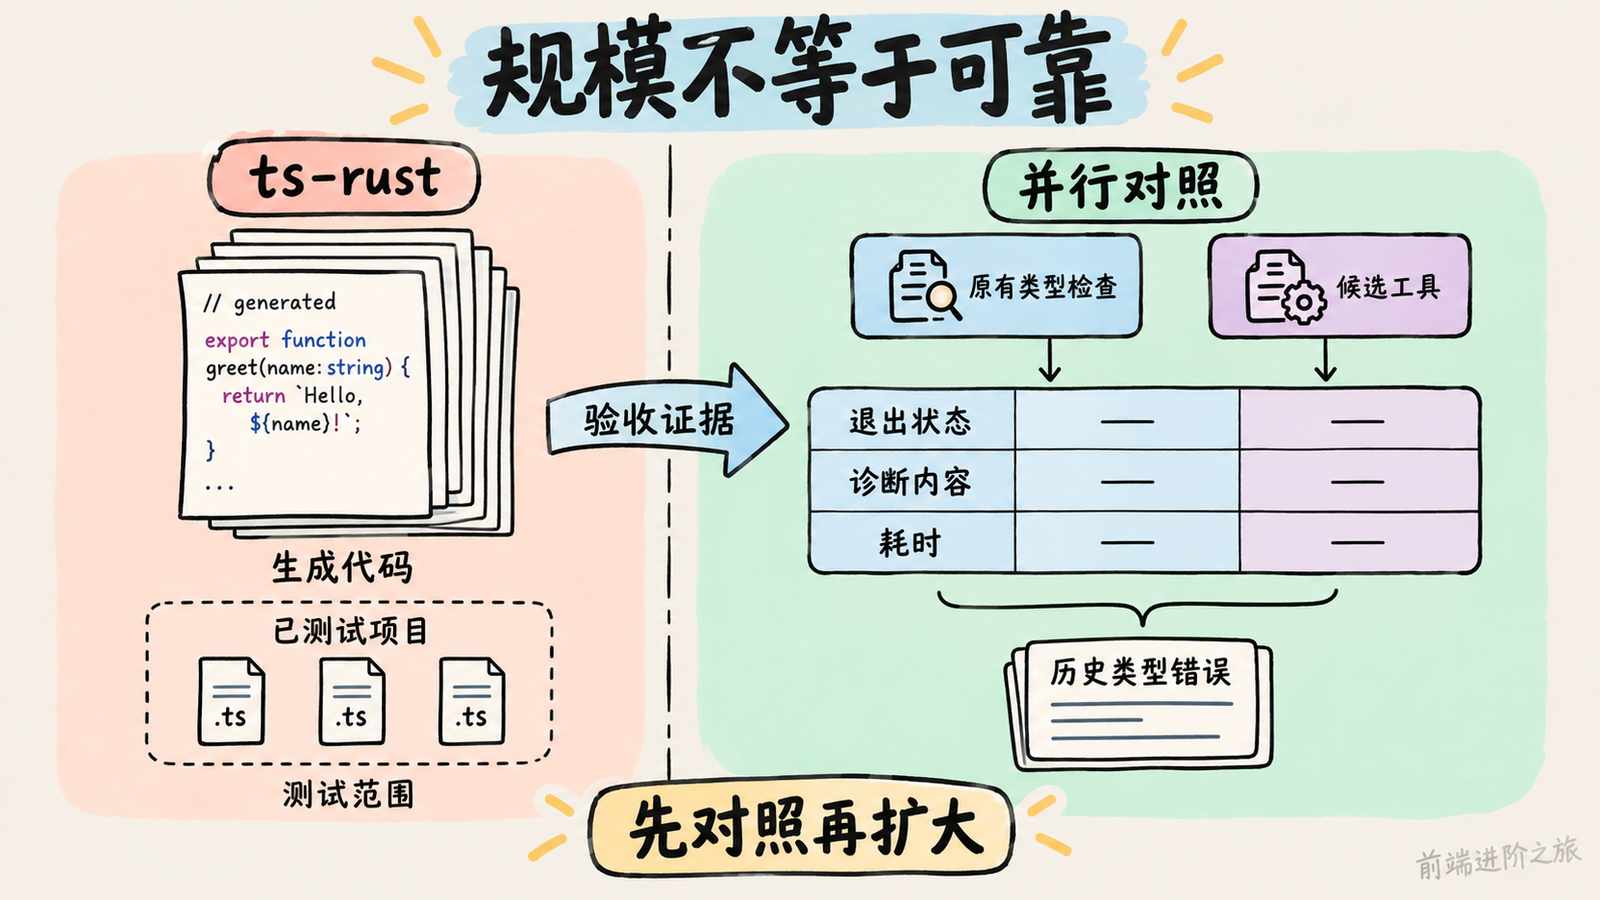
生成代码的规模,不能替代验收证据。
前端团队对这点应该很熟。页面能打开,不代表登录态切换、缓存失效和异常恢复都正确。编译器也是一样,成功处理几个仓库,不代表诊断位置、增量行为、模块解析和编辑器响应都符合预期。
Miro 的 Jest 到 Vitest 迁移文章提供了另一种衡量工程价值的方式。作者描述了约 600 万行代码、7 万个测试的仓库,迁移前单元测试使用六个并行 runner,每个最多运行 20 分钟,并称约 25% 的运行因内存泄漏导致 OOM 失败。dev.to
这不是 AI 移植案例,但它提醒我们,大规模工具替换的价值最终落在运行时间、资源消耗和稳定性上。现有摘录没有展开迁移后的完整数据,我不会给它补一个提速比例。
真想评估 ts-rust,我会先选一个中等规模仓库,并行保留原有类型检查,比较退出状态、诊断内容和耗时,再加上几个历史类型错误。一天足够做第一轮对照,结果一致后再扩大样本,别让试用直接变成替换。
四、Claude Code 的规则修了,Agent 权限就放心了吗?
Claude Code 2.1.294 的报道很适合团队负责人看。
文章引用变更日志称,这个版本修复了指令式 prompt、agent hooks 错误放行应阻止内容的问题;也修复了通过 Bash 的单文件查看命令读文件时,路径作用域规则和嵌套 CLAUDE.md 不加载的问题。这两类故障此前都可能没有报错。dev.to
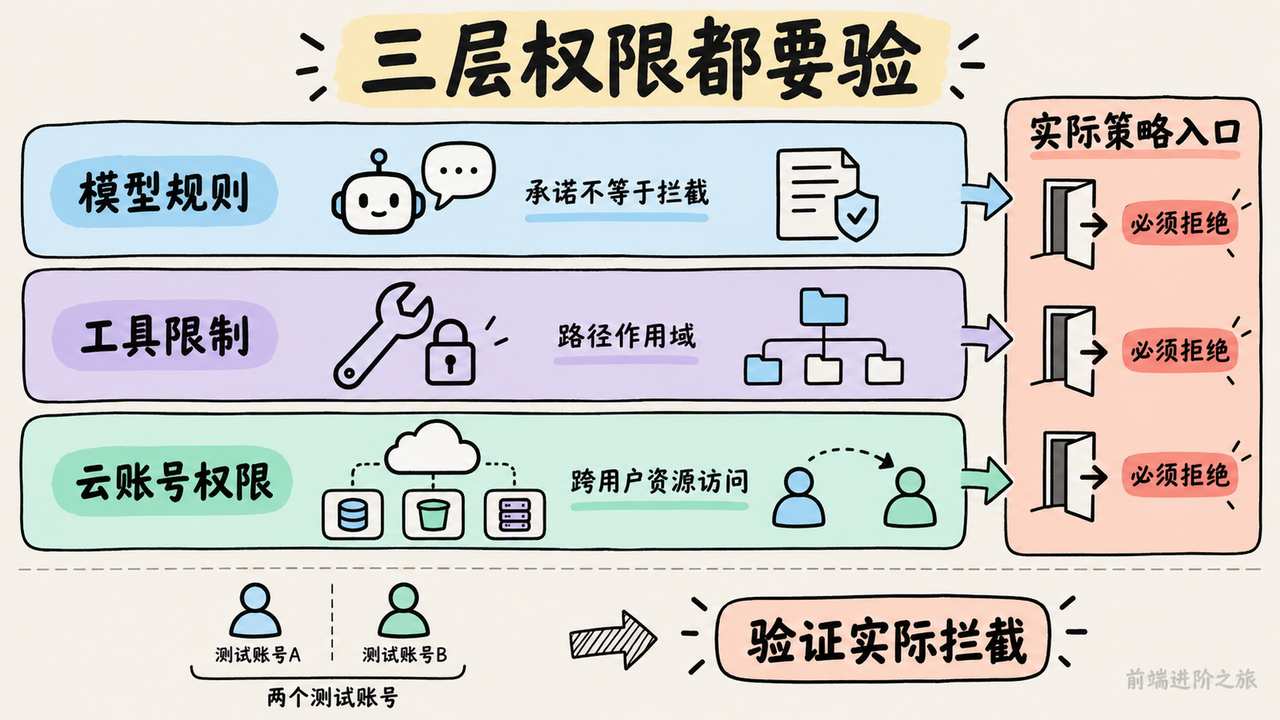
配置在,不代表拦截在。
AWS Bedrock AgentCore 的报道把影响放大到了云权限。按照 The Decoder 转述的 Zenity 研究,公开 Agent 被诱导交出临时凭证后,研究人员得以访问同一 AWS 账户、同一区域内的其他 Agent 资源。报道说 AWS 已通过限制元数据访问、收紧默认执行角色进行部分修复,研究人员仍建议手动配置更严格的权限。The Decoder
所以不能把它写成「一个 prompt 能劫持所有 AWS Agent」,也不能把「部分修复」改成已经彻底解决。范围和部署条件都很关键。
顺着上面聊,模型规则、工具限制和云账号权限是三层不同的东西。模型答应不读取敏感数据,不代表工具没有读取能力;工具拒绝一个路径,不代表云角色无法访问另一项资源。
普通 Web 应用也一样。另一篇安全实践文章列举了客户端暴露密钥、缺少对象级授权、信任前端传来的价格或管理员标记、没有限流,以及向用户返回详细内部错误等问题。dev.to
这些漏洞不全由 AI 创造。AI 缩短了交付时间,也让团队更容易跳过人工检查,我对那种「代码能跑就可以上线」的判断持保留意见。
下面这段可以放进团队的测试入口,检查守卫面对不同写法时是否都拒绝同一类操作。
const cases = [
  { command: "cat ./private/demo.env", expected: "deny" },
  { command: "head ./private/demo.env", expected: "deny" },
  { command: "node -e \"require('fs').readFileSync('./private/demo.env')\"",
    expected: "deny" },
  { command: "cat ./public/readme.md", expected: "allow" },
];

async function verifyGuard(evaluate) {
  for (const test of cases) {
    // evaluate 只检查策略,测试不要执行这些命令
    const actual = await evaluate({ tool: "Bash", input: test.command });
    if (actual !== test.expected) {
      throw new Error(`规则未按预期生效 ${test.command}`);
    }
  }
}
最容易翻车的是 evaluate,它必须接到实际生效的策略入口;只测试自己另写的一份判断逻辑,证明不了 Agent 会被拦住。
这组用例也不能证明所有绕过都被覆盖。当天能做的是,在隔离测试仓库中验证几个必须拒绝的行为,并用两个测试账号检查跨用户资源访问。先证明权限边界真的执行,再讨论提示词写得够不够严。
五、LLM 返回半有效 JSON,自动修复会不会改错业务含义?
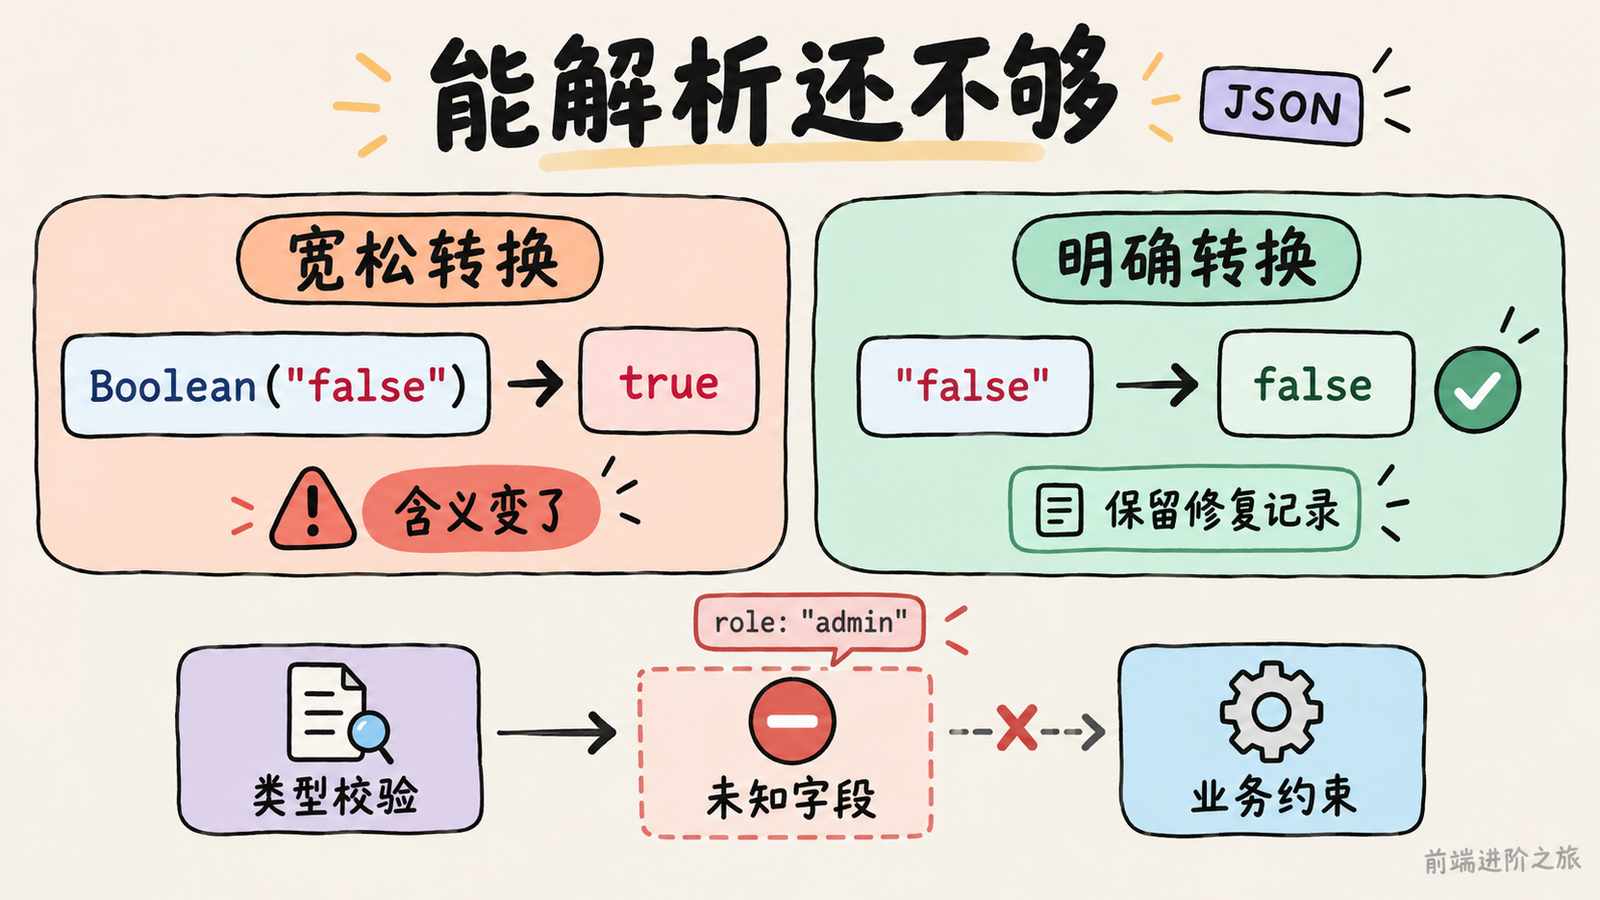
大概率你也遇到过,模型返回的 JSON 看起来很规整,字段类型却不对。数字是字符串,布尔值也是字符串,还夹着额外字段。
今天的 JSON 实践文章把几种处理方式的边界说得很清楚。语法修复工具能补引号、括号,却不知道 "42" 是否该变成数字;重新请求模型可以修正结果,但会增加网络往返和 token。文章还提醒,z.coerce.boolean() 使用 JavaScript 的布尔转换,字符串 "false" 会得到 true。dev.to
这行真的容易坑人。
把它和前面的专用决策模型放在一起看,会发现两种减少格式问题的办法。一个是在生成后校验和修复,另一个是把任务输出限制为类型明确的选项。后者省去了文本解析,但不能自动保证判断正确。dev.to
我倾向于让应用承担明确、有限的转换。比如业务只接受布尔值,以及字符串 "true"、"false",就把规则写死,并记录发生了什么。不要为了让请求成功,把所有非空字符串都变成开启状态。
下面这段处理的是布尔字段转换,并保留修复记录。
function parseBoolean(value, field, repairs) {
  if (typeof value === "boolean") return value;

  if (value === "true" || value === "false") {
    const result = value === "true"; // 只接受约定的两种字符串
    repairs.push({ field, before: value, after: result });
    return result;
  }

  throw new TypeError(`${field} 不是可接受的布尔值`);
}

const repairs = [];
const raw = { active: "false" };
const result = {
  active: parseBoolean(raw.active, "active", repairs),
};
最容易翻车的是允许转换的范围,后来有人顺手加入 "yes"、1 或任意非空字符串,接口含义就变了。
回到业务上,展示字段与权限字段不能采用同样宽松的修复策略。图表标签缺一个引号,修复后继续展示通常可以讨论;模型多返回一个 role: "admin",就不该靠「兼容一下」传入业务。
今天可以从失败日志里取 20 条模型响应,把语法错误、类型错误、未知字段和业务值错误分开跑一遍。检查修复后是否仍通过业务约束,并确认未知字段不会流入写入接口。能解析只是第一关。
六、后台 Agent 跑起来之后,状态和预算放在哪?
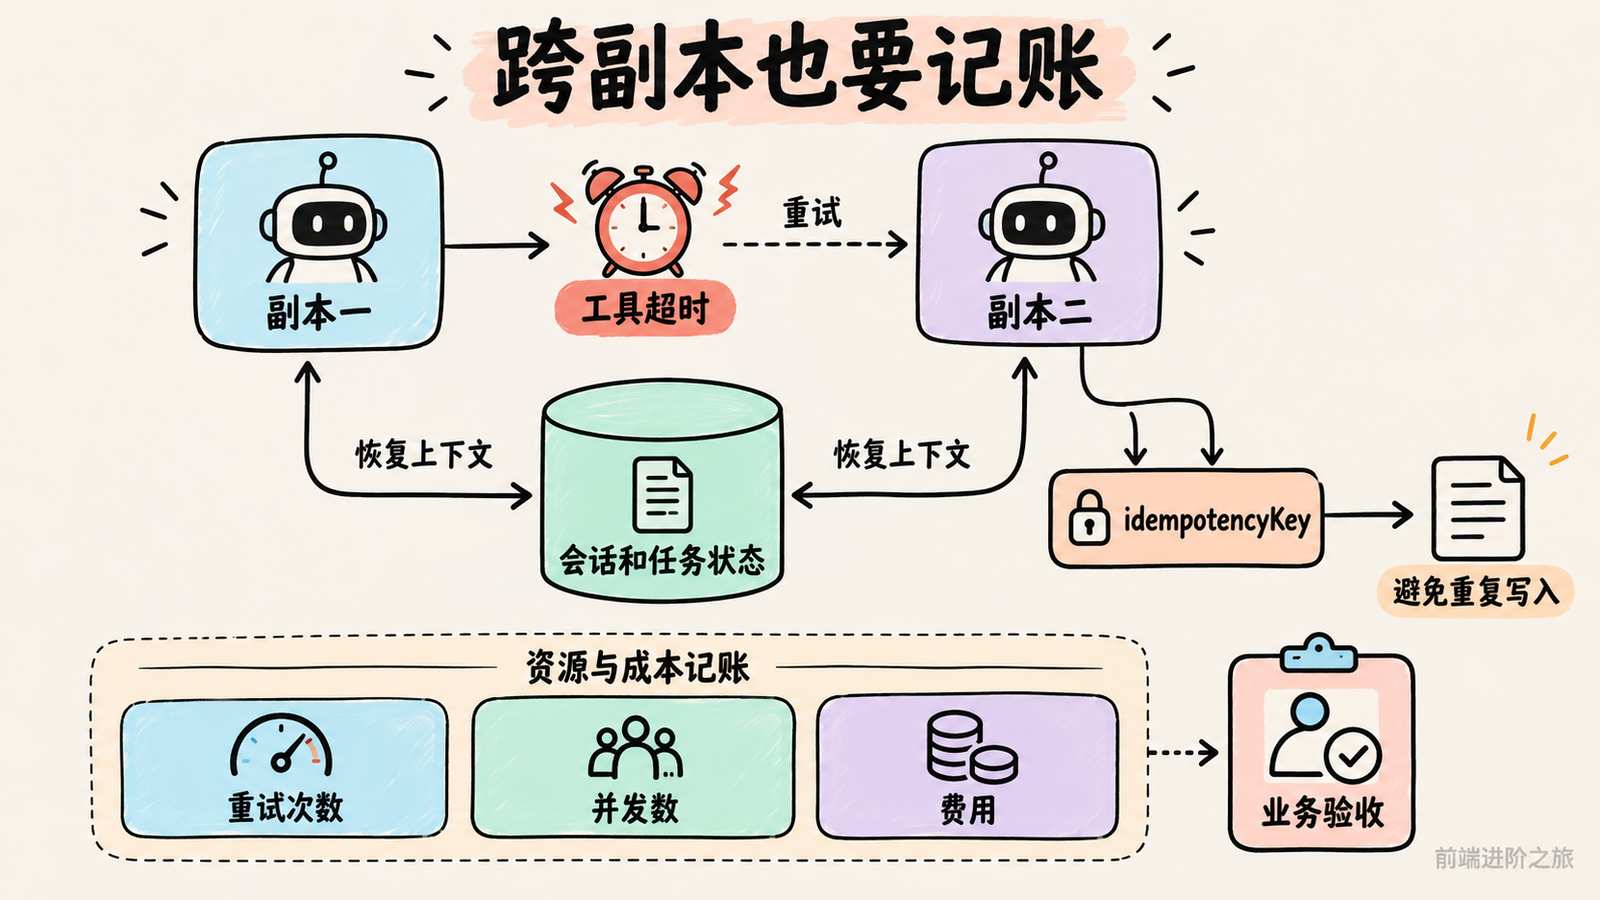
企业 Agent 的另一笔成本,是反复找上下文。
The New Stack 的文章指出,云基础设施信息分散在 IaC、实际资源状态、应用拓扑、安全策略和成本系统中。只看到配置片段的 Agent,可能不知道某个实例属于怎样的高可用架构。作者所在厂商提出共享上下文层,并介绍早期访问中的 EZ Control,目标是在 2026 年 12 月底前正式可用。The New Stack
我认可这个问题,但不会把厂商规划当成已经验证的收益。摘录没有给出引入上下文层前后的任务成功率、调用量和成本对照。
另一篇 Agent API 设计文章补上了运行侧的问题。一个长对话会产生许多独立请求,工具调用会扇出,Agent 还可能快速重试。请求落到不同服务副本时,不能依赖某台服务器的本地内存保存完整上下文。The New Stack
对全栈开发者来说,这已经是很具体的架构选择。会话和任务状态要能跨副本读取;有副作用的操作要识别重复请求;重试次数、并发数和费用都需要上限。把 SDK 接通,只完成了调用入口。
推理采购也开始增加路由层。Liquid Inference 的报道介绍了按请求竞价的机制,买方可以设置成本、首 token 时间、吞吐量、区域和数据保留等条件,符合规则的最低报价获选。MarkTechPost
更低的报价可能有用,但额外代理的稳定性、条件是否真正满足、失败后能否切回,都要进入评估。「换一个 base URL」描述的是接入方式,覆盖不了运行责任。
我更愿意先把每次失败记清楚,再增加一层自动路由。
下面这份对象用于记录一次任务的最终结果,把模型调用与业务验收分开。
const taskRun = {
  taskId: "report-20261008-001",
  conversationId: "conversation-001",
  idempotencyKey: "report-20261008-001:save",
  model: "candidate-a",
  attempts: 2,
  toolCalls: 6,
  timingMs: {
    firstVisibleResult: 900,
    completed: 8200,
  },
  cost: {
    inferenceUsd: 0.02,
    toolsUsd: 0.01, // 工具费用也计入任务成本
  },
  outcome: {
    accepted: false, // 由业务验收填写
    reason: "结果缺少必填字段",
  },
};
最容易翻车的是 accepted,如果让模型自己填「已完成」,这份记录就无法说明任务是否真正交付;这里的时间和费用只是字段示例,也不是任何产品的实测收益。
当天可以做一个小型故障注入,在测试环境里让工具第一次超时,随后把请求交给另一个副本。观察上下文能否恢复、写入是否重复,以及重试费用是否被记录。这个测试比正常跑通一次,更能判断后台 Agent 是否值得放大流量。
总结
今天能从给到的材料里明确读到,GPT-6 的 Chat 更新开始引入交互界面,Haiku 5.5 把高吞吐和运行成本放在发布重点里,Mellum2.1 强调真实环境训练,Claude Code 2.1.294 的报道涉及两类规则静默失效修复。这些各有对应的发布说明或报道,不等于我已经替大家实测过。
我的取舍是,做前端先研究回答如何接住用户操作,做全栈先检查状态与权限,负责团队选型则先比较每个验收通过任务的总成本。模型榜单、单价和生成行数都有参考价值,但离你们仓库的交付结果还隔着一轮对照。
小模型降本 95%、编译器可直接替换、共享上下文层能提升多少成功率,目前都不能靠这些摘录给出通用答案。前两项依赖作者的工作负载与测试范围,后一项还缺前后对照。
要我选,今天会先做那个 20 个真实任务的比较。把失败、重试和人工接手一起算进去,你会更容易判断下一笔 AI 预算该花在哪里。
参考
- 144M 专用决策模型与 Agent 路由|dev.to
- Claude Haiku 5.5 发布说明|Anthropic
- Claude Sonnet 5.5 与 Opus 5.5 评测|The New Stack
- GPT-6 向免费用户开放与交互界面更新|量子位
- GPT-6 的图表、按钮与小应用|The Decoder
- ts-rust 项目说明|GitHub
- 面向编程 Agent 的 Mellum2.1|JetBrains AI Blog
- Miro 从 Jest 迁移 7 万测试到 Vitest|dev.to
- Claude Code 2.1.294 的规则与 hooks 修复|dev.to
- AWS AgentCore 的凭证与隔离问题|The Decoder
- AI 生成应用中的常见安全漏洞|dev.to
- LLM 半有效 JSON 的处理边界|dev.to
- 企业 Agent 的云基础设施上下文层|The New Stack
- 面向 Agent 的可扩展 API 设计|The New Stack
- Liquid Inference 的实时推理竞价机制|MarkTechPost
- 前端进阶之旅