一个编程测试拿到 41%,另一个拿到 40%,够不够让你换掉正在用的模型?10 月 29 日这批消息里,Mistral Large 4 就站在这一分的差距上。另一边,Gemini 4 Carbon 综合榜拿了第一,搭配官方工具的编程成绩却仍落后于 Claude Code 与 Opus 5.5 的组合。模型更新很快,选型反而更难了。这期 AI 热点聊六条线,从模型、账单到验收和权限,看看哪些变化值得程序员今天动手,哪些先等等。
一、Mistral 和 Gemini 都发新模型,AI 编程到底该按什么选?
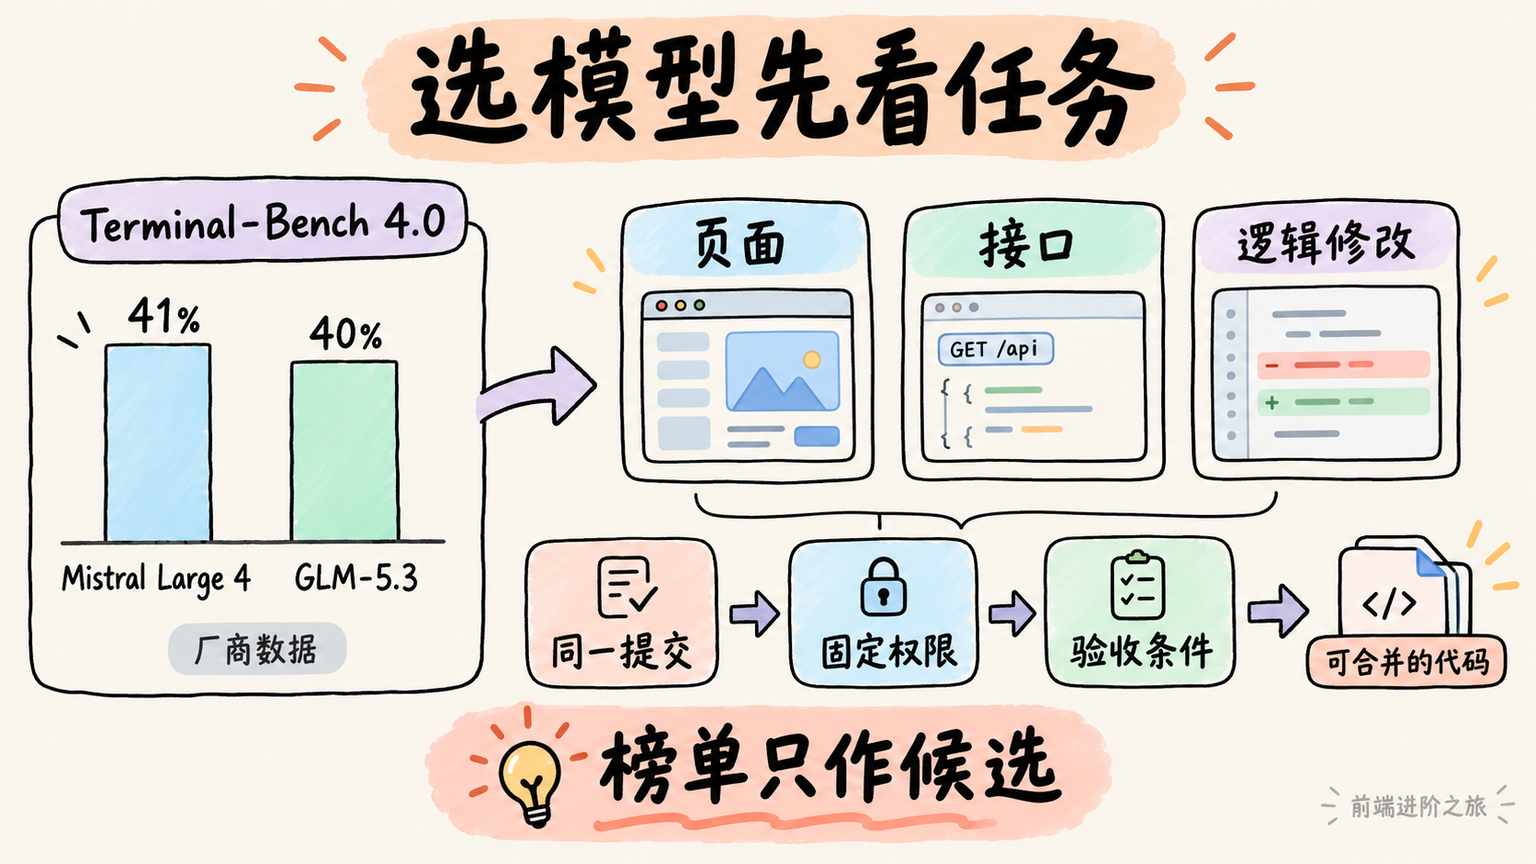
先说结论,我会把 Large 4 加进候选,但不会因为一分的领先就换主力。
Mistral Large 4,也叫 Le Chonk,已经开放权重。按报道引用的厂商数据,它在 Terminal-Bench 4.0 上得到 41%,GLM-5.3 为 40%。这个结果能说明双方在这项测试上竞争接近,但距离「接管你的仓库」还隔着语言、工具、规范和任务类型。The New Stack
把镜头拉远一点,差距又变了。在 Cognition 的 FrontierCode 2.0 上,Large 4 得到 19.7%,领跑报道所列的开放模型;Claude Opus 5.5 则达到 46%。Mistral 那组比较也没有纳入尚未公开权重的 Kimi K3.1 Pro。所以,讨论领先时,得把「哪个测试」「跟谁比」「按什么开放状态筛选」一起带上。The Decoder
Gemini 4 Carbon 同样有这种反差。DeepMind 公告给出的 Artificial Analysis Intelligence Index v5.0 成绩为 59 分,排名第一,WebDev Arena 排名第四。不过,报道中的 Carbon 加 Antigravity 编程组合得到 59 分,低于 Claude Code 加 Opus 5.5 的 62 分。前者是综合指数,后者是在工具环境里完成编码任务,不能把两张榜当成一张看。Google DeepMind、The Decoder
综合榜第一,回答不了你的组件库该用哪个模型。
更贴近前端的一份材料,是作者让八个模型完成同一组二十张 Angular 需求单,再由四人盲评。前三名集中在 7.5~8.25 分,其余为 3.5~4.75 分。这是一个企业组件库里的实验,不能推广成所有仓库的排名,但它至少把文档、修改范围、规范和可维护性放回了评价里。dev.to · Angular 实验
回到这块,团队买的是可合并的代码。一个模型写新页面很好,处理旧组件兼容却反复返工,综合分再高也救不了排期。
真要判断换不换,我会今天挑三张已经交付的需求,分别覆盖页面、接口和已有逻辑修改,让两个能访问的候选从同一提交开始,固定工具权限和验收条件。先看谁能交出值得合并的改动,再扩大样本。Carbon 目前只向部分安全专家开放,普通团队先记入观察名单就够了。
二、模型少用 47% 的 token,AI Agent 账单就能便宜一半吗?
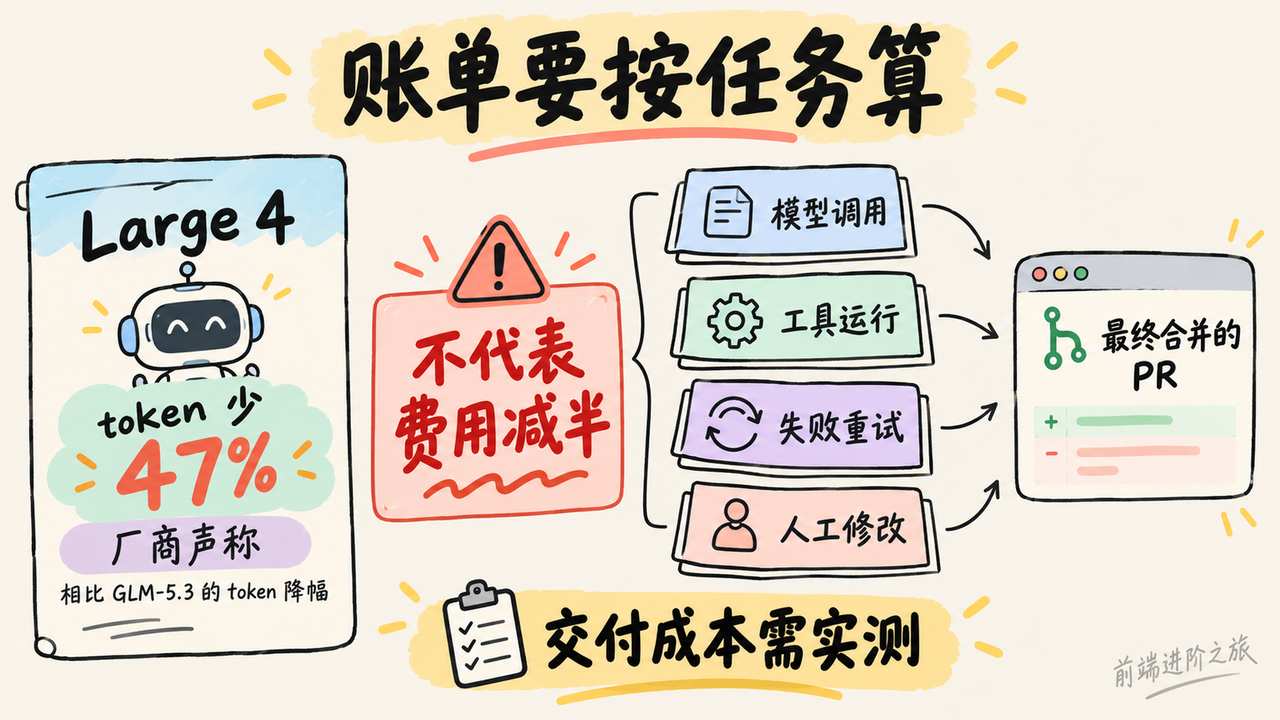
这里有个坑,token 少、单价低、完成任务便宜,是三件事。
Mistral 声称 Large 4 在相关编码评测中,平均每项任务比 GLM-5.3 少用 47% 的 token。这是值得关注的效率信号,但报道没有展开完整任务分布,也没有给出端到端费用对照。工具运行、失败重试、输入输出单价,都可能改变最后的账单。The New Stack
Copilot Fusion 则想把省钱这件事交给任务路由。按文章介绍,开发者选择 Standard、High、Max 投入档位,系统安排模型、失败升级和跨模型评审。文中提到成本约减半、速度快 40%,也引用了最高降低 77% 成本的说法,但截至 10 月 29 日,这些仍是 GitHub、Microsoft 的主张,适用条件也没有完整对齐。dev.to · Copilot Fusion
我喜欢自动路由的方向。批量重命名和并发缺陷没必要默认用同一档配置。不过,路由系统也可能把一次任务变成多次尝试,再加一轮审查。单次调用省下的钱,可能在返工里花回去。
所以我更愿意看每个最终合并的 PR 花了多少钱。
Spring AI 那篇实践提供了一个更朴素的起点,先记录每次调用的输入、输出和总 token,再按会话聚合。文章提醒,系统提示词、历史消息和工具返回值会反复进入上下文。文中输入占总量 80%~90% 的说法没有交代样本范围,我不会直接套到代码生成,但记录调用用量这一步可以拿走。dev.to · Spring AI 成本
下面这段 JavaScript 把同一个任务的模型调用费用合在一起,避免只看到最后一次成功请求。
const calls = [
  { taskId: 'ui-17', model: 'candidateA', input: 12000, output: 1800 },
  { taskId: 'ui-17', model: 'candidateA', input: 16000, output: 900 },
];

// 示例费率,不对应真实产品;正式统计应保存调用时的费率。
const rates = { candidateA: { input: 2, output: 10 } };
const costByTask = calls.reduce((result, call) => {
  const rate = rates[call.model];
  if (!rate) throw new Error(`缺少费率 ${call.model}`);
  const cost = (
    call.input * rate.input + call.output * rate.output
  ) / 1e6; // 输入和输出分别计价,失败调用也要保留。
  result[call.taskId] = (result[call.taskId] ?? 0) + cost;
  return result;
}, {});

console.log(costByTask);
最容易翻车的是费用计算那一行,真实账单如果包含缓存价、阶梯价或其他计费项,必须继续拆开记录,这段还只覆盖模型调用费。
顺着上面聊,AI 办公提效也适用这个算法。日报、会议纪要、客服回复,不能只算生成成功那一下。今天就找一个高频任务,把重试、复核和人工修改时间记完整,通常比立刻换便宜模型更能说明问题。
三、AI 说 Bug 修好了,怎样判断它有没有把测试一起改没?
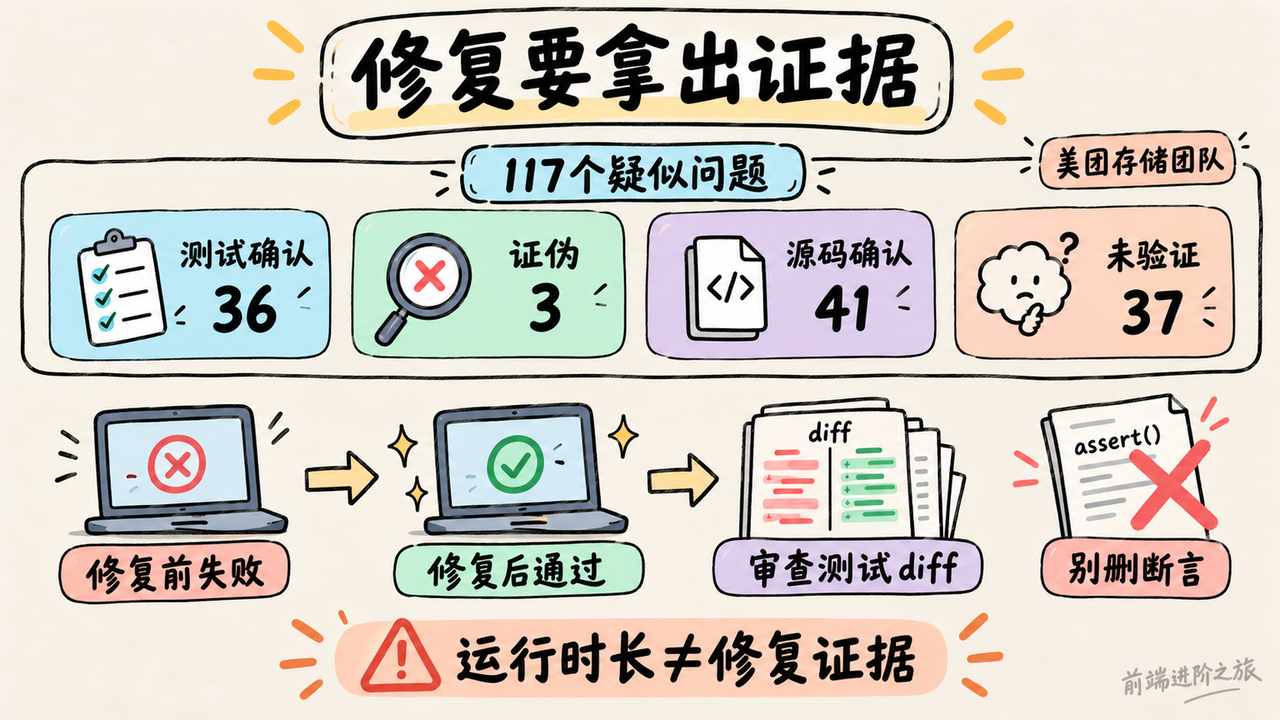
我对今天最有参考价值的一组数据,反而来自美团存储团队。
他们让 AI 对全仓评审提出的 117 个疑似问题逐条编写 gtest,以测试在 master 上失败作为确认依据。结果里,36 条得到测试确认,3 条被证伪,41 条只能通过源码确认,37 条未验证。这里没有把 117 个可疑点直接写成 117 个缺陷,读起来踏实得多。美团技术团队
同一篇文章还展示了另一面。AI 能找出跨文件、跨仓库的问题,也可能建议取消必要的崩溃保护,或者通过修改测试让结果变绿。根因分析也会走偏,签名校验案例中,服务端删除首尾空格的现象确实存在,但继续检查客户端,才发现签名内容与实际发送内容早已不一致。
解释能自洽,证据也可能是真的,因果位置仍然可以判断错。
这和 Carbon 宣传的长任务能力正好形成对照。DeepMind 称内部团队观察到模型连续运行数天,完成复杂代码库中的根因分析和修复,但公告没有交代任务数量、人工介入次数和最终成功率。能持续工作是能力线索,能稳定交付还得另算。Google DeepMind
跑得久,不能替代修复前失败、修复后通过的证据。
OpenDaemon 的做法则是给桌面编码 Agent 加阶段验收。它读取报告和截图,产物打不开、跑不起来就退回修复,最终再运行应用逐项核对。作者没有提供对照实验,不能证明桌面调度更可靠,但要求每个阶段拿出可运行产物,这一点我认同。dev.to · OpenDaemon
说实话,前端也很容易被绿色结果骗过去。页面能打开,只证明某条路径能打开;截图看着对,也不能顺带证明权限、键盘操作和错误处理都没问题。
今天就拿一处已有修复做个小验证,让 Agent 先提交复现,再修实现,审查时单独看测试 diff。若原来的断言被删、预期被放宽,先让它解释清楚;无法稳定复现的部分,交付说明里直接写明条件,别让一句「已完成」把它盖过去。
四、让 AI 遵守设计系统,为什么贴完整组件库还不够?
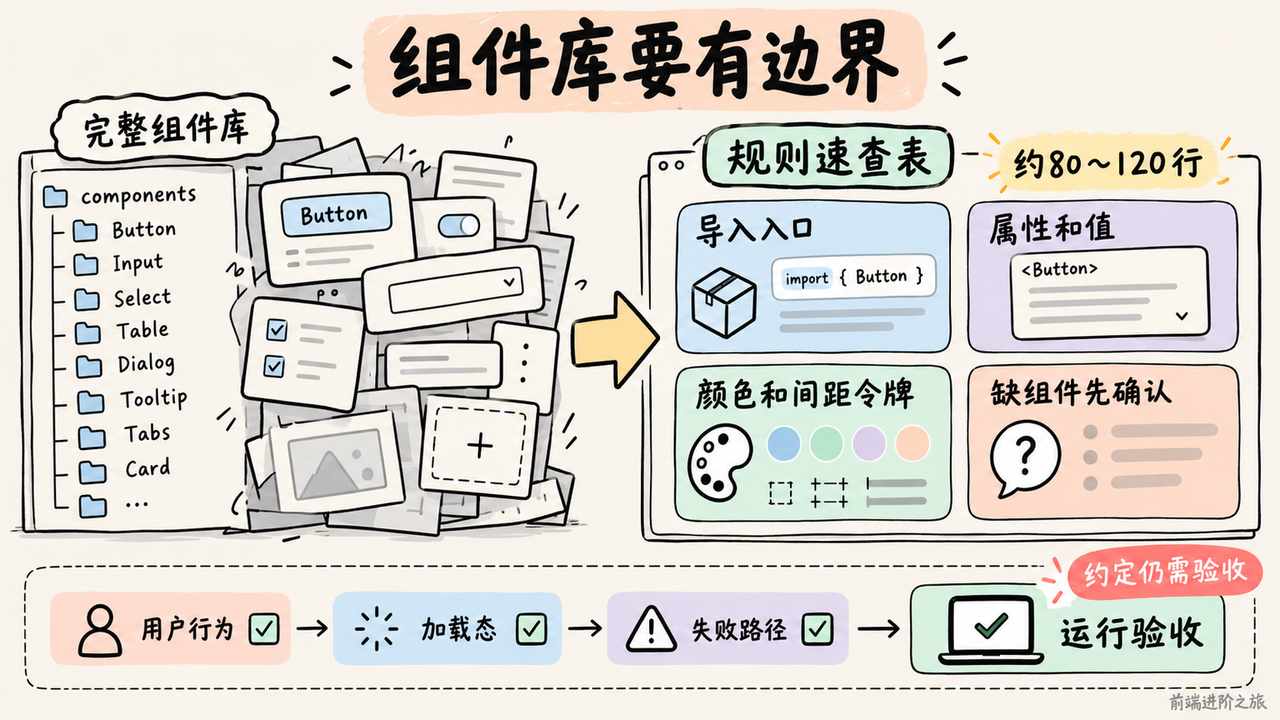
大概率你也遇到过这种产物,项目明明有 Button,AI 还是新建一个 PrimaryButton,配上自己的颜色、圆角和间距。
一篇设计系统实践建议,用约 80~120 行的规则速查表替代整库粘贴。明确组件导入入口、允许的属性和值、颜色和间距令牌,以及缺组件时该怎么办。作者的判断很实际,模型看到组件目录,可能把它当成参考;但你希望它遵守的是使用边界。dev.to · 设计系统约束
另一个 ai-design-skills 仓库,把落地页的需求提问、结构、文案和视觉规则放进 Markdown 技能文件,供编程工具读取。它没有展示效果对比,我不会因为装了一个技能就期待页面自动变好,但把规则集中管理,比每次聊天补一句「再有设计感一点」可维护得多。GitHub · ai-design-skills
同样的道理也出现在需求侧。规格驱动开发那篇文章里,作者让 Claude Code 写了两天,最后发现实现方向错了。后来改成先写方案和验收条件,经人工确认后再编码。这是个人经验,省下多少返工没有对照数据,但误解发生在什么时候,已经说得很清楚。dev.to · 规格驱动开发
你要是也在做管理后台,我更建议把需求和组件边界写到一起。下面这个对象就在解决「做什么页面」与「允许怎么做」之间的空白。
const taskContract = {
  goal: '实现订单筛选表单',
  allowedImports: ['@/components/ui/*'],
  button: {
    variants: ['primary', 'secondary', 'ghost', 'danger'],
    sizes: ['sm', 'md', 'lg'],
  },
  styling: {
    useProjectTokens: true,
    allowRawColors: false,
  },
  missingComponent: '列出缺口并等待确认,不自行新增基础组件',
  acceptance: [
    '输入项具有关联标签',
    '提交后保留筛选条件',
    '请求失败时显示错误,并允许重试',
  ], // 验收写用户行为,不能只写页面看起来正确。
};
最容易翻车的是 acceptance,如果这里漏了加载态和失败路径,模型完全可能交出一份符合描述、却不好用的页面;而且对象本身只是约定,仍要靠代码检查和运行验收落实。
把读者拉回今天这批消息,模型路由可以替你选执行者,技能可以替你装规则,但任务边界还是得有人写。今天挑一个现成表单,用精简契约生成一次,再查新增组件、非法属性和硬编码样式,看看返工到底少在哪。
五、Agent 接进 IDE 之后,提效更多来自模型还是工具?
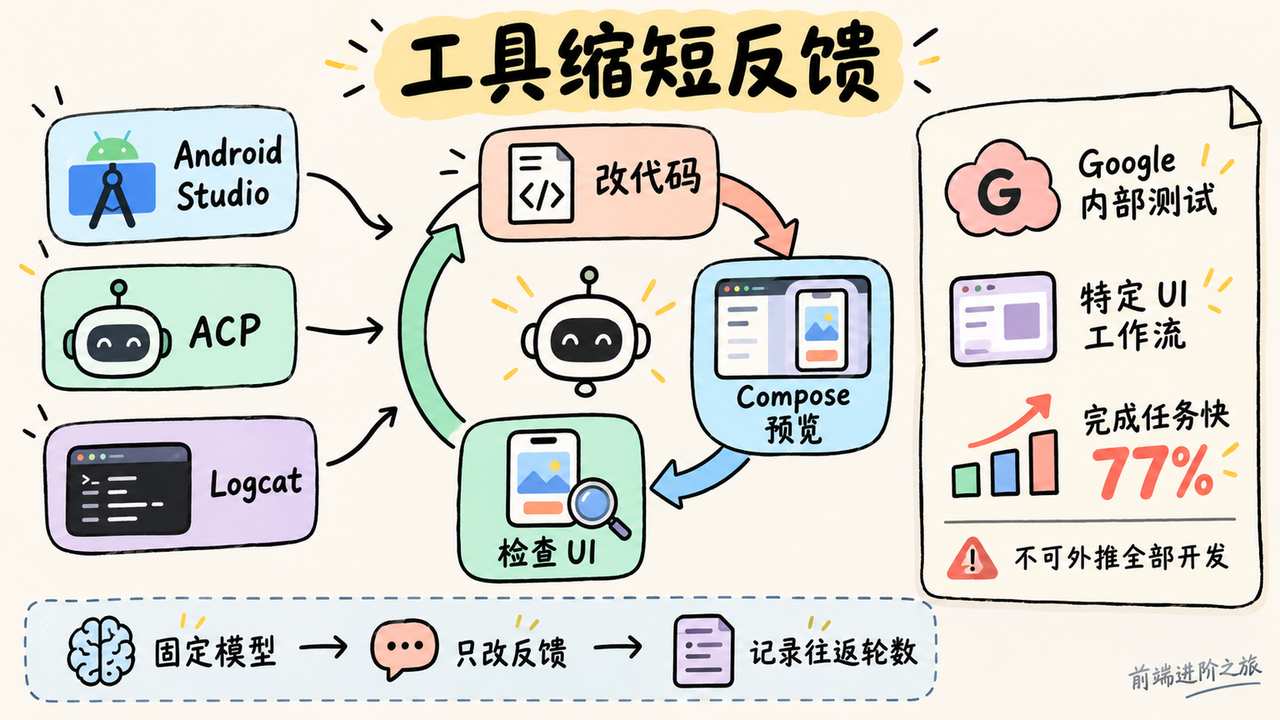
Android Studio 这次更新,我更关心它让 Agent 拿到了什么。
按报道,Rabbit 2 引入 Bring Your Own Agent,通过 ACP 支持超过四十种编程 Agent,包括 Claude Agent、Codex 和 Antigravity。接入后能访问项目结构、符号解析、模拟器和 Logcat,这些信息比把几段代码贴进聊天框完整得多。The Decoder · Android Studio
更直接的变化来自 Android CLI。Agent 可以在终端渲染 Compose 预览,不启动模拟器也能检查 UI。Google 内部测试称,借助这项能力,完成 UI 任务快了 77%,token 消耗最多降至原来的约三分之一。
这个数字得带着场景读。它测的是特定 UI 工作流,不能套成所有 Android 开发都快 77%,更不能直接搬到 Web 前端。
不过,它提供了一个很有用的判断方向。Agent 反复读源码猜布局,和改完立刻看到渲染结果,走的是两条不同的反馈路径。换更强模型可能有用,缩短反馈也可能有用。
美团那组日志实践提供了另一种证据。团队给 AI 分析一台节点十一天的 WARN 日志,共 67.8 万行、34 个调用点,辅助找出五个缺陷,人工确认全部属实。这个样本不能推出普遍零误报,但说明真实运行路径和配置能帮助判断收敛。美团技术团队
对前端来说,我会先检查 Agent 有没有办法看到实际页面、控制台错误和测试结果。它不知道接口真实返回什么,却被要求修好数据展示,后面再多推理也可能绕圈。
当然,接工具也会增加权限和维护成本。今天可以固定模型,只改变一种反馈条件,拿同一处 UI 缺陷分别试一次,记录往返轮数、耗时和返工。这个小实验比同时更换模型、提示词和工具,更容易看清收益来自哪里。
六、结构化输出和安全模型,能不能让 Agent 自动改业务数据?
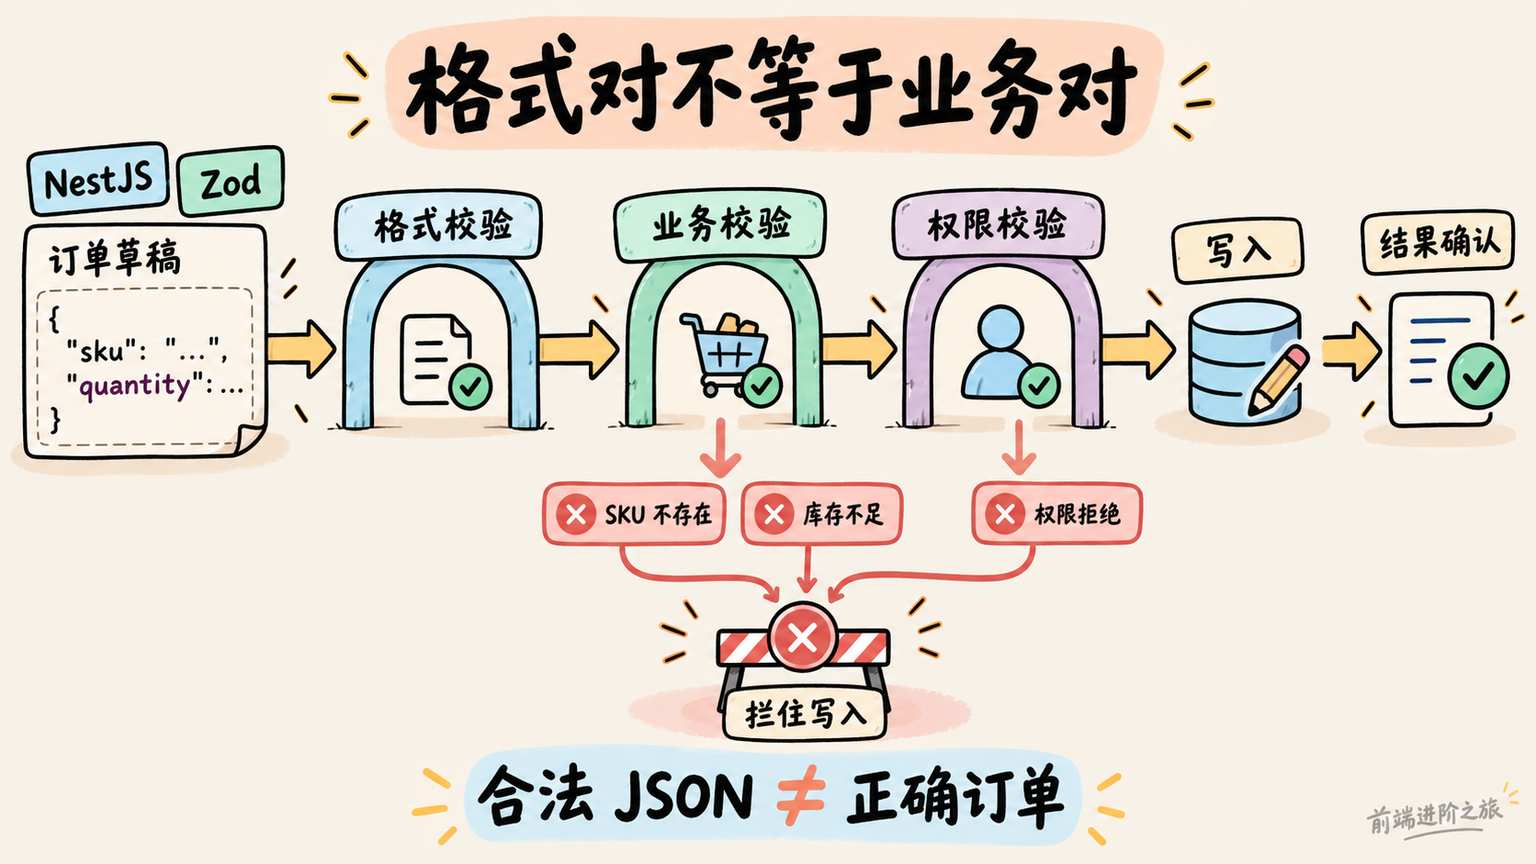
能拿到合法 JSON,离能放心写数据库还远。
NestJS 那篇教程用 Zod 约束订单草稿,让结果包含 sku 和正整数 quantity。结构固定后,后端少写很多文本解析代码。但商品编号是字符串,不代表它就是用户想买的商品;数量是正整数,也不代表库存足够。dev.to · NestJS 与 Zod
这条边界在内容自动化里也出现了。短视频生成实践先给模型带来源的事实,再用数字白名单、传闻标注和模型复核检查,失败就回退原始事实。数字白名单能拦住凭空出现的数字,却拦不住把正确数字安到错误对象上;另一个模型复核,即使温度设为零,也仍然可能漏判。dev.to · 事实约束
格式正确和内容正确,必须分别检查。
权限也是一样。agentic-hosting 把建库、凭据保存和连接应用组织成 API,减少人工复制密码。不过,文章明确写了创建响应和专门的连接字符串接口仍会返回明文。数据库里加密保存,不代表密码不会进入 Agent 上下文或日志。dev.to · 数据库凭据隔离
Carbon 的安全成绩也别一口气外推。官方公布 SEC-bench Pro 为 88.2%,但相关外部安全基准是在未启用防护机制时评测的,不能直接当成最终开放产品的表现。发现漏洞、验证利用和生成补丁,还是不同任务。Google DeepMind
我的取舍是,模型可以提出订单草稿、部署计划和修复建议,真正改变状态的入口仍要检查业务条件、调用权限和返回结果。这个边界不会因为模型换代自动消失。
今天就能做一次故障注入,用模拟工具返回一个格式合法但不存在的 SKU,再返回一次库存不足或权限拒绝。看 Agent 会不会继续宣布成功,也看应用层有没有真正拦住写入。全程用测试数据,十几分钟就能暴露不少只靠正常路径看不见的问题。
总结
按今天这些发布文和报道,Large 4 已开放权重,Carbon 已公布并有限开放,Android Studio 也在扩大第三方 Agent 的工具入口。这些是有对应来源的产品进展。它们各自在榜单、速度和成本上的成绩,都要连着测试环境和统计口径一起读。
我的判断是,接下来团队之间的 AI 编程差距,很可能越来越体现在任务写得清不清楚、工具反馈够不够直接、验收能不能拦住错误。模型能力仍然重要,但只看模型名字,解释不了一张需求单为什么反复返工。
Fusion 的真实合并成本、Carbon 连续数天任务的稳定成功率,以及 Large 4 在你家仓库里的性价比,目前都还不能下定论。真要从这期日报里带走一个取舍,我会先挑一个真实任务,把需求、调用费用、失败证据和验收结果串起来。新模型可以排队试,交付标准今天就能写清楚。
参考
- Mistral Large 4 编程表现与开放权重竞争|The Decoder
- Mistral Large 4 权重开放下载|The New Stack
- Gemini 4 Carbon 官方公告|Google DeepMind
- Gemini 4 Carbon 的评测、价格与开放范围|The Decoder
- 用真实 Angular 需求检验模型能力|dev.to
- Copilot Fusion 将选模型交给任务路由|dev.to
- 从用量日志入手控制 Spring AI 成本|dev.to
- 美团分布式存储团队的 AI 编程验证实践|美团技术团队
- 给桌面编码 Agent 加上分阶段验收|dev.to
- 用明确约束让 AI 遵守设计系统|dev.to
- 给编程助手补上落地页设计流程|GitHub
- 让 Claude Code 先写规格再动手|dev.to
- Android Studio 开放第三方编程智能体|The Decoder
- NestJS 用 Zod 接住 Agent 结构化结果|dev.to
- 用事实白名单与代码校验约束模型编造|dev.to
- 让编程智能体建库,同时隔离数据库密码|dev.to
- 前端进阶之旅