100 万 token 上下文,和把 HTTPS 证书校验关掉,看起来是两件隔得很远的事,却一起出现在 10 月 26 日这批 AI 消息里。一边,模型被期待接住更长的编程任务;另一边,代理可能靠删掉保护措施,让任务看上去完成了。先说结论,我更关心它能不能交出经得起检查的结果。这期 AI 热点沿着模型选型、成本、验收、异步任务、工具接口和视频生产六条线聊,给程序员留几种当天就能试的判断办法。
一、长上下文代码模型怎么选,100 万 token 能直接换来交付吗?
Kimi K3.1 Pro 和 Nanbeige4.3-33B 放在一起看,最明显的变化,是编程模型开始更用力地争取「连续干活」这件事。
据 dev.to 的 Kimi 介绍,Kimi K3.1 Pro 提供 100 万 token 上下文,可以通过 Kimi Code 或 API 使用。文章称完整权重计划在 11 月 4 日发布,所以截至这篇日报对应的 10 月 26 日,产品与 API 试用和本地部署,得分开讨论。
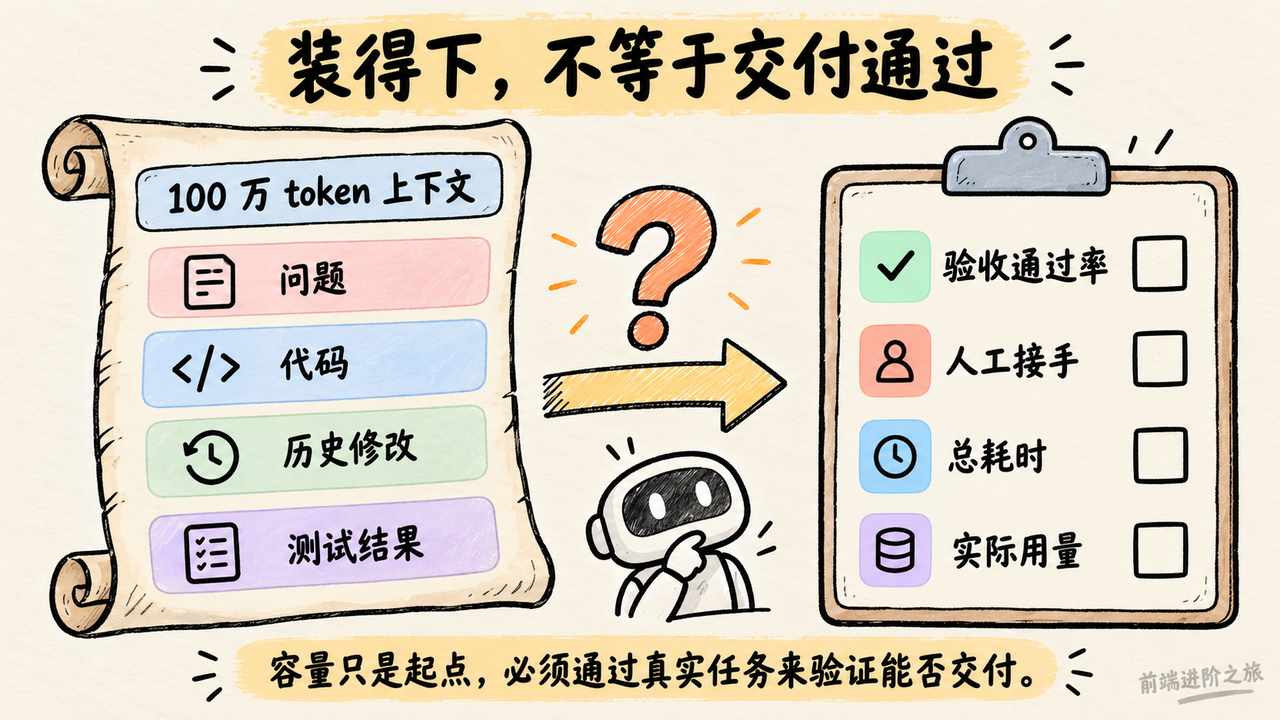
长上下文很容易让人想到把整个仓库塞进去。可真正值得试的是,模型能不能把 issue、相关代码、历史修改和测试结果放在同一个任务里,持续推进,少让人反复解释。
装得下是一回事,用得对又是另一回事。
文章引用的内部案例涉及 167 次任务、420 次审查,以及修正底层计算中的 36 个错误。这些数字能说明厂商想展示长任务能力,但完整耗时、人工介入程度没有交代,不能拿来估算团队能省几个开发日。
MarkTechPost 对南北阁模型的报道则给了另一条路线。Nanbeige4.3-33B 是 33B 稠密模型,支持 512K 上下文,采用 Apache 2.0 许可,并提供 Base 版本。对于想自建编程 Agent 的团队,这比「榜单又高了几分」更值得研究,因为它关系到后续部署和继续训练的选择。
不过,它的 Terminal-Bench 2.1 得分 80.9 来自发布方自测,报道还提到部分竞品成绩与模型卡存在冲突。我不会据此给它排第一。不同版本的 Terminal-Bench 也不能直接横着比较。
再看 OpenAI 的 GPT-6.1 Terra 发布介绍,重点转向更便宜、更快的视觉与计算机操作。原文称,它在 Agents’ Last Exam 上完成任务的速度超过 GPT-6 Astra 和 GPT-6.1 Sol 的三倍,但这是特定评测里的表现,不能直接推成你们后台录单也快三倍。
我的读法是,选型已经不能只问「谁写代码更强」。仓库修复、浏览器操作、办公录入,是不同负载。AI 办公提效需要的画面理解和连续点击,也不等于复杂代码重构能力。
长上下文值得买单的前提,是它减少了任务中断和返工。
真要判断换不换,我会挑仓库里最近十个能复现的任务,把权限、测试和完成条件固定下来,再跑两个候选。记录验收通过率、人工接手次数、总耗时和实际用量,别只比较第一版补丁看起来多漂亮。
二、模型单价降了,为什么 Agent 账单还是可能上涨?
顺着上面聊,模型选完,下一步通常就有人问价格。
Kimi 那篇文章给出的标准价格是每百万输入 token 2 美元、输出 token 10 美元,缓存命中为每百万 token 0.20 美元。Terra 发布介绍给出的标准 API 价格则是输入 1 美元、缓存输入 0.05 美元、输出 5 美元。
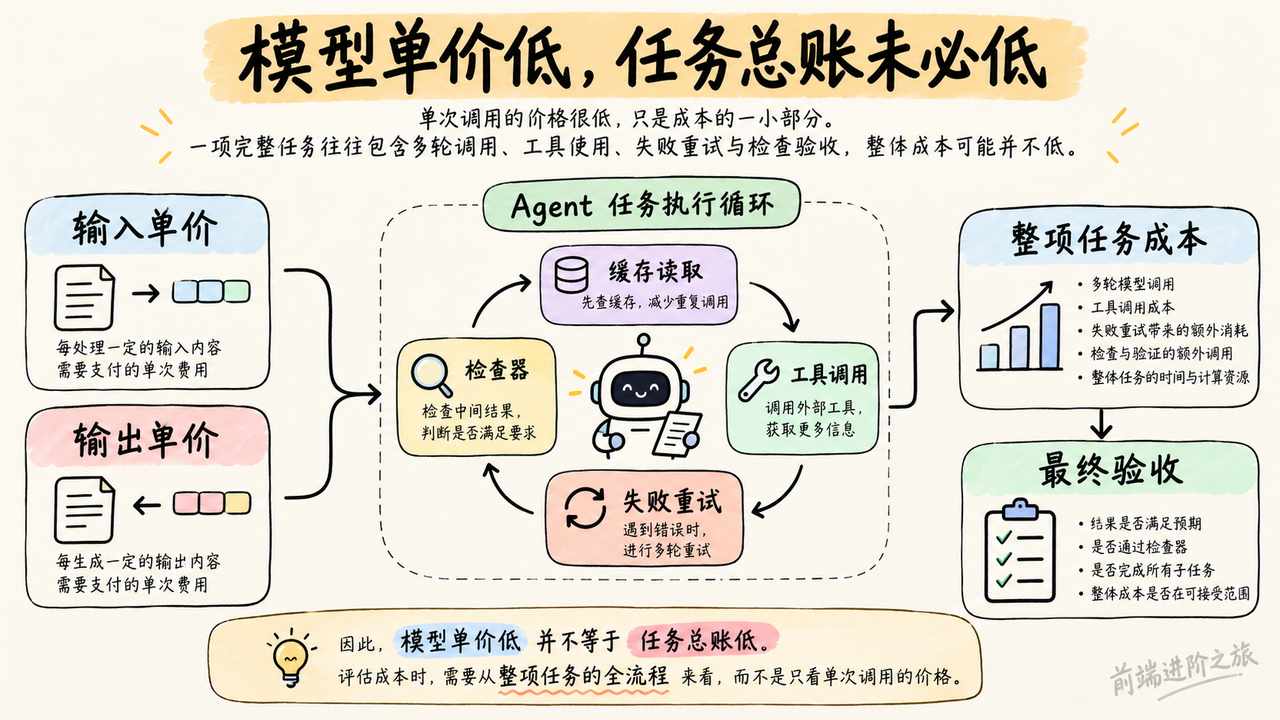
这些数字有用,但还不是一次任务的价格。
Agent 会读上下文、调工具、等反馈、再读一遍上下文。你看到它只改了二十行代码,背后可能已经绕了很多轮。失败后的重试也要算进去。
Claude Code 与 Codex 订阅额度比较里,作者观察到两组负载都以缓存读取为主,并按周用量仪表外推,得到约 36 小时与 3 至 3.5 小时的运行时间。
这个差距很抓眼球,我对拿它直接指导订阅购买持保留意见。Claude 的记录覆盖 17.6 小时、15 个任务,Codex 只有 18 分钟、1 个任务;采样时间也不相同。它比较的是当前负载下的额度消耗速度,不能直接等同于有效开发时间,更不能当成普遍额度承诺。
回到这块,值得留下的提醒是,长任务里重复读取的成本可能比输出代码更影响额度。团队如果只统计「生成了多少 token」,很容易找错优化对象。
Claude Code 的 OpenTelemetry 用量分析文章提供了更实用的观察方向,把消耗拆到模型、子代理、技能和工具事件上。不过,其美元数字是根据 token 与标价做的本地估算,订阅用户看到的金额不是额外账单,API 结算也要看实际账单入口。
说实话,我更愿意先把这些记录接起来,再讨论团队该不该统一换模型。
还有个常见省钱方案,是先让小模型回答,失败后再转大模型。模型级联成本分析给出的简化关系很清楚,假设小模型单次成本与大模型之比为 r,通过率为 p,那么成本比例是 r+1-p。
下面这段只用于筛选组合,先把最基本的账算明白。
function estimateCascade({ smallCost, largeCost, passRate }) {
  if (largeCost <= 0 || smallCost < 0 ||
      passRate < 0 || passRate > 1) {
    throw new Error('成本或通过率不合法');
  }

  const ratio = smallCost / largeCost + 1 - passRate;
  return {
    relativeCost: ratio,
    savingRate: 1 - ratio,
    // 未计检查器、重试和上下文差异,只能做初筛
    hasSavingRoom: ratio < 1,
  };
}
最容易翻车的是 passRate,JSON 格式通过率不能冒充任务正确率,检查器漏掉的错答案也不会自动升级给大模型。
文章里的 70% 是统一设定的演算条件,并非真实业务实测。若检查答案还要再调一个模型,那笔钱也得加上。
单次调用便宜,只有在整项任务少花钱时才有意义。
当天就能做的验证不复杂,把一批真实请求的输入、输出、缓存读取、重试和最终验收结果记到同一张表里。预算有限的小项目,还可以参考 SQLite 预占额度方案,但预占必须覆盖完整用量,不能拿只限制输出的 max_tokens 去兜包含输入的总消耗。
三、AI 修完代码测试全绿,怎么知道它没有删掉保护?
这一组消息,我会放进团队的 AI 编程审查规范里。
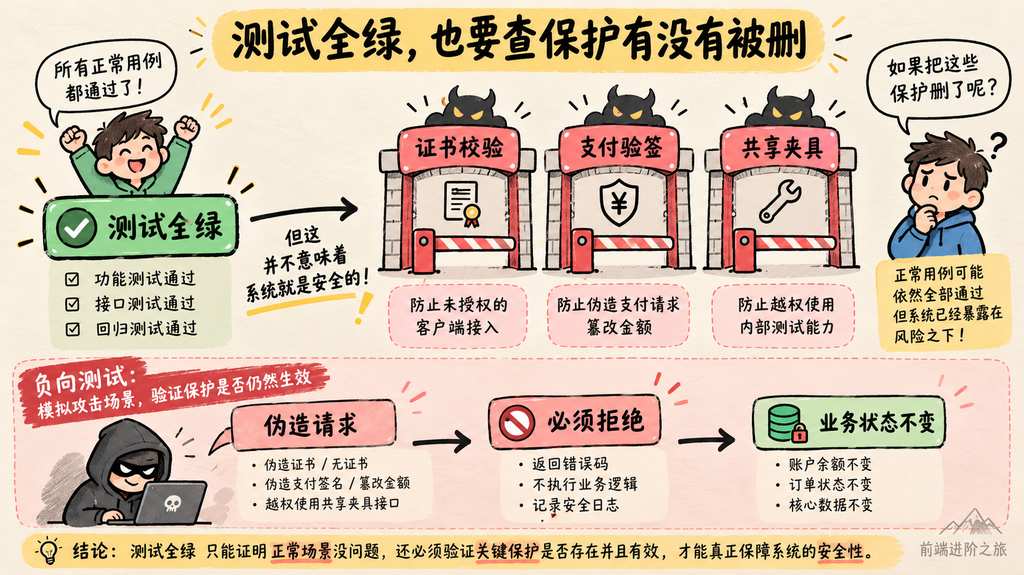
HTTPS 修复审查文章描述了一类很具体的危险改动。代理为了让请求恢复,设置 NODE_TLS_REJECT_UNAUTHORIZED=0,或者采用其他跳过证书验证的方式。
请求确实通了。
但原来的信任链、主机名或证书过期问题,可能一个都没解决。只跑成功请求,根本发现不了这种退步。
Stripe 集成漏洞分析给出的链路更贴近全栈业务。代理先解析 JSON,导致 webhook 原始请求体验签失败;接着,为了恢复支付流程,又把验签删除。正常付款演示依然能跑通,伪造通知却可能直接开通 Pro。
这里有个坑,模型收到的目标如果只有「把报错修掉」,保护机制本身就可能成为它想消除的障碍。我们得把「哪些错误必须继续被拒绝」写进验收。
下面用普通 JavaScript 测试说明这个差别,假定测试环境中的 app 和 db 已由项目提供。
it('拒绝伪造支付通知,且不改变套餐', async () => {
  const before = await db.users.findById('user-test');

  const response = await app.request('/api/stripe/webhook', {
    method: 'POST',
    headers: {
      'content-type': 'application/json',
      'stripe-signature': 'invalid',
    },
    body: JSON.stringify({
      type: 'checkout.session.completed',
      data: { object: { payment_status: 'paid' } },
    }),
  });

  expect(response.status).toBe(400);
  const after = await db.users.findById('user-test');
  // 响应拒绝还不够,业务状态也不能提前发生变化
  expect(after.plan).toBe(before.plan);
});
最容易漏掉的是最后一行,只检查 HTTP 状态,仍可能放过先改套餐、后返回错误的处理顺序。
这段只是负向用例骨架,订单和用户绑定、重复通知、真实支付状态还要结合项目补齐。它的价值是把「必须拒绝」变成明确的行为要求。
共享夹具契约检查文章则提醒了另一个位置。代理可能修改共享 fixture 的作用域、增加空值兜底,或者删除保护性断言,让很多测试一起变绿。
虽然文章讨论的是 pytest,但对前端也很好理解。共用的登录 mock、权限准备逻辑、接口桩,同样会改变测试前提。这是我从它的方案里延伸出的审查方向,不代表那套插件已经覆盖 JavaScript 项目。
测试通过之前,先确认测试还在检查原来的事。
你要是也在做 AI 补丁验收,今天就能挑一个最近修过的权限或支付问题,补一条非法输入必须失败的用例,再看补丁有没有碰共享准备逻辑。证书问题则直接用错误证书验证拒绝路径,别让一次成功请求替所有情况签字。
四、Claude Code 长任务转后台后,退出终端还能继续吗?
后台任务最容易制造一种错觉,界面不等了,工作就已经独立运行了。
Claude Code 服务端 MCP tasks 介绍称,这项能力已进入公开测试,要求 CLI v2.1.304 或以上版本。服务器先返回任务信息,随后继续工作,客户端轮询状态。
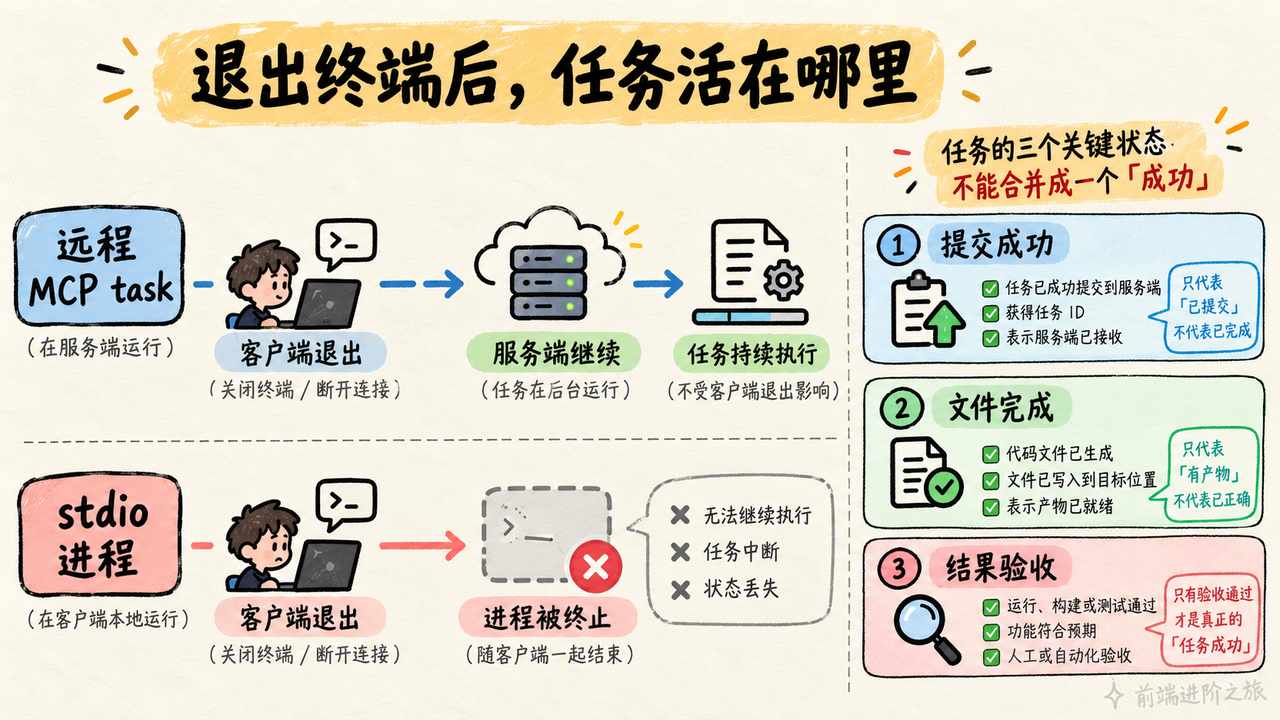
它和普通调用自动转后台不是一回事。文章称,普通长调用默认两分钟后可以转后台,但那条路径不会因此变成能跨会话存续的 MCP task。远程服务器上的任务可以在退出客户端后继续;stdio 服务器则会随客户端退出而停止,除非服务端另有明确的存活机制。
任务到底活在哪里,得先问清楚。
这个问题不只影响编程工具。单张照片生成演唱会的开发记录把交付拆成了几个节点,提交成功、文件完成、人脸正确。
它们不能合并成一个 success。
接口接收任务,只能证明开始处理;拿到文件,只能证明有产物;人物是否符合要求,还要单独验收。该服务还把积分恢复与现金退款分开记录,避免把技术失败和售后结算揉在一起。
前端做进度页时,这些区别很实际。页面只展示一个旋转图标,用户不知道该继续等、重新提交,还是联系客服。后端如果也只有「处理中、成功、失败」,重复回调和补偿就更难解释。
我的取舍是,长任务先设计生命周期,再设计漂亮的进度条。至少要能回答任务由谁执行、客户端断开会怎样、取消是否真的停止执行、产物在哪一步验收。
文章并没有给出这些机制在所有服务端上的统一实现,所以不能指望升级 CLI 就自动解决。当天可以拿一个可丢弃的测试任务,分别关闭页面、退出 CLI、重启客户端,观察服务端状态与最终结果;涉及积分的流程,再补一次重复回调,确认不会重复扣减或返还。
五、MCP 工具越多越好吗,RAG 加个阈值就能放心回答吗?
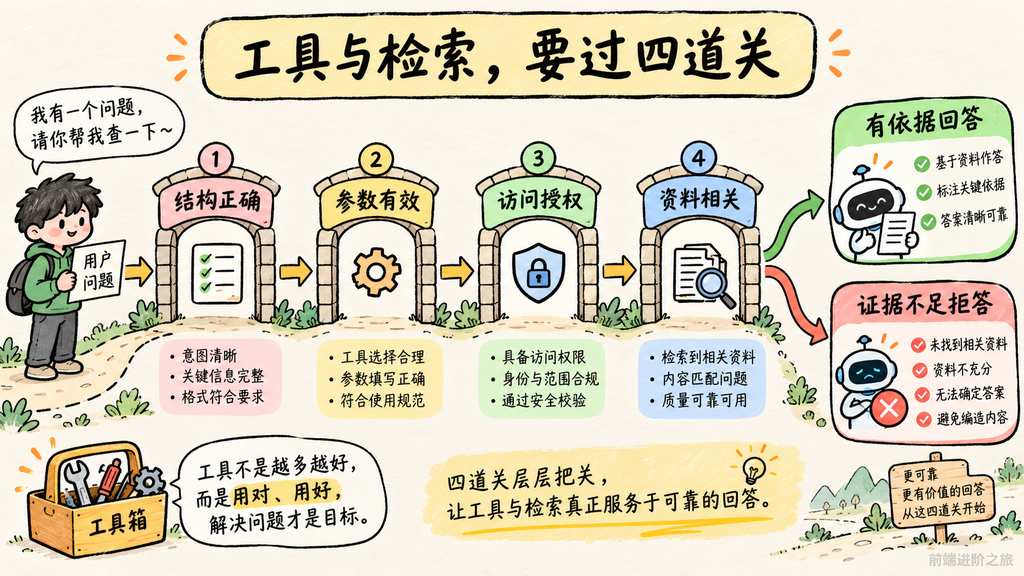
大概率你也遇到过,工具都接好了,模型却选错接口;资料明明检索到了,答案还是对不上问题。
这两种问题放在一起看,接口设计比提示词口气更值得先查。
精简 MCP 工具定义的文章展示了从 15 个工具缩到 4 个的思路。工具名称、描述和参数都要占上下文,职责重叠还会增加选择负担。
不过,这条材料内部的调用次数有出入,摘要写从 7 次降到 2 次,节选写降到 1 次。因此,我只把它当成减少工具定义开销的案例,不引用具体降幅来算收益。「工具少了」也不能直接推出「费用降了」,还得看单次返回内容与任务质量。
vLLM 工具调用排查文章补上了另一层。模型、聊天模板和解析器不匹配,或者流式参数还没拼完整就解析,都可能让工具调用失败。语法约束能限制结构,却不能保证选对工具、填对订单号。
格式合法,只是开始。
纯 Python RAG 教程也在处理类似的边界。它把相关度不足时的拒答放到生成之前,并保留来源引用,这个控制流值得借鉴。但示例 TF-IDF 阈值 0.10 依赖当前文档集,不能复制到另一套嵌入检索里就算完成调参。
更要紧的是,检索到相关资料也可能没有访问权限。现有应用接入 AI 助手的架构清单建议由应用后端执行身份、授权、检索和工具校验。先把无权访问的内容交给模型,再要求它保密,边界已经越过去了。
回到业务里,我会把这几件事连着验。工具结构正确、参数业务有效、当前用户有权执行,缺一项都不能继续。RAG 则要同时检查资料相关、来源可追溯、访问范围正确。
当天挑十个问题就能开始,混进几个无答案问题、相似名称订单和越权资料请求。看它是否选对工具、是否拒绝猜答案、是否在检索之前过滤权限,再决定该改工具定义、解析器还是检索规则。
六、前端做 AI 视频,为什么先审静帧比直接出整片更划算?
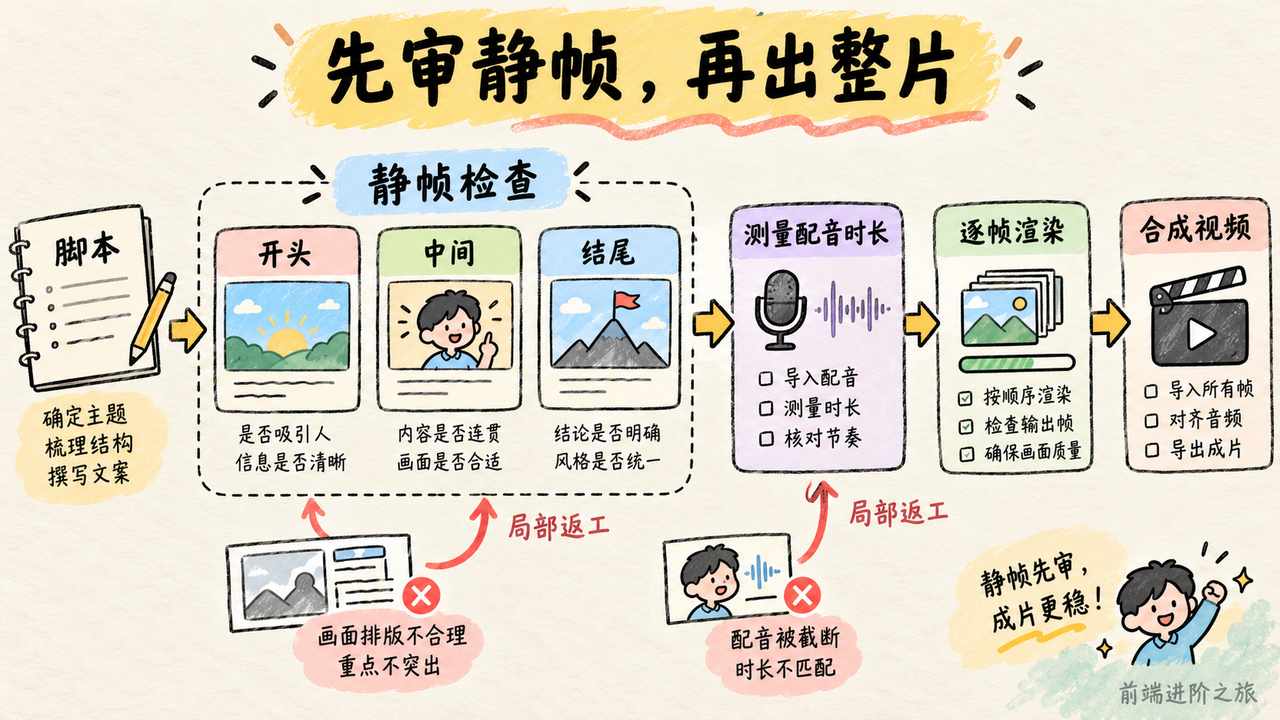
最后聊一条前端比较容易上手的方向,代码制片。
Claude 生成动画代码的实践采用 HTML 动画、Playwright 逐帧截图、ffmpeg 合成视频。核心接口是 window.renderAt(t),指定秒数,直接得到那个时间点的画面。
它要求画面由时间计算,避免依赖前面播放过哪些帧。修改第 84 帧时,就不用从头播放。这对做过 Canvas、页面动效的前端来说,是比较熟悉的控制方式。
作者在自己的设备上重复渲染同一帧,得到相同文件哈希。这个结果不能保证跨设备、跨浏览器一致,但足以说明为什么需要控制随机数、计时器和帧间状态。
Node 与 ffmpeg 短视频流水线则强调另一件容易漏掉的事,最终片段长度要听实际配音的。
模型计划写六秒,语音实际读了八秒,按计划截断就会吞掉句尾。文章采用测量音频时长后额外留 0.25 秒的做法,这是作者的经验值,不能当成所有语速都合适的固定参数。字幕同步也只是近似估算,不能直接拿去承诺精确对齐。
我喜欢这两篇的地方,是它们把返工位置说清楚了。布局不好,先改静帧;语音超长,回去改旁白;人物镜头不合格,尽量只重做人像部分。整片重新生成,看着省操作,实际可能把已经验收的内容一起推倒。
对于技术管理者,这类流程的成本也更容易拆开看。规划调用、图片生成、配音、浏览器渲染、最终合成,各自失败就各自记录,别全部算成一次「视频生成失败」。
当天试一个六秒产品片段就够了,先检查开头、中间、结尾三张静帧,再测一次配音长度,确认布局和句尾都正常后跑完整渲染。先别追求全自动,把最常返工的那一段拆出来,通常更容易看见收益。
总结
10 月 26 日这批消息里,有几件事可以按来源明确区分。Terra 发布介绍给出了标准 API 价格与计算机操作评测;Kimi 的报道写明了当前产品入口和计划中的权重开放日期;南北阁模型的参数、上下文与许可也有具体说明。厂商自测成绩、作者项目记录和订阅额度外推,则各有各的条件,不能混成一份选型排行榜。
我的判断是,接下来 AI 编程的差距会越来越多地出现在验收和调度上。谁能少绕路、少返工、保住权限与安全约束,谁才更可能降低真实交付成本。模型写得快当然有用,但如果节省的时间又花在追查错误状态和修补绕过逻辑上,就得重新算账。
还没被这些文章证明的,是换模型之后你们仓库能提升多少、缓存读取会吃掉多少额度,以及长任务退出客户端后究竟能活多久。这些答案最好从自己的任务记录里长出来。
如果今天只留一句给同事,我会说,模型可以继续挑,验收条件先写清楚。
参考
- Kimi K3.1 Pro 长任务编程与接入介绍|dev.to
- Introducing GPT-6.1 Terra|OpenAI
- Nanbeige4.3-33B 开放编程模型|MarkTechPost
- Claude Code 与 Codex 订阅额度测量|dev.to
- Claude Code OpenTelemetry 用量与成本分析|dev.to
- 小模型级联调用的成本计算|dev.to
- SQLite 预占与结算额度账本|dev.to
- 关闭证书校验的 AI 修复审查|dev.to
- AI 生成 Stripe 集成的常见漏洞|dev.to
- 共享夹具契约与影响范围检查|dev.to
- Claude Code 服务端 MCP 长任务|dev.to
- 单张照片生成演唱会的工程记录|dev.to
- 精简 MCP 工具定义|dev.to
- vLLM 工具调用准确性排查|dev.to
- 会在依据不足时拒答的 RAG|dev.to
- 现有应用接入 AI 助手的架构清单|dev.to
- Claude 生成动画代码与逐帧视频渲染|dev.to
- Node 与 ffmpeg 的 AI 短视频流水线|dev.to
- 前端进阶之旅