
9.0
重磅
AI SCORE
编程提效2026-09-25 18:52
AI SRE智能处理值班警报:自动根因分析并提PR修复
dev.to · AI#Agent#SRE#自动化
Editor brief · 编辑速览
团队用AI Agent替代人工完成值班首小时的根因分析, skeptic Agent质疑其他Agent结论,高置信度时直接开可合并PR修复。
on-call 时最令人恐惧的环节是排查 Root Cause 的第一个小时。事实证明,这恰恰是 AI Agent 团队今天完全能承接的工作。于是我们搭建了一套系统,让它指向一个 Kubernetes 集群,然后观察它如何与自身辩论。
几乎每个事故的头一个小时都是体力活。找服务、查最近一次部署、读日志、形成假设、猜测自己有多确定。每次都是相同的流程,通常在凌晨 2 点,通常还有某个重要的人被叫醒。
我们构建了一套系统:告警触发后,唤起一组只读 AI Agent,像 SRE 一样进行调查。然后一个怀疑者 Agent——它的全部「人格」就是质疑其他 Agent——会试图把结论推翻。置信度靠的是共识赢得的,不是自封的。
当遇到高置信度的代码缺陷时,它会打开一个真实可合并的 Pull Request 附上修复方案,然后把整个排查过程丢进 Teams。只读。临时。顾问性质——最终还是要由人来合并。
这不是把聊天机器人绑在 runbook 上。这是业界开始称之为 AI SRE 的东西,它是企业级 AI 实际走向的一个预览:Agent 做那些无聊、昂贵的头一个小时,这样人类从有趣的环节开始。
什么东西坏了。监控面板变红了。某人的夜晚结束了。
而第一个小时永远是一套相同的套路。哪个服务。什么东西变了。日志怎么说。这是新问题,还是周二那个我们发誓修好了的老问题。回滚还是正向修复。
没有一样是创造性的工作。这是一份清单,一个疲惫的人在压力下执行,同一个清单,同一个顺序,每次事故,永远如此。与此同时,那台本可以运行这个清单的机器就坐在旁边,闲置着,像一个带有月订阅费的昂贵镇纸。
第一个小时不是创意工作。它是在压力下做的机械工作。而这恰恰是对「把这个交给计算机」最精准的描述。
大多数「AI 运维」演示都在这里翻车。它们做了一个聊天机器人。你问它哪里出了问题。它给你写一段漂亮、结构良好的文字。
同时,它还经常、自信地、滔滔不绝地把整个事情编造出来,因为它压根没有看过任何东西。
Root-cause analysis 不是一道问答题。它是一场调查。收集证据、关联部署、形成假设、自我质疑、得出结论。所以我们没有写一个大 prompt 然后祈求好运。我们建了一支团队。如果你想要业界正在流行的术语,叫它 AI SRE。不是那种能做人类 SRE 所有事情的 Agent。只是所有人最讨厌的那部分——第一个小时。
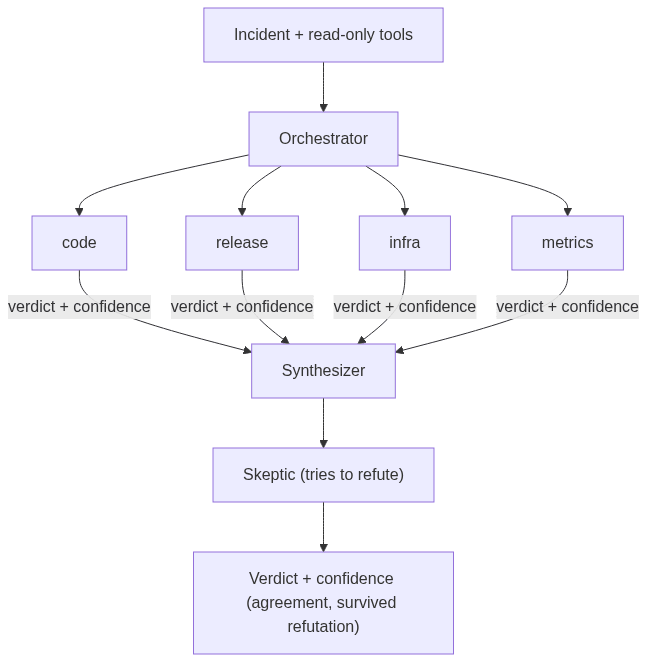
四个专家,各自用自己的只读工具独立调查。一个看代码,一个看最近的发布,一个看基础设施,一个看指标。一个综合器合并他们的发现并裁决分歧。还有一个怀疑者,只拿到结论,被告知的核心意思是:「证明他们错了。」
置信度不是模型用同样欢快的语气说「95% 确定」,不管它答对还是幻觉。置信度是挣来的。有多少独立的专家得出了相同的原因,以及怀疑者是否没能推翻它。
告警触发。调度器为每个事故启动一个临时 Kubernetes Job,承载整个团队。它只读调查,发布带置信度评分的裁决,如果存在真实的代码修复,就打开一个 Pull Request。
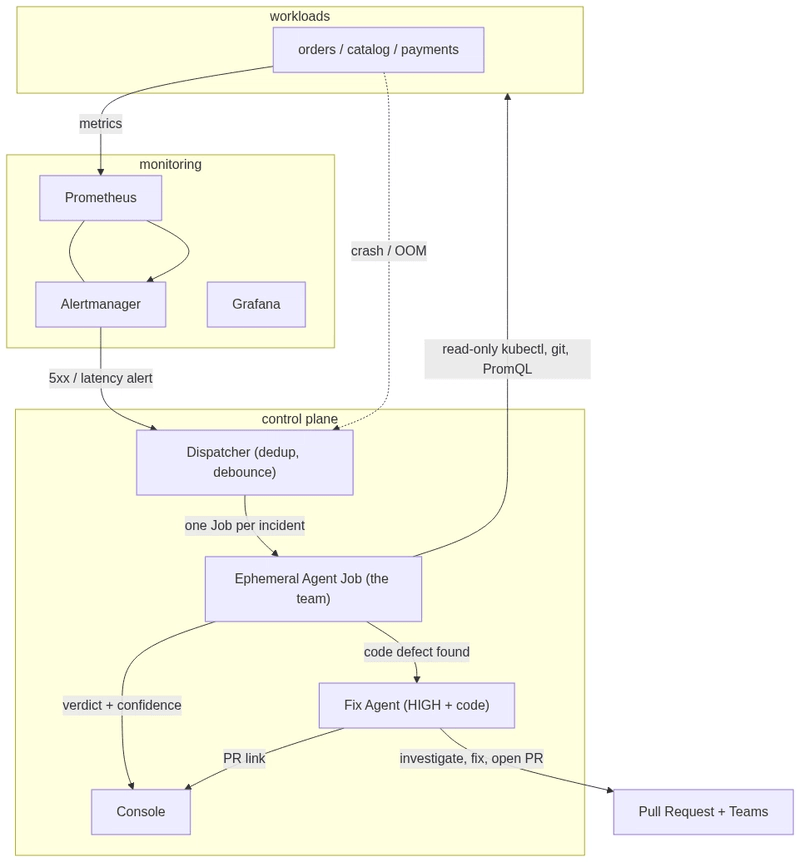
整个控制平面故意做得很小、很无聊。没有框架、没有向量数据库、没有我们不好意思展示的十二服务架构图。调查 Agent 只能读。它物理上无法触碰任何东西。整个系统中唯一会写东西的是修复 Agent,而它能做的最坏的事就是提议一个变更等人类审批。
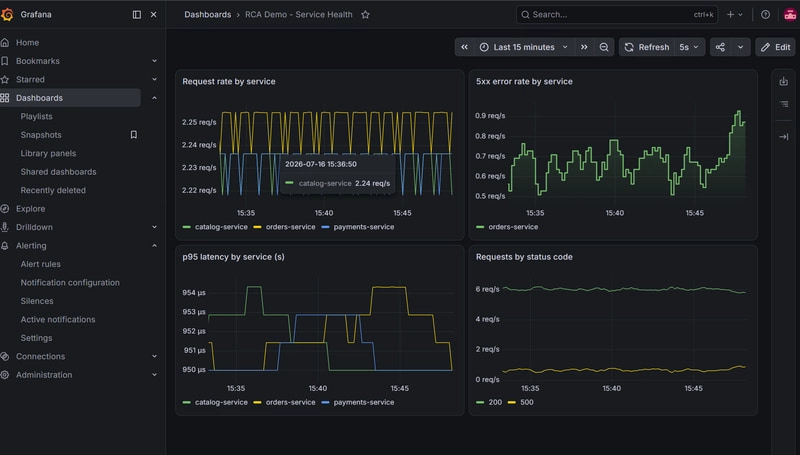
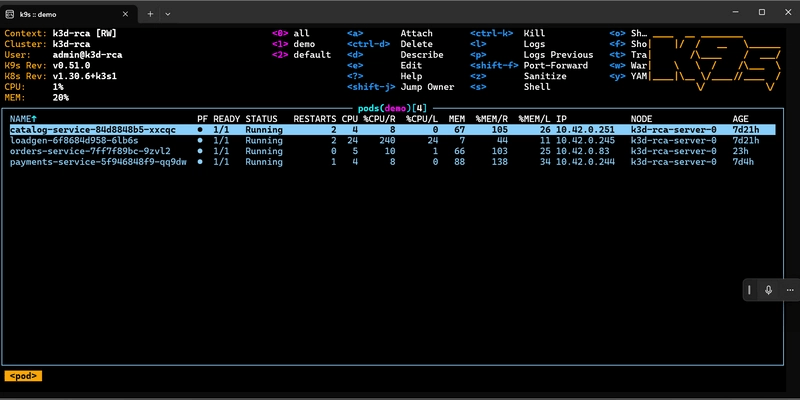
我们给一个服务植入了一个潜伏 bug,然后把它打开。错误率攀升,告警触发。
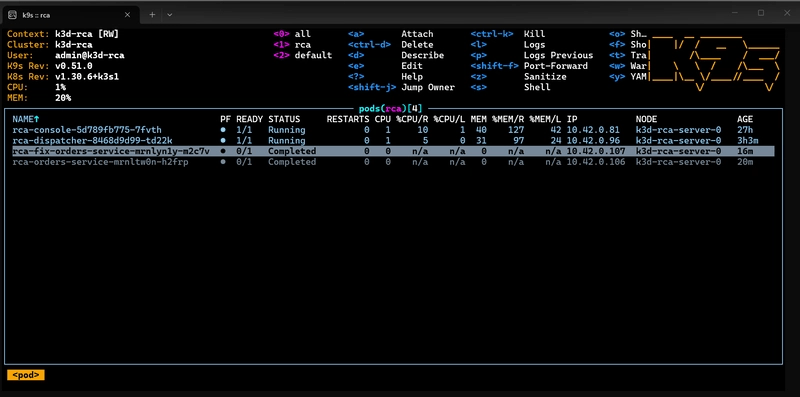
调度器启动了一个 Agent Job。这一步奇怪地让人满足。你看着调查者出现、干活、然后消失,像一个真正干完活就走的承包商。
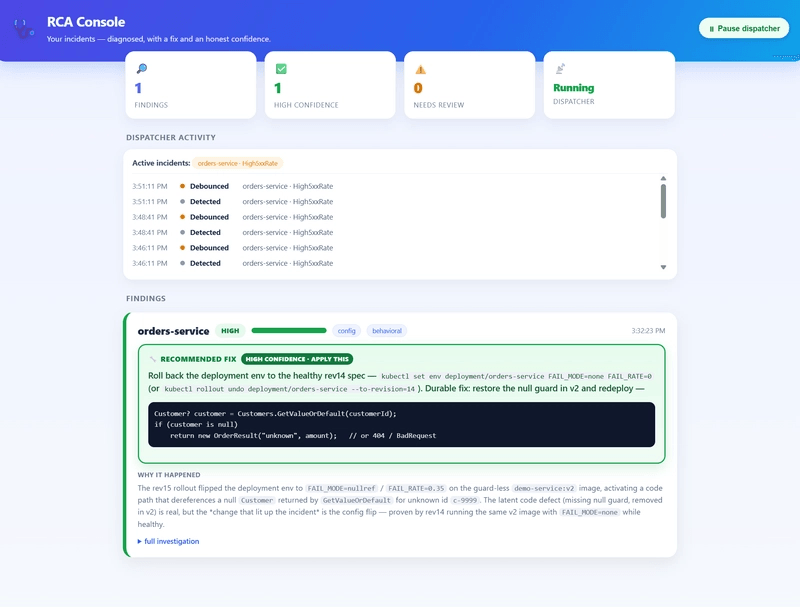
几分钟后,一个裁决。不是一堆日志。而是一个诊断、一个置信度仪表,以及精确的修复方案。
以下是那个临时 Job 内部发生的事情。
在我们的事故中,团队分裂了。两个 Agent 说问题在代码里。两个说是配置变更。没人会同意任何事情,而事故就杵在那儿,满不在乎,好像它有一整天时间似的。而作为一个事故,它确实有。
一个单独的大模型会选一个,用全部的自信说出答案,然后以出色的语法在 40% 的情况下出错。这里的分歧本身就是信号。两边都对。确实存在一个真实的代码缺陷,而配置变更是导火索。怀疑者没能推翻它,两个专家达成一致,所以裁决返回 HIGH confidence。挣来的,不是感觉出来的。
机器在技术上是正确的。触发因素是配置变更。最烦人的那种正确。
但是那里确实躺着一个真实可修复的 bug,敞开着。所以我们做了一个决定。如果存在具体的修复方案,就提出它,不管我们给事故贴什么标签。诊断和修复是两个不同的问题,而我们一直让一个否决另一个。
所以它就这么做了。它算出了最小安全变更,写成文档,打开了一个供人工审查的 Pull Request。一个真实的。会合并的那种。我刷新了两次页面确认它不会收回去。
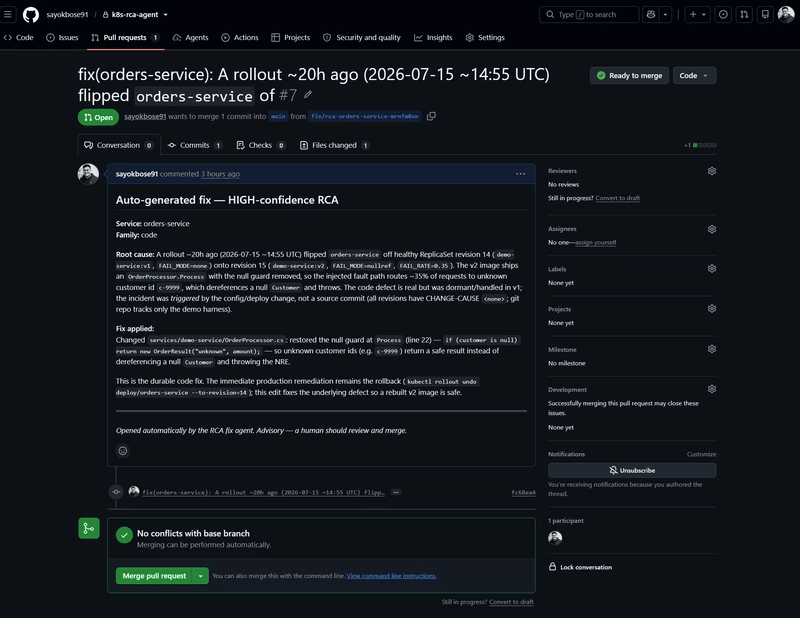
两件事坑了我们。都是那种踩到钉耙式的教育意义。
它在频道里刷屏。第一个版本有很多看法,而且它要分享出来。每隔几分钟。在频道里。永远。罪魁祸首是一个隐蔽的问题。一个喷错误的服务的某个 Pod 完全健康。什么都在崩溃。它正微笑着返回失败,心跳绿色,竖起大拇指。所以我们的「一切正常」信号不断触发,重置了一切,重新跑了一遍整个流程,形成循环。修复方案是:只有当告警真正消除时才认为事故已解决,而不是当 Pod 感到乐观时。一个事故,一条通知。
然后它把整个故事、根因、建议的修复方案和提议的变更,发布成一张整洁的卡片,这样人类可以在正确的地方讨论它。
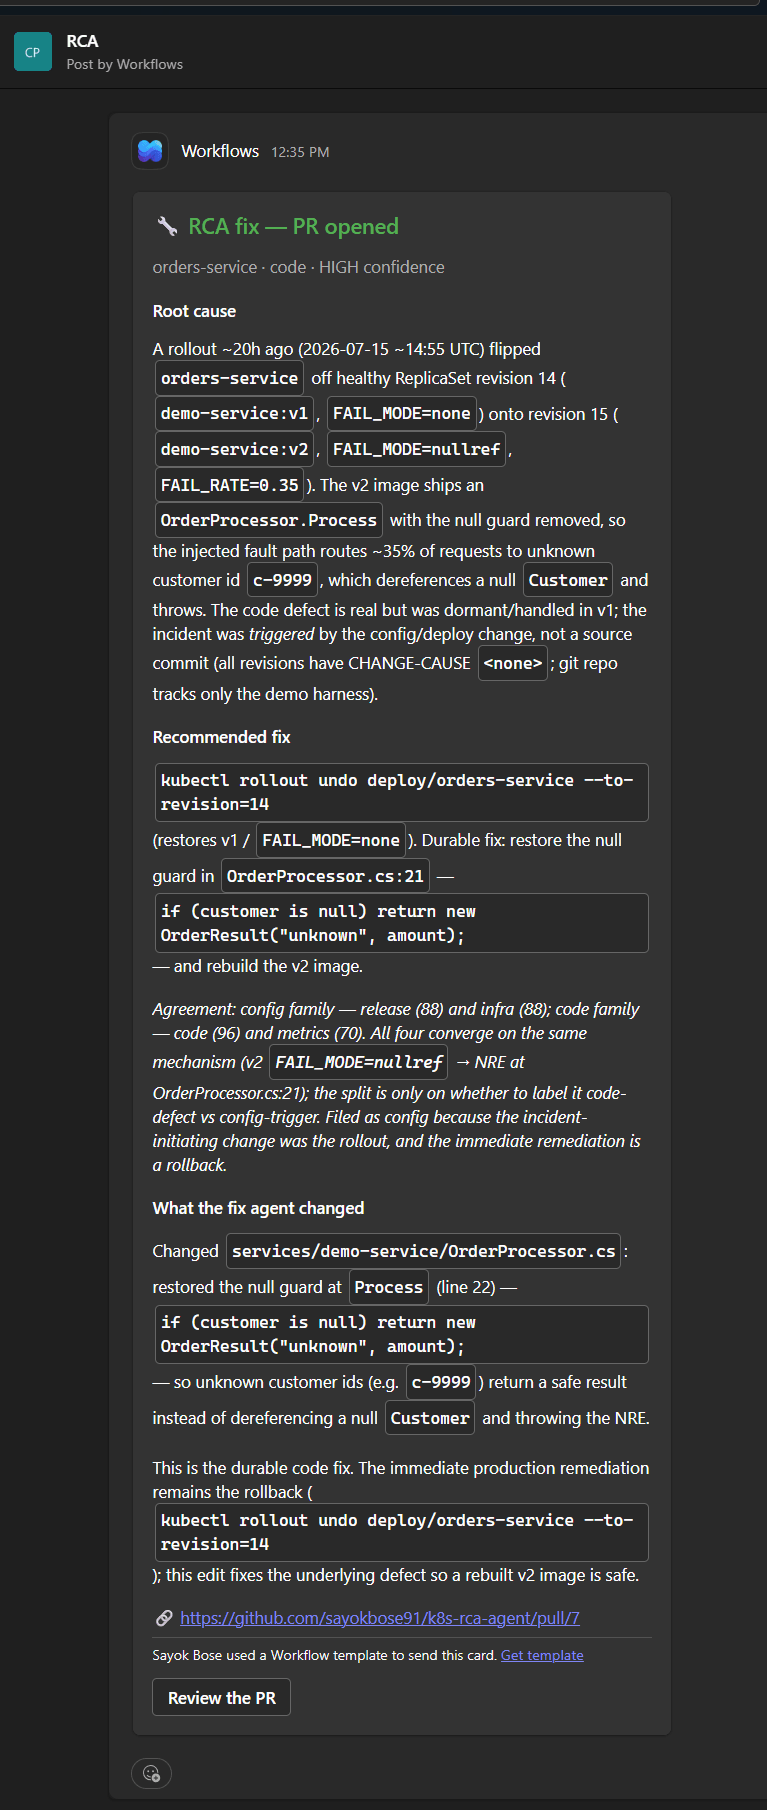
像这样的 AI SRE 之所以不仅仅是一个花哨把戏,取决于几个无聊但承重的属性。
成本随事故增长,而不是随服务增长。Job 只在调查期间存在,调查结束就消失了。一万个健康的服务费用正好是零。
默认只读。调查 Agent 什么也改不了。它唯一产生的东西就是一个供人签字的建议。
而且它可移植。把本地监控换成你云上已经在跑的东西,大脑是一样的。触发器和证据变了。团队不变。
有一个问题真的、令人惭愧地难。就是:这是和上次一样的那个事故,还是一个恰好看起来一模一样的全新问题?目前我们按症状匹配,而两个完全不同的 bug 可能抛出完全相同的告警。
要知道这真的是同一个问题,需要一个被诊断出来的原因的指纹,而这只有在调查之后才会存在。所以下一个构建是 memory。过往事故的记录,这样重复出现的事故直接短路到「见过这个,这是上次管用的方法,不谢。」之后,再关联一个原因跨多个告警,以及一个学习循环:被接受的修复方案提升置信度,被拒绝的降低置信度。
有趣的在后面。判断。权衡。「我们是在 CEO 盯着监控面板的时候回滚还是正向修复」。
所以把体力活交给机器。收集证据、关联部署、带着一个你真正能信任的置信度写出假设的第一个版本。判断留给自己。反正那部分本来就更好。
如果你今晚要 on-call,这是我的问题。当寻呼机响的时候,你实际上想要一个 Agent 递给你什么?证据、假设、还是可以直接审查的修复方案?在评论区告诉我。尤其是当你答案是「一份不同的工作」的话。