
8.0
热点
AI SCORE
技术实践2026-09-26 00:29
AWS EKS上MoE强化学习训练吞吐量提升40%
AWS ML Blog#AWS#强化学习#MoE
Editor brief · 编辑速览
AWS博客详解在EKS上使用EFA和DeepEP扩展MoE强化学习,RLHF和GRPO训练吞吐量提升40%。
当使用人类反馈强化学习(RLHF)或群体相对策略优化(GRPO)在规模上对专家混合(MoE)模型进行后训练时,会面临三个同时存在的挑战。第一个挑战是需要协调异构计算资源来完成 rollout 生成和策略训练。第二个挑战是在数百个加速器之间维持高吞吐量通信。第三个挑战是动态编排每个子系统以保持它们之间的平衡。在 AWS 上,你可以使用 Amazon Elastic Kubernetes Service(Amazon EKS)、Elastic Fabric Adapter(EFA)和 DeepEP 来应对这些挑战。
专家混合(MoE)已成为将大语言模型(LLM)扩展到数千亿甚至数万亿参数的标准架构,同时通过稀疏性保持高效推理。然而,稀疏性并不能消除训练中的基础设施复杂性。作为标准训练流程的一部分,这些模型必须经历预训练、中期训练、监督微调(SFT)和强化学习(RL)。在这些阶段中,大规模 RL 训练对基础设施提出了不同寻常的需求,因为它将弹性推理工作与需要高带宽通信的紧耦合模型训练结合在一起。奖励模型、验证器和检查点更新进一步增加了内存、网络和编排压力。当你在共享资源上运行模型训练、推理和评估时,如果不造成瓶颈或不使容量闲置,这类多工作负载优化反映了一种常见的基础设施挑战。
与密集模型相比,后训练 MoE 模型引入了一个新的基础设施挑战:随着更新的 MoE 架构变得越来越稀疏以降低推理成本,训练越来越多地受到通信约束而非计算约束。这种通信开销的一个主要来源是专家并行(EP)。EP 引入了跨设备的动态 all-to-all token 路由,除了张量并行(TP)、数据并行(DP)和流水线并行(PP)的密集、结构化通信模式之外。在紧耦合的异步 RL 工作负载中,MoE 训练的异构计算和通信需求必须与基于推理的生成保持平衡。缓慢的训练步骤会阻塞推理工作进程,而推理吞吐量不足则会使训练加速器闲置。这一挑战在大规模强化学习工作负载中很常见,包括基于近端策略优化(PPO)的 RLHF 流程和 GRPO 等更新的方法。
PPO 通常使用 critic 模型来估计策略优化过程中的值,而 GRPO 则通过使用基于群体的相对奖励来避免对独立 critic 模型的需求。尽管它们的算法和模型需求不同,但两者都施加了类似的基础设施需求:大规模 rollout 生成、紧耦合策略训练和高带宽节点间通信。
在这篇文章中,我们描述了一种优化架构,用于加速结合 Amazon Elastic Kubernetes Service(Amazon EKS)和 EFA 的 MoE 训练,以编排和加速大规模 RL 训练,以及 DeepEP 如何通过 EFA 优化专家并行通信。
大规模 RL 训练面临三个相互关联的挑战:
大规模异步 RL 作业有两个不同的同时工作负载需要优化:rollout 生成和策略训练。在 rollout 生成期间,系统执行大规模分布式推理,专注于最大化聚合吞吐量,而不是最小化首个 token 时间(TTFT)或 token 间延迟。相比之下,策略训练需要紧耦合的工作进程,这些工作进程像预训练或 SFT 一样步进式推进。任何延迟峰值或落后工作进程都可能阻塞整个作业或触发 NVIDIA 集合通信库(NCCL)超时。RL 系统必须平衡这两个工作负载,因为它们速率的任何不匹配都可能导致硬件闲置或引入训练不稳定。
图 1:异步 RL 循环,其中 rollout 工作进程通过分布式推理生成经验,而策略训练工作进程消费批次并更新模型权重
RL 工作负载具有异构的计算和通信需求。因此,任何 RL 系统都必须平衡三个资源约束:加速器计算、内存和网络带宽。策略训练是计算密集型的,必须跟上 rollout 生成的步伐。同时,分布式推理必须管理 KV 缓存容量和 token 生成。平衡内存带宽和计算对于最大吞吐量至关重要,因为 MoE 层添加了稀疏的动态 all-to-all 通信,当 token 跨设备路由时。奖励模型在训练期间提供反馈,数据移动进一步增加了压力。所有这些子系统必须共同平衡,以帮助防止任何一个成为瓶颈。
随着 RL 训练作业扩展到单个实例之外,模型分区和并行组跨越多个节点,通信从高带宽节点内 NVLink 结构转移到较低带宽的节点间链路。MoE 模型加剧了这种转移:与张量并行和流水线并行的结构化模式不同,专家并行通过稀疏、细粒度的 all-to-all 通信流量动态跨设备路由 token,随着专家并行度增长,这种通信越来越多地发生在节点间。
图 2:多节点 MoE 训练中的通信域,其中 NVLink 承载高带宽节点内流量,而 EFA 处理专家并行、张量并行和数据并行的节点间 token 路由
AWS 加速计算实例(如 P5 和 P6)使用两个主要通信域:节点内 NVLink 结构(通常通过 NVSwitch 连接)和通过 EFA 的节点间网络。EFA 在实例之间提供高带宽通信流量。在支持的配置上,EFA 与 NVIDIA GPUDirect RDMA 和 OS bypass 配合使用,将数据直接从 GPU 内存缓冲区跨实例传输,减少了通信路径中 CPU 和操作系统的参与。在 RL 工作负载中优化带宽利用率需要平衡这两个通信域,确定哪些操作可以在 EFA 上高效运行,哪些必须保留在 NVLink 结构内。
为了在 AWS 上扩展 RL 工作负载,我们结合了 Amazon EKS、EFA 和 Amazon Simple Storage Service(Amazon S3),以便编排、高性能通信和持久存储可以独立扩展。使用 Amazon EKS,你可以管理异构工作进程的生命周期和放置。使用 EFA,你可以获得通信密集型 GPU 工作负载的节点间数据路径。使用 Amazon S3,你可以存储数据集、模型检查点和已完成的训练工件,包括模型权重。以下部分描述了如何映射 RL 系统的不同层,包括编排、高性能网络和持久存储,以及每一层如何独立扩展。
Amazon EKS 集群包含针对 RL 工作流每个阶段优化的单独节点组。GPU 加速实例运行 rollout 生成、奖励模型推理和策略训练,而 CPU 实例执行环境和预处理任务。内存优化实例托管经验缓冲区和检查点缓存,允许生产者和消费者交换数据,而无需将持久存储直接放在关键路径上。
图 3:EKS 集群拓扑,包含用于策略训练和 rollout 生成的 GPU 节点组、用于环境工作进程和预处理的 CPU 节点组,以及用于经验缓冲区和检查点缓存的内存优化实例
在 rollout 期间,模型通过与基于 CPU 的环境 pod 交互生成样本,生成的经验流入内存优化缓冲区。然后,策略训练步骤消费批次、更新模型权重,并发布反馈到下一轮 rollout 生成的新检查点。检查点和已完成的训练工件也持久化到 Amazon S3 以进行持久存储、恢复和下游使用。策略训练、权重更新和新检查点生成都可以在 EKS 集群上运行。
网络与执行层
EKS 提供控制平面,负责调度、扩缩容、故障恢复以及跨不同工作组之间的协调。在 GPU 实例内部,NVLink 和 NVSwitch 提供高带宽的节点内通信。EFA 支持对分布式策略训练和其他紧密耦合的 GPU 操作进行延迟敏感的节点间通信。经验缓冲区与 Amazon S3 构成数据层,将高频样本和检查点交换与长期制品存储分离。
性能与成本优化
本节介绍两个关键优化:使用 DeepEP 降低 EFA 上专家并行通信开销,以及使用 Amazon Elastic Compute Cloud(Amazon EC2)Spot Instances 降低 rollout 生成的成本。
DeepEP 与其他拓扑感知的专家并行通信技术一样,是 MoE 工作负载的常见优化手段,旨在减少通信瓶颈。标准的 all-to-all 集合操作对密集、规则的通信效率最高,但 MoE 工作负载会产生稀疏、细粒度且不均衡的流量,因为 token 会根据路由动态分配到各个专家。当 Expert Parallelism 跨越多个节点时,同步和每条消息的开销都会增加,使得节点间通信成为主要瓶颈。DeepEP 通过用专用的 dispatch 和 combining 内核替换通用的 all-to-all 集合操作来解决这个问题。这些内核通过 NVSwitch 使用 NVLink 进行节点内通信,并使用支持 RDMA 的后端进行节点间通信。
Amazon 为将 DeepEP 的通信原语迁移到 libfabric 贡献了多项功能。这使得传输层可以在 libfabric 支持的网络结构之间移植,并在 EFA 上优化 MoE 训练。通过这些更改,DeepEP v2 获得了原生的 EFA 支持。此外,NCCL 2.31 包含了针对密集集合通信的最新 EFA 优化。在下一节中,我们将介绍 DeepEP over EFA 如何通过减少专家调度和合并操作的通信开销来提高 rollout 生成吞吐量。
DeepEP 如何通过 EFA 进行通信
DeepEP 用两个专用的 GPU 内核替换了标准的 NCCL all-to-all 集合操作:一个 dispatch 内核将 token 从本地 GPU 路由到远程专家,一个 combine 内核将处理后的 token 聚合回来。对于节点内传输,这些内核通过 NVSwitch 使用 NVLink。对于节点间传输,DeepEP 使用 libfabric 通过 EFA 发送数据。在 P5 和 P6 等支持的实例类型上,EFA 与 NVIDIA GPUDirect RDMA 配合工作,可以跨实例直接在 GPU 内存缓冲区之间传输数据,绕过 CPU 和操作系统。Amazon 的上游贡献将 DeepEP 的通信原语从 CUDA 特定的 RDMA 后端迁移到 libfabric。这使得传输可以在 EFA 支持的配置之间移植,并减少了 Expert Parallelism 生成的稀疏、细粒度流量模式中每条消息的开销。
在 48 个 P5en 实例(16 个用于训练,32 个用于推理)上运行超稀疏 MoE 模型,启用 DeepEP over EFA 后,聚合 RL rollout 吞吐量提高了 40%。图 5 显示了有和没有 DeepEP 的吞吐量对比。
Figure 5: 在 48 个 P5en 实例上,有无 DeepEP over EFA 的 RL rollout 吞吐量对比
用于 rollout 生成的 Spot Instances
Rollout 生成非常适合使用 Amazon EC2 Spot Instances,因为它由可以跨独立 worker 分区的分布式推理任务组成。与紧密耦合的 worker 必须同步推进的策略训练不同,一个 rollout worker 的中断不需要整个 RL 作业停止。未完成的 rollout 任务可以返回队列并重新分配,而其余 worker 继续生成经验。
通过 Amazon EKS,你可以根据 rollout 需求和队列深度扩缩容基于 Spot 的 rollout 节点组,同时为策略训练保持稳定的容量。Rollout worker 应该处理有界的任务单元并频繁发布已完成的样本。当 Spot 中断通知到达时,worker 会排空活动请求并将未完成的任务返回队列。这种分离有助于降低 rollout 生成成本。策略训练 worker 与 Spot 中断、延迟或 NCCL 超时隔离开来。
整体方案
本节逐步介绍如何配置前面各节描述的基础设施,从集群创建到运行启用 DeepEP 通信的 RL 作业。
在 Amazon EKS 上运行 RL 之前,请确认满足以下要求:
该架构可以通过将策略训练、rollout 生成和支持服务分离到独立管理的节点组来部署在 Amazon EKS 上。这保持了紧密耦合的训练工作负载与更弹性的 rollout worker 之间的隔离,同时允许每个组件使用针对其执行特性优化的容量模型。
托管节点组简化了配置、更新和实例生命周期管理。策略训练 worker 可以在稳定的 GPU 容量上运行,而 rollout 生成容量可以独立扩缩容,并在允许中断的地方纳入 Spot Instances。基于 CPU 的服务(包括编排和支持组件)可以放置在单独的节点组中,以避免与 GPU 工作负载争夺容量。
以下 eksctl ClusterConfig 定义了集群的通用 CPU 节点组和 GPU 加速器节点组:
apiVersion: eksctl.io/v1alpha5
kind: ClusterConfig

metadata:
  name: my-eks-cluster
  region: us-west-2
  version: "1.33"

managedNodeGroups:

# ------------------------------------------------------------
  # General-purpose CPU node group
  # ------------------------------------------------------------
  - name: general-purpose-ng
    minSize: 3
    desiredCapacity: 3
    maxSize: 6
    capacityType: ON_DEMAND
    privateNetworking: true
    launchTemplate:
      id: lt-xxxxxxxxxxxxxxxxx
      version: "1"
    labels:
      workload-type: general-purpose
    tags:
      Name: eks-general-purpose
      NodeGroup: general-purpose-ng
      Workload: general-purpose
    updateConfig:
      maxUnavailable: 1

# ------------------------------------------------------------
  # GPU / accelerator node group
  # ------------------------------------------------------------
  - name: accelerator-ng
    minSize: 3
    desiredCapacity: 3
    maxSize: 6
    capacityType: ON_DEMAND
    privateNetworking: true
    launchTemplate:
      id: lt-yyyyyyyyyyyyyyyyy
      version: "1"
    labels:
      workload-type: accelerator
      accelerator: nvidia-b300
    taints:
      - key: nvidia.com/gpu
        value: "true"
        effect: NoSchedule
    tags:
      Name: eks-accelerator
      NodeGroup: accelerator-ng
      Workload: accelerator
    updateConfig:
      maxUnavailable: 1
列出的 Ampere、Hopper 和 Blackwell 实例类型(p4d.24xlarge、p4de.24xlarge、p5.48xlarge、p5e.48xlarge、p6-b200.48xlarge 和 p6-b300.48xlarge)支持大规模 RL 训练,可用于 rollout 或训练工作负载。
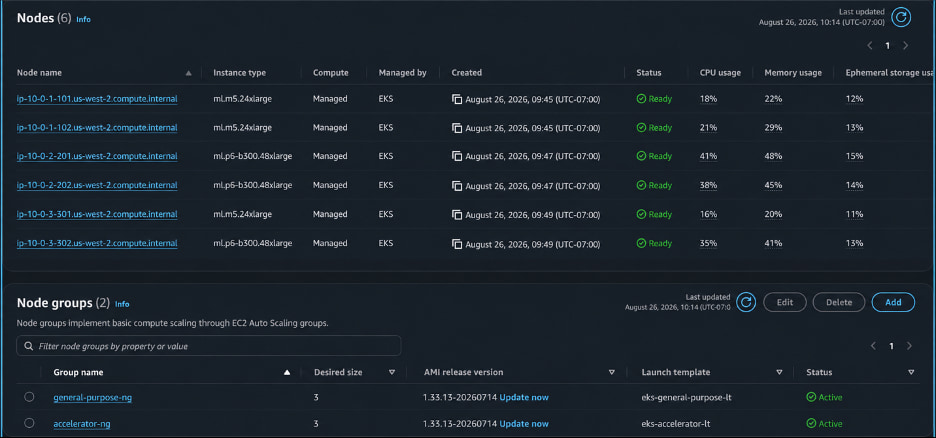
Figure 6: 展示 EKS 部署拓扑的代表性架构图,包含用于训练和 rollout 的 GPU 节点组(P5/P6)、用于推理 worker 的 Spot 支持容量,以及用于编排服务的 CPU 节点组。
配置 EFA 驱动和插件
为了在 Amazon EKS 上优化异步 RL,通信节点必须位于同一可用区(AZ),并且必须设置 EFA Kubernetes 设备插件。使用 EFA,你可以获得快速高效的模型更新、高性能模型训练和低延迟通信。要应用 EKS EFA 设备插件,你可以使用 kubectl 直接将其应用到集群。
apiVersion: apps/v1
kind: DaemonSet
metadata:
  name: aws-efa-k8s-device-plugin
  namespace: kube-system
  labels:
    app: aws-efa-k8s-device-plugin
spec:
  selector:
    matchLabels:
      app: aws-efa-k8s-device-plugin
  updateStrategy:
    type: RollingUpdate
  template:
    metadata:
      labels:
        app: aws-efa-k8s-device-plugin
    spec:
      # 仅安装在 accelerator 节点组上
      nodeSelector:
        eks.amazonaws.com/nodegroup: accelerator-ng
      priorityClassName: system-node-critical
      hostNetwork: true
      automountServiceAccountToken: false
      tolerations:
        - operator: Exists
      containers:
        - name: aws-efa-k8s-device-plugin
          # 当前 AWS EFA K8s device plugin
          image: 602401143452.dkr.ecr.us-west-2.amazonaws.com/eks/aws-efa-k8s-device-plugin:v0.5.20
          securityContext:
            privileged: true
            allowPrivilegeEscalation: true
            runAsUser: 0
            runAsNonRoot: false
          resources:
            requests:
              cpu: 10m
              memory: 20Mi
          volumeMounts:
            - name: device-plugin
              mountPath: /var/lib/kubelet/device-plugins
            - name: infiniband
              mountPath: /dev/infiniband
      volumes:
        - name: device-plugin
          hostPath:
            path: /var/lib/kubelet/device-plugins
        - name: infiniband
          hostPath:
            path: /dev/infiniband
更多说明和性能测试,请参阅 EKS EFA 设置指南。
参考实现整合了支持前几节所述优化所需的 CUDA、PyTorch、通信和推理组件。下表列出了基准测试环境:
保持这些组件对齐至关重要。GPU 内核、集合通信库和底层 EFA 传输各自都会影响端到端性能。使用 763104351884.dkr.ecr.<region>.amazonaws.com/sglang:0.5.17-gpu-py312-cu130-ubuntu24.04-ec2 镜像(SGLang 深度学习容器目录中提供)是实用的起点。以下 Dockerfile 可用于设置训练环境。
# syntax=docker/dockerfile:1.7

# 来自 AWS 深度学习容器 SGLang 目录的参考基础镜像。
# 如果从其他区域拉取镜像,可在构建时覆盖 AWS_REGION。
ARG AWS_REGION=us-west-2
ARG SGLANG_DLC_TAG=0.5.17-gpu-py312-cu130-ubuntu24.04-ec2
FROM 763104351884.dkr.ecr.${AWS_REGION}.amazonaws.com/sglang:${SGLANG_DLC_TAG}

ARG BUILD_JOBS=16
ARG NVCC_THREADS=1

# 参考实现版本矩阵。
ARG PYTORCH_VERSION=2.12.1
ARG EFA_INSTALLER_VERSION=1.49.0
ARG NCCL_VERSION=2.31.2
ARG NVSHMEM_VERSION=3.7.2
ARG SGLANG_VERSION=0.5.17
ARG DEEPEP_VERSION=2.0.0
ARG DEEPEP_COMMIT=b306af06afd412c88e51e71802951606e40b7358
ARG MILES_VERSION=0.1.0
ARG MILES_REF=v0.1.0

# 保留原始 Dockerfile 中的现有优化锁定。
ARG DEEPGEMM_COMMIT=731e7c7a97d269e4b9f482ea18d0e709a948f293

ENV PIP_RETRIES=20 \
    PIP_DEFAULT_TIMEOUT=60 \
    LIBFABRIC_HOME=/opt/amazon/efa

RUN apt-get update && \
    apt-get install -y --no-install-recommends \
    autoconf automake build-essential ca-certificates cmake curl git \
    libtool ninja-build pkg-config patch

# 面向 CUDA 13.0 构建的 PyTorch 2.12.1。此处显式安装,不依赖基础镜像中碰巧附带的 PyTorch 次版本。
RUN pip install --no-cache-dir --force-reinstall \
    --index-url https://download.pytorch.org/whl/cu130 \
    "torch==${PYTORCH_VERSION}"

# 安装 EFA 1.49 用户空间栈及其 NGC 兼容的 OFI NCCL 插件。
# EFA 内核模块由 EKS/EC2 主机提供,不由本容器提供。
RUN apt-get remove -y libnccl-ofi && \
    rm -f /etc/ld.so.conf.d/aws-ofi-nccl.conf && \
    curl -fsSL "https://efa-installer.amazonaws.com/aws-efa-installer-${EFA_INSTALLER_VERSION}.tar.gz" -o /tmp/aws-efa-installer.tar.gz && \
    mkdir -p /tmp/aws-efa-installer && \
    tar -xzf /tmp/aws-efa-installer.tar.gz -C /tmp/aws-efa-installer --strip-components=1 && \
    cd /tmp/aws-efa-installer && \
    ./efa_installer.sh -y --skip-kmod --no-verify --build-ngc --skip-mpi

# DeepEP V2 使用 NCCL Gin。将 NCCL 保持在请求的 2.31 版本线上,并在编译 DeepEP 之前安装,以便构建时头文件和运行时库保持一致。
RUN pip install --no-cache-dir --force-reinstall --no-deps \
    "nvidia-nccl-cu13==${NCCL_VERSION}" \
    "nvidia-nvshmem-cu13==${NVSHMEM_VERSION}"

ENV DEEPEP_REPO=https://github.com/deepseek-ai/DeepEP.git \
    DEEPEP_SRC_DIR=/opt/amazon/DeepEP \
    TORCH_CUDA_ARCH_LIST="9.0 10.0 10.3 12.0" \
    CUDASTDCXX_INCLUDE=/usr/local/lib/python3.12/dist-packages/flashinfer/data/cccl/libcudacxx/include \
    DEEPGEMM_REPO=https://github.com/sgl-project/DeepGEMM.git \
    DEEPGEMM_SRC_DIR=/opt/amazon/DeepGEMM \
    TVM_FFI_CUDA_ARCH_LIST="9.0 10.0 10.3 12.0" \
    DG_FORCE_BUILD=1

ENV CPATH="${CUDASTDCXX_INCLUDE}" \
    CPLUS_INCLUDE_PATH="${CUDASTDCXX_INCLUDE}"

# 从锁定的公开发布提交构建 DeepEP。
RUN export MAX_JOBS="${BUILD_JOBS}" CMAKE_BUILD_PARALLEL_LEVEL="${BUILD_JOBS}" && \
    mkdir -p /opt/amazon && \
    rm -rf "${DEEPEP_SRC_DIR}" && \
    git clone --filter=blob:none --no-checkout "${DEEPEP_REPO}" "${DEEPEP_SRC_DIR}" && \
    cd "${DEEPEP_SRC_DIR}" && \
    git fetch --depth 1 --no-tags origin "${DEEPEP_COMMIT}" && \
    git checkout FETCH_HEAD && \
    pip install --no-cache-dir wheel && \
    python setup.py bdist_wheel && \
    pip install --no-cache-dir --force-reinstall --no-deps dist/*.whl

# 保留现有的 DeepGEMM 优化层。
RUN export MAX_JOBS="${BUILD_JOBS}" CMAKE_BUILD_PARALLEL_LEVEL="${BUILD_JOBS}" && \
    mkdir -p /opt/amazon && \
    rm -rf "${DEEPGEMM_SRC_DIR}" && \
    git clone --filter=blob:none --no-checkout "${DEEPGEMM_REPO}" "${DEEPGEMM_SRC_DIR}" && \
    cd "${DEEPGEMM_SRC_DIR}" && \
    git fetch --depth 1 --no-tags origin "${DEEPGEMM_COMMIT}" && \
    git checkout FETCH_HEAD && \
    pip install --no-cache-dir --upgrade "apache-tvm-ffi==0.1.11" && \
    ./build_sgl_deep_gemm.sh && \
    pip install --force-reinstall --no-de
通过 TorchX,你可以将 RL 工作负载提交到 Amazon EKS,同时将应用配置与基础设施配置分离。TorchX 将作业需求转换为 Kubernetes 资源,包括计算请求、存储挂载和运行时配置。这种分离使得在不将模型和训练配置与集群配置耦合的情况下变更它们变得更加容易。