
8.0
热点
AI SCORE
开源项目2026-09-25 14:40
Hindsight:让 AI Agent 真正学习的记忆系统
GitHub Trending#Agent#记忆系统#开源
Editor brief · 编辑速览
超越 RAG 和知识图谱的 Agent 记忆系统,在 LongMemEval 基准上达到 SOTA,专注让 Agent 从历史经验中学习而非仅记忆对话。
Documentation • Integrations • Cookbook • Benchmarks • Paper • Hindsight Cloud

Hindsight™ 是一个 AI 智能体记忆系统,旨在构建能够随时间学习的更智能的智能体。大多数 AI 智能体记忆系统专注于回忆对话历史。Hindsight 专注于让 AI 智能体学会学习,而不仅仅是记住。
它消除了 RAG 和知识图谱等替代技术的缺陷,在长期记忆任务上达到了最先进的性能。
记忆性能与准确度
快速上手 — 服务器 · 客户端 · 平台 · 嵌入式
将 Hindsight 集成到你的 AI 智能体 — LLM 包装器 · 集成 · 编程 AI 智能体 · MCP
核心概念 — 记忆类型 · 保留 / 召回 / 反思 · 观察 · 心理模型与知识页面 · 记忆库
生产环境运行
记忆性能与准确度
根据基准测试结果,Hindsight 是有史以来测试过的最准确的 AI 智能体记忆系统。它在 LongMemEval 基准测试上取得了最先进的性能,该基准测试被广泛用于评估各类对话 AI 场景下记忆系统的表现。以下是截至 2026 年 1 月,Hindsight 与其他 AI 智能体记忆解决方案的当前报告性能:
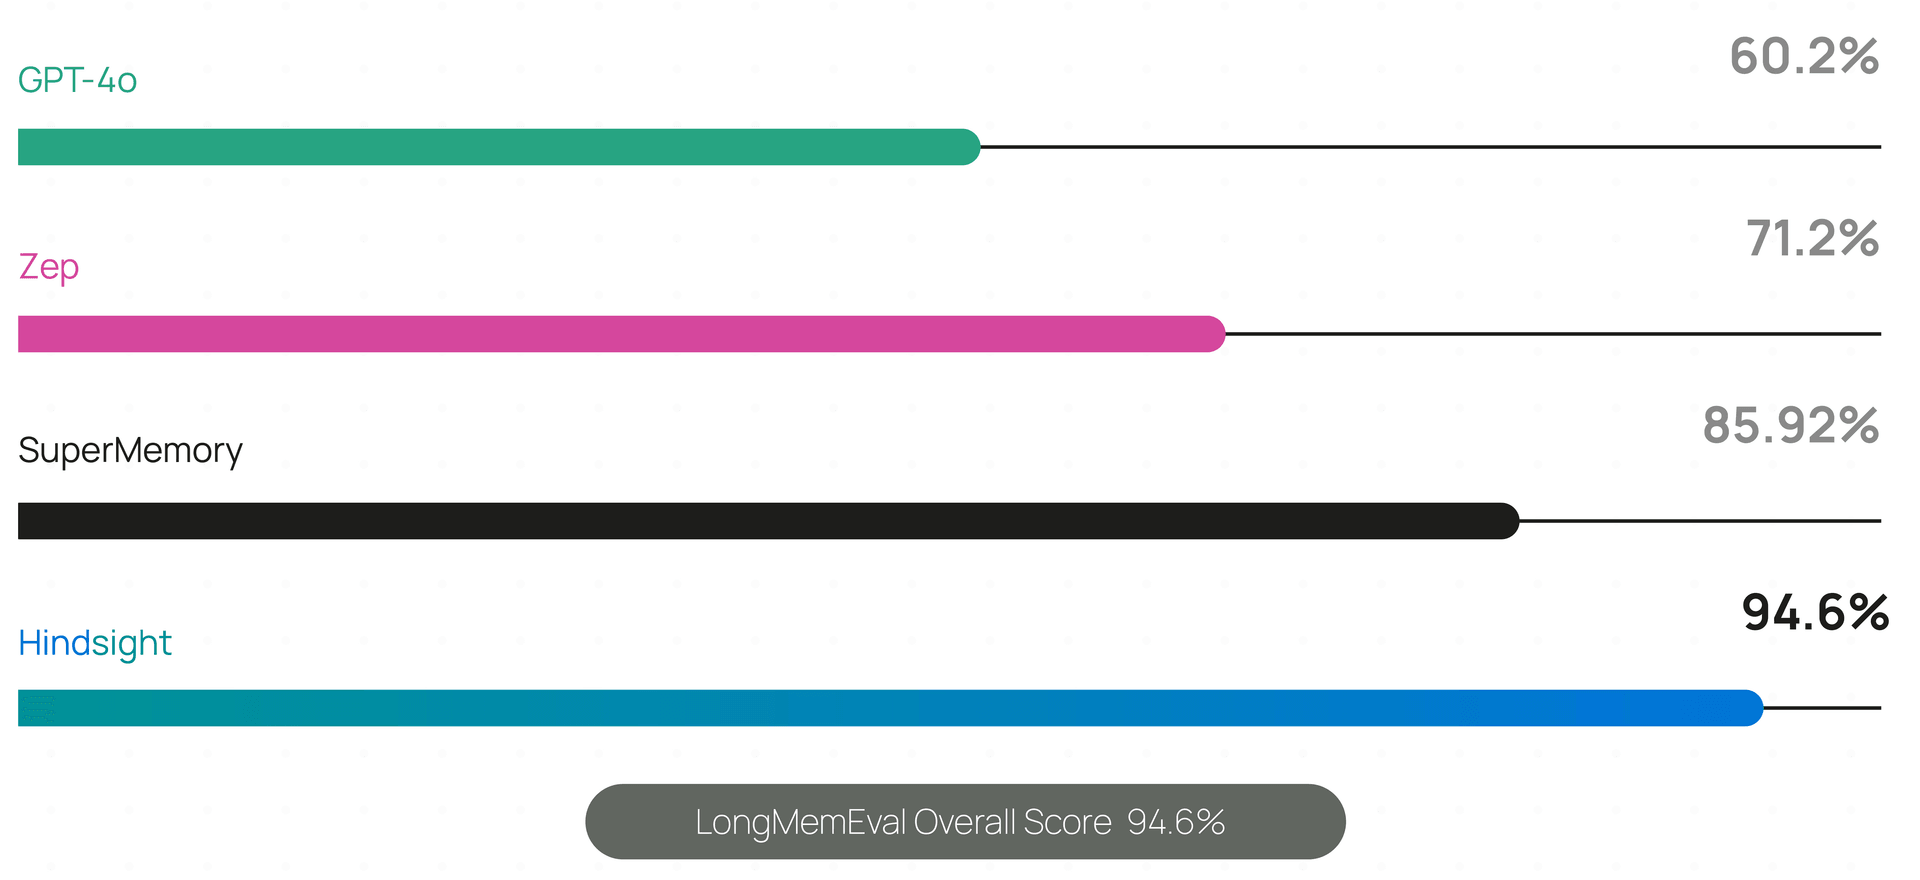
实时、持续更新的结果——包括各模型的准确率、延迟和成本——发布于 benchmarks.hindsight.vectorize.io。
Hindsight 的基准测试性能数据已由弗吉尼亚理工 Sanghani 人工智能与数据分析中心以及《华盛顿邮报》的研究合作者独立复现。其他分数由软件供应商自行报告。
Hindsight 已被财富 500 强企业用于生产环境,并有越来越多的 AI 初创公司采用。
🤖 使用编程 AI 智能体?安装 Hindsight 文档技能,获取即时文档访问:
npx skills add https://github.com/vectorize-io/hindsight --skill hindsight-docs
适用于 Claude Code、Cursor 等 AI 编程助手。
export OPENAI_API_KEY=sk-xxx

docker run -it --pull always --name hindsight --restart unless-stopped -p 8888:8888 -p 9999:9999 \
  -e HINDSIGHT_API_LLM_API_KEY=$OPENAI_API_KEY \
  -v hindsight-data:/home/hindsight/.pg0 \
  ghcr.io/vectorize-io/hindsight:latest
API: http://localhost:8888 UI: http://localhost:9999
Hindsight 通过 HINDSIGHT_API_LLM_PROVIDER 支持 25+ LLM 提供商——托管服务(openai、anthropic、gemini、groq、bedrock、vertexai、minimax、deepseek、atlas、meta……)、完全本地化(ollama、lmstudio、llamacpp)、任何兼容 OpenAI 的端点,以及网关(litellm、litellmrouter)可访问其余提供商。现有的订阅也能用:openai-codex(ChatGPT Plus/Pro)、claude-code(Claude Pro/Max)、cursor(Cursor)和 github-copilot(GitHub Copilot)无需 API 密钥。详见支持的模型。
export OPENAI_API_KEY=sk-xxx
export HINDSIGHT_DB_PASSWORD=choose-a-password
cd docker/docker-compose
docker compose up
Oracle AI Database 也支持企业级部署,功能完全对齐。详见存储文档。
pip install hindsight-api
export HINDSIGHT_API_LLM_API_KEY=sk-xxx

hindsight-api
helm install hindsight oci://ghcr.io/vectorize-io/charts/hindsight \
  --set api.llm.provider=openai \
  --set api.llm.apiKey=sk-xxx \
  --set postgresql.enabled=true
Hindsight Cloud 是托管版本:自动扩展的托管基础设施,外加仪表盘、备份、团队协作和 99.9% 可用性 SLA。按用量计费,入门有免费额度——无固定月费或按席位收费。用你的 API 密钥将任意客户端指向 https://api.hindsight.vectorize.io,即可跳过部署流程。
比较自托管、Cloud 和 Enterprise 版 → · 注册 →
所有选项(包括 Windows 和气隙环境)均在安装指南中有详细说明。
pip install hindsight-client -U                                  # Python
npm install @vectorize-io/hindsight-client                        # Node.js / TypeScript
go get github.com/vectorize-io/hindsight/hindsight-clients/go     # Go
curl -fsSL https://hindsight.vectorize.io/get-cli | bash          # CLI
from hindsight_client import Hindsight

client = Hindsight(base_url="http://localhost:8888")

# Retain: Store information
client.retain(bank_id="my-bank", content="Alice works at Google as a software engineer")

# Recall: Search memories
client.recall(bank_id="my-bank", query="What does Alice do?")

# Reflect: Generate disposition-aware response
client.reflect(bank_id="my-bank", query="Tell me about Alice")
const { HindsightClient } = require('@vectorize-io/hindsight-client');

const main = async () => {
  const client = new HindsightClient({ baseUrl: 'http://localhost:8888' });

await client.retain('my-bank', 'Alice loves hiking in Yosemite');

const results = await client.recall('my-bank', 'What does Alice like?');
  console.log(results);
}

main();
完整参考:Python · Node.js · Go · CLI · REST API
⚠️ Intel Mac:使用 hindsight-all-slim——详见安装指南。
Python 嵌入式(无需服务器)
pip install hindsight-all -U
在 Intel(x86_64)Mac 上,请改用 hindsight-all-slim——详见支持的平台。
import os
from hindsight import HindsightServer, HindsightClient

with HindsightServer(
    llm_provider="openai",
    llm_model="gpt-5-mini",
    llm_api_key=os.environ["OPENAI_API_KEY"]
) as server:
    client = HindsightClient(base_url=server.url)
    client.retain(bank_id="my-bank", content="Alice works at Google")
    results = client.recall(bank_id="my-bank", query="Where does Alice work?")
同时提供 Node.js 等效版本和守护进程 CLI。
将 Hindsight 集成到你的 AI 智能体
LLM 包装器(2 行代码)
为现有 AI 智能体添加记忆最简单的方式是使用 LLM 包装器。将你的 LLM 客户端替换为包装版本——记忆会在每次调用时自动存储和检索,代码无需其他修改。
pip install hindsight-litellm
from openai import OpenAI
from hindsight_litellm import wrap_openai

# Wrap your existing LLM client and you're done.
# Defaults to Hindsight Cloud; pass hindsight_api_url for a self-hosted server.
client = wrap_openai(
    OpenAI(),
    bank_id="user-123",
    hindsight_api_url="http://localhost:8888",
)

# Hindsight recalls relevant memories before the call
# and retains the conversation after it.
response = client.chat.completions.create(
    model="gpt-5-mini",
    messages=[{"role": "user", "content": "What do you know about me?"}],
)
wrap_anthropic() 对 Anthropic SDK 做同样的处理,每一个设置项——bank、recall budget、fact types、reflect instead of recall——都可以通过 hindsight_* kwargs 在每次调用时覆盖。底层依赖 LiteLLM,所以同一套集成可以覆盖 100+ 模型。详见 LiteLLM 集成。
如果你需要对记忆的存储和召回时机进行显式控制,请直接使用 SDK 或 REST API。
60+ 集成 — 大多数无需代码改动。
👉 浏览所有集成
一个包为 CLI 编码智能体提供长期项目记忆:一个基于每个代码仓库构建的 bank,自动从 git 历史和过往会话中提取,在智能体开始工作时注入进去,外加精心整理的知识页面,覆盖架构、规范和进行中的工作。
npx @vectorize-io/hindsight-coding-agents install all          # 每个被检测到的智能体,原生接入
npx @vectorize-io/hindsight-coding-agents install claude-code  # 或者只装一个
支持 Claude Code、Codex CLI、Cursor CLI、GitHub Copilot CLI、opencode、Kilo CLI、Cline CLI、Antigravity CLI、Devin CLI、pi、Prime Agent、Grok Build 和 DeepSeek Harness。接入是自动的——没有设置命令。详见编码智能体集成。
每个服务器都内置了一个 Model Context Protocol 端点,每个 bank 一个,默认启用:
http://localhost:8888/mcp/{bank_id}/
将任意 MCP 客户端指向它,即可将 retain、recall 和 reflect 暴露为工具。详见 MCP 服务器文档。
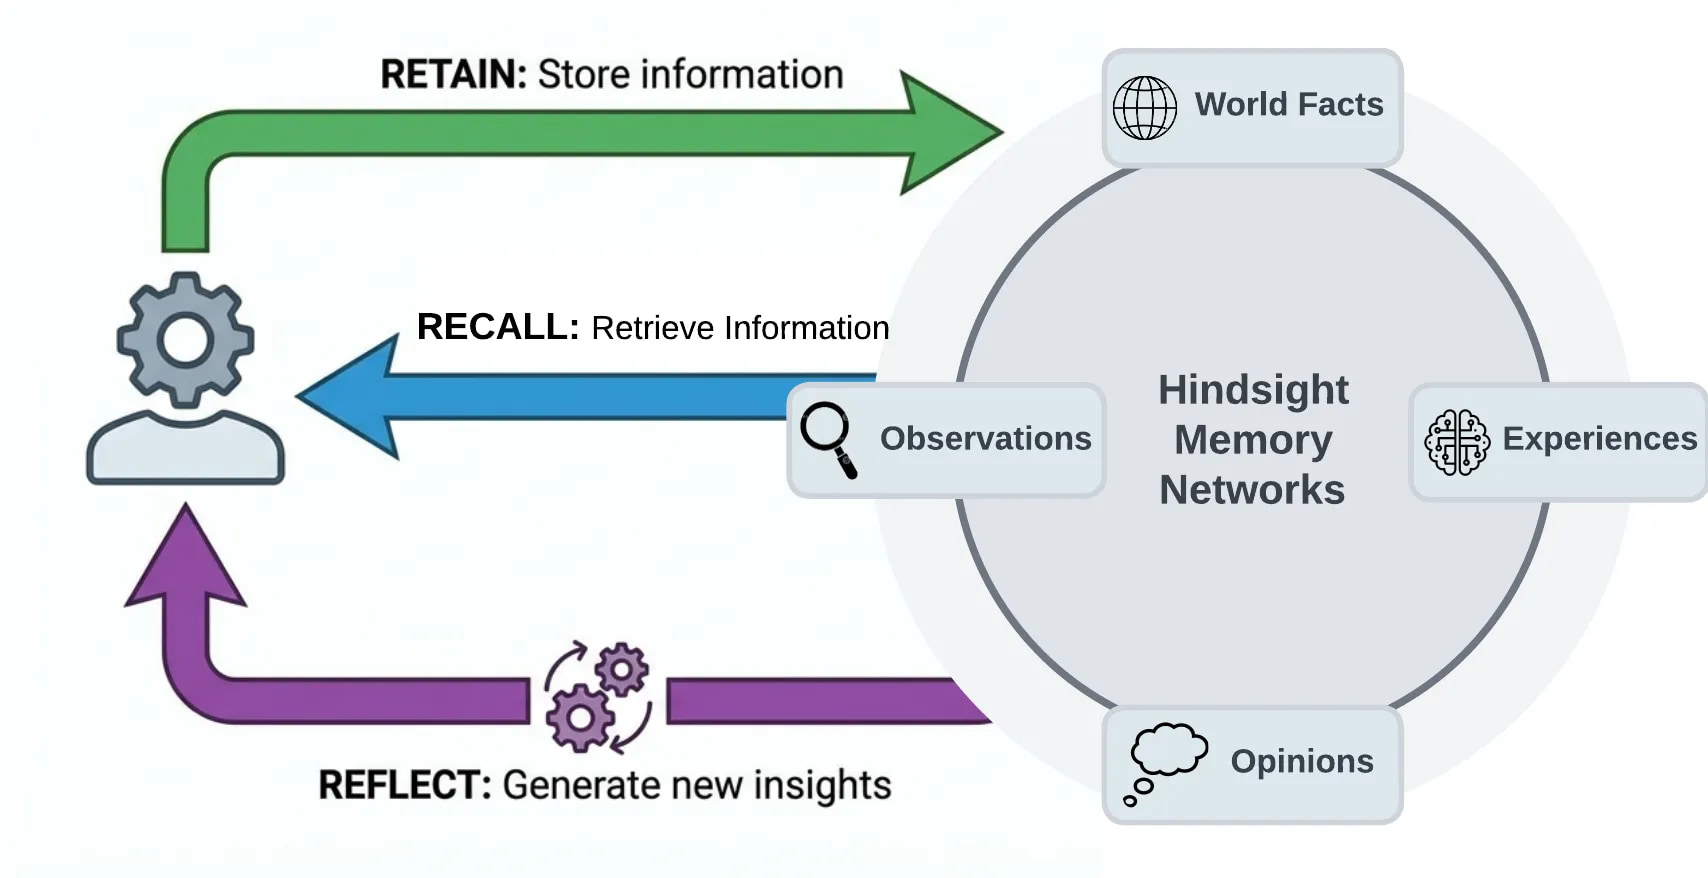
大多数智能体记忆实现依赖基础向量搜索,有时也用知识图谱。Hindsight 采用仿生数据结构来组织智能体记忆,其方式更接近人类记忆的工作原理:
世界事实:关于世界的真实("炉灶是烫的")
经验:智能体自身的经历("我摸了炉灶,真的很疼")
观察:由众多记忆综合而成、有证据支撑的信念
心智模型:从观察和事实中综合得出的、对智能体所处世界的学习理解
记忆存在于 bank 中。当记忆被添加时,它们被推入世界事实或经验路径,然后被表示为实体、关系和时间序列的组合,并带有稀疏/密集向量表示,以辅助后续召回。
retain 操作用于将新记忆推入 Hindsight。它告诉 Hindsight 将你传入的信息作为输入进行保留。
client.retain(
    bank_id="my-bank",
    content="Alice 被提升为高级工程师",
    context="职业变动",
    timestamp="2025-06-15T10:00:00Z",
)
幕后,retain 使用 LLM 提取关键事实、时间数据、实体和关系。它将这些信息通过规范化流程处理,转换为规范实体、时间序列和搜索索引,以及元数据。这些表示为 recall 和 reflect 操作中的精确记忆检索创建了路径。
recall 操作用于检索记忆。这些记忆可以来自任意记忆类型(世界、经验等)
client.recall(bank_id="my-bank", query="Alice 是做什么的?")
client.recall(bank_id="my-bank", query="六月发生了什么?")   # 时间性
Recall 并行执行 4 种检索策略:
语义:向量相似性
关键词:BM25 精确匹配
图谱:实体/时间/因果链接
时间:时间范围过滤
各结果通过倒数排名融合(reciprocal rank fusion)合并,按相关性排序,并使用交叉编码器重排序模型重新排序,然后根据需要修剪以符合 token 限制。
reflect 操作对现有记忆进行更深入的分析。这使得智能体能够在记忆之间形成新的联系,并对其所处世界构建更透彻的理解——或者回答需要深度思考而非简单查找的问题。
client.reflect(bank_id="my-bank", query="关于 Alice,我应该了解什么?")
例如,reflect 支持以下用例:
AI 项目经理反思项目中需要缓解的风险。
销售智能体反思为什么某些外展消息得到了回复,而其他的没有。
支持智能体反思客户在哪些方面有问题,而现有产品文档尚未回答。
保留的事实不会保持为一堆扁平数据。在后台,Hindsight 将相关事实综合为观察——即 bank 随着时间积累建立的、经过去重的信念。每个观察保留其支持证据,包括精确引用和证明计数,并在新证据到来时进行精细调整而非覆盖,因此新信息会加强、削弱或扩展现有信念,而不是静默替换它。
心智模型 & 知识页面
心智模型是关于一个 bank 的常驻答案("这个用户的偏好是什么?")。你只需定义一次问题;Hindsight 写出答案、存储它,并在 bank 了解更多后于后台重写它。读取一个心智模型是一次数据库读取——无需检索、无需 LLM 调用——因此智能体启动时即可获得一页已沉淀的知识,而非在每个会话中重新发现它。
知识页面是隐藏了机制细节的心智模型:bank 为自己编写的活文档,像 wiki 一样按文件夹组织,可搜索,并可作为普通 markdown 投影到磁盘。只需提供一个名称和问题;其他所有决策都是可覆盖的默认值。
心智模型 → · 知识页面 →
一个 bank 是一个独立的记忆存储——一个"大脑"对应一个用户、智能体或项目。隔离是严格的:不允许跨 bank 泄露。Bank 携带背景上下文和性格特质(怀疑主义、字面主义、同理心),这些特质会影响 reflect 如何对其记忆进行推理,并且可以从声明式 bank 模板创建。
还有两点值得了解:
默认多语言。输入语言被检测并端到端保留——事实保持其原始语言,实体保留其原生脚本(张伟保持张伟,而非 "Zhang Wei")。文档 →
记忆防御(Memory Defense)。一个可选的、per-bank 的策略,对每次 retain 进行扫描,检测 45 种模式下的 secrets 和 PII,然后要么对匹配内容进行脱敏([REDACTED:github_token]),要么在数据到达存储之前将其阻止。文档 →
Hindsight 旨在支持对话式 AI 智能体以及旨在自主执行任务的智能体。Hindsight 的理想用例是需要混合这些功能的智能体,例如需要处理开放性任务、根据用户反馈改变行为、并学习执行复杂任务以将工作自动化到接近人类水平的 AI 员工。Hindsight 可以与简单的 AI 工作流配合使用,比如用 n8n 等工具构建的工作流,但对于此类应用可能过于重量级。
Per-User Memories and Chat History
你可以用 Hindsight 实现的一个更简单的用例是通过存储和召回与个人用户关联的记忆,来个性化 AI 聊天机器人和对话式智能体。
此用例的需求通常如下所示:
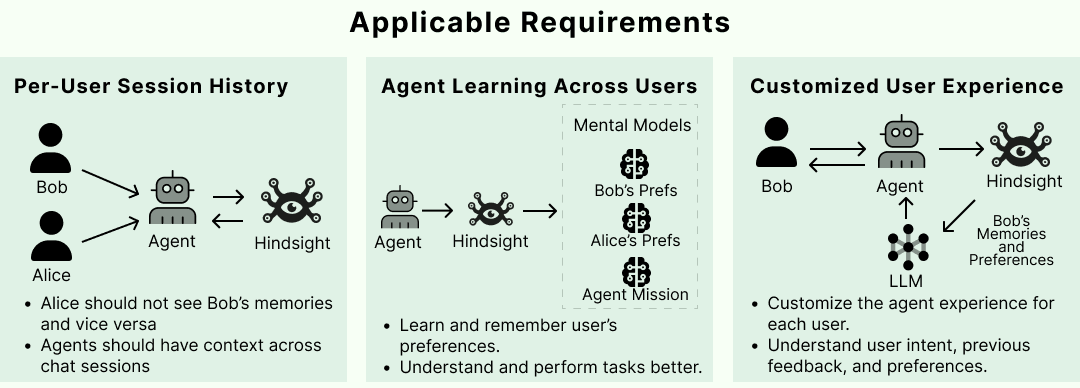
在 Hindsight 中满足这些需求非常直接。当使用 retain 操作将新的用户输入和工具调用摄入 Hindsight 时,可以使用自定义元数据来丰富新记忆。元数据提供了一种便捷方式来隔离需要限制在特定用户的记忆。一旦这些数据送入 retain 操作,创建的任何原始记忆和心智模型都可以在检索相关记忆时进行过滤。

更多模式请参阅 Cookbook 和最佳实践。
生产环境运行
文档 · FAQ · 最佳实践 · Cookbook · 博客
论文 · 基准测试 · RAG 与记忆
Python · Node.js · Go · CLI · REST API
由 Vectorize.io 构建