
8.0
热点
AI SCORE
编程提效2026-09-25 02:26
GitHub安全实验室:AI驱动的模糊测试实战
GitHub Blog · AI/ML#GitHub#模糊测试#安全
Editor brief · 编辑速览
介绍GitHub Security Lab基于Taskflow Agent框架的AI模糊测试工作流,可自动化发现安全漏洞。
如果你刚接触 fuzzing,想先学习基础知识,可以访问 gh.io/fuzzing101 参加我们的 Fuzzing 101 课程。
持续 fuzzing 并不是能解决所有问题的魔法方案。即使是加入 OSS-Fuzz 多年的项目,仍然可能隐藏着关键 bug,而原因几乎总是一样的:需要有人盯着覆盖率、为没人触达的代码编写新的 harnesses、筛选另一端输出的 crash。换句话说,fuzzing 仍然需要人在循环中参与。
所以我一直在问自己的问题是:有多少人类工作实际上可以交给 LLM agent?
这正是我构建 Fuzzing Taskflow 的初衷——一个面向 C/C++ 项目的自主 fuzzing 流水线。你只需要给它指定一个 GitHub 仓库,剩下的它全包了:识别合适的入口点、分析构建系统、编写 harnesses、运行 AFL++、读取覆盖率报告、改进 harnesses、筛选每个 crash,并为每个独特 bug 撰写漏洞报告——全程无需人工看守。
Fuzzing Taskflow 构建在 GitHub Security Lab Taskflow Agent 之上,这是我们编写 LLM 驱动安全自动化的框架,因此流水线被表达为一组 taskflows,由 agent 端到端执行。
在这篇文章中,我将带你了解它的工作原理和背后的设计决策。开始吧!
最简单的方式是访问 https://github.com/GitHubSecurityLab/seclab-taskflows-fuzzing 并启动一个 codespace。
然后,这样运行脚本:
./scripts/fuzzing/run_fuzzing.sh PROJECT
./scripts/fuzzing/run_fuzzing.sh tukaani-project/xz
就这么简单。参数只是一个 GitHub owner/repo slug。然后 agent 自己处理所有前期步骤:
如果你只是想在上线长期 campaign 之前做一次快速冒烟测试,可以针对一个小项目:
./scripts/fuzzing/run_fuzzing.sh DaveGamble/cJSON
运行之前有件事要提醒:这个 taskflow 直接在宿主机上运行 afl-fuzz、clang 以及 LLM 选择的任意构建命令,中间没有容器隔离。一个被 prompt 注入的 agent 原则上可以做任何你用户能做的事。因此请只在一次性环境中运行(例如 Codespace 或可丢弃的 VM),不要使用提升的权限。
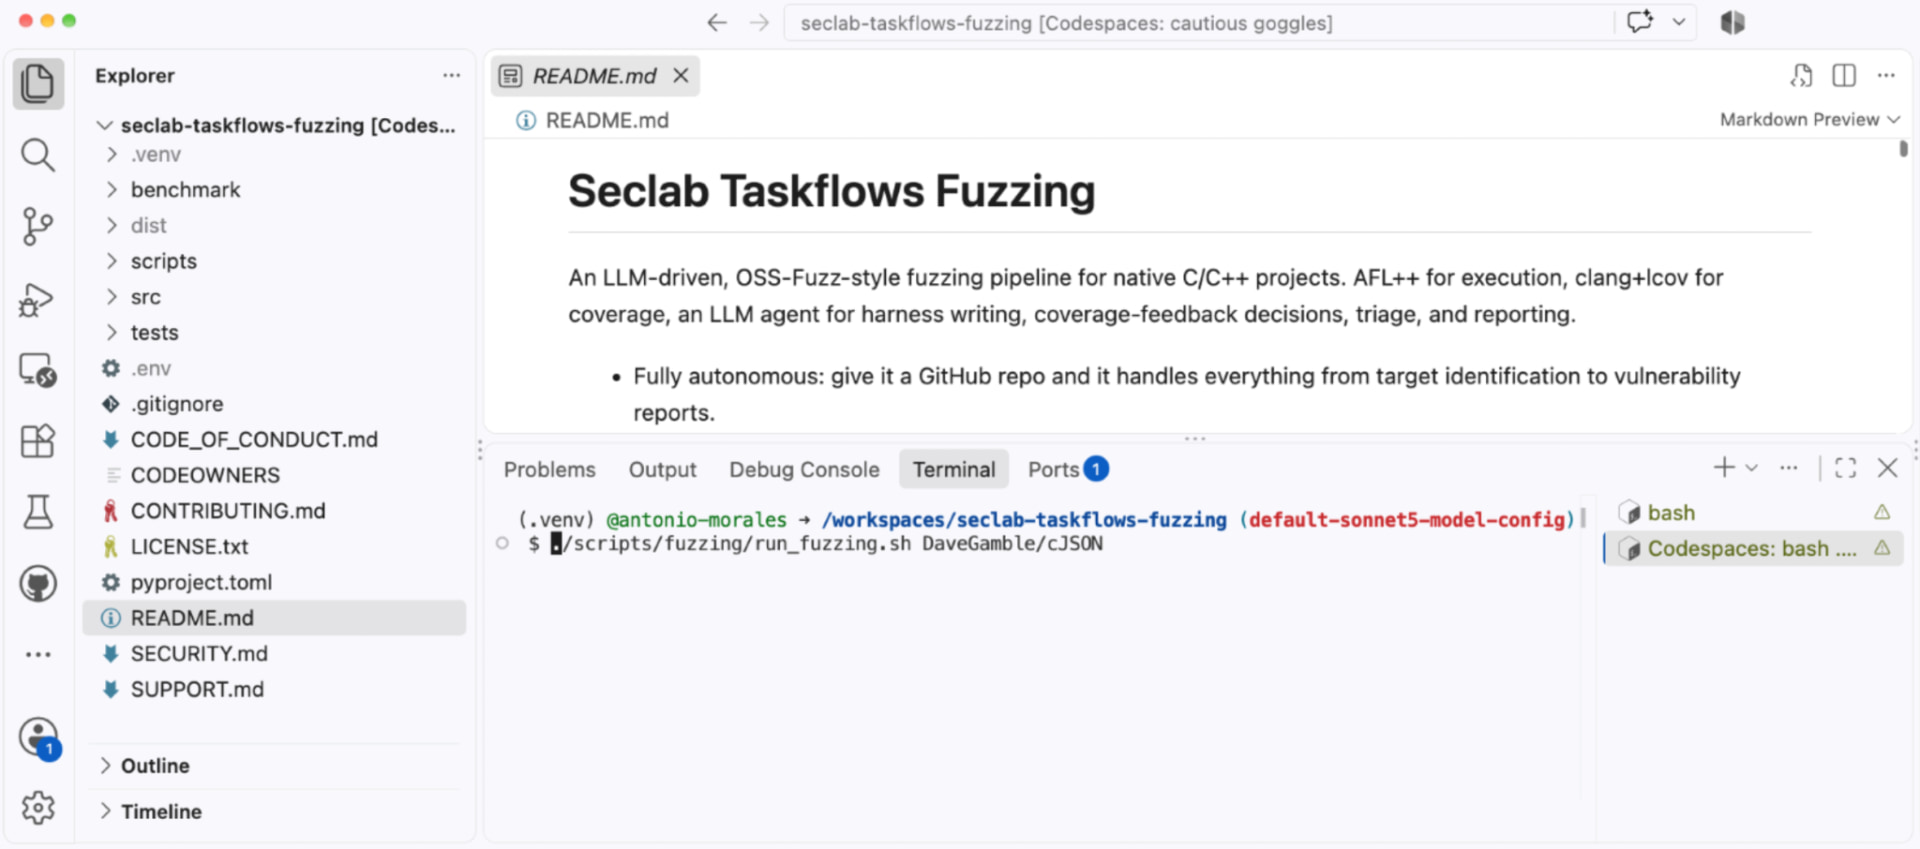
一些前沿模型会对输出施加安全 guardrails。对于 fuzzing taskflow,我们默认使用 Claude Sonnet 5,因为它通过了我们所有的内部测试且没有问题。你可以通过修改以下文件选择不同的模型:src/seclab_taskflows_fuzzing/configs/model_config.yaml。
在深入有趣的部分之前,了解各组件如何协作会很有帮助。整体分为三层:
run_fuzzing.sh),将流水线各阶段串联起来。我最在意的设计规则是职责的清晰分离:LLM agent 负责决策,MCP tools 负责执行。agent 决定 fuzz 什么、编写什么 harness、下一步追逐什么覆盖率缺口。tools 只暴露 run_afl_for 或 compile_harness 这样的原语。agent 永远不会直接调用 AFL 或 clang;它用这些构建块组合出流水线。所有状态都存储在 SQLite 数据库(fuzz_context.db)中,因此各阶段之间从不通过内存传递数据,只通过数据库。
一个小但重要的细节:每个 harness 会构建两次。AFL 的 edge instrumentation 很适合引导 fuzzer,但对人类可读的覆盖率报告毫无用处。因此每个 harness 都会生成两个二进制文件:一个 .afl 二进制(用 afl-clang-lto -fsanitize=address,undefined 构建)和一个 .cov 二进制(用 clang -fprofile-instr-generate -fcoverage-mapping 构建)。.afl 二进制执行 fuzzing;.cov 二进制在之后回放 AFL 的队列,生成真实的源代码行覆盖率和分支覆盖率。
这是整个流水线的核心,也是最直接自动化我开头描述的手动工作流程的部分。
如果你曾尝试手动提高 fuzzing 覆盖率,你会知道这是一个迭代过程,如下所示:
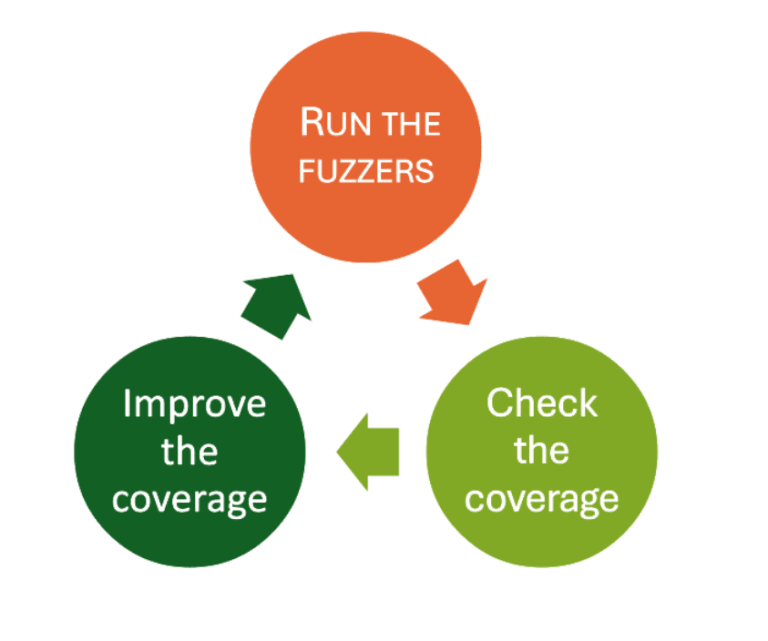
"检查覆盖率"这一步曾经是我手动完成的——手动阅读 LCOV 报告,寻找未覆盖的分支。"改进覆盖率"这一步也是我手动完成的,这次是编写新的 harness 或精心构造新的输入。Fuzzing Taskflow 把这两步都交给了 agent。
每次迭代,针对每个 harness,agent 运行 AFL 一个时间预算,回放队列到 .cov 二进制以获取真实的覆盖率报告,然后读取未覆盖分支列表。根据发现的内容,它从以下几种动作中选择一个:
时间预算每次迭代翻倍:
30s → 60s → 120s → 240s → 480s → 960s(约 32 分钟/目标)
设计思路是:在早期进行廉价、简短的轮次(当有很多低垂的覆盖率果实可以摘取时),在后期进行更长的轮次(当 fuzzer 需要更多时间突破一个 hard guard 时)。
就像我的手动工作流程一样,我需要回答一个问题:什么时候停止?这里循环使用 plateau 检测:一旦连续两次迭代每次获得的绝对行覆盖率增益都低于一个可配置阈值(默认 1%),循环就判定已经进入收益递减阶段,继续下一阶段。这防止 agent 在最后百分之零点几的覆盖率上燃烧大量计算资源。
AFL 默认的字节级 mutation 算子(位翻转、算术、块拼接)在二进制格式上表现出色,但在结构化的基于文本的输入上表现挣扎。经典解决方案是为每种格式手写自定义 mutator,但这是一项繁琐的工作。这次我希望流水线替我做这件事,因此它携带了四种互补的机制来生成结构感知输入。
对于输入格式被识别(JSON、XML、regex、PNG、长度前缀二进制 TLV)的目标,taskflow 附带了预置的 AFL 字典和 LLVMFuzzerCustomMutator C 文件。JSON mutator 做 token 拼接和平衡括号复制;XML mutator 了解标签、实体和 billion-laughs token;regex mutator 携带真实的 ReDoS 模式。每个 mutator 将一半的 mutation 委托回 AFL 的默认字节 mutator,因此我们保留了引擎的随机化能力,而不是与之对抗。
对于流水线不识别的格式,它通过扫描目标的 .c/.h 文件动态生成自定义 mutator。它提取字符串字面量和 32 位数值常量(来自 #define、case 和 enum),过滤掉噪声,并用它们作为拼接 token。直觉很简单:一个 parser 检查的最有趣的魔数值通常就写在它自己的源码中某处。
同一组源码 token 在迭代 1 之前也被导出为 AFL 经典字典(数值常量同时包含两种字节序,因此 fuzzer 可以满足对 4 字节魔数的 memcmp,不管宿主机的字节序)。然后,在每次覆盖率步骤之后,流水线查看未覆盖行附近的 guard(strncmp、memcmp、case 0xN、== 'X'),并追加它发现的新 token。字典实际上是在向 fuzzer 还无法触达的代码方向生长。
智能 mutator 还可以从语料库目录加载文件,并将它们的随机子区域拼接进输入,这是一种重组风格的算子,AFL 原装的 havoc 做得不好。
有件事会悄悄扼杀 fuzzing 效率:丢弃进度。如果每次运行都从原始 seeds 开始,你就会一遍又一遍地重复发现相同路径的成本。
为避免这种情况,每个 harness 都有一个稳定的语料库目录,跨迭代和整个 campaign 持久存在:
<workspace>/corpus/harness_<id>/
每次迭代结束时,AFL 的队列被合并到这个目录,并经过 afl-cmin 处理以保持其大小有界。效果是昨天的有趣输入会带入今天的运行,上周 campaign 中发现的输入会带入本周的 campaign。如果你停止并重启 campaign,什么都不会丢失。
发现 crash 只是工作的一半。任何做过根因分析的人都知道,triage 往往是整个过程中最繁琐的部分。这是 agent 展现能力的另一个地方。
fuzzing 循环结束后,三个阶段自动运行。首先,每个 crash 用 afl-tmin 最小化,在 ASan 下回放以捕获栈追踪,并通过栈顶哈希去重(规范化栈帧的顶部,去除模板、内联命名空间和 LTO 后缀,使语义相同的 crash 聚合在一起)。其次,先前已知的 crash 会在当前二进制上回放,看看上游修复是否已解决它们。第三,agent 读取 harness 源码和 crash 函数,从公共 API 往回追溯调用链,并为每个 crash 撰写一份 markdown 报告。
每份报告给出以下裁决之一:
真实漏洞(通过公共 API 可达且可利用)和 mere harness_bug(bug 在我们自己的 harness 中,而非库中)之间的区别,正是过去需要我坐下来手动追溯代码的那种判断。每份报告都包含根因分析(含 file:line 引用)、可达性论证、可利用性评估、统一 diff 格式的建议修复方案以及回归测试草图。
需要说明的是:建议的补丁标记为"需要审核"是有原因的。agent 的分析受限于模型对目标代码的理解,确实会出错。把这些裁决当作人类很好的起点,而不是最终结果。
运行一个自主 campaign 却看不到它在做什么,这让人不舒服。因此流水线将所有内容发布到一个实时 HTML 仪表板。它在你启动 campaign 时自动在后台启动,端口 8765。在 Codespace 中该端口会自动转发,因此你可以在任何浏览器中打开它,在仪表板上实时观看 campaign 进度。
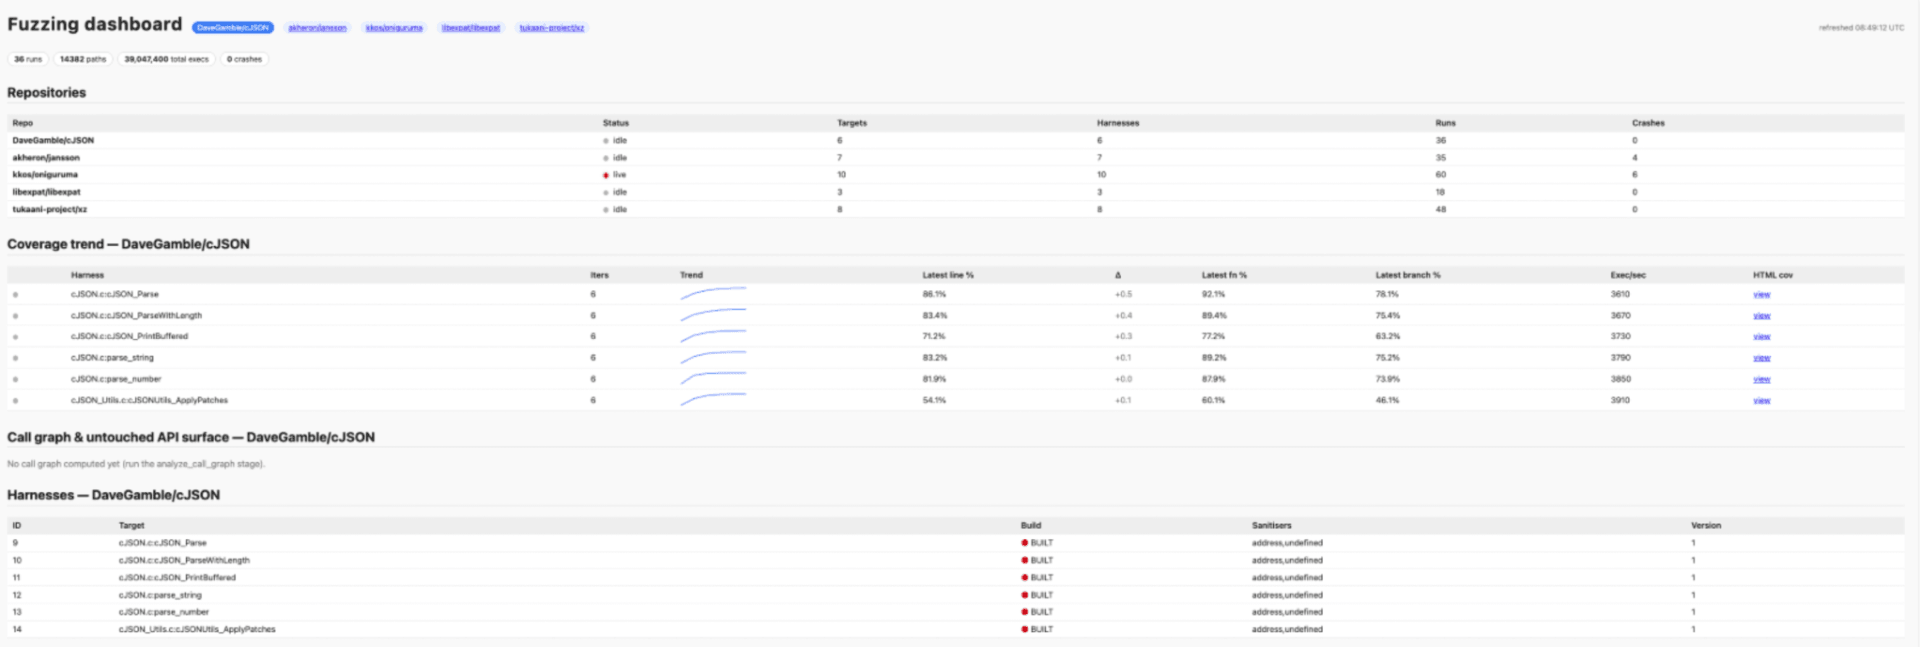
页面显示包括:
我启动这个项目的动力是每位安全研究员都熟悉的局限性:fuzzing 有效,但没有人工关注就无法扩展,而人工关注正是瓶颈所在。Fuzzing Taskflow 是我尝试通过将重复性工作(编写 harnesses、阅读覆盖率、追逐缺口、筛选 crash)交给 LLM agent 来推低这个瓶颈,同时在 agent 的判断和执行实际工作的 tools 之间保持清晰的分离。
如果你是一个 C/C++ 项目的维护者,请尝试一下。如果你的项目从未被 fuzz 过,这个工具会帮你快速入门。如果你的项目曾经被 fuzz 过,这个工具可能通过提高 fuzzing 覆盖率来帮助你发现新的 bug。
源代码是开源的,如果你遇到任何 bug 请提交 issue。也欢迎贡献代码!
延伸阅读
Rendering huge pull requests in the GitHub Copilot app
How we rebuilt the diff surface in the GitHub Copilot app to open a million-line pull request with hundreds of inline review comments.
Should you read the code, is RAG dead, and did Skills kill MCP?
We dive into these questions and other AI hot takes on the latest episode of the GitHub Podcast.
Migrating the GitHub Copilot runtime to Rust, using Copilot
A rewrite this size wasn't affordable before agents. Here's what porting the Copilot agent runtime to 800,000 lines of production Rust actually took.