
8.0
热点
AI SCORE
开源项目2026-09-25 14:40
NVIDIA 开源统一模型优化库
GitHub Trending#NVIDIA#模型优化#推理加速
Editor brief · 编辑速览
集成量化、剪枝、知识蒸馏、NAS、投机解码等 SOTA 优化技术,一站式输出兼容 TensorRT-LLM、vLLM 等推理框架的优化模型。
Documentation | Roadmap | Announcement Blogs
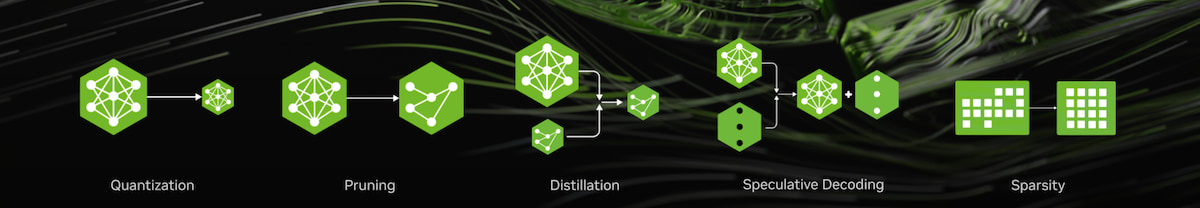
NVIDIA Model Optimizer(简称 Model Optimizer 或 ModelOpt)是一个汇集了业界领先模型优化技术的库,涵盖量化、剪枝、神经架构搜索(NAS)、蒸馏、投机解码和稀疏化,用于加速模型推理。
[输入] Model Optimizer 目前支持输入 Hugging Face、PyTorch 或 ONNX 格式的模型。
[优化] Model Optimizer 提供 Python API,用户可轻松组合上述模型优化技术并导出优化后的量化 checkpoint。Model Optimizer 还与 NVIDIA Megatron-Bridge、Megatron-LM 和 Hugging Face Accelerate 集成,为训练所需的推理优化技术提供支持。
[导出部署] 与 NVIDIA AI 软件生态系统无缝集成,Model Optimizer 生成的量化 checkpoint 可直接在下游推理框架中部署,如 SGLang、TensorRT-LLM、TensorRT 或 vLLM。统一的 Hugging Face 导出 API 现已支持 transformers 和 diffusers 模型。
[2026/09/16] Qwen3.6-35B-A3B 端到端 W4A4 NVFP4 + QAD 教程:NVFP4 W4A4 PTQ 配合量化感知蒸馏,vLLM 吞吐量最高提升 1.30 倍(相比 BF16),checkpoint 体积缩小 3.1 倍,同时恢复 W4A4 精度损失。
[2026/09/09] 博客:利用 Local-Hessian 权重尺度提升 NVFP4 精度
[2026/08/24] 博客:AutoQuantize:快速自动混合精度分配
[2026/08/17] 博客:使用 NVIDIA Model Optimizer 开发 Nemotron 3.5 Lightning NVFP4(QAD):了解量化感知蒸馏如何从激进 NVFP4 量化中恢复精度,同时缩小模型体积并提升吞吐量。
[2026/06/26] 博客:使用 NVIDIA Model Optimizer 创建 NVIDIA Nemotron 3 Ultra NVFP4 Checkpoint:介绍如何使用 Model Optimizer 将 Nemotron 3 Ultra(550B)量化为 NVFP4——在匹配 BF16 精度的同时,解码密集型推理吞吐量比 GLM-5.1 754B FP4 高出 5.9 倍。NVFP4 Checkpoint 已发布于 Hugging Face。
[2026/05/27] Nemotron-3-Nano-30B-A3B 端到端优化教程:剪枝 + 两阶段蒸馏 + FP8 量化,实现 2.6 倍 vLLM 吞吐量和 2.6 倍显存降低。
[2026/05/13] Puzzletron:用于 LLM 和 VLM 模型异构剪枝和 NAS 的新算法。
[2026/04/15] 客户案例:Domyn 使用 ModelOpt 的 Minitron 剪枝 + 蒸馏将 Colosseum-355B 压缩至 260B
[2026/03/17] 客户案例:Bielik.AI 使用 ModelOpt 的 Minitron 剪枝 + 蒸馏构建 Bielik Minitron 7B(体积缩小 33%、速度提升 50%、质量保留 90%)
[2026/03/11] Model Optimizer 量化的 Nemotron-3-Super checkpoints 已发布于 Hugging Face 供下载:FP8、NVFP4。更多详情见 Nemotron 3 Super 发布博客。在此了解如何量化 Nemotron 3 模型以加速部署。
[2026/03/11] NeMo Megatron Bridge 现已支持 Nemotron-3-Super 量化(PTQ 和 QAT)及使用 Model Optimizer 库的导出工作流。详见 FP8/NVFP4 量化及 HF 导出指南。
[2025/12/11] 博客:提升 AI 模型推理速度与智能化的五大优化技术
[2025/12/08] NVIDIA TensorRT Model Optimizer 正式更名为 NVIDIA Model Optimizer。
[2025/10/07] 博客:使用 NVIDIA Model Optimizer 剪枝和蒸馏 LLM
[2025/09/17] 博客:投机解码降低 AI 推理延迟入门
[2025/09/11] 博客:量化感知训练如何实现低位精度恢复
[2025/08/29] 博客:使用量化感知训练微调 gpt-oss 以提升精度和性能
[2025/08/01] 博客:使用训练后量化优化 LLM 的性能和精度
[2025/06/24] 博客:推出 NVFP4——高效且精准的低精度推理
[2025/05/14] NVIDIA TensorRT 解锁 NVIDIA Blackwell GeForce RTX 50 系列 GPU 的 FP4 图像生成
[2025/04/21] Adobe 使用 Model-Optimizer + TensorRT 优化部署,扩散延迟降低 60%,总体拥有成本降低 40%
[2025/04/05] NVIDIA 加速 Meta Llama 4 Scout 和 Maverick 的推理。在此了解如何量化 Llama4 以加速部署。
[2025/03/18] 全球最快的 DeepSeek-R1 Blackwell FP4 推理,以及 Blackwell 图像生成效率提升
[2025/02/25] Model Optimizer 量化的 NVFP4 模型已发布于 Hugging Face 供下载:DeepSeek-R1-FP4、Llama-3.3-70B-Instruct-FP4、Llama-3.1-405B-Instruct-FP4
[2025/01/28] Model Optimizer 新增 NVFP4 支持。在此查看 NVFP4 PTQ 示例。
[2025/01/28] Model Optimizer 现已开源!
[2024/10/23] Model Optimizer 量化的 FP8 Llama-3.1 Instruct 模型已发布于 Hugging Face 供下载:8B、70B、405B。
[2024/09/10] 使用 NVIDIA NeMo 和 Model Optimizer 对 LLM 进行训练后量化。
[2024/08/28] 在 NVIDIA H200 GPU 上使用 Model Optimizer 将 Llama 3.1 405B 性能提升高达 44%
[2024/08/28] 使用 Medusa 将 Llama 3.1 性能提升最高 1.9 倍
[2024/08/15] 最新版本新功能:Cache Diffusion、支持 NVIDIA NeMo 的 QLoRA 工作流等。详见博客。
[2024/06/03] Model Optimizer 新增实验性功能,可部署到 vLLM——这是我们支持主流部署框架的一部分工作。在此查看工作流。
[2024/05/08] 公告:Model Optimizer 正式发布,进一步加速 GenAI 推理性能
[2024/03/27] Model Optimizer 为 TensorRT-LLM 加速,创下 MLPerf LLM 推理纪录
[2024/03/18] GTC 会议:在 TensorRT-LLM 和 TensorRT 中使用量化优化 GenAI 推理
[2024/03/07] Model Optimizer 的 8 位训练后量化使 TensorRT 能将 Stable Diffusion 加速近 2 倍
[2024/02/01] 在 TRT-LLM 中使用 Model Optimizer 量化技术加速推理
使用 pip 从 PyPI 安装 Model Optimizer 稳定版:
pip install -U nvidia-modelopt[all]
Model Optimizer 会下载并安装其他第三方开源软件项目。使用前请查阅这些开源项目的许可条款。
如需从源码以可编辑模式安装并包含所有开发依赖,或使用最新功能,请运行:
# Clone the Model Optimizer repository
git clone git@github.com:NVIDIA/Model-Optimizer.git
cd Model-Optimizer

pip install -e .[dev]
您也可以直接使用预装了 Model Optimizer 的 NVIDIA 容器镜像:
nvcr.io/nvidia/pytorch:<version>-py3
nvcr.io/nvidia/nemo:<version>
nvcr.io/nvidia/tensorrt-llm/release:<version>
在拉取和使用容器镜像前,请查阅其各自的许可条款。请确保按上述说明将 Model Optimizer 升级到最新版本。更多精细化依赖控制或替代 docker 镜像及环境变量设置,请访问安装指南。
可直接部署的 checkpoints:[🤗 Hugging Face - Nvidia Model Optimizer Collection]
支持部署至 TensorRT-LLM、vLLM 和 SGLang
更多模型即将上线!
✨ 提交功能请求
Model Optimizer 采用结构化方法管理废弃功能:
沟通:废弃通知记录在 Changelog 中。废弃项包含指示废弃时间的源代码声明,使用时发出运行时警告。
迁移期:由于 Model Optimizer 仍处于 1.0 之前版本,废弃后会提供约 1 个月的一个发布迁移期。在此窗口期内,废弃功能继续运行但会发出警告。
范围:该策略涵盖完全废弃(移除整个 API)和部分废弃(移除特定参数但保留方法)。
移除:迁移期结束后,废弃项按语义化版本标准移除,Model Optimizer 处于 0.x 阶段时可能在小版本更新中包含破坏性变更。
如果您在研究中使用 NVIDIA Model Optimizer,请按以下方式引用:
@misc{nvidia-modelopt,
  author       = {{NVIDIA Corporation}},
  title        = {{NVIDIA Model Optimizer}},
  howpublished = {\url{https://github.com/NVIDIA/Model-Optimizer}},
  year         = {2024--2026},
  note         = {GitHub repository}
}
Model Optimizer 现已开源!欢迎任何反馈、功能请求和 PR。请阅读贡献指南了解如何参与本项目。
ModelOpt 的 Agent 技能可从本仓库安装,并在任意工作区使用。
claude plugin marketplace add https://github.com/NVIDIA/Model-Optimizer.git
claude plugin install modelopt@modelopt
codex plugin marketplace add https://github.com/NVIDIA/Model-Optimizer.git
然后打开 /plugins,选择 modelopt marketplace 并安装 modelopt。贡献者也可直接从 checkout 直接使用这些技能。详见 Agent 工具说明。