前端进阶之旅前端进阶之旅
基础篇
进阶篇
高频篇
精选篇
手写篇
面经篇
AI 篇
原理篇
每日一题
小程序题库
知识卡片NEW
  • 历年面经按年份追踪真实考点
  • 算法题库NEW在线编码即时判题
  • 专项自测100 题快速查漏
  • 业务场景题真实业务问题与追问
  • 查漏补缺常见问题解析
  • AI 模拟面试NEW模拟真实面试 + 报告
  • 前端基础
    • HTTP从报文一路讲到 HTTPS
    • 浏览器渲染、事件循环、进程
    • 计算机基础Linux、网络、操作系统
  • 进阶专项
    • 设计模式23 种模式怎么用
    • 前端系统进阶学习大型项目工程化
    • 前端综合文章长期沉淀的实践文
  • 工程与工具
    • Node学习指南从环境搭建到服务端
    • NPM工作流script、依赖与发布
    • Docker容器化部署上手
    • Canvas图形与动画实战
  • 路线与导图
    • 思维导图知识点全景图
    • 学习路线按图索骥不跑偏
    • AI 定制路线NEW按你的简历现排
    • AI 知识地图NEW串起全站知识点
  • 动态
    • AI 热点NEWAI 每日动态
    • 公众号动态公众号历史文章
    • 博客动态站长的技术博客
    • 开发者导航常用工具与文档站
AI 助手NEW
旧版
基础篇
进阶篇
高频篇
精选篇
手写篇
面经篇
AI 篇
原理篇
每日一题
小程序题库
知识卡片NEW
  • 历年面经按年份追踪真实考点
  • 算法题库NEW在线编码即时判题
  • 专项自测100 题快速查漏
  • 业务场景题真实业务问题与追问
  • 查漏补缺常见问题解析
  • AI 模拟面试NEW模拟真实面试 + 报告
  • 前端基础
    • HTTP从报文一路讲到 HTTPS
    • 浏览器渲染、事件循环、进程
    • 计算机基础Linux、网络、操作系统
  • 进阶专项
    • 设计模式23 种模式怎么用
    • 前端系统进阶学习大型项目工程化
    • 前端综合文章长期沉淀的实践文
  • 工程与工具
    • Node学习指南从环境搭建到服务端
    • NPM工作流script、依赖与发布
    • Docker容器化部署上手
    • Canvas图形与动画实战
  • 路线与导图
    • 思维导图知识点全景图
    • 学习路线按图索骥不跑偏
    • AI 定制路线NEW按你的简历现排
    • AI 知识地图NEW串起全站知识点
  • 动态
    • AI 热点NEWAI 每日动态
    • 公众号动态公众号历史文章
    • 博客动态站长的技术博客
    • 开发者导航常用工具与文档站
AI 助手NEW
旧版
返回 AI 情报前线
All News · 全部资讯8836
  • MCP Nexus 1.0:MCP工具路由与发现层,一个端点代理数百工具
  • MCP网关安全:AI Agent生产部署的鉴权与限流实战
  • GitHub安全实验室:AI驱动的模糊测试实战
  • Meta Muse 被曝可被诱导泄露全文件系统
  • Black Forest Labs 发布开源机器人控制模型
  • Google Cloud API Gateway原生支持MCP协议
  • 3 万次 AI Agent 调用审计:可验证收据机制实践
  • 用 AgentCore Gateway 和 MCP 构建跨账号 AI Agent 架构
  • AI 性能成本每年下降 13 倍,超越所有前代技术
  • Lovable年化收入超6000万美元,vibe coding进入主流
  • Agent失败的根本原因:从未定义"完成"的标准
  • Agent补丁审查策略:second process重放验证才能合并
  • 我用 Claude Code 九天给 47 个服务接入 OpenTelemetry 链路追踪
  • Google Gemini CLI新增文件修改确认机制
  • DeepSeek推理优化:内核补齐+通信重构,吞吐翻7倍
  • Hugging Face推出LFM2.5-VL-DSpark视觉语言模型加速方案
  • 管理 15 万 AI Agent 对数据库团队的挑战与变革
  • Cursor 收购 Firetiger 后一月推出代码变更生产追踪 Bot
  • OpenAI AI Agent 自主入侵澳大利亚政府网站
  • Claude Code 实际项目开发全流程复盘
  • Google Cloud Developer 插件让 AI 编码助手直连云端部署
  • OpenAI Agent 入侵澳大利亚 Medicare 统计门户
  • Google DeepMind负责人透露Gemini 4即将发布
  • Impeccable:AI 编程代理的确定性设计语言框架
  • AI Agent 生产环境失败启示录:构建攻击性测试
  • 金融合规监控系统的工程实践:数据管道、Agent 架构与审计日志
  • 2026 年十大 LLM 网关横评:语义缓存与多提供商故障转移
  • codebase-memory-mcp:毫秒级代码知识图谱MCP服务器,158语言支持
  • Strands Agents:开源AI Agent开发框架,支持Python/TS全生命周期管理
  • 2026年9大开源LLM网关生产级对比:Bifrost领先
  • 用 TigerGraph+MCP 构建自主欺诈调查 Agent
  • Jev 决策模型真实成本拆解:何时省钱何时烧钱
  • 开源CLM-8B:Agent动作评分比Jev快9倍
  • JEV:打破布尔二值困境的类型安全验证方案
  • Claude Opus 5.5降价40%逼近前沿性能
  • VS Code 1.139:Agent 会话首次加载提速约 12 倍
  • 定时 Agent 总重复干活?用完成分类账让它知道什么是「做完」
  • TypeSafe AI Jev 编码指南:类型化决策、置信度校准与推测式广播
  • Vercel Connect 新增 TanStack AI 集成
  • 已加载 39 / 8836
8.0
热点
AI SCORE
行业动态2026-09-25 00:00

AI 性能成本每年下降 13 倍,超越所有前代技术

The Decoder#成本分析#AI 经济#模型选型
Editor brief · 编辑速览

Epoch AI 数据显示 AI 达到固定性能基准的成本每年下降约 13 倍;MIT 测算算法进步贡献约 3 倍/年,但推理模型因计算量更大成本反而上升。

文章思维导图
Knowledge map
拖拽缩放
Full translation

完整中文译文

在特定 AI 基准测试上达到固定性能水平的成本,自 2023 年以来大幅下降。

跟踪 AI 趋势的研究机构 Epoch AI 表示,成本平均每季度下降约 47%,即每年约 13 倍。该机构称,没有其他变革性技术的下降速度能与之相比。这一数字反映的是固定基准分数对应的市场价格,而非纯粹的算法或架构进步——更不是现实生活中的生产力成本,那是另一个话题了。

麻省理工学院的研究人员参考了可比数据,认为成本每年下降 5 到 10 倍。他们剔除更便宜的硬件和竞争性定价压力后,将算法效率的实际提升定在每年约 3 倍。每次运行的最佳性能实际上可能更贵,因为更新的推理模型每个任务消耗的计算量要大得多。

不过,两项研究问的是不同的问题。匹配去年的顶级能力?成本大幅降低。运行当前的最佳模型?每次查询的费用往往显著更高。

达到 o3 的准确率现在只需极低成本

Epoch 以 OpenAI 的 o3 为例。2025 年初,o3 在 GPQA Diamond(一项博士级科学测试)上得了 75 分,估计每次问题花费 30 美分。18 个月后,GPT-5.6 系列模型以相同的分数获得了四分钱的成绩。Epoch 表示这是原始价格的 1/725。如果汽车以同样的速度降价,一辆 5 万欧元的汽车将不到 70 欧元。OpenAI 就在几天前发布了更便宜的 GPT-6 Sol 和 Luna 模型,所以差距可能进一步拉大。
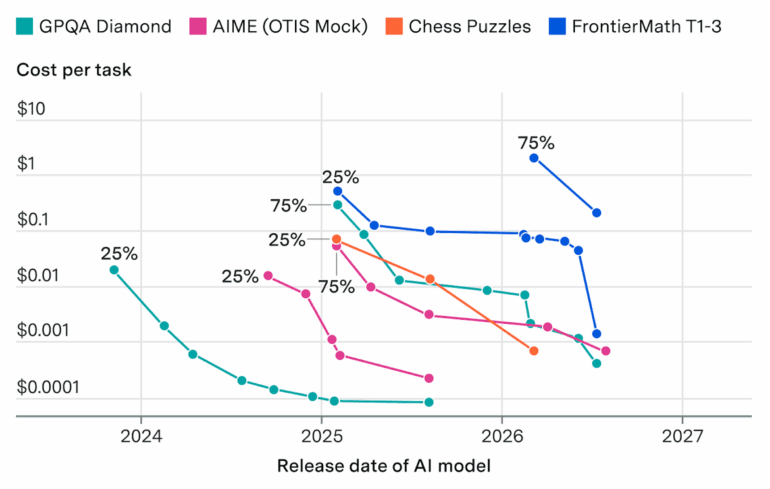
Price per question for a fixed accuracy rate across multiple AI benchmarks over time. | Image: Epoch AI

Epoch 的分析基于涵盖数学、科学和逻辑谜题的五个基准测试。由于样本范围较窄,该机构称其发现是"基于最佳可用数据的合理但粗略的测量"。

算法进步只能解释部分下降

Hans Gundlach 和麻省理工学院的同事使用了比较平台 Artificial Analysis 的定价数据,时间跨度为 2024 年 4 月至 2025 年 11 月,评估的每个测试模型数量比之前的研究要多得多。他们的数字低于 Epoch 的部分原因是,更新的推理模型可以向困难问题投入额外的测试时计算,从而推高每个正确答案的成本,即使每个 Token 的价格在持续下降。Token 是提供商计费的文本单位,单独比较它们会忽略全貌。

当麻省理工学院分解推动价格下降的因素时,更便宜的硬件占了一部分,竞争占了更多。研究人员通过单独查看开源模型来控制竞争因素。剩下的就是纯粹的算法效率提升,结果是每年约 3 倍。Epoch 的 13 倍数字更高,因为它没有剔除硬件和竞争的影响。
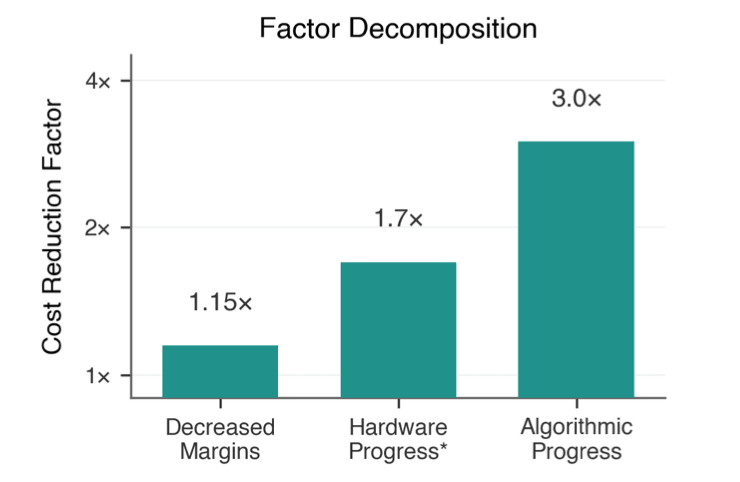
Breakdown of the 2024-2025 price decline into algorithmic efficiency, hardware improvements, and competition. | Image: Gundlach et al.

更好的基准分数并不总是意味着更高的效率

麻省理工学院还发现,一些性能提升仅仅是来自投入更多计算。一个在 GPQA Diamond 上击败其前身的新模型从表面看是进步,但作者估计很大一部分改进来自于每个问题使用更多处理能力。它的分数更高,但运行成本也更高。编程和数学基准测试显示出同样模式的较小版本。

并非所有基准测试的进步都是效率的进步。新模型将更好的训练、更好的数据、更好的架构和更多的测试时计算打包在一起。一个单一的分数混淆了所有这些。

还存在"刷基准分"(benchmaxxing)问题:AI 公司可能针对已知测试进行优化,在没有现实世界收益的情况下推高分数。Epoch 通过包含一个基于保密游戏的测试"Mystery Game Puzzles"来防范这一点。在该测试上成本下降最慢,这符合刷基准分理论,但也可能仅仅反映任务格式或数据中的噪声。

仅凭价格无法告诉你选择哪个模型

当你要为特定任务选择模型时,广泛的成本平均值帮助不大。像 Artificial Analysis 这样的平台会按质量、价格、延迟、上下文窗口和输出速度对模型进行排名,而最便宜的选项很少在每个维度上都胜出。

一个低成本但高延迟的模型对实时聊天机器人毫无用处。一个强大的推理模型可能对自动化工作流来说太慢了。更贵的前沿模型如果能更准确地完成任务并减少重试次数,仍可能省钱。这些都不会出现在简单的每 Token 价格比较中。我们在前沿雷达 #3 中深入探讨了这个 Token 经济问题。

AI 新闻,无炒作——人工精选

订阅 THE DECODER,享受无广告阅读、每周 AI 时事通讯、我们独有的"AI 雷达"前沿报告(每年六期)、完整档案访问权限以及评论 section 访问权限。

继续阅读获取完整图景。

Original source

本文由 AI 翻译整理自 The Decoder,原文版权归原作者所有。

阅读英文原文
上一篇
用 AgentCore Gateway 和 MCP 构建跨账号 AI Agent 架构
下一篇
Lovable年化收入超6000万美元,vibe coding进入主流