
8.0
热点
AI SCORE
技术实践2026-10-16 09:44
印度语言预训练数据扩至2.8万亿词元
Hugging Face Blog#预训练#数据工程#多语言
Editor brief · 编辑速览
介绍印度语言预训练的数据扩展工作,规模达到2.8万亿词元,并提供开放的数据生成流水线。


作者:AI4Bharat — Mohammed Safi Ur Rahman Khan、Mitesh Khapra、Anoop Kunchukuttan。NVIDIA — Niket Agarwal、Raviraj Joshi、Anusha Kamath、Markus Kliegl、Yev Meyer、Sriharsha Niverty、Kiran Praveen、Utkarsh Vaidya。
我们很高兴向大家介绍 Nemotron-pretraining-Indic-v1:一个覆盖 22 种印度语言、包含约 2.8 万亿个 token 的语料库。它即将与用于构建该语料库的开源 GPU 加速数据生成流水线一同发布。这 22 种语言均列于印度宪法之中,是 97% 印度人的第一语言;按 2011 年人口普查统计,使用者接近 12 亿人。此次发布由 NVIDIA 携手印度顶尖工程院校印度理工学院马德拉斯分校(IIT Madras)及其 AI4Bharat 实验室共同开发,为模型开发者提供了规模可观的印度语言预训练新资源。该流水线涵盖完整的生成方案,包括提示词、LLM 工作流和质量检查,开发者可以据此适配自己的源材料,并根据需求生成更多数据。
AI4Bharat 是 IIT Madras 的印度语言研究实验室,致力于构建面向印度语言的开源数据集和模型。其资源包括覆盖 22 种印度语言的开放预训练语料库 Sangraha,帮助奠定了开放印度语言模型研究的基础。我们此次联合开源发布,将大幅扩充社区可用的开放合成印度语言训练数据。它将经过筛选整理的多种英语材料转化为印度语言,内容涵盖数学、代码和问答等,为团队提供更多训练材料,以构建能够用这些语言解释技术概念、推导解题过程和回答问题的模型。每条记录都能追溯到经过筛选整理的源文档,每份输出也都会对照输入进行检查,确保合成文本以真实信息为依据。
AI4Bharat 负责人、入选 2025 年《时代》TIME100 AI 榜单的 Mitesh Khapra 曾指出核心问题:印度语言技术之所以落后于英语,是因为“我们没有足够的印度语言数据”。我们正在通过提供更多数据,以及一套用于生成更多数据的开放方案,回应这一需求。
语料库也考虑到了人们实际的书写方式。它包含全部 22 种语言的本族文字数据,以及其中 12 种语言的罗马化文本,共覆盖 34 种语言与文字系统组合。我们的工作流结合了文档级翻译、质量评估和针对性修复,并通过检查保留公式、表格和代码等内容。这些数据是对自然撰写的印度语言文本的补充,后者对于本地知识和文化语境仍然至关重要。
我们公开这套生成方案,是希望社区不仅能够复现数据,还能在此基础上进一步推进这项工作。团队可以直接使用语料库,调整提示词和质量检查,也可以将自己的源文档接入工作流。通过同时开放数据和生成过程,我们希望降低大规模印度语言数据生成的门槛,让更多开发者能够参与构建能力更强的印度语言模型。
Nemotron 3.5 Super VL 在持续预训练阶段加入了 100 亿个印度语言 token,这些数据来自该语料库中涵盖 12 种语言的子集,以及自然撰写的印度语言文本。关于该模型的技术报告介绍了完整细节。我们计划在未来的 Nemotron 模型中继续利用这一语料库。
图 1. 语料库包含 26,010 亿个本族文字 token 和 2,246 亿个罗马化 token。数量使用 Gemma-4 tokenizer 统计。文档记录包含同一来源的译文和文字系统变体,并不代表去重后的英语文档数量。
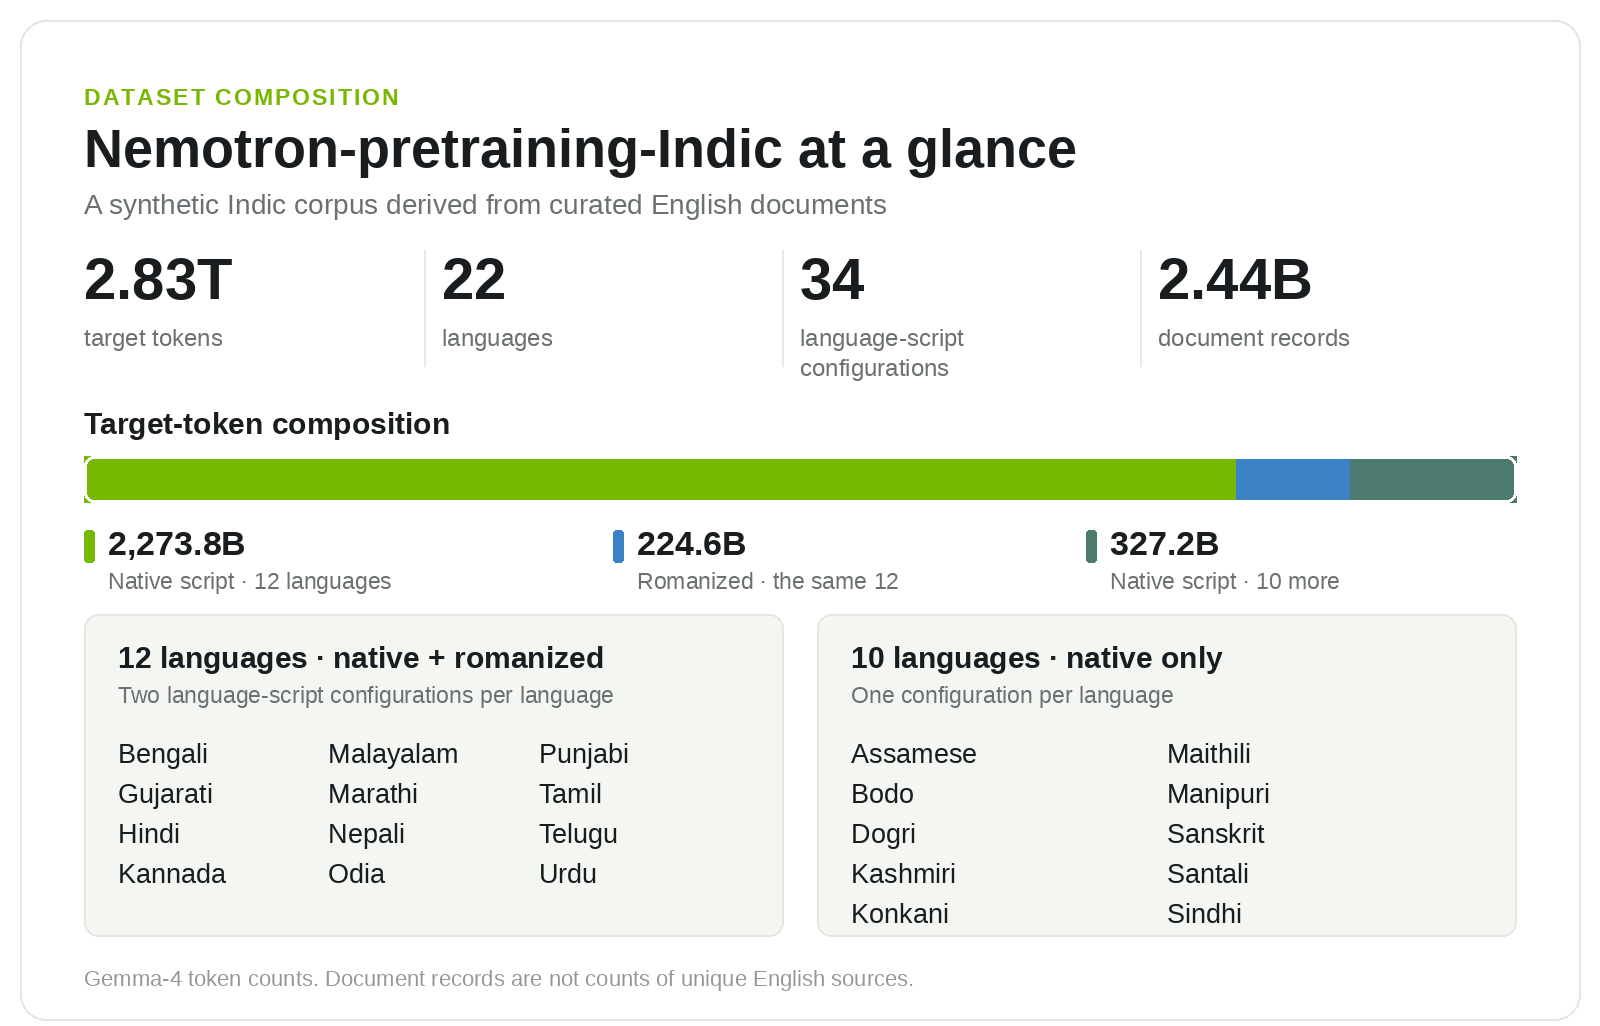
语料库包含两组语言配置:
本族文字和罗马化数据:孟加拉语、古吉拉特语、印地语、卡纳达语、马拉雅拉姆语、马拉地语、尼泊尔语、奥里亚语、旁遮普语、泰米尔语、泰卢固语和乌尔都语。
本族文字数据:阿萨姆语、博多语、多格拉语、克什米尔语、孔卡尼语、迈蒂利语、曼尼普尔语、梵语、桑塔利语和信德语。
这里的“本族文字”描述的是书写系统,文本仍然是从英语翻译而来的。“罗马化”指使用拉丁字母书写的印度语言文本,而非英语译文。对于同时提供两种文字形式的 12 种语言,罗马化处理仅覆盖已通过验收的本族文字译文中的一部分。
在构建训练数据混合方案时,这一区别很重要。本族文字记录和罗马化记录让模型接触到不同的文字系统,但可能表达相同的底层内容。token 数量描述的是最终保留的语料库规模,其中包含通过验收的改写结果,而非某次训练运行的 token 预算。统计数量也取决于所使用的 tokenizer,因此应分别理解语料库的数据规模与训练 token 数量。
为构建这一语料库,我们首先从 Nemotron-CC-v2 的 15 个子集中获取文档,内容涵盖网页文本、问答材料、数学、代码及其他专业内容。我们使用 NVIDIA 的开源合成数据生成框架 NeMo Data Designer,执行翻译、质量检查和针对性修复。在整个工作流中,我们保留每份源文档的标识符,以便开发者将输出追溯至原始文档。这样清晰的来源信息,是开放数据能够被切实审查并用于后续开发的重要条件之一。图 2 展示了面向 12 种语言的工作流。
图 2. 使用 NeMo Data Designer 和 Gemma-4-31B-it 实现的四阶段印度语言合成数据流水线,覆盖 12 种语言。我们先翻译英语文档,再评估翻译质量、修复低分输出,最后将部分通过验收的译文转换为拉丁字母。其余 10 种语言采用下文介绍的独立 Indic Translate 工作流。
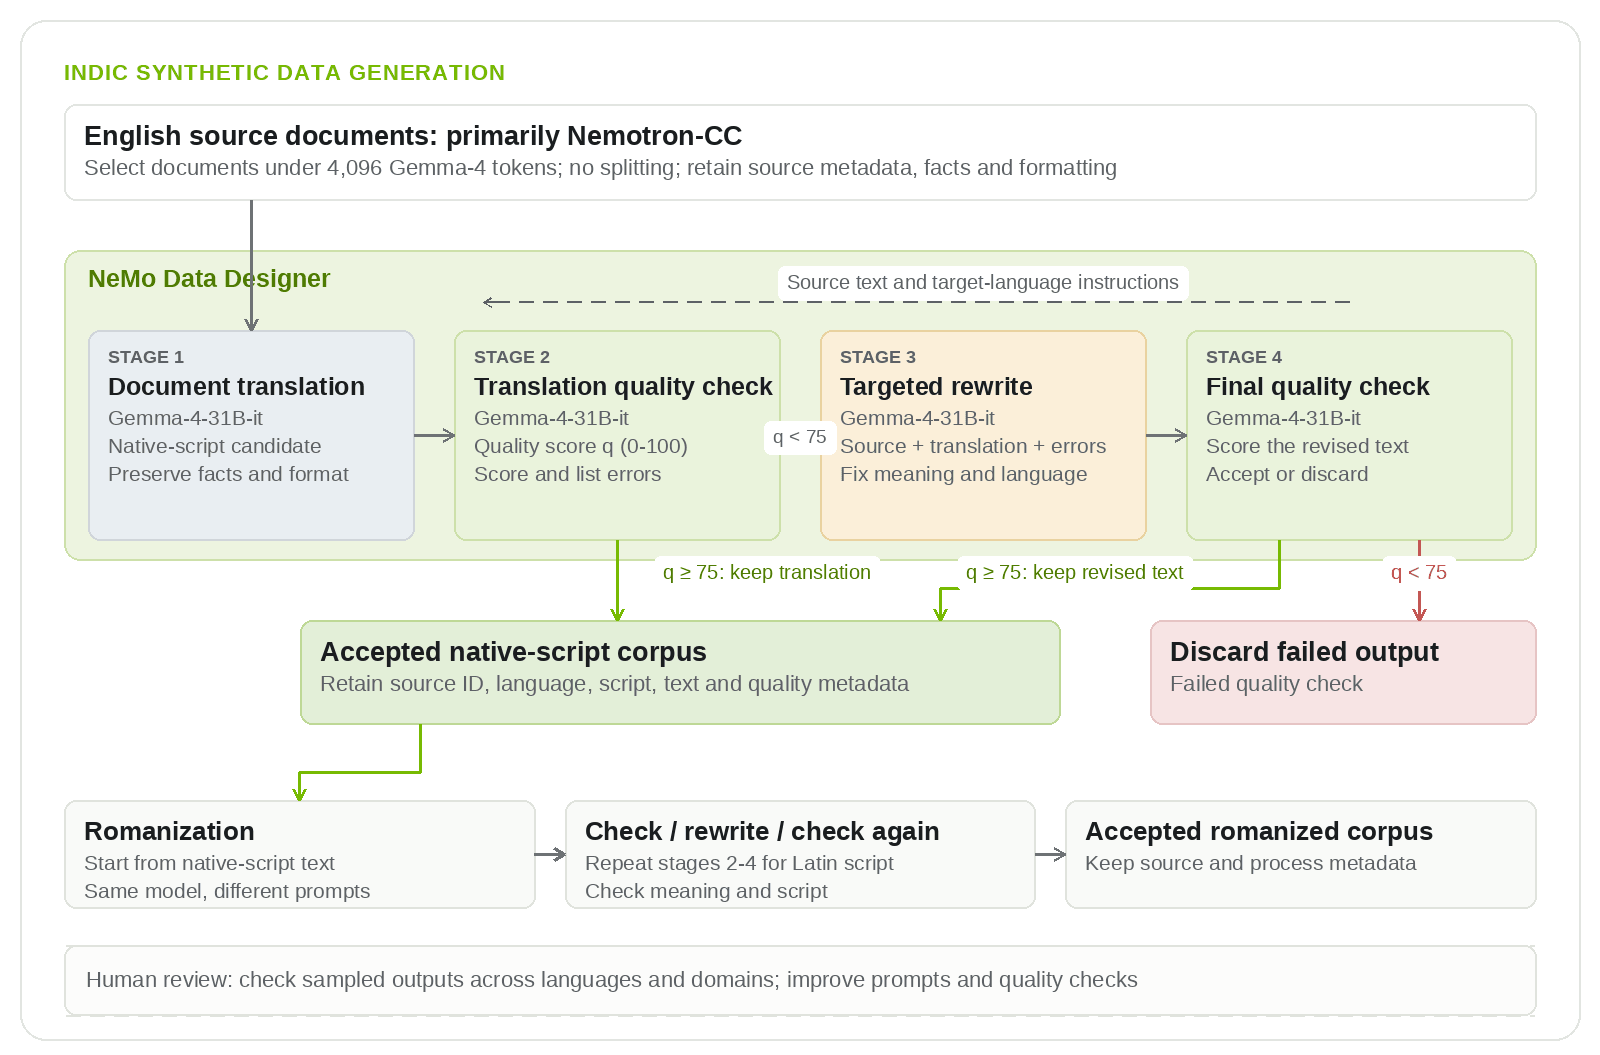
对于这 12 种语言,我们对整篇文档进行翻译,使模型能够利用段落、表格和公式之间的上下文。我们通过对比不同模型在完整文档上的表现,检查翻译质量和技术内容的保留情况,最终选择了 Gemma-4-31B-it。我们的提示词会区分需要翻译的自然语言文本与需要保留的内容,后者包括代码、公式、URL 和格式。
翻译完成后,我们使用同一个模型,将每份输出与其英语源文档进行对照评估。评估量表借鉴了多维质量指标(Multidimensional Quality Metrics,MQM),覆盖语义、流畅度、术语、风格和格式。MQM 是一种按类型和严重程度对翻译错误进行分类的开放框架。我们仅保留评分至少为 75 分的输出,满分为 100 分;这是量表评分,并非准确率百分比。对于评分较低的输出,我们使用评估反馈指导修复,然后按照相同阈值重新评估。这一过程从本族文字和罗马化数据中挽回了 4,384 亿个 token,这些 token 已计入语料库总量。人工抽样审查和刻意引入错误的测试,帮助我们发现了内容遗漏和英语残留,并据此改进提示词和检查机制。
通过验收的本族文字译文也是生成罗马化数据的起点。我们将其中一部分转换为拉丁字母,并将每份结果与其本族文字输入进行对照检查。这样便将翻译与文字系统转换分开处理。在最初的人工对比中,与直接从英语生成罗马化文本相比,这种两步方法产生的幻觉性增补更少,英语残留也更少。
对于其余 10 种语言,我们调整了工作流,以解决在对比中观察到的长文档质量问题和文字系统稳定性问题。我们使用 Indic Translate 进行翻译,这是 Bodhan AI 推出的文档级翻译模型,支持英语和 22 种印度语言。Bodhan AI 是由 IIT Madras 孵化的非营利性教育 AI 中心。随后,Gemma-4-31B-it 会将每份译文与英语源文档进行对照评估。其中 8 种语言仍采用整篇文档翻译的方式。对于较长的桑塔利语文档,我们采用相互重叠的窗口进行翻译,再重建文档;对于曼尼普尔语,我们先翻译为使用孟加拉文字书写的文本,再转换为其本族文字 Meitei Mayek。这些工作流仅保留评分至少为 75 分(满分 100 分)的输出,只生成本族文字数据,不进行基于反馈的改写。
Nemotron 3.5 Super VL 技术报告比较了印度语言继续预训练(CPT)阶段开始前与结束后的模型检查点。该阶段设定的训练预算为 1000 亿个 token,其中 10%(100 亿个 token)分配给合成与自然印度语言文本的混合数据。其余 90% 则保持上一阶段训练混合数据中各组成部分的相对比例。
在报告列出的五项印度语言知识与推理基准上,得分均有所提升:MILU、Indic MMLU-Pro、Indic ARC-Challenge、Indic ARC-Easy 和 Indic GSM8K。
图 3. Nemotron 3.5 Super VL 在印度语言 CPT 阶段前后的表现。提升幅度为 4.98 至 9.82 个百分点。这一比较反映的是结合合成与自然印度语言数据的整个训练阶段带来的变化,并未单独衡量合成语料的贡献。各基准覆盖的语言有所不同;这里比较的是训练阶段前后的检查点,而非最终发布的模型版本。
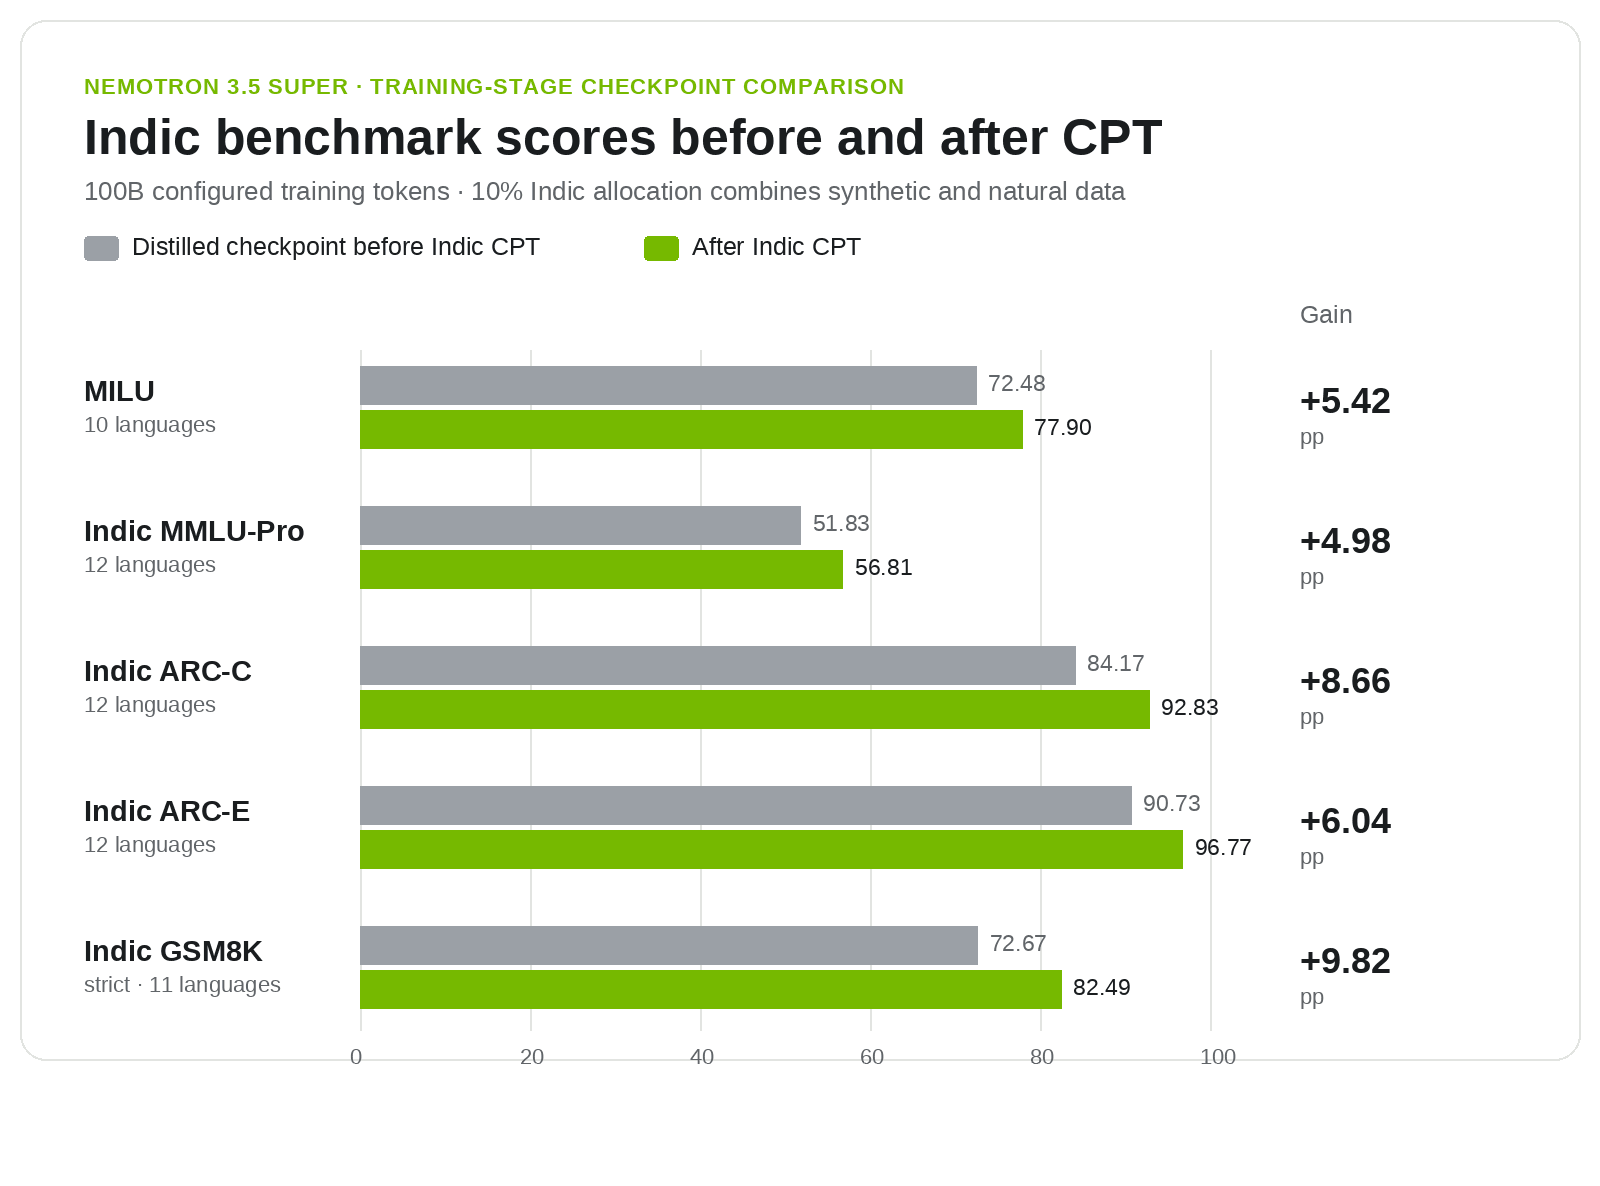
来源:Nemotron 3.5 Super VL 技术报告,表 2。GSM8K 未包含奥里亚语,因为评估超出了推理服务的上下文长度限制。
这些提升支持了将合成与自然印度语言数据结合使用的 CPT 方案,但其他模型和语言应采用怎样的数据混合比例,仍有待进一步研究。
配套的印度语言报告使用十二种语言组中首轮通过验收的数据,研究了来源混合比例、合成数据池规模和文字系统覆盖范围。对完整语料进行评估,包括经改写后通过验收的数据和另外十种语言的数据,仍是这些受控研究的下一步工作。
Nemotron 3.5 Super VL 更全面的印度语言能力
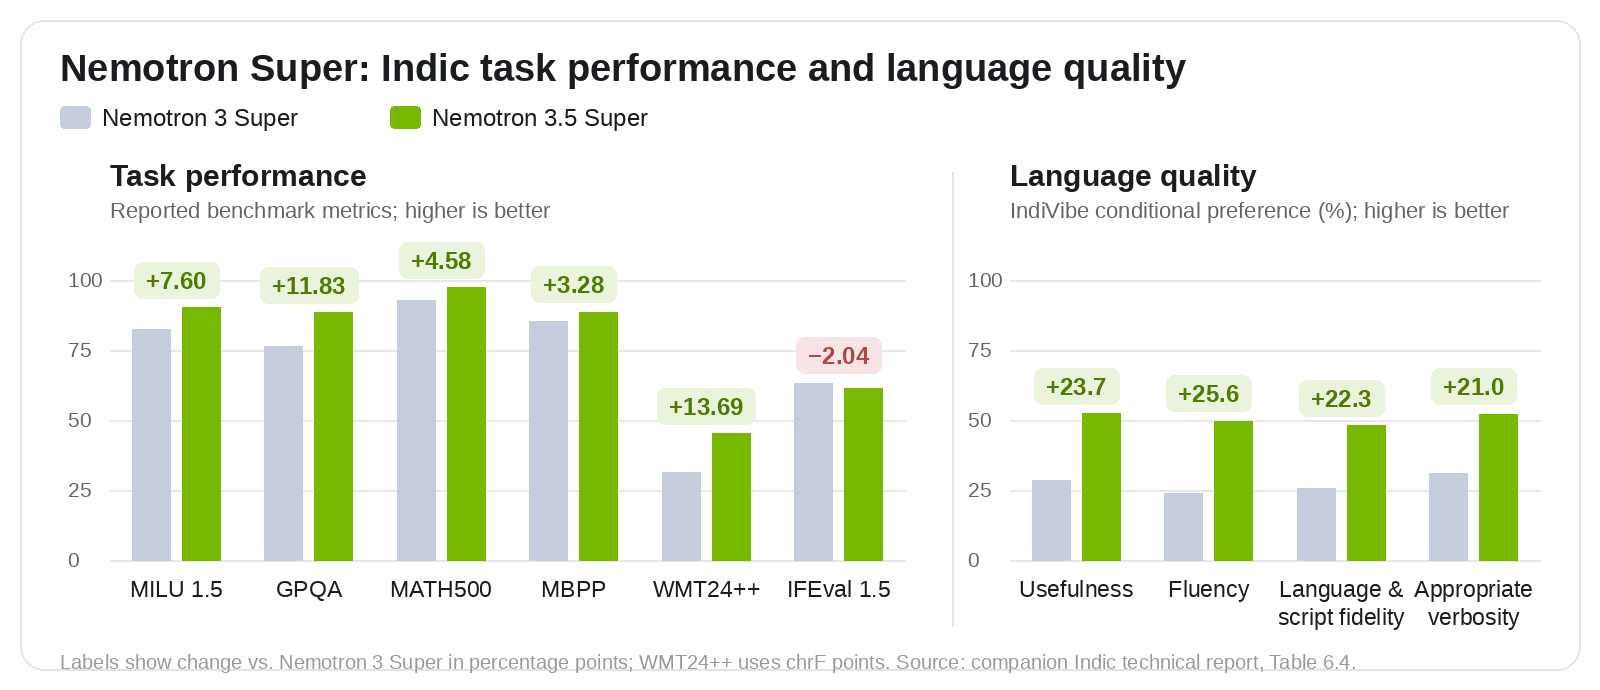
除了 CPT 阶段的结果,已发布模型与上一代相比表现如何?图 4 从印度语言任务表现和语言质量两个方面,对比了 Nemotron 3.5 Super VL 与 Nemotron 3 Super。这些结果反映了已发布模型完整训练流程的效果,包括印度语言 CPT 和后训练。
在图中展示的六项任务基准中,Nemotron 3.5 Super VL 有五项得分更高,涵盖知识、推理、数学、代码和翻译。IFEval 1.5 上的指令遵循得分下降了 2.04 分。在 IndiVibe 的全部四个维度上,它也都有提升:实用性、流畅性、语言与文字系统的忠实度,以及回答详略的适当程度。IndiVibe 是 Sarvam AI 推出的开放基准,包含使用印度语言编写的助手类提示词。这些评估共同考察了模型能做什么,以及它使用印度语言交流的水平。
图 4. 两代 Nemotron Super 的印度语言任务表现与语言质量。左图:六项任务基准。右图:初步的 IndiVibe 条件偏好得分,并非直接对战胜率。标签显示的变化以百分点为单位,WMT24++ 除外,其单位为 chrF 分。基准和评估的详细信息,请参阅配套的印度语言技术报告。
从模型所需的语言和文字系统入手,检查样本,并在训练前阅读数据集卡片和许可证。配置使用语言、文字系统和地区标签:例如,hi-Deva-IN 表示使用天城文的印地语,而 hi-Latn-IN 表示罗马化印地语。
下面的示例会要求输入数据集卡片中的仓库 ID,然后查询可用的数据划分,并以流式方式读取一个样本。
from datasets import get_dataset_split_names, load_dataset

dataset_id = input("Repository ID from the dataset card: ").strip()
config = "hi-Deva-IN"

splits = get_dataset_split_names(dataset_id, config_name=config)
print("Available splits:", splits)

data = load_dataset(
    dataset_id, name=config, split=splits[0], streaming=True
)
print(next(iter(data)))
Hugging Face Datasets 支持流式读取,因此读者无需下载整个语料库即可检查记录。数据集发布后,应固定所用的数据集修订版本,以确保实验可复现。
首次开展训练研究时,应在固定 token 预算下比较不同的混合方案,并记录自然数据与合成数据、原生文字与罗马化文字各自的占比。除了跟踪各语言的结果,还应关注英语能力的保留情况,以及语言和文字系统的质量。创建留出数据划分时,要考虑跨语言、跨文字系统中由同一来源衍生的记录。
若要构建更完整的训练方案,可将该语料与 Nemotron 后训练数据搭配使用,例如 Chat & Instruction 或 Post-Training Blends 合集。对于面向印度的合成数据,可以使用 Nemotron-Personas-India 为 NeMo Data Designer 提供种子数据。这些以英语和印地语编写的合成人物画像,以印度的真实世界分布为依据。
调整生成方案
面向 NeMo Data Designer 的开源 Nemotron Bharat 翻译插件提供了翻译与评估提示词、可选的基于反馈的改写、文档分窗处理,以及文字系统重映射支持。可参考其配置文档选择模型和语言,根据领域调整提示词,并设置改写参数。随附的开发者说明介绍了工作流程和工程上的取舍。
先从你自己的源文档中选取少量样本。检查翻译质量,以及代码、数学内容和格式的保留情况,然后与母语审阅者一起完善提示词和检查机制,再扩大规模。应将生成与语料验收视为两个独立步骤:插件返回候选文本和评分,而你的过滤策略决定哪些记录可以进入训练语料库。
适用范围与局限
翻译能让更多人读到源材料,但无法替代最初就以印度语言撰写的文本,也不能保证覆盖当地知识和文化。我们建议将该语料与来源恰当的自然印度语言文本结合使用,并针对预期用例评估最终的混合数据。
质量评估主要依靠自动化,并辅以人工抽样审阅,各语言的人工审阅覆盖程度有所不同。在十二种语言的工作流程(图 2)中,翻译模型同时也担任评判模型。保留的文本仍可能包含错误,而十种语言的工作流程还需要更广泛的母语者验证。源 ID 检查用于移除处理过程中产生的重复记录,并不等同于对相似内容进行语义去重。
除语料库之外,IIT Madras 的 AI4Bharat 也在 NVIDIA 的支持下构建 Indic-LLM-Eval-Suite。这是一个开放且持续演进的基准集合,用于评估印度语言模型的能力。它可以帮助模型开发者同时评估任务表现和语言质量。请参阅配套博文《更好的模型需要更好的基准:Indic-LLM-Eval-Suite 简介》。
探索语言配置,测试训练混合方案,或将这套开放方案调整用于新的领域。分享各语言的结果以及生成工作流程的改进,可以帮助社区在这项工作的基础上继续推进。
延伸阅读与致谢
配套报告《印度语言大模型合成预训练数据与评估的规模化》,以及 Nemotron 3.5 Super VL 和 Lightning 技术报告,提供了语料统计、生成方法、实验和评估细节。评估是这项工作的另一半。关于基准部分,请参阅 AI4Bharat 与 NVIDIA 的配套博文《更好的模型需要更好的基准:Indic-LLM-Eval-Suite 简介》。
这项工作汇集了 NVIDIA、IIT Madras、AI4Bharat 和 Bodhan AI 的共同努力。我们也感谢这条流水线所使用的模型与工具的贡献方:Google 的 Gemma、Bodhan AI 的 Indic Translate,以及 NeMo Data Designer。更多 NVIDIA 数据资源可在 Nemotron Pre-Training Datasets 合集中找到。
本文提及的模型 4
本文提及的数据集 5
本文提及的合集 2
该作者的更多文章
使用 NVIDIA Speech Agent Skills,为你的领域微调 ASR

一个模型家族,两项金牌级成绩:针对 IOI 和 IMO 微调 Nemotron
看起来很有意思,我一定会试试
· 注册或登录以发表评论


本文提及的模型 4 个
本文提及的数据集 5 个
本文提及的合集 2 个