
8.0
热点
AI SCORE
开源项目2026-10-16 15:42
TokenSpeed 面向智能体负载优化推理引擎
GitHub Trending#推理引擎#Agent#开源
Editor brief · 编辑速览
TokenSpeed 将 C++ 控制平面与 Python 执行平面分离,通过有限状态机管理请求、KV 缓存及执行重叠,并在编译期约束缓存资源复用。它提供可插拔内核和异步入口,目标是兼顾生产推理性能与易用性,性能定位仍需实测。
TokenSpeed 是一款面向 Agent 工作负载、追求光速般性能的 LLM 推理引擎,兼具 TensorRT-LLM 级别的性能和 vLLM 级别的易用性。它的目标是成为生产环境中 Agent 工作负载性能最强的推理引擎。
调度器:采用 C++ 控制平面和 Python 执行平面。请求生命周期、KV cache 所有权以及重叠执行的时序都通过有限状态机来表达,并由类型系统在编译时确保 KV 资源能够安全复用。
Kernels:采用可插拔、分层的 kernel 系统,提供可移植的公共 API 和集中式注册中心。其中包含面向 Agent 工作负载、在 Blackwell 上速度最快的 MLA(Multi-head Latent Attention,多头潜在注意力)实现之一。
入口:集成 SMG 的 AsyncLLM,以较低的开销处理 CPU 侧请求。
TokenSpeed 采用了与现有 LLM 推理引擎截然不同的架构。在欢迎 TokenSpeed 加入 PyTorch Ecosystem Landscape 时,PyTorch Foundation 特别介绍了以下架构差异:
TokenSpeed 是一个开源 LLM 推理引擎,也是首个将控制平面与执行平面分离的推理引擎。控制平面使用 C++ 实现为有限状态机,借助类型系统,在编译时而非运行时确保资源管理的安全性,涵盖请求生命周期和 KV cache 状态等。执行平面使用 Python 实现,支持快速迭代,也降低了研究人员和工程师的认知负担。这种架构将核心调度系统的强正确性保证,与高层执行层的开发效率结合起来。
TokenSpeed 还将 kernels 视为一等的模块化子系统,通过可移植的公共 API、集中式注册与选择模型,以及面向异构加速器的可扩展插件机制,将 kernels 与核心引擎解耦。
更重要的是,TokenSpeed 堪称开源 LLM 推理引擎中的瑞士:它由非营利组织 LightSeek Foundation 支持,而非商业公司,因此能够保持中立,同时获得 NVIDIA、AMD 等厂商的大力硬件与工程支持。
[2026/10] 🔥 面向 NVIDIA Vera Rubin 的 TokenSpeed MLA 2。[博客]
[2026/10] 🔥 单用户每秒 685 tokens:使用 TokenSpeed 在 NVIDIA GB300 上部署 Qwen3.8-Flash-Next。[博客]
[2026/10] 🔥 使用 TokenSpeed 推进 Kimi K3 在 AMD Instinct MI355X GPU 上的推理优化。[AMD 博客]
[2026/09] GB300 上的 Kimi K3 优化——第一部分。[博客]
[2026/08] 在发布首日支持 Qwen3.8 Flash Next 和 GLM 5.3 Flash。
[2026/08] 在发布首日支持 Qwen3.8:使用 TokenSpeed 实现 2.4T 规模的推理。[博客]
[2026/08] TokenSpeed 加入 PyTorch 生态。
[2026/07] 在发布首日支持 Kimi K3:使用 TokenSpeed 在领先平台上运行前沿模型。[博客]
[2026/07] 在发布首日支持 TML Inkling:使用 TokenSpeed 在 NVIDIA 和 AMD 平台上实现 FP4 推理。[博客]
[2026/06] 深入解析 TokenSpeed-Kernel 的设计与优化。[PyTorch 博客]
[2026/05] 🚀 TokenSpeed 在面向 Agent 的 Qwen3.5-397B-A17B 工作负载上达到 580 TPS。[PyTorch 博客]
[2026/05] TokenSpeed 正式发布——一款面向 Agent 工作负载、追求光速般性能的 LLM 推理引擎。[博客]
如需阅读 LightSeek Foundation 的技术博客、会议演讲内容和工程文章,请访问 LightSeek Blog。
LightSeek 的工作得到了 AI 生态中众多赞助商与合作伙伴的支持。
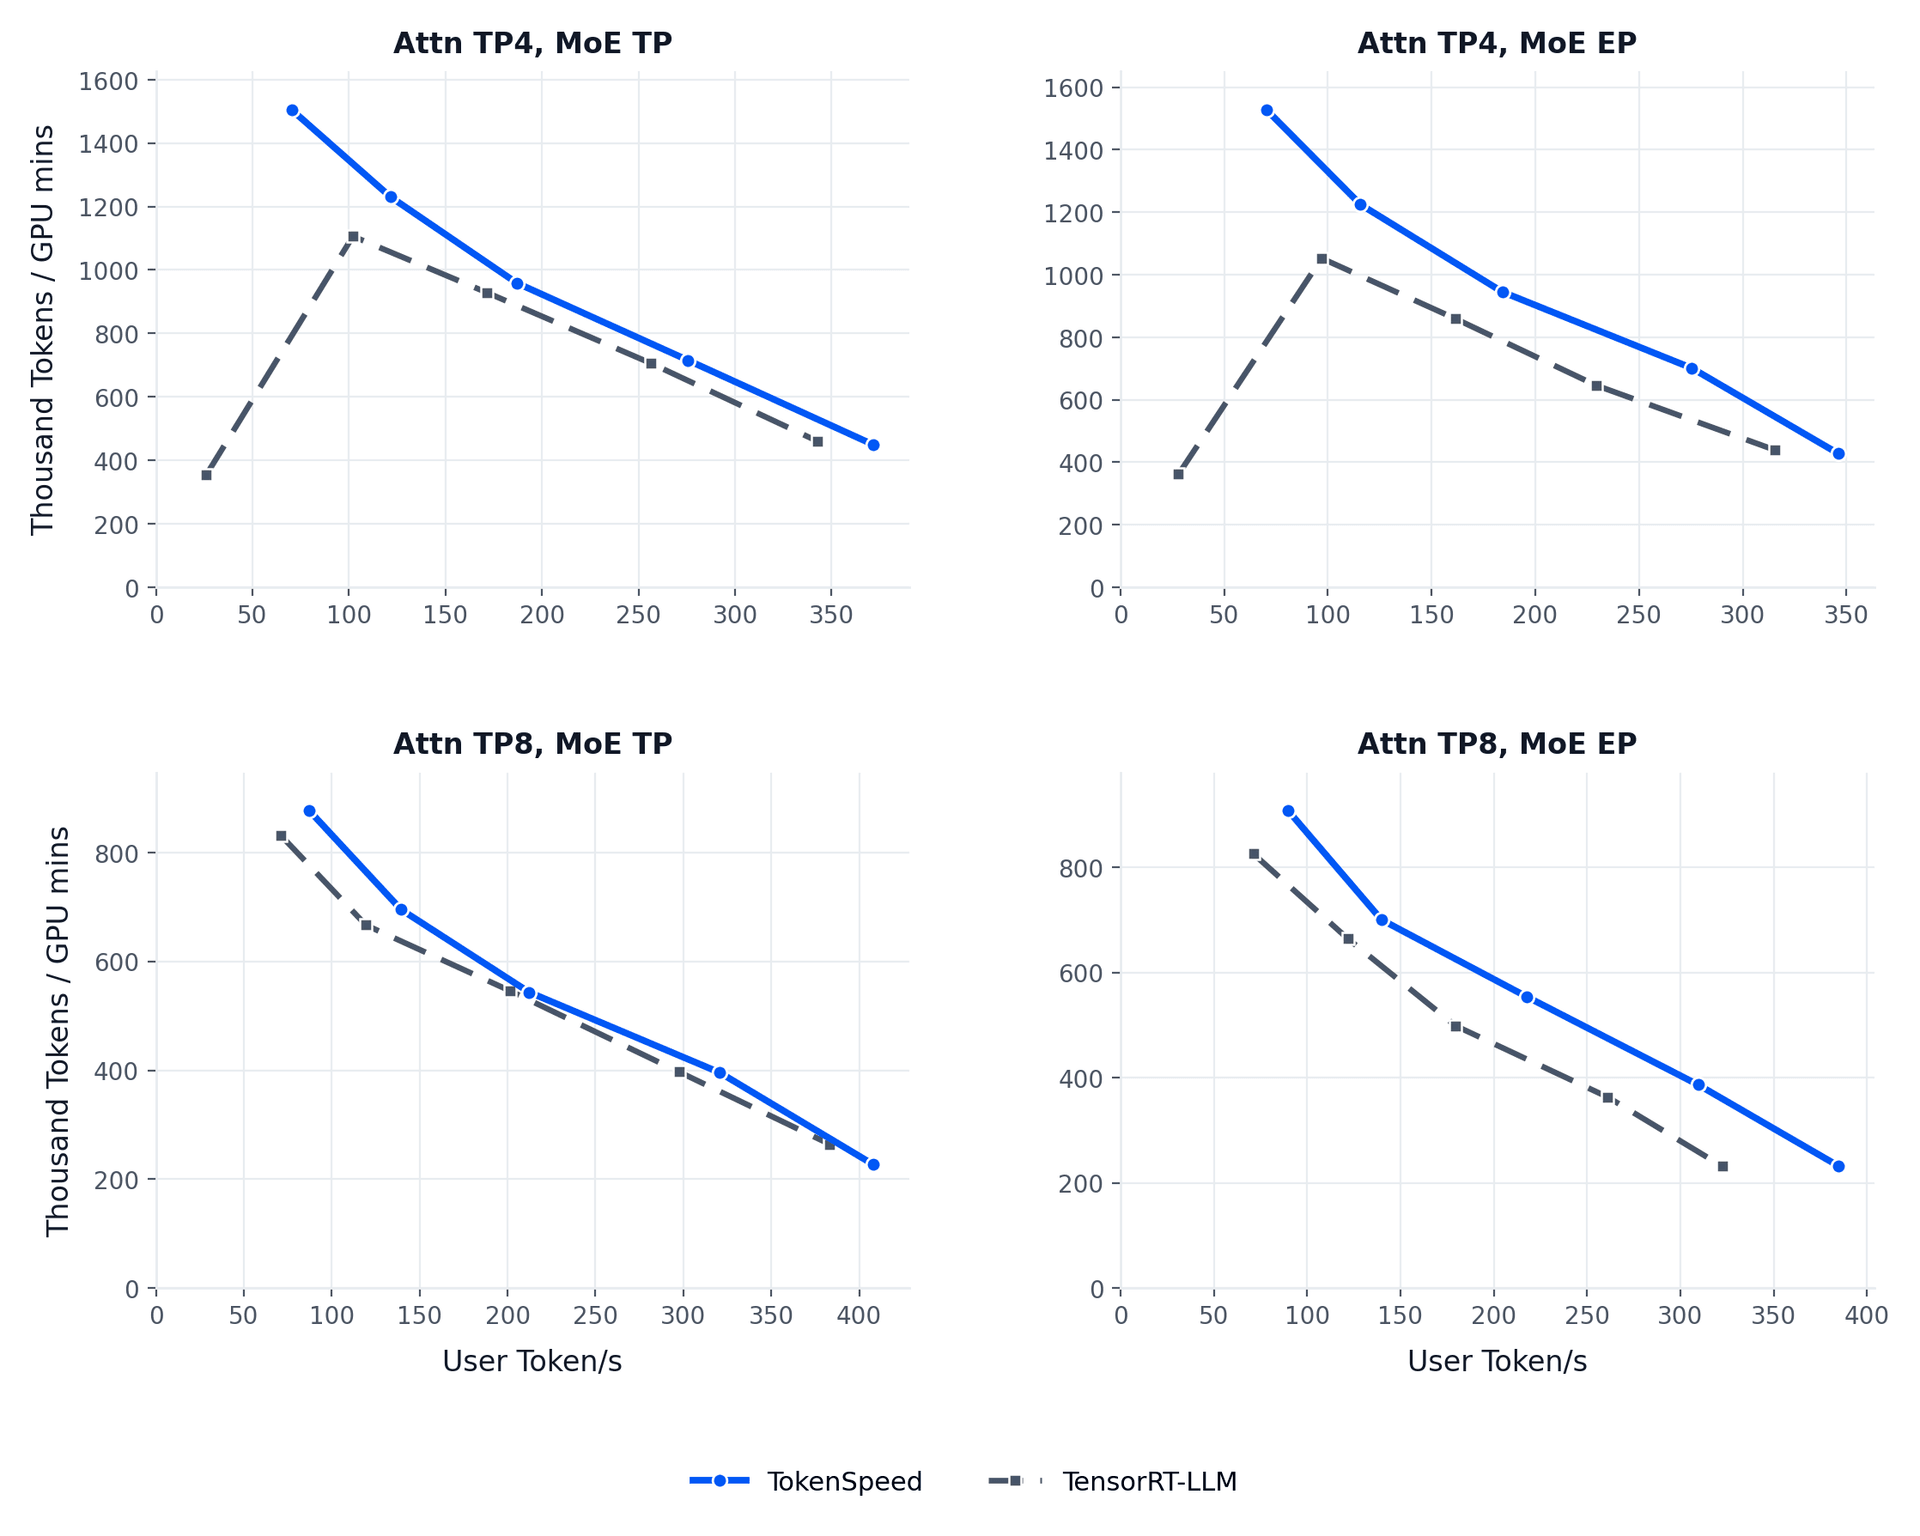
TokenSpeed 与 TensorRT-LLM 在 Agent 工作负载下的 Pareto 曲线对比(Kimi K2.5,B200)
@misc{tokenspeed2026,
  author       = {{TokenSpeed Team}},
  title        = {{TokenSpeed}: A Speed-of-Light {LLM} Inference Engine},
  year         = {2026},
  howpublished = {\url{https://github.com/lightseekorg/tokenspeed}}
}