
8.0
热点
AI SCORE
技术实践2026-10-16 15:40
异步转写接口如何避免重复计费与结果丢失
dev.to · AI#异步接口#幂等性#语音转写
Editor brief · 编辑速览
文章以转写 API 接入为例,讨论重试去重、任务轮询、结果过期及多功能请求的部分失败。创建任务返回 HTTP 202、任务标识、轮询地址和重试间隔,客户端需要围绕异步任务生命周期设计处理逻辑。
接入一个转录 API,看起来像是一个下午就能搞定的活儿。POST 一个媒体 URL,拿到返回的 JSON,然后上线。两周后,账单页面显示:380 个视频创建了 412 个任务,三位用户说字幕不见了,还有一张支持工单反馈,转录文本“过期了”。
这些问题都与转录质量无关。问题出在转录服务的接口约定上:重试时如何去重、如何等待任务完成,以及一个包含多项功能的请求中,某一部分失败时该怎么办。
最近,我一直在把 Transcript API 接入一条内容处理流水线。它的文档对这些约定讲得格外明确,很适合拿来作为具体示例。下面这些模式适用于任何异步媒体 API。
转录不是一次请求、一次响应就能完成的操作。一段 90 分钟的录音,处理起来需要实实在在的时间,所以创建任务的调用不会等到处理结束才返回。
POST /transcriptions 会立即返回 HTTP 202,并附带一个任务对象:
{
  "id": "req_example_001",
  "object": "transcription",
  "status": "queued",
  "poll_url": "/openapi/v1/transcriptions/req_example_001",
  "retry_after": 3
}
其中有三个关键字段。id 是后续所有操作使用的任务标识;poll_url 是查询进度的地址;retry_after 则告诉你,服务器希望你等多久再来查询。
如果你在开发 Web 应用,这意味着你不能直接用转录文本来响应这次 HTTP 请求。你需要保存任务 id,把它返回给客户端,再让 worker 完成后续处理。那些“为什么我的请求 30 秒就超时了”的 bug,根源都是跳过了这一步。
这个 API 中最有价值的请求头不是 Authorization,而是 Idempotency-Key。
相同的 key、相同的请求体,服务器会返回原来的任务,HTTP 状态码为 200,不会再创建第二个任务。相同的 key、不同的请求体,则会返回 HTTP 409 idempotency_conflict,告诉你:你复用了一个不该复用的 key。
这两条规则,正是生产环境需要的。对一个实现简单的客户端来说,提交请求在半途超时是最棘手的情况:你不知道任务到底有没有创建成功。没有幂等性,你要么重试并付两次钱,要么放弃重试,让任务悄无声息地丢失。有了稳定的 key,重试就不会产生额外费用。
import os, requests

def create_task(source_url, entity_id):
    return requests.post(
        "https://videotranscriber.ai/openapi/v1/transcriptions",
        headers={
            "Authorization": f"Bearer {os.environ['VT_API_KEY']}",
            "Content-Type": "application/json",
            "Idempotency-Key": f"transcribe-{entity_id}",
        },
        json={"source_url": source_url, "transcription_model": "advanced"},
    ).json()
key 的长度必须为 1 到 128 个可见 ASCII 字符,不能包含空格。用你已经持有的业务 id 来生成,不要用时间戳。另外,只要你有意更换模型或调整请求的功能,就应该生成一个新 key,因为请求体变了却复用旧 key,恰好就是触发 409 的情况。
文档中的循环刻意写得很朴素:读取 retry_after,等待,然后请求 GET /transcriptions/{request_id}。当任务状态进入终态时,停止轮询。
终态包括 succeeded、partial_succeeded、failed 和 cancelled。在此之前,状态都是 queued 或 processing,这两种状态都不是加快轮询的理由。
响应中会返回限流请求头(X-RateLimit-Limit、X-RateLimit-Remaining、X-RateLimit-Reset)和 Retry-After,让你可以有依据地退避,而不是靠猜。高频轮询除了换来 HTTP 429 rate_limit_exceeded 或 concurrency_limit_exceeded,没有其他收益。
这是大多数接入实现都会处理错的情况。一个任务可以同时请求多项功能:转录、说话人分离、章节生成、翻译、音频事件识别。如果章节生成成功,但翻译失败,任务状态会是 partial_succeeded,而不是 failed。
状态响应会分别报告每项功能的情况,包括各自的状态、配额用量和错误对象:
{
  "type": "translation",
  "status": "succeeded",
  "target_language": "es",
  "used_quotas": 1,
  "error": null
}
结果接口只会返回成功的部分。失败的功能,以及从未请求过的功能,返回值都是 null。
因此,客户端正确的处理方式是:遇到 partial_succeeded,保存成功的部分,并记录其余功能的 features[].error。不要因为章节生成失败,就把一份已经转录成功的文本也丢掉。计费也遵循同样的逻辑,这其实比乍听起来更公平:失败或被取消的功能会释放预留配额,部分成功时只对成功的功能收费。
请求级错误通过 HTTP 状态码和稳定的英文 error.code 返回。文档明确要求:应该根据 code 编写分支逻辑,绝不要根据 message 判断。
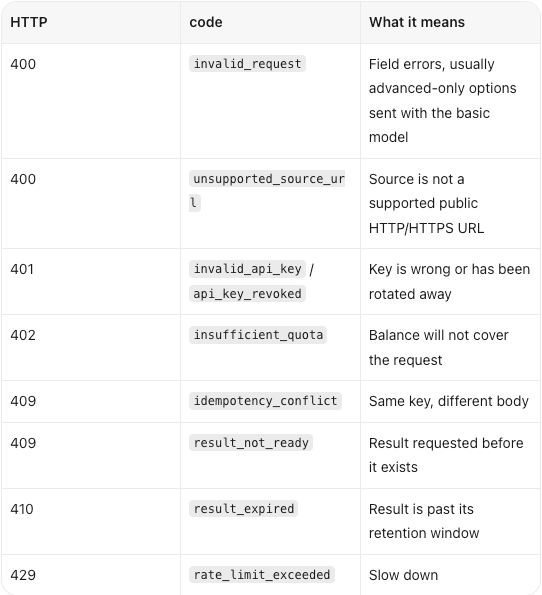
任务级错误是另一层。即使任务本身已经失败,查询状态仍然会返回 HTTP 200,因此你必须检查任务自身的 error 字段。常见错误包括 task_timeout、provider_unavailable、transcription_failed 和 no_speech_detected。
最后一种尤其值得提前考虑。静音文件、只有音乐的上传内容,以及噪声很大的文件,确实可能没有可识别的语音。这是数据问题,不是重试能解决的问题,反复重试只会消耗配额。
结果可获取的期限为 30 天。字幕下载 URL 是私有的,带有签名,有效期最长为一小时。任务记录则按 UTC 时间,保留至创建当月的下一个自然月结束。
如果你的应用六个月后还需要这份转录文本,就应该在任务成功时立即复制到自己的存储中。不要把 result_url 当作永久地址。如果下载 URL 在用户使用过程中到期,只要仍在结果保留期内,再次调用结果接口就能获得一个新地址。这个修复方法很简单,但很多人在认定功能坏了之前,偏偏忽略了它。
前面的模式都假设,客户端是由你控制的一项服务。如果客户端是 AI Agent,大部分衔接代码都可以省掉。同一套后端在 https://videotranscriber.ai/mcp 提供远程 Model Context Protocol 服务,使用 Streamable HTTP 和 Bearer API Key。它暴露了三个工具,与本文中的三种调用一一对应:create_transcription、get_transcription、get_transcription_result。只需在 Agent 客户端中配置一个 MCP 条目,鉴权、轮询和持久化这些步骤,就会在 Agent 自身的工具调用循环中完成,无须放进你的服务里。
如果 Agent 需要的是明确的工作流,而不只是几个可用的工具,官方 VideoTranscriberAI/videotranscriber-skills 仓库中的 transcribe-media Agent Skill 会将本文介绍的规则安装进去:只创建一次、保存请求 id、遵守 retry_after、进入终态就停止,以及把 partial_succeeded 视为部分成功。使用 npx skills add VideoTranscriberAI/videotranscriber-skills --skill transcribe-media --agent codex --global 安装,然后在此基础上单独配置 MCP 服务。
关键在于,这些做法都不会改变接口约定。幂等 key、按 retry_after 轮询、处理 partial_succeeded、两层错误,以及 30 天的结果保留期,依然全部适用,因为 MCP 服务和 Skill 调用的是同一个 OpenAPI 后端。
经得住生产环境考验的版本,大约只需要 150 行代码:一个支持幂等性的创建操作,一个遵守 retry_after 的轮询器,一个包含四个分支而不是两个分支的状态处理器,以及一个在成功时执行的持久化步骤。
Video Transcriber AI 的 Transcript API 在首次创建 key 时,会提供 1,500 API Quota,无须信用卡。这足够让你在正式投入之前,用真实媒体跑通整个流程。配额不会过期,所以即使你把项目搁置一个月,这份免费额度也不会浪费。
在写第一行代码之前,先读一遍错误码列表。这让我少走了一轮靠猜排错的弯路。
如需采取进一步措施,你可以考虑屏蔽此人和/或举报滥用行为。