
8.0
热点
AI SCORE
技术实践2026-10-11 08:22
两万余市场实测:Jev 不敌市场价格
dev.to · AI#模型评测#预测市场#基线对比
Editor brief · 编辑速览
作者在 26,174 个已结算市场上测试 Jev,其中发布后市场的 AUC 为 0.615,前一天市场价格为 0.844。提供价格或混合两者均未带来收益,文章附有测试代码。
Jev 能击败 Polymarket 的价格吗?只靠问题文本,不能。我把 26,174 个已结算的 Polymarket 市场的问题和结算规则发给 Jev,只问一件事:这个市场会结算为 Yes 吗?其中,9,138 个市场是在 Jev 发布后结算的,因此它不可能在训练中见过这些结果。在这些市场上,Jev 的 AUC 为 0.615,而提前一天的 Yes 成交价对应的 AUC 为 0.844。把价格告诉 Jev,它的表现反而比价格本身更差。将两者融合,也没有带来任何增益。只有 2.4% 的市场得到了 Jev「Yes 比 No 更有可能」的判断,因为它对几乎所有问题都回答 0.3。
这一篇介绍主要结果,并附上代码。还有一个我没预料到的发现:Jev 也记不住过去的市场结果。这会在第 2 篇单独展开。
在我之前的系列《Jev 用于交易:实测》的最后一篇中,我写道,Jev 没能通过我做过的任何一项仅使用价格的测试,但我还没有测试过信息不在价格里的任务。预测市场显然是一个值得尝试的方向。每个市场都有一个用普通英文写成的问题,再加上一页结算规则,这正是 Jev 所擅长处理的输入。而且,「用 Jev 找出 Polymarket 中定价有误的市场」也是当下很流行的一种说法:用代码扫描数千个市场,让 Jev 判断哪些值得交易,再用代码确定仓位并执行交易。
Polymarket 也公开了验证这套说法所需的全部数据:每个已结算市场、市场文本,以及完整的价格历史。没人为这项测试付钱给我,我也不销售任何基于 Jev 的产品。
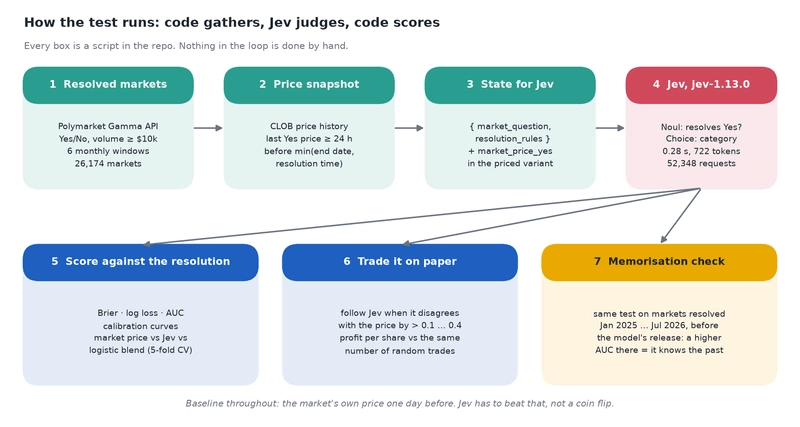
我有意把提前 24 小时的价格设为一个难以超越的基准。想击败市场的 bot,必须胜过市场的当前价格,而不是胜过抛硬币。问题在于:Jev 能否提供价格中尚未包含的信息?
Gamma API 会返回已关闭市场的文本和最终结果。我只保留那些确实由 UMA 完成结算、结果明确为 0/1,且选项为 Yes/No 的市场:
url = ("https://gamma-api.polymarket.com/markets?closed=true&limit=100"
       f"&offset={off}&end_date_min={day}T00:00:00Z&end_date_max={next_day}T00:00:00Z"
       f"&volume_num_min={min_volume}")
for m in get(url):
    prices = json.loads(m["outcomePrices"])          # e.g. ["0", "1"]
    if m["umaResolutionStatus"] != "resolved":  continue
    if set(prices) != {"0", "1"}:               continue
    if json.loads(m["outcomes"]) != ["Yes", "No"]:  continue
    keep(question=m["question"], rules=m["description"],
         yes_token=json.loads(m["clobTokenIds"])[0],
         resolved_yes=int(prices[0] == "1"), ...)
价格来自 Yes token 的 CLOB 历史记录,取参考时间之前九天的数据,粒度为每小时。「提前 24 小时」指的是该时刻或之前的最后一笔成交价:
ref = min(end_date, closed_time)                      # the event, not the resolution lag
hist = get(f"https://clob.polymarket.com/prices-history?market={yes_token}"
           f"&startTs={ref - 9*86400}&endTs={ref}&fidelity=60")["history"]

def last_before(hist, t):
    p = None
    for h in sorted(hist, key=lambda h: h["t"]):
        if h["t"] <= t: p = h["p"]
        else: break
    return p

p_24h = last_before(hist, ref - 86400)
p_7d  = last_before(hist, ref - 7 * 86400)
存续时间不足一天的市场没有提前 24 小时的价格,因此会被剔除。这排除了大多数每日加密货币市场和当天的体育赛事市场。
每个市场发送一次请求,包含两个问题。按照文档建议,state 使用一个小型 JSON 对象,Noul 则写成一个可以判断真假的陈述:
from typesafe_sdk import AsyncTypeSafeClient, Choice, Noul

state = {
    "market_question": "Will Xi Jinping visit US by September 30?",
    "resolution_rules": "This market will resolve to Yes if ...",   # cut at 1,200 chars
    # priced variant adds:
    # "market_price_yes": 0.27,
    # "market_price_note": "Price of one Yes share one day before ... the traders' implied probability",
}
questions = {
    "yes": Noul(instructions=(
        "The prediction market described in the state resolves Yes, meaning the event asked "
        "about in market_question happens according to resolution_rules.")),
    "category": Choice(
        instructions="Which category does market_question belong to?",
        criteria={"sports": "A sports match, game, season, tournament or athlete result",
                  "crypto_price": "The price of a cryptocurrency reaching, staying above or below a level",
                  "politics": "Elections, governments, legislation, geopolitics, wars, officials",
                  "economics": "Central banks, interest rates, macro data, companies, stocks, commodities",
                  "entertainment": "Movies, music, awards, television, celebrities, culture",
                  "science_tech": "Technology products, AI models, space launches, science, weather, health",
                  "other": "Anything that does not fit the categories above"}),
}

async with AsyncTypeSafeClient(model="jev-latest") as client:
    resp = await client.system_one(state, questions)
    p_yes    = resp.nouls["yes"].noul          # 0..1
    category = resp.choices["category"].choice
运行程序每次并发发送八个请求,并将每条回答追加到 JSONL 文件中。因此,即使发生崩溃或触发限流,也只需要重新运行同一条命令。全部 52,348 次请求都成功完成,没有出现一次错误。大多数 API 可做不到这一点。
评分采用常见的概率评估指标:Brier score 和 log loss(越低越好)、AUC(能否把结算为 Yes 的市场排在结算为 No 的市场之前),以及校准情况。
单独使用 Jev,只比直接猜基准发生率好一点点,Brier score 为 0.220,后者为 0.227。即便是提前整整一周的市场价格,也能轻松胜过它。而当我把价格交给 Jev 时,它确实会跟随价格变化,排序相关系数达到 0.85,但它会把所有答案都往自己偏爱的 0.3 附近拉。它的调整使 72.6% 的市场的平方误差变得更大。
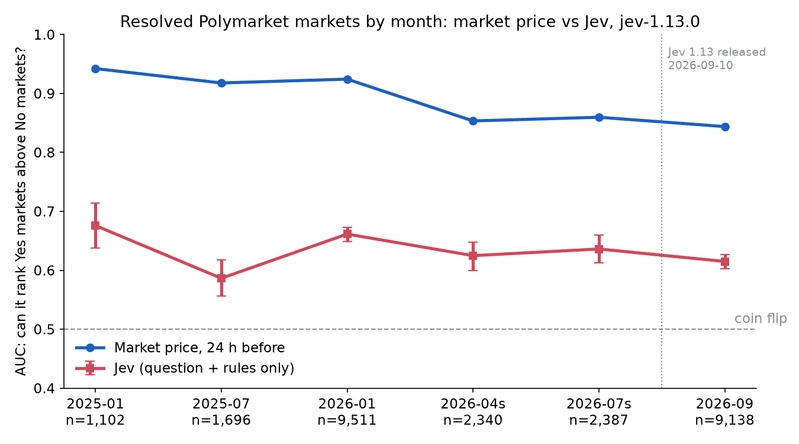
在 Jev 划分的每个类别中,都存在同样的差距。体育类的差距最小,AUC 为 0.656 对 0.774;而在价格几乎总是正确的类别中,差距最大,例如加密货币价格阈值类的 0.698 对 0.971,以及政治类的 0.633 对 0.956。
这一点值得仔细看看。下面是回答的分布:
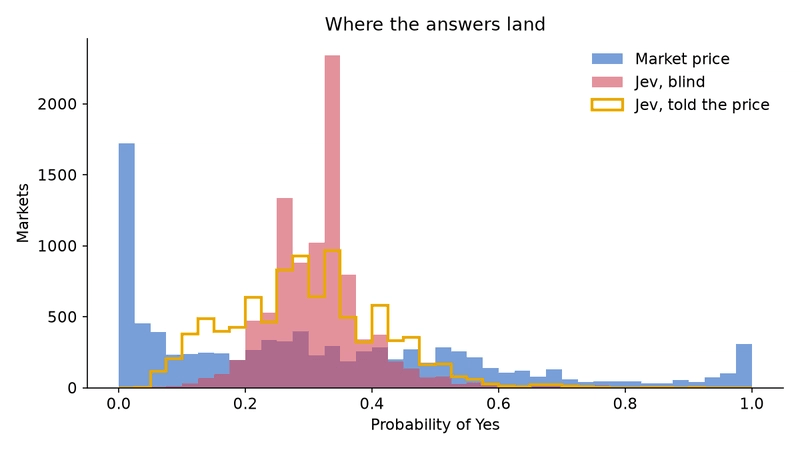
无论问题是什么,十个市场中有九个得到的回答都在 0.2 到 0.45 之间。价格为 1 美分的市场和价格为 99 美分的市场,得到的数值几乎一样。
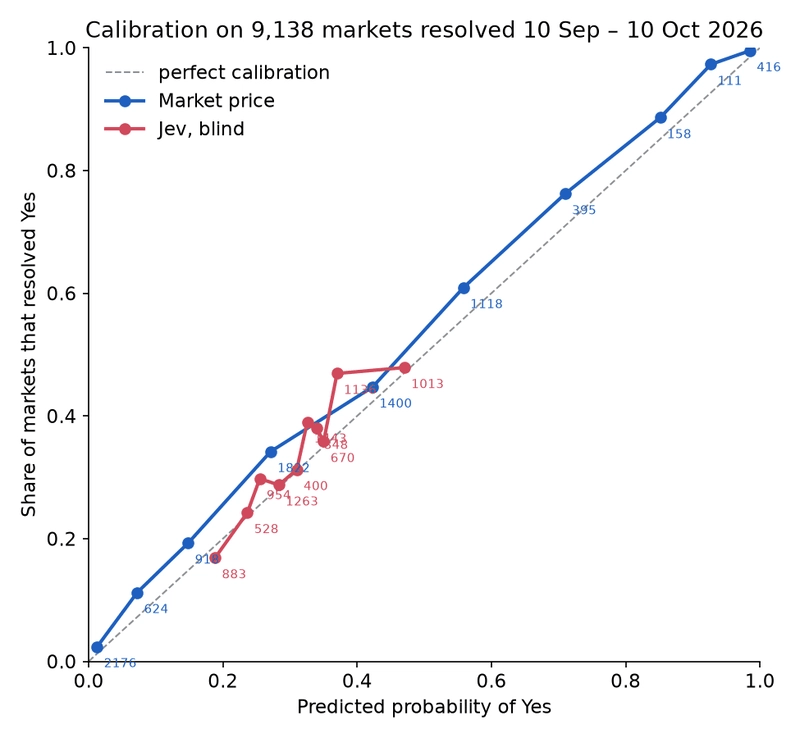
在这个狭窄区间内,它的校准还算合理:当它回答 0.19 时,大约 17% 的市场最终结算为 Yes;当它回答 0.47 时,大约 48% 的市场结算为 Yes。所以它并没有撒谎。面对一个它无法知道答案的问题,它给出的回答接近于「预测市场通常会结算为 No」。这句话是对的,这里只有 35% 的市场结算为 Yes,但它对挑选交易机会毫无用处。
做了三项检查,结果都是否定的。
融合。 对市场价格的 logit 和 Jev 输出的 logit 做 logistic regression,采用 5 折交叉验证,得到的 Jev 权重为 +0.20,Brier score 仍为 0.150,与仅对市场价格重新校准的结果相同。
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import KFold

X = np.column_stack([logit(p_market), logit(p_jev)])
pred = np.zeros(len(y))
for train, test in KFold(5, shuffle=True, random_state=0).split(X):
    m = LogisticRegression(C=10.0).fit(X[train], y[train])
    pred[test] = m.predict_proba(X[test])[:, 1]
print(brier(pred, y), m.coef_)        # 0.150, [+0.92, +0.20]
在同一价格区间内比较。 这对应的是「筛选定价错误」的用法。取出所有价格在 35 到 65 美分之间的市场,看看 Jev 能否判断哪些最终会结算为 Yes。它在这个区间内的 AUC 为 0.536。对于价格低于 5 美分的小概率市场,AUC 为 0.480。对于价格高于 85 美分的大概率市场,AUC 为 0.379,甚至不如把它的判断反过来用。一旦知道价格,Jev 给出的数字就不再提供额外信息。
模拟交易。 当 Jev 给出的概率比价格高出某个阈值时,买入一份 Yes;当它低于价格超过该阈值时,买入一份 No。只考虑价格在 10 到 90 美分之间的市场,不计手续费或买卖价差。
for d in (0.1, 0.2, 0.3, 0.4):
    buy_yes = p_jev - p_market > d
    buy_no  = p_market - p_jev > d
    pnl = np.concatenate([y[buy_yes] - p_market[buy_yes],              # Yes share pays 1 or 0
                          (1 - y[buy_no]) - (1 - p_market[buy_no])])    # No share costs 1 - price
    print(d, len(pnl), pnl.mean())
Jev 与市场的分歧越大,亏得就越多。这说明,对于 Jev 无法知道的事情,市场的判断才是对的。
那些分歧最大的案例,比表格更能说明问题:
这些问题无一例外,答案都在前一天的新闻里,却不在 Jev 训练时读过的任何文本中。对于 Lake America,Jev 给出的 0.05,是根据训练数据所描述的世界得出的一个完全合理的先验概率。但市场已经读过新闻了。这就是全部差距所在:预测市场交易者的优势来自最新信息,而问题文本里没有这些信息。
阅读理解。 Choice 问题要求判断市场属于七个类别中的哪一类。在关键词规则能够标注的 8,105 个市场中,Jev 的回答与规则的匹配率达到 98.6%。这与我之前的 Bitcoin 测试呈现出相同的模式:Jev 能准确理解输入,并回答那些可以从输入中找到答案的问题。而未来某件事会不会发生,并不属于这类问题。
只测试了一个模型版本,jev-1.13.0,以及一种提问方式。我只尝试了一种 Noul 表述。换一种表述,数值会略有变化,但并不会让 Jev 获得新闻信息。
不提供价格的 state 也没有任何上下文。真正的 bot 会加入新闻、博彩公司给出的赔率,或者当前的 BTC 价格。这样一来,你测试的就是这些上下文,而 Jev 成了读取上下文的工具。这才是我实际上认为可能有效的用法。我只测试了 Jev 在没有额外信息时,自己是否知道些什么。
存续时间不足一天的市场被排除了,因为它们没有提前 24 小时的价格。这些主要是每日加密货币市场和体育赛事市场。
模拟交易忽略了买卖价差,并假设你能按最后一笔成交价买入。真实成交只会更差,因此负面结果仍然是负面的。
成交量筛选门槛为 10,000 美元及以上。交易清淡的市场可能更容易出现定价错误,但也更难交易。
如果我要做一个这样的 bot,我会按这套宣传说法来构建,也按它所暗示的标准来衡量:如果扫描程序找到 1,000 个候选市场,而 Jev 留下了 30 个,那么这 30 个市场的最终结算表现就必须优于那 1,000 个。只靠问题文本,它做不到。Jev 的输出几乎就是恒定的 0.3 加上一些噪声,而根据这些噪声采取行动,亏损会随着它与价格的分歧程度增大而增大。
可能有效的是那个朴素的版本:用代码找到候选市场并收集最新信息,再让 Jev 阅读这些信息,所问问题的答案就包含在提供给它的文本中。「这篇文章是否说会议取消了?」是适合 Jev 的问题。「会议会举行吗?」则不是。
所有内容都已放在 GitHub 上,你可以重新运行:github.com/truongxxxx/jev-polymarket-test。总共五个脚本,没有 notebook:获取市场、获取价格、构建数据集、调用 Jev、评分。对全部 26,174 个市场运行 Jev,费用约为 1.60 美元;只跑一个月的数据,则只需几美分。
接下来是第 2 篇:我原以为 Jev 会记得 2025 年发生过什么。结果它并不记得,而这会改变你对它进行回测的方式。
如需采取进一步行动,可以考虑屏蔽此人和/或举报滥用行为。