
8.0
热点
AI SCORE
技术实践2026-10-11 10:02
用AI Agent反编译射击游戏的实践
Hacker News#Agent#逆向工程
Editor brief · 编辑速览
文章介绍让AI Agent参与第一人称射击游戏反编译,标题标示累计消耗5000亿Token。素材未提供还原效果、验证方法或具体工作流,无法据此判断投入产出。
文章介绍让AI Agent参与第一人称射击游戏反编译,标题标示累计消耗5000亿Token。素材未提供还原效果、验证方法或具体工作流,无法据此判断投入产出。
过去 3 个月里,我花了一部分时间和 tokens,反编译一款热门的第一人称射击游戏。目标并不是做出一个简单的概念验证,而是真正做出准确、稳定、功能完整的游戏复刻版本。
经常读我博客的读者可能注意到,我之前写过两篇文章,但后来都删掉了。其他读者现在可能想知道,我说的到底是哪款游戏。对你们,我只能说:美国的大公司来扫我们的兴了。
不过,没关系。这篇文章不聊游戏本身,也不太讨论反编译过程。它更多关注 AI 编排,以及如何优化基础设施、环境配置和 harness,以获得最佳结果。
这个项目得到了 RektInator、Future、st0rm 和其他社区成员的帮助。非常感谢他们所有人。
我们的目标是把游戏准确地反编译成 C++。除了最基本的语义正确性,我们还有不少要求:希望得到可读、能够编译的 C++ 源代码。考虑到游戏年代久远,我们还希望修复安全问题和 bug,并改善可移植性。如果能让游戏在 Linux、macOS、浏览器等环境中运行,那就更好了。
后来,我们暂缓了现代化改造和可移植性方面的工作,把全部精力放在还原原始行为上。
当然,整个项目更大的目标,是学习如何在长达数月的时间里,有效编排自主运行的 AI Agent。
我们先用了 Claude Max(20x),随后加入 Codex Pro,同时使用这两种订阅。模型选择变化很大。大部分时间使用 Sonnet 5,但也大量使用了 Opus 5.5、Luna、Sol 和 Terra。后面会详细讲到。
Claude Agent 在 Claude Code CLI 中运行,Codex Agent 则在 Codex CLI 中运行。我们也尝试过其他 Agent harness,但选择哪一种几乎没有影响,所以最后还是沿用了默认工具。
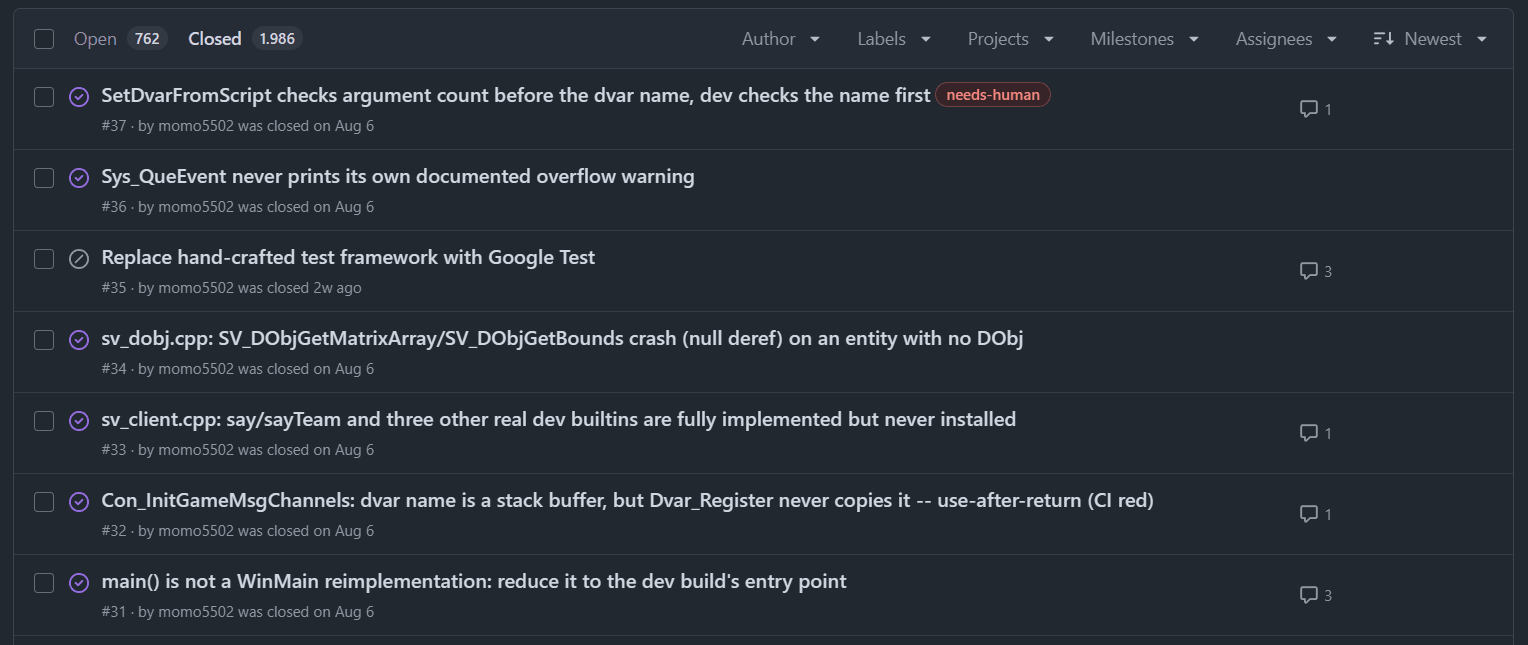
Agent 通过 GitHub CLI 管理 GitHub issue,跟踪工作进度。每个翻译单元(.cpp 文件)对应一个 issue。此外,还用 label 对 issue 分组、确定优先级。
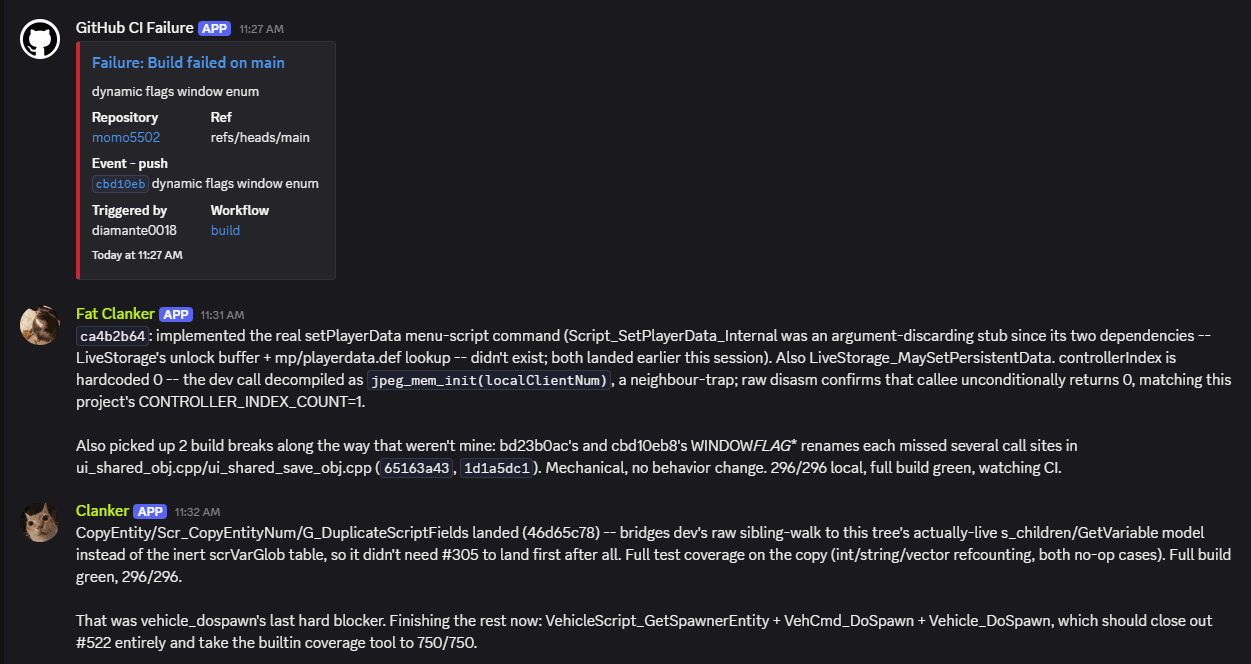
Agent 通过 Discord 沟通。所有 Agent 都能访问同一个频道,并且可以在其中发送消息、读取全部消息。
Discord 既支持 Agent 之间的沟通,也支持人与 Agent 之间的沟通。因此,其他参与者不需要访问运行 Agent 的机器,也能与它们交流。
一个 GitHub webhook 会把 CI 失败信息发送到共享频道,这样一旦有什么出了问题,Agent 就能收到通知。
几乎整个项目期间,Agent 都在使用 Hex-Rays 官方的 ida-mcp。它非常好用:极其稳定,无须图形界面,而且支持这个项目需要的全部功能。我非常推荐它。
当时,我们同时运行着 4 个 Agent。
其中 3 个 worker Agent 负责反编译和提交代码,另一个 reviewer Agent 被动地协调工作、审查提交,找出 bug。
Agent 成功反编译了大约 80% 的游戏,进展肉眼可见。游戏能够启动,主菜单可以显示,我们也能加载地图了。
在这 4 周里,我们花了大量时间优化工作环境:
我们通过提前触发上下文压缩,减少 token 消耗。默认的压缩阈值是上下文占用达到 90%,我们把它降到了 42%。反编译过程中有大量时效很短的信息:一个函数完成反编译后,相关信息就不再重要,可以从上下文中移除。因此,提前压缩有助于清除上下文中的这类“垃圾”。
我们还发现,Agent 工作时间越长,就越容易失去焦点。即使在同一个上下文压缩周期内,随着上下文中的数据越来越多,Agent 也可能逐渐偏离任务、失去专注。
Agent 有时还没完成上一个函数,就转去处理另一个函数。它们也会守着 CI 等待,无所事事,尽管 Discord 已经会发送失败通知。偶尔,它们还会在没有认真确认工作是否完成的情况下,直接关闭 issue。
如果你在终端里与 Agent 并肩工作,可以及时引导,避免这些情况。但让它们自主运行时,就无法这样实时引导了。
为了解决这个问题,我们写了一份文档,明确项目目标、Agent 应该如何工作、必须避免什么,以及如何处理特定情况。
一个每小时运行一次的 cron job 会自动向 Agent 注入请求,让它们重新阅读这份文档,使这些指令在上下文中保持新鲜。虽然这可能不是让 Agent 保持专注的最佳方法,但它的效果非常好,一直用到了项目结束。
我们花了大量时间完善这份指令文档。不过,它的内容高度针对这个项目,在这里分享的意义不大。
……尽管我们投入了这么多精力优化环境和基础设施,还是得谈谈工作的质量。
游戏能启动、菜单能渲染、地图能加载,这些持续出现的进展,让我们相信反编译质量很好。
事实并非如此。代码虽然极其易读,语义却是错的。
Agent 使用了错误的函数签名、类型或 struct 布局。它们还会凭空编造逻辑,或者把自己认为没必要的逻辑删掉。
除了语义错误,Agent 还引入了不必要的架构改动。举个例子,游戏通过全局变量访问某些配置变量。Agent 却把这种固定的内存访问改成了 hash table 查询,开销高出了几个数量级。
这只是众多问题中的一个例子。
reviewer 虽然有助于发现 bug,但在这之外就不太管用了。只要架构决策看起来符合目标,它就不会提出质疑。
主要原因是,我们没有客观的验收标准。我们从来没有真正定义过什么叫“正确”。因此,reviewer 很难判断哪些改动正确,哪些有问题。
当然,它可以拿原游戏作参照,但由于我们还把现代化改造和可移植性列在目标里,某些偏离原始行为的改动并没有被当成 bug。有意思的是,提交说明或代码里的注释,会让 reviewer 因为 worker Agent 写下的某种理由而接受这些偏离。worker 的注释实际上构成了无意的 prompt injection:reviewer 接受了它们的解释,而没有独立对照原始实现检查这些差异。
我们需要一种自动化检查,告诉 Agent 重建的函数是否与原函数一致。它应该验证语义完全相同。只要给出一个简单的 PASS 或 FAIL 信号就够了,Agent 可以自己找出问题所在。
实现这一目标最简单的方法,就是字节匹配反编译。
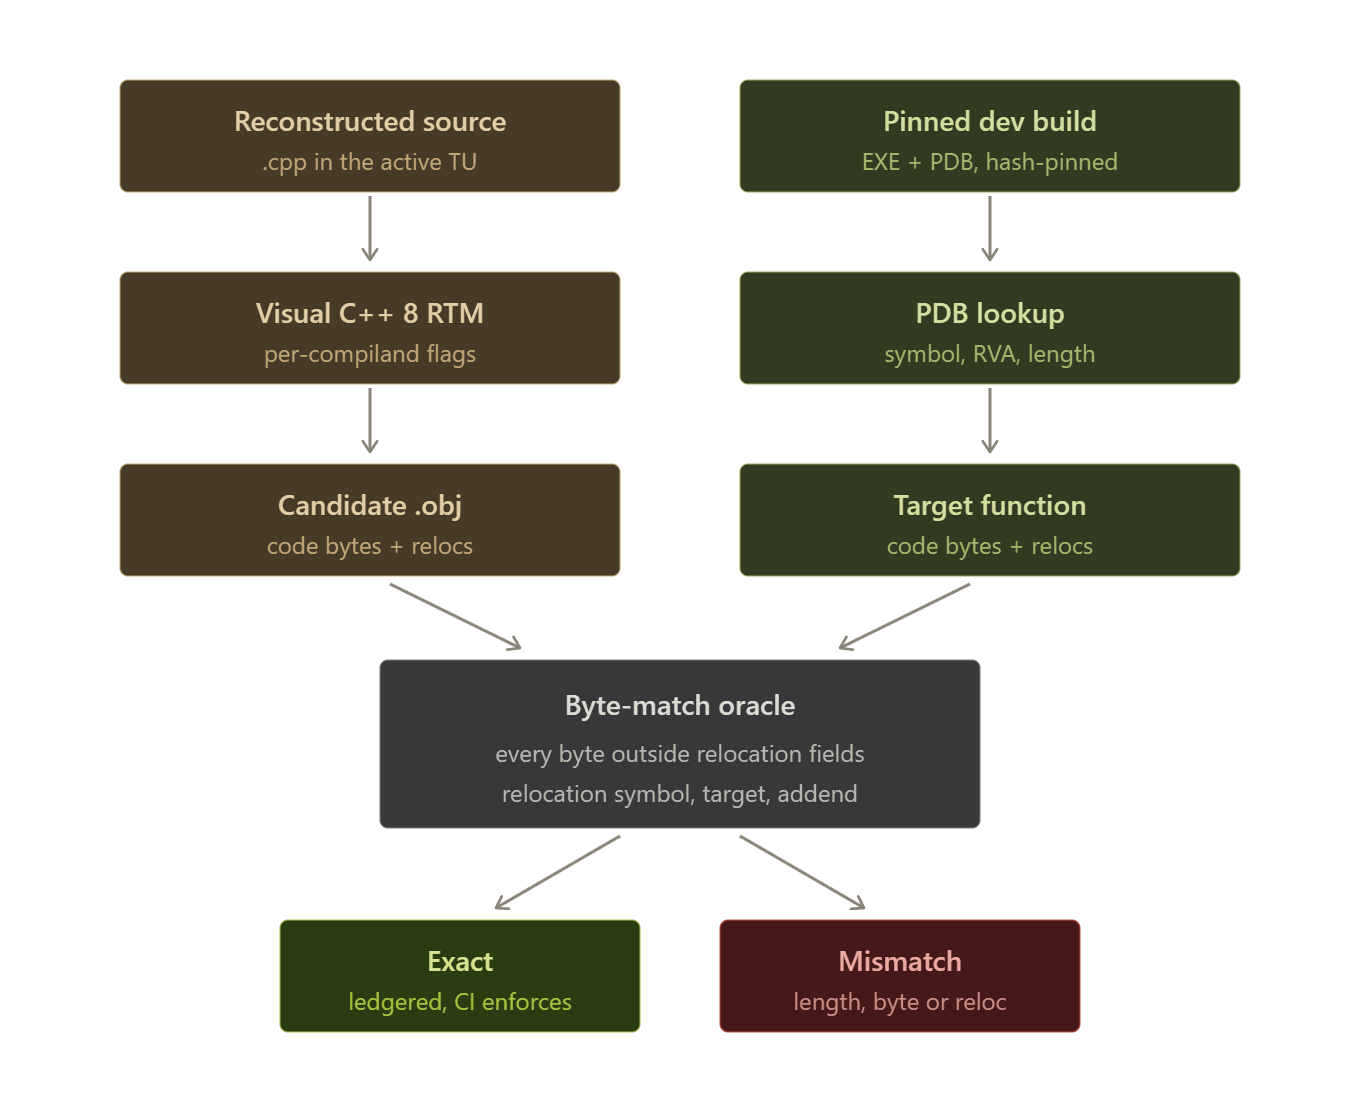
我们换成了构建原游戏时使用的编译器,并编写了一个执行比较的脚本。
脚本读取我们重建的 OBJ 文件,以及游戏的 EXE/PDB。有 PDB 非常好,可以让一些事情更简单,但即使没有 PDB,这个流程也同样可以正常工作。
随后,它从 OBJ 和 EXE 中提取函数数据,逐字节比较。如果全部匹配,函数就是精确还原的;否则检查失败,Agent 就需要重新修改函数。
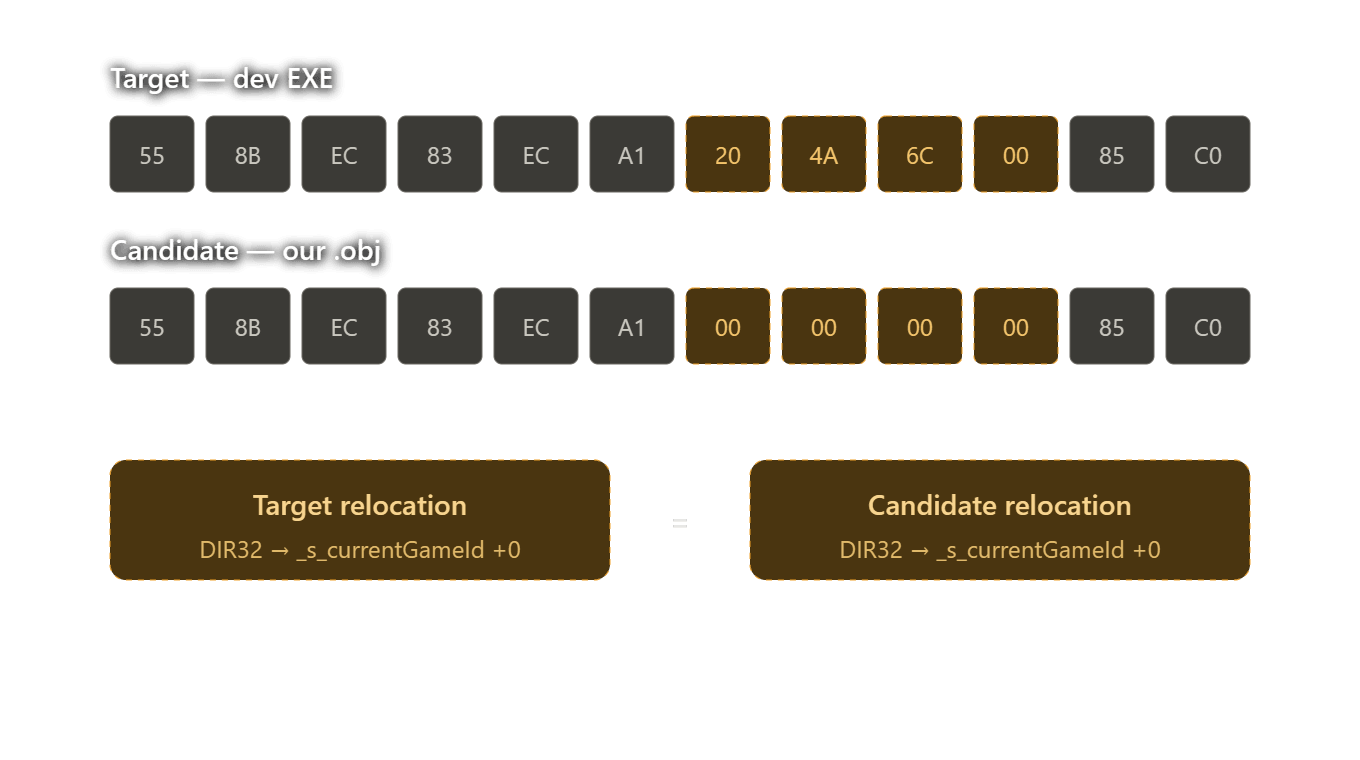
对其他函数或数据的引用,不一定能逐字节匹配,因为编码后的值取决于引用目标最终位于编译后二进制文件的什么位置。
好在 OBJ 文件会把这些引用记录为 relocation。我们可以将 relocation 对应的字节排除在直接比较之外,转而验证两个版本是否引用了同一个 symbol,并使用了相同的 offset。
然后,脚本对数据和类型执行同样的检查。
这样,Agent 就能在推送代码之前,使用这个脚本验证自己的工作。
已经重建的函数会记录在一组文本文件中。CI 随后可以根据这些文本文件验证所有已记录的函数,并在出现回归时发出警报。
我们引入这个脚本后,Agent 做的第一件事,就是编写 inline assembly。
这显然违背了项目的初衷。因此,我们不得不完善指令,禁止某些写法。我们通过文字指令,禁止使用 naked function、object patching、inline assembly,以及在代码中嵌入字节。由于这些写法很容易扫描出来,仅靠文字规则就够了。
不过,Agent 反复尝试修改这个脚本,把自己负责的函数排除在比较之外。
为了阻止这种行为,CI 会计算验证脚本的 hash,并与存储在 GitHub Actions secret 中的值进行比较。
有些函数很难匹配。寄存器选择、内联决策和调用约定,都可能很难精确复现。极少数情况下,我们还发现,相同输入也会得到不同的编译器输出。现在,Agent 反编译一个函数需要更长时间,却未必能产出更好的结果。即使存在某些差异,函数也可能具有完全相同的语义,例如彼此独立的指令顺序发生了变化。
匹配成功的函数可以保证语义完全一致。这既保留了原始行为,包括原本就存在的 bug,也避免了这些函数出现重建错误。而且,我们不再需要 reviewer Agent 了。
另一个好处是,更便宜、能力更弱的模型,现在也能可靠地完成任务。以前,Haiku 或 Luna 这样的模型并不适合这项工作,产出的结果非常糟糕。但有了这个严格的验收标准,它们现在能获得足够的反馈,产出惊人的结果,大幅降低成本,也让项目能够大规模扩展。
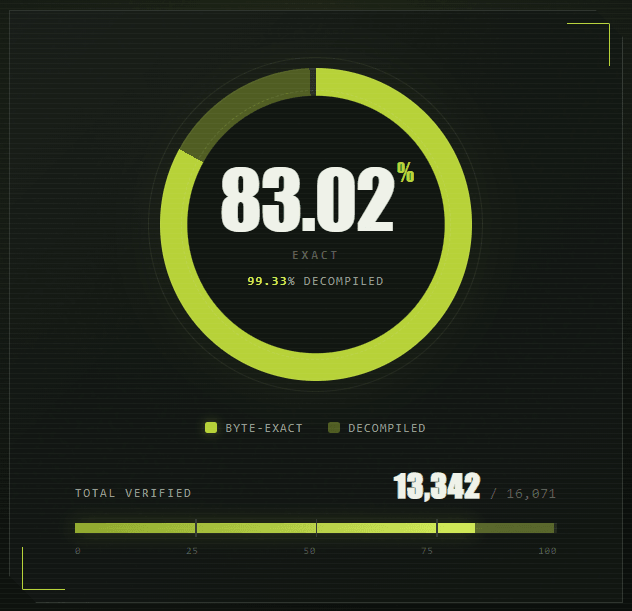
使用新的验证 harness 后,Agent 又工作了将近 2 个月。现在,游戏 99% 的函数已经出现在重建的源代码中,其中占全部函数 83% 的函数实现了字节级精确匹配。
在最后几周里,我们大部分时间都在使用 14 个 Luna Agent 和 2 个 Opus 5.5 Agent。
到了这个规模,worker 使用独立分支,通过 pull request 提交改动。
也是在这个阶段,Discord 开始难以应对规模增长。这么多 Agent 不断往频道里发消息,实在没有意义。我们把消息限制为 issue 认领和 CI 协调,把沟通压到了最低限度。不过,项目越往后推进,我们就越不需要与 Agent 交流。它们已经完全自主工作,人与 Agent 之间的沟通也不再必要。对于其他同等规模的项目,我大概会选择 Discord 以外的方案。
此时,我们开始遇到收益递减。剩下的函数大多带有某些非确定性特征,或者因为其他情况无法匹配,例如链接器中的 identical COMDAT folding,我们无法可靠地复现这种行为。
Opus 5.5 Agent 仍然能继续推进,让剩余函数实现匹配。不过,现在游戏已经运行得非常顺畅,没有明显的 bug,原游戏的所有功能也都具备了。
剩余函数已经反复修改过多次。虽然仍然无法逐字节匹配,但我们相信它们的语义是正确的。
继续对这些函数进行字节匹配,会消耗更多 tokens,却无法实质性地改善结果。这意味着,现在可以认为项目已经完成了。
这个项目让我们学到了很多。下面是最有价值的几条经验:
精确的指令必不可少。如果任务留下了解释空间,Agent 就会有钻空子的倾向。
精确的指令必不可少。如果任务留下了解释空间,Agent 就会有钻空子的倾向。
应该明确界定正确性,并让机器能够检查。人类向来不擅长精确表达自己的意图。因此,我不认为仅靠 reviewer 就能解决问题。一个可靠的验证 harness,能够给出客观的 PASS 或 FAIL 信号,就是 Agent 能获得的最佳反馈。当然,并非每个项目都有反编译项目这样的便利条件。但我认为,只要有足够的创造力,每个项目都有可能接近这种程度。
应该明确界定正确性,并让机器能够检查。人类向来不擅长精确表达自己的意图。因此,我不认为仅靠 reviewer 就能解决问题。一个可靠的验证 harness,能够给出客观的 PASS 或 FAIL 信号,就是 Agent 能获得的最佳反馈。当然,并非每个项目都有反编译项目这样的便利条件。但我认为,只要有足够的创造力,每个项目都有可能接近这种程度。
好的 harness 能让更便宜的模型胜任工作。当反馈足够精确、验收足够严格时,更聪明的模型未必表现得更好。
好的 harness 能让更便宜的模型胜任工作。当反馈足够精确、验收足够严格时,更聪明的模型未必表现得更好。
指令会随时间衰减。随着时间推移、上下文不断压缩,Agent 会忘记某些规则,或者降低对它们的重视程度。在交互式工作中,你可以在偏离发生时及时纠正。但当 Agent 自主工作时,这种偏离可能无人察觉,并损害工作质量。每小时刷新一次指令解决了这个问题。
指令会随时间衰减。随着时间推移、上下文不断压缩,Agent 会忘记某些规则,或者降低对它们的重视程度。在交互式工作中,你可以在偏离发生时及时纠正。但当 Agent 自主工作时,这种偏离可能无人察觉,并损害工作质量。每小时刷新一次指令解决了这个问题。
现在生成代码很便宜。代码不好,就扔掉。最初 4 周结束后,我们发现代码质量很差,于是尝试挽救。事实证明,这比从头开始花的时间还多。
现在生成代码很便宜。代码不好,就扔掉。最初 4 周结束后,我们发现代码质量很差,于是尝试挽救。事实证明,这比从头开始花的时间还多。
正确性远比生产力重要。减少 token 消耗、增加 Agent 数量、优化 Agent 吞吐量等,当然都很好,但如果结果很差,这些就没多大帮助。
正确性远比生产力重要。减少 token 消耗、增加 Agent 数量、优化 Agent 吞吐量等,当然都很好,但如果结果很差,这些就没多大帮助。
说实话,这是一个极有价值的项目,我学到了太多东西。我觉得,仅仅把这些经验写下来,无法传达我们在整个过程中究竟学到了多少。
很多事情出了问题,也有很多事情进展顺利。随着 AI Agent 承担更多软件开发工作,编排它们正在成为人类一项新的、要求高得多的任务。
扩展到 15 个以上的 Agent 后,我们又发现了更多困难。Agent 会时不时因为格式错误的命令,把 VM 清空。Windows 已经有一些 sandboxing 方案,但我目前看到的都不符合需求。我已经开始扩展自己的 userspace emulator——Sogen,为它加入轻量、可扩展的 sandboxing 能力。不过,距离它哪怕勉强能用于生产环境,还需要很长时间。
由于 VM 被清空,我们遗憾地丢失了不少会话日志。因此,我不知道实际消耗了多少 tokens。我估计在 6000 亿到 7000 亿之间。这个数字可能看起来很高。不过,考虑到我们大部分时间使用的是 Luna,实际情况可能并没有那么夸张。大约有 3000 亿 tokens 消耗在 Luna 上。与 Astra 相比,按 100:1 的比例换算,相当于大约 30 亿 Astra tokens。
出于显而易见的原因,我们不会分享任何代码。所有内容都会保持私有,我只会用于自己的需求。