
8.0
热点
AI SCORE
技术实践2026-10-11 03:37
美团如何用统一模型承接外卖多业务精排
美团技术团队#推荐系统#美团#大模型
Editor brief · 编辑速览
美团在 MTGR 基础上提出 MTFM,将外卖多个主要业务的精排统一到一个推荐基座模型。文章介绍该模型在多业务场景中的落地实践。
美团在 MTGR 基础上提出统一推荐基座大模型 MTFM,首次实现外卖多个主要业务的统一精排模型。围绕规模可扩展性、场景可延展性与架构高效性三大挑战,MTFM 以异构 Tokenizer 与动态掩码实现多场景特征免对齐,通过混合注意力与 Target Scale-Up 提升模型的规模扩展能力,借鉴 LLM 优化实践提升深层网络训练效果,并以用户级训练范式与定制算子保证系统开销可控。美团外卖多个业务的订单量提升 2.06%~6.68% 不等,推理成本降低 24%,相关工作已被 KDD 2026 收录。
我们去年提出了 MTGR[1]——一种新的生成式精排框架,在美团外卖推荐场景验证了 Scaling Law 的有效性,并取得显著业务收益。然而,推荐领域对 Scaling Law 的探索往往局限于单一场景内部,模型被限制在单场景孤岛中,跨场景的数据、算力和架构无法充分复用。在美团,这一问题尤为突出:推荐覆盖外卖首页、拼好饭等多个业务场景,各场景长期独立建模。与此同时,大语言模型(LLM)已验证了一条清晰路径:基座模型(Foundation Model)足以统一处理编程、数学、写作等多领域任务,也可以将文本、图像、语音等异构信息表示为 Token 序列并进行端到端学习,展现出强大的泛化性与可扩展性。因此,我们认为,美团推荐下一阶段的关键在于打通跨场景的异构性,充分利用多场景数据提升 Scaling Law 的上限,即建设统一推荐基座大模型。
推荐基座大模型主要面临三个核心挑战:规模可扩展性(Scalability)、场景可延展性(Extensibility)和架构高效性(Efficiency)。规模可扩展性要求模型在参数规模、数据量扩大时,效果能够稳定、可预期地提升;场景可延展性要求模型能够以低成本适配已有场景或接入新场景;架构高效性要求模型在处理多场景海量数据时,训练和推理仍保持可接受的成本开销。
为解决上述挑战,我们在 MTGR 的基础上提出了美团统一推荐基座大模型 MTFM(Meituan Foundation Model for Recommendation)。MTFM 使用类 Transformer 骨干网络进行端到端建模,提出 Target Token Scale-Up 以提升模型能力,并借鉴 LLM 实践优化深层网络训练策略;通过异构 Tokenizer 替代固定特征模板,支持多场景异构特征免显式对齐;提出自注意力(Self-Attention)和目标注意力(Target Attention)堆叠的混合架构,结合用户级样本和 GPU 算子优化提升训练与推理效率。
MTFM 首次实现了外卖多个主要业务的统一精排模型,并在各核心场景完成全量上线,相关工作于 2026 年 5 月被 KDD 2026 接收[2]。
场景收益:全面超越 MTGR 或 DLRM 基线模型,各业务离线指标大幅提升,在线效果最显著的业务线订单增长超过 6%。
规模扩展:在模型参数量、序列长度上展现了稳健的规模扩展能力,为后续落地更大规模的基座模型打下基础。
资源效率:单样本计算量达到 192 GFLOPs,相比传统 DLRM 提升数百倍,在线推理成本降低 24.0%。
核心目标是在共享跨业务用户兴趣表达的同时,兼顾不同业务间的分布差异与个性化需求。多场景建模主要沿着两个方向演进。第一类方法遵循“先同构、再解耦”的范式,将模型参数拆分为域共享与域特定两部分。例如,STAR[3] 采用星型拓扑结构,将领域参数锚定在共享中心参数周围;M3OE[4] 进一步引入多个 MoE 模块,在通用、领域和任务层面学习层次化用户偏好;MLoRA[5] 则通过轻量化 LoRA 适配不同领域,提高参数效率。第二类方法开始探索多场景基座模型,通常采用“基座模型 + 专家模型”的架构。例如,ExFM[6] 将超大规模模型的知识蒸馏到场景专家模型,LFM4Ads[7] 通过多粒度机制在特征与任务间迁移表示。这类方法并非端到端建模,可能限制模型能力的上限。
推荐模型的规模扩展范式主要沿着三个方向演进。第一类方法聚焦 DLRM 骨干网络扩容,通过扩展特定的可堆叠模块实现规模扩展。例如,RankMixer[8]、TokenMixer-Large[9] 通过 Token 混合、逐 Token FFN 与稀疏 MoE 增强特征交互能力。第二类方法将输入特征切分成独立 Token,采用 Transformer 骨干网络进行端到端统一建模。具体而言,HSTU[10] 将推荐重新定义为序列转导任务,采用高性能架构捕获用户行为模式;MTGR 在此基础上引入交叉特征与双向注意力机制,进一步丰富特征交互;OneTrans[11] 通过金字塔式截断策略提升训练与推理效率。第三类方法探索生成式自回归推荐,例如 OneRec[12],通过下一 Token 预测(NTP)将推荐改写为序列生成任务,尝试以统一生成框架替代传统的“召回—排序”架构。
MTFM 的模型架构如图 1 所示,支持多场景统一建模,并面向基座模型的三个核心属性进行创新改造:
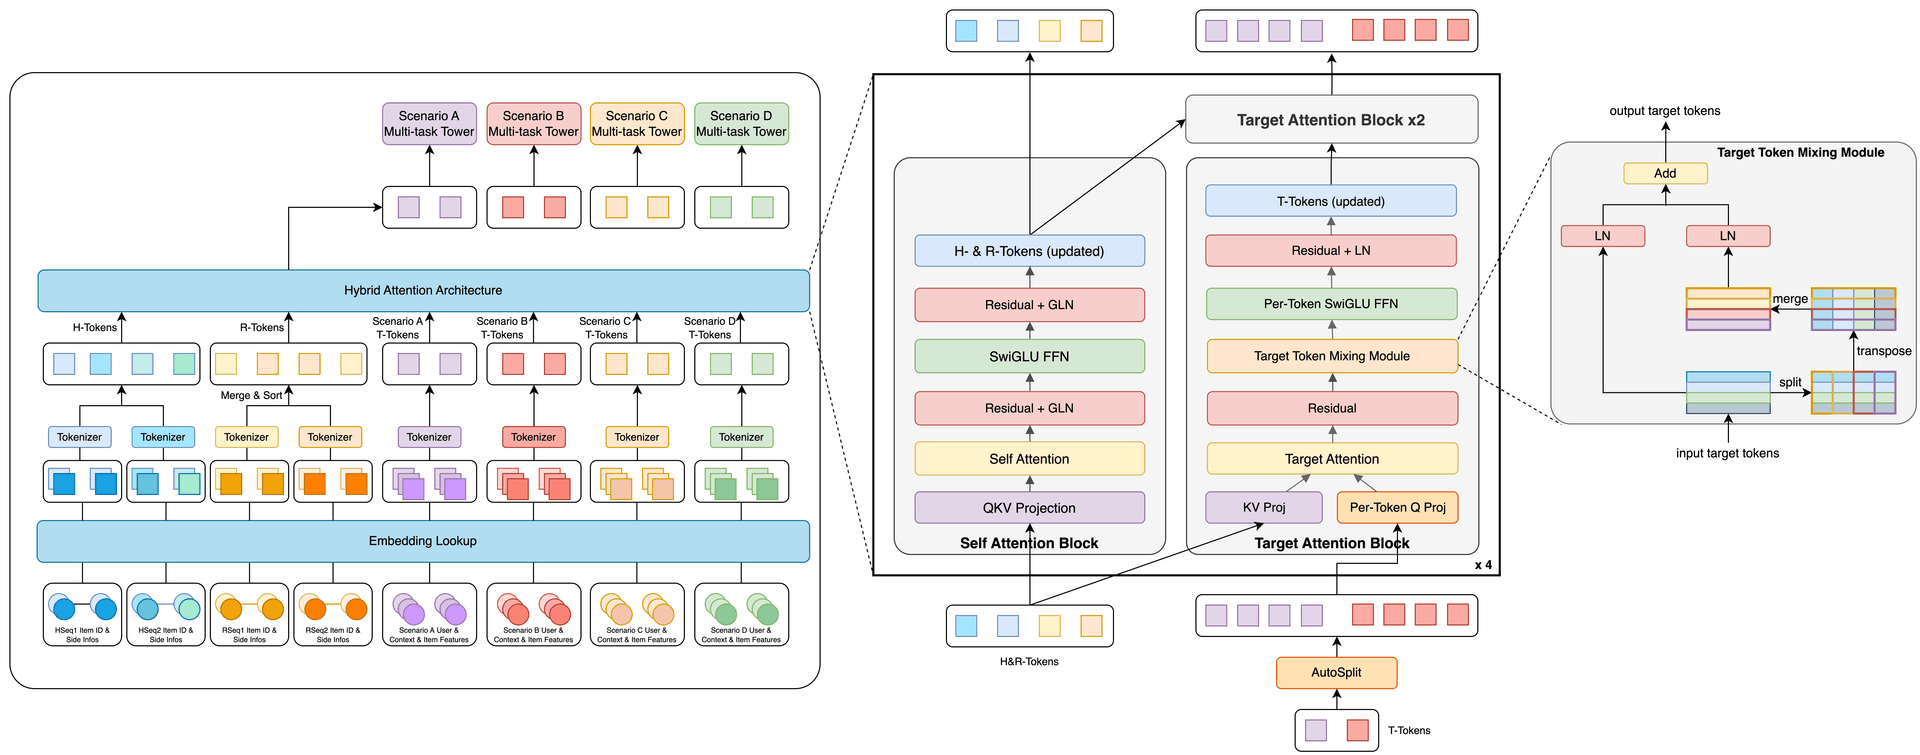
规模可扩展性:整体采用类 Transformer 模块堆叠作为骨干网络,并针对性地设计 Target Token Scale-Up,以支持用户序列与目标信息的规模扩展。
场景可延展性:将多域输入抽象为统一的异构 Token 序列,让模型无需人工对齐特征模板,即可无损提取各场景的异构信号,并通过动态掩码机制控制跨场景信息与时间因果关系的可见性,避免信息泄漏。
架构高效性:受 LLM 混合架构启发,MTFM 引入混合目标注意力机制(Hybrid Target Attention),避免自注意力平方复杂度带来的性能瓶颈。在少数关键层使用自注意力以维持全局依赖捕捉能力,主要堆叠目标注意力,将算力分配给更重要的目标感知计算。
MTFM 将多业务输入统一组织为三类 Token:H-Token、R-Token 与 T-Token。其中,H-Token 表示用户跨业务历史行为序列,包括商家统一序列与商品统一序列,用于建模用户长期兴趣;R-Token 表示用户近实时行为序列,包括点击、加购等行为,按行为时间戳统一排序;T-Token 表示待预估目标(商家、商品或券包),包含上下文特征、候选侧特征及交叉特征。其中,H-Token、R-Token 在所有业务间共享,T-Token 由各业务独立维护。
模型采用统一的 Token 化范式:针对 H-Token、R-Token,不同序列使用各自独立的 Tokenizer 完成编码;针对 T-Token,将上下文特征与候选侧特征拼接,再通过业务独立的 Tokenizer 编码。最终,所有 H-Token、R-Token 与 T-Token 按顺序堆叠,形成统一的 Token 序列,输入共享的注意力骨干网络,在无需显式对齐跨业务特征体系的情况下,实现多场景统一建模。
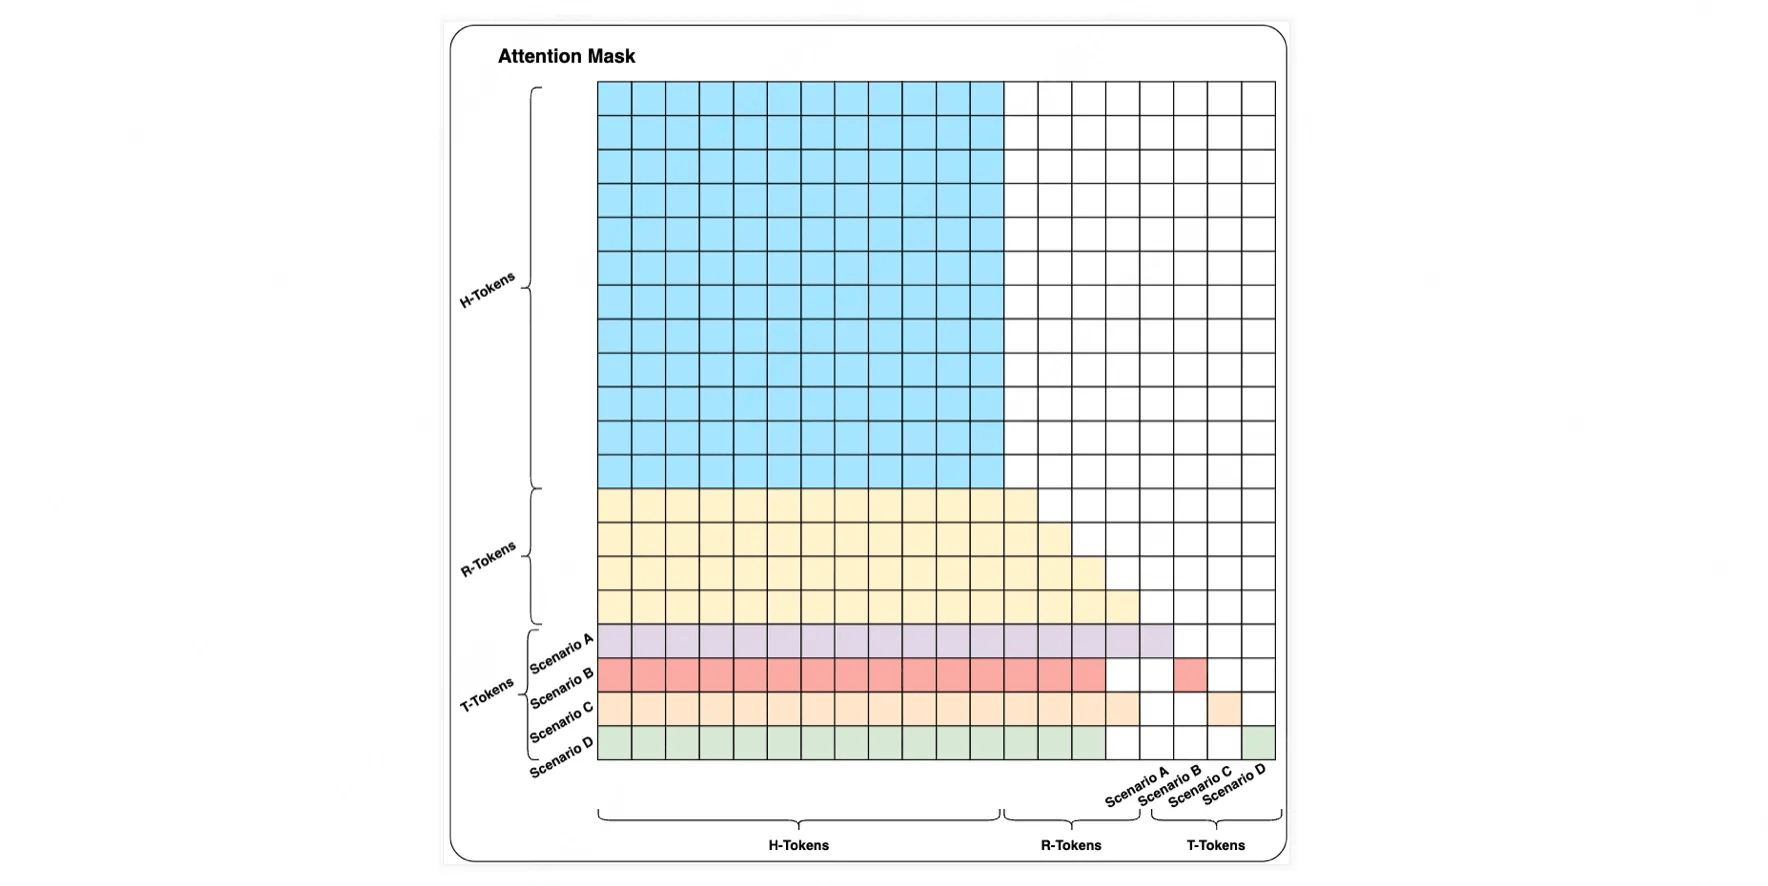
为防止跨场景和时间上的信息泄漏,MTFM 进一步扩展了 MTGR 的掩码策略。在下图的掩码矩阵中,每一行代表当前 Token 在注意力计算时能看到序列中的哪些 Token,每一列代表当前 Token 能被哪些 Token 看到。H-Token、R-Token、T-Token 三类 Token 的可见性如下:
H(History)-Token:可被所有 Token 看到,历史行为是全场景共享的用户上下文。
R(Realtime)-Token:按时间因果关系可见,实时序列内部使用标准因果掩码,且每个目标 Token 只能看到发生在该次曝光之前的实时行为。
T(Target)-Token:只能被自身看到,同一请求内的不同候选之间互不感知。
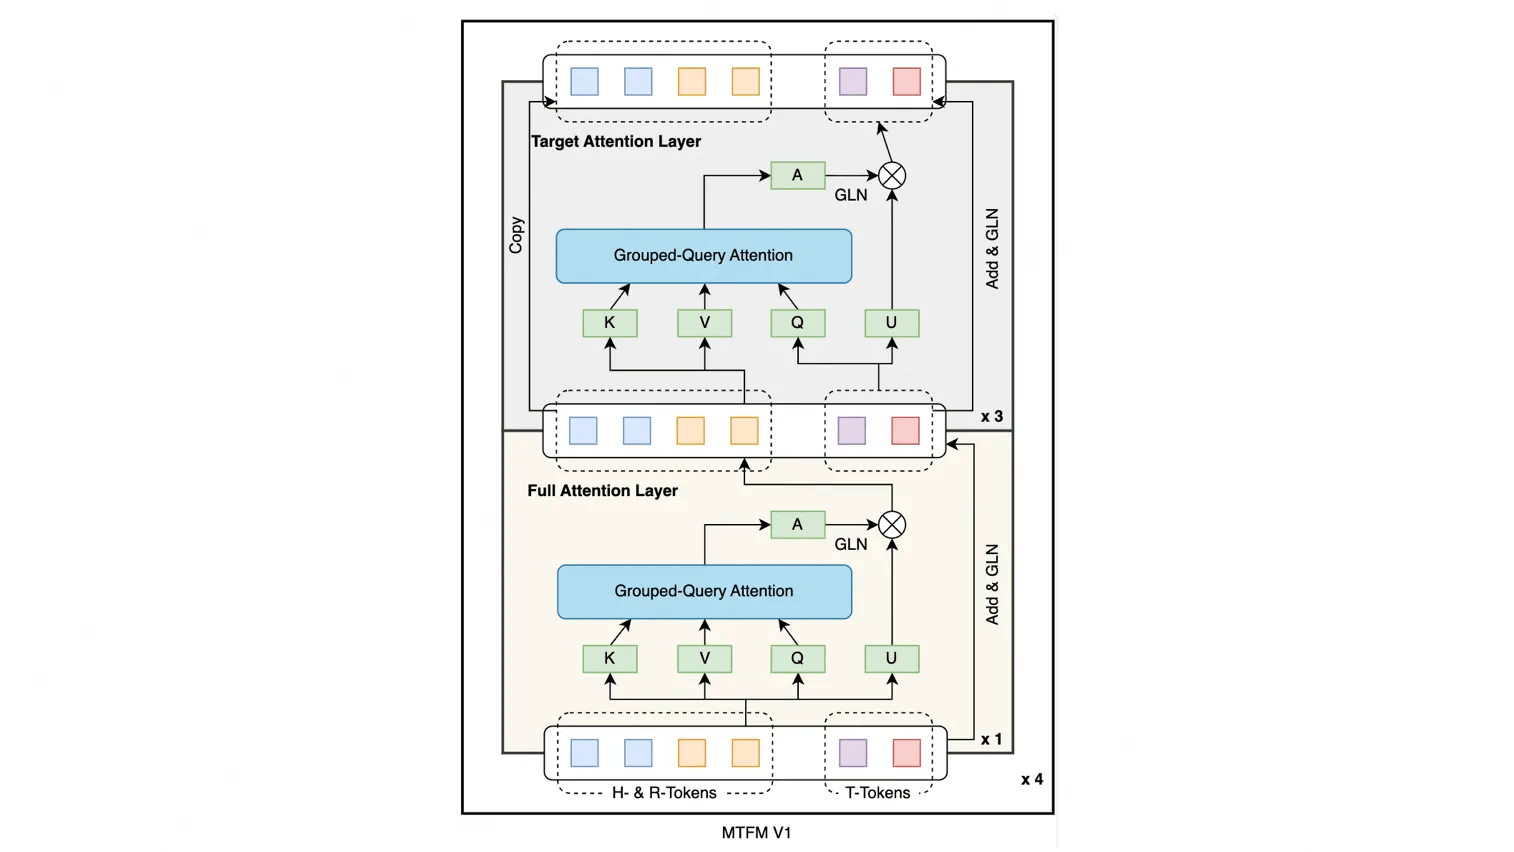
MTGR 采用多层全注意力(Full Attention)进行全序列建模,其计算复杂度随序列长度呈平方增长。统一模型包含多条长度达数千的序列,直接堆叠全注意力会导致训练与推理成本难以接受。另一方面,推荐任务的预估结果高度依赖目标侧特征,已有工作,如 STCA[13]、OneRec V2[14] 的 LazyDecoder,表明目标注意力能够以更低成本完成有效的信息提取。
基于此,MTFM V1 借鉴 LLM 中的混合注意力架构(Qwen3-Next[15]、MiMo-V2-Flash[16]),交错堆叠全注意力与目标注意力层,以降低长序列建模的复杂度。具体而言,全注意力层负责全序列信息聚合;在目标注意力层中,T-Token 仅以全序列 Token 为 Key/Value 执行注意力提取,不再参与全序列自注意力计算,从而显著降低计算量。在此基础上,进一步引入分组查询注意力(GQA,Grouped-Query Attention),降低注意力计算的开销。
最终模型采用 Target:Full=3:1 的混合结构,共 16 层,即 4 个模块,每个模块包含 1 层全注意力与 3 层目标注意力。消融实验表明,该配置在各任务的 GAUC 上均取得最优效果;同时,由于显存占用下降,批次大小可扩大 1.7 倍,样本吞吐量达到全注意力架构的 2.9 倍。
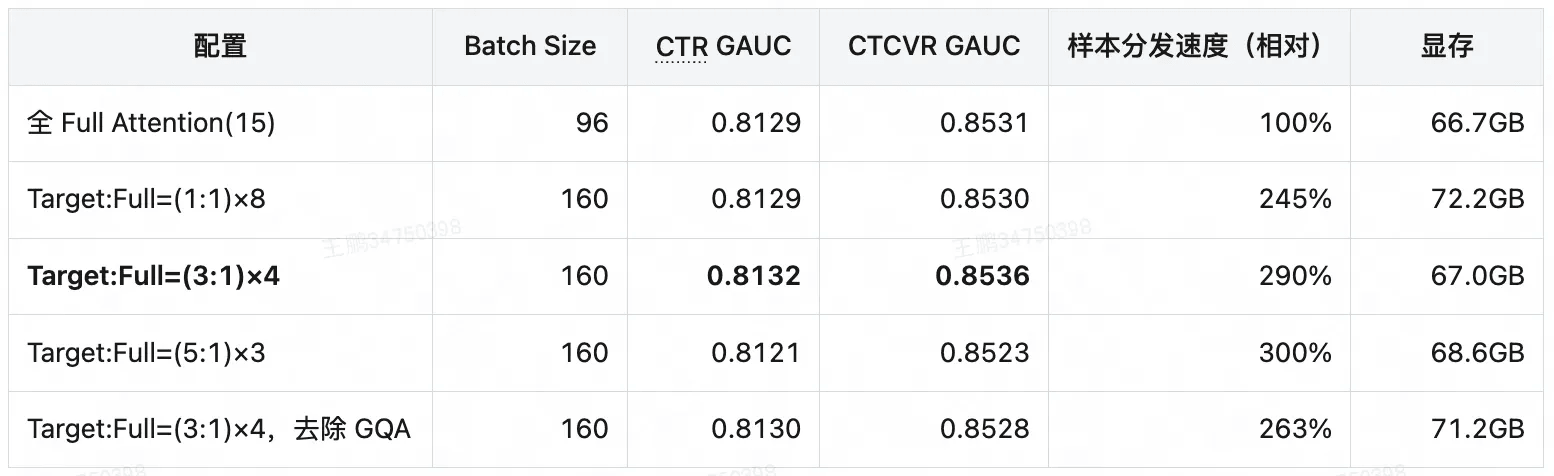
混合架构以更低成本取得了与全注意力架构相当的效果,说明将更多计算集中在目标侧是一个值得进一步扩展的方向。在 MTFM 多场景长序列中,单个目标 Token 包含的特征数量远多于单个用户 Token,但在 Token 化阶段,目标侧和用户侧都被视为同一维度的单个 Token。这会造成目标信息的过度压缩,在信息密度分配上并不合理。因此,在 MTFM V1 混合架构的基础上,MTFM V2(模型结构图见图 1)进一步对目标注意力层采用 Target Scale-Up 方式增大模型规模,实现进一步的规模扩展。
1、目标 Token 嵌入构造:采用 AutoSplit[17],每个目标的用户、上下文与物品特征经过一层线性映射,生成 4 个 Token 嵌入。
2、逐 Token 查询投影与 FFN:在目标注意力层,每个目标的 4 个 Token 分别经过不同的查询投影矩阵和 SwiGLU FFN。
3、自注意力与目标注意力参数分离:位于同一层的自注意力和目标注意力使用独立的 QKV 投影矩阵与 SwiGLU FFN 参数。
4、目标 Token 混合:拆分后的目标 Token 各自独立地与用户序列进行交叉注意力计算,并经过独立的 FFN。如果不进行交叉,4 个目标 Token 在均值池化前完全没有交互,会导致各 Token 在相同 KV 下趋向于学到冗余、相似的表征,即表征坍缩。因此,采用 RankMixer[18] 中的混合模块,以零参数、低计算量对目标 Token 进行交叉,促使各 Token 学习不同的表征。
为了实现多业务间的知识共享与差异建模,模型采用“共享基座 + 业务解耦”的多任务架构。具体而言,经过混合注意力聚合后的各业务 T-Token 表征,被送入 MMoE 层进行跨业务信息提取,再接入业务独立的任务塔,完成 CTR、CTCVR 等目标预估。其中,长序列兴趣建模能力主要沉淀在共享注意力骨干网络中,而不同业务的分布差异则由 MMoE 门控与任务塔参数承担。
在训练与部署层面,MTFM 采用“一图多业务”的设计范式。训练阶段,以用户为粒度聚合同一用户当日全场景曝光的目标,并共享序列侧注意力计算,使多个业务能够复用同一份用户兴趣表征,大幅降低长序列训练成本。线上部署阶段,各业务导出图保留共享序列基座与独享任务塔,使在线计算限定在当前业务相关组件上,减少无效 FLOPs 消耗,在统一建模的同时控制推理成本,实现“统一训练、多业务部署”。
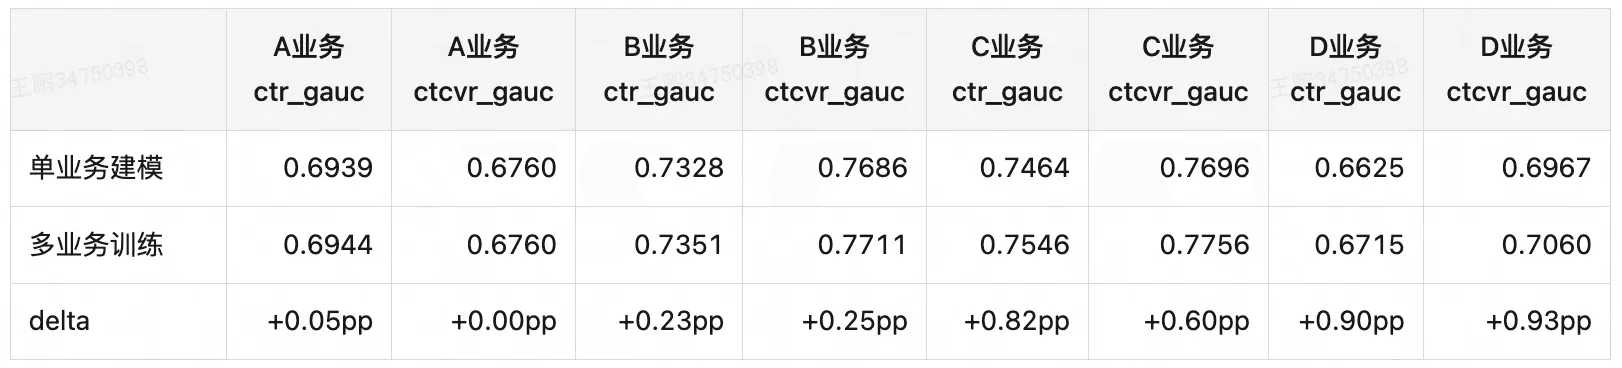
实验表明,跨场景的信息迁移可有效缓解数据稀疏问题。具体体现在:小流量业务显著提升 0.60~0.93 个百分点不等,中流量业务提升 0.25 个百分点,大流量业务基本持平、略有提升。
传统 DLRM 模型以曝光(PV)为粒度构建样本,多场景样本通过固定模板强制对齐,存在序列重复存储、重复计算的问题,资源利用率低。MTGR 将样本组织为单用户(UV)粒度,MTFM 进一步升级为外卖全业务的统一用户粒度样本,将同一用户在外卖多业务中的曝光聚合成 1 条样本,共享模型中最耗费算力的长序列注意力计算。
MTFM 训练时按用户级聚合样本,推理时按各业务的请求级聚合候选,进一步放大了训练阶段算力复用带来的经济收益。在特征组织上,由于各业务的供给类型、展现形态不同,特征 Schema 无法直接对齐。因此,各业务首先在内部按用户级聚合业务独立特征,再与共享用户序列以及其他业务的样本进行合并。在模型训练和推理时,多个目标共享长序列计算,实现算力资源的高效复用。
过去,各业务独立维护场景内的行为序列,存在数据链路和辅助信息(SideInfo)体系重复建设、跨场景行为信息缺失等问题,这在数据稀疏的小流量业务中尤为严重。为此,MTFM 将全场景行为统一为商家、商品长序列,聚合外卖多场景的点击、加购、完单行为,构建覆盖质量、价格、品类和情景化信息的通用辅助信息。受益于 4.1 节的用户级训练范式升级,整体资源消耗保持在可控范围内。各业务均使用全场景行为信号建模,提升了用户兴趣刻画的全面性,消融实验也显示外卖多个业务均取得显著提升。
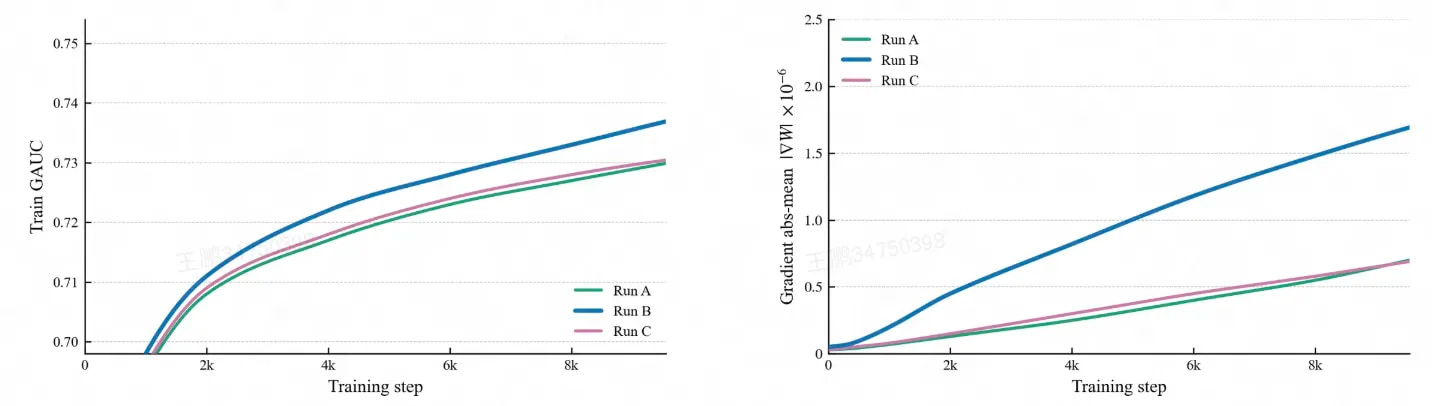
多业务联合训练叠加网络层数加深,使模型优化难度显著提升。项目初期发现,多组随机重复实验的离线指标波动超过 0.4 个百分点,严重影响迭代基准的置信度。通过监控中间层激活值、参数值、梯度值等指标,完善训练动态追踪,我们发现离线效果与部分层的梯度大小具有强相关性(图 4,Run A、B、C 为模型随机重复实验),据此判断存在局部梯度衰减、参数退化的问题。为此,我们从初始化、优化器两个方向系统性地解决问题。另外,针对多业务联合训练范式下样本稀疏引发的梯度噪声增大、无效梯度等问题,我们改进了损失函数,完善了优化器逻辑,并引入梯度累积。
深度感知的初始化策略:MTFM 的骨干网络是带残差连接的多层 HSTU,残差结构使网络输出的标准差随深度累积而不断增大,训练初期存在激活值过大、导致非线性激活层饱和的风险。借鉴 GPT-2 针对多层 Transformer 的初始化策略,在初始化 HSTU 每个模块的输出投影层时,按深度缩放标准差:
$$ W_{o_{proj}} \sim \mathcal{N}\left(0,\frac{0.02}{\sqrt{L}}\right) $$
其中,(L = 16) 为本次全量上线模型的 HSTU 总层数,其他线性层的标准差仍设为常数 0.02,使残差分支累积后的总方差保持在相对稳定的量级,改善深层模型训练初期的梯度稳定性。
优化器升级:将部分稠密参数的优化器由 AdamW 切换为 Muon。Muon 是一种主要面向二维矩阵参数、近年来在 LLM 领域得到广泛应用的优化器,使用 Newton-Schulz 迭代对更新梯度矩阵进行正交化,以改善更新方向和训练效率。实践中,我们借鉴了月之暗面的最新实践,增加权重衰减和更新 RMS 缩放,以提升训练稳定性。我们还探索了 Muon 的覆盖范围,发现仅将 Muon 用于 HSTU 的 UQKV 投影与输出投影,可以在速度与效果之间取得最佳平衡。
叠加这两个优化策略后,5~10 组随机实验的训练 AUC 波动幅度从 0.4 个百分点降至 0.1 个百分点,离线实验的稳定性和可复现性得到明显改善。
动态归一化:初期的联合损失采用各业务损失分别归一化后相加的形式:
$$ L = \sum_{s} \frac{1}{|B_s|} \sum_{i \in B_s} \mathrm{loss}_i $$
其中,(B_s) 为批次内某业务的样本集合。由于小流量业务的有效批次大小较小,基于其归一化损失得到的梯度存在较大噪声,既影响自身个性化参数,如 MMoE、任务塔的收敛,也通过共享参数间接影响其他业务。为此,将损失改为按批次内各业务的 PV 占比动态加权。该形式可化简为等价的全局归一化,即不区分业务,对批次内全部样本统一归一化。修改后的损失形式如下:
$$ L=\frac{\sum_{s}\sum_{0\leq i \leq |B_s|-1} loss_{s,i}}{\sum_{s'}|B_{s'}|} $$
稀疏更新改进:在多业务联合建模的范式下,稀疏样本带来了一个新问题:部分批次内不含小流量业务的目标,其 Tokenizer、MMoE 专家与任务塔在该步没有梯度,但这些参数仍在持续衰减。为此,在优化器的计算逻辑中,对零梯度参数跳过权重衰减,并将零梯度检测合并为单次批量同步,将非零参数更新批量向量化,以减少 kernel launch 次数、提升训练吞吐量。此外,为提升小流量业务的训练稳定性,引入步长为 2 的梯度累积,降低优化器的更新频率,提升训练速度。
MTFM 的单样本计算量较 DLRM 模型增长数百倍,系统性的性能优化是基座大模型成功落地的前提。为此,我们从训练、推理两部分入手,解决模型计算量和存储量激增带来的诸多性能挑战。
FA 镜像与掩码 Kernel 优化:HSTU 动态注意力在长度为 2k 的序列下,逐样本构造动态掩码因不连续访存与频繁的 kernel launch,耗时高达 22ms。MTFM 基于 Flash-Attention V2 进行重构:将多维掩码预处理为一维 jagged mask,存入共享内存,供轻量读取;将掩码构造从 for-loop 改写为 Triton Kernel,耗时降至 1ms;扩展 FA2 接口,支持全注意力、目标注意力、动态掩码读取与 SiLU 融合。相比 NVIDIA[19] 的实现,优化后前向计算加速 128%,反向计算加速 152%。
GLN Kernel 融合:MTFM 序列由终身行为、实时行为、候选目标等多种异构 Token 拼接构成,各类型使用独立的 LayerNorm 参数。传统实现按组循环执行,多次 kernel launch 和冗余的全局内存读写成为长序列训练中的瓶颈。
优化方案:前向计算基于 Triton 重构 Group LayerNorm(GLN)算子。将多组参数统一组织为 [G, D] 大矩阵,通过 seq_group_id_mask 为每个 Token 动态索引对应的组,在单次内核调用中完成全部 Token 的归一化;同时实现 GLN-ADD 与 GLN-MUL 融合算子,避免频繁回写中间结果。反向梯度计算改为分块归约:各处理单元独立累积局部梯度,再统一汇总,避免多个 Token 并发累加同一份共享参数时产生串行排队。在 2k 长序列下,GLN 的内存带宽利用率从 30% 提升至 60% 以上,整体相对原生实现提速超过 30%。
Muon 性能优化:针对原生 Muon 优化器中 Newton-Schulz(NS)正交化对每个二维参数串行执行、GPU 利用率低的问题,首先借鉴了 flash-muon[20] 的做法:利用 X@Xᵀ 的对称性,仅计算上三角部分,将浮点运算量减半。该做法在大矩阵场景下收益明显,但 MTFM 中的矩阵普遍偏小,额外的 Triton 内核启动开销反而拖慢了性能。因此,采用针对小矩阵的批处理策略:将同一优化步骤中形状相同的权重梯度堆叠为形状为 (B, M, N) 的批量张量,整组 NS 批量并行执行。批量化后,整个 NS 阶段的内核启动次数减少至数十次,该阶段加速 241%,端到端训练吞吐提升 19%。
消除阻塞点:随着特征规模和序列长度增长,训练瓶颈正从注意力计算转向主机与设备的协同效率。典型阻塞点包括 torch.unique、TorchRec wait() 同步、HashTable 优化器 step,以及业务代码中由 .item() 等操作引发的设备到主机(D2H)同步。
优化方案:核心思路是将“串行等待”转化为“并行重叠”。① 重构 TorchRec 数据分发和 HashTable 优化器链路,通过异步数据传输与计算重叠,削减通信、回传和更新过程中的空闲间隙,并结合去重与截断优化降低冗余计算;② 将原先按嵌入维度拆分的多个 HashtableCollection 融合为单个统一集合,对所有特征一次性查表,消除多个实例之间的调度与同步开销;③ 基于 AI 智能体基础设施,将 repeat_interleave 等存在 D2H 阻塞的原生算子改写为纯 GPU 实现,将频繁访问的 CPU 常量迁移为 GPU Tensor 并预先计算。最终,MTFM 训练流水线的整体训练速度提升约 15%。
特征精简:多业务统一后,特征规模达到 1.3K+。利用 Agent Auto Research 进行分析与分组搜索验证,删减近 500 个特征,且 GAUC 无损,释放显存以增大批次大小,训练吞吐提升 6%,线上特征处理耗时也同步降低。
查表合并:多个 Hashtable 查询存在重复加载同一张表的问题,导致显存碎片严重、多表查询串行化。将多个查询改为共享同一张表后,显存占用由 22GB 降至 5.9GB。
Attention Maskfunc 规则跳算:在 MTFM 的 HSTU 结构中,进入注意力计算的序列可抽象为用户(User)和物品(Item)两部分,两者的掩码逻辑不同,因此分别进行了针对性优化:用户侧使用自定义掩码,区别于 LLM 的因果掩码。在早期实现中,掩码通过逐元素乘法作用于注意力计算中 Q * K^T 的矩阵结果。多场景长序列中的掩码包含大量零值,计算效率极低。对此,优化方案是预扫描掩码,生成有效计算索引,在注意力计算过程中仅对存在有效键(Key)的块执行计算,跳过全零块,使长序列下的单算子延迟降低约 50%。物品侧的掩码逻辑为物品可见用户、用户不可见物品,即 User→Item 方向的注意力计算完全无效。利用这一可见性先验规则,直接跳过该方向的计算,在 2000 User + 200 Item 配置下,延迟降低 13%。
用户侧使用自定义掩码,区别于 LLM 的因果掩码。在早期实现中,掩码通过逐元素乘法作用于注意力计算中 Q * K^T 的矩阵结果。多场景长序列中的掩码包含大量零值,计算效率极低。对此,优化方案是预扫描掩码,生成有效计算索引,在注意力计算过程中仅对存在有效键(Key)的块执行计算,跳过全零块,使长序列下的单算子延迟降低约 50%。
物品侧的掩码逻辑为物品可见用户、用户不可见物品,即 User→Item 方向的注意力计算完全无效。利用这一可见性先验规则,直接跳过该方向的计算,在 2000 User + 200 Item 配置下,延迟降低 13%。
GLN 自定义算子:原生 GLN 按索引取数→归一化→写回,因索引不连续而产生大量乱序访问和显存拷贝。改为基于掩码的 GLN,直接通过掩码定位有效位置,避免重排开销;结合线程块和线程束级别的归约与向量化读取进行加速,吞吐提升 38%。
推理图精简:识别并融合冗余算子,合并连续的 Cast 转换,减少数值格式转换引发的额外内存搬运开销,降低访存压力,并重排计算顺序以提升数据局部性,吞吐提升 20%。
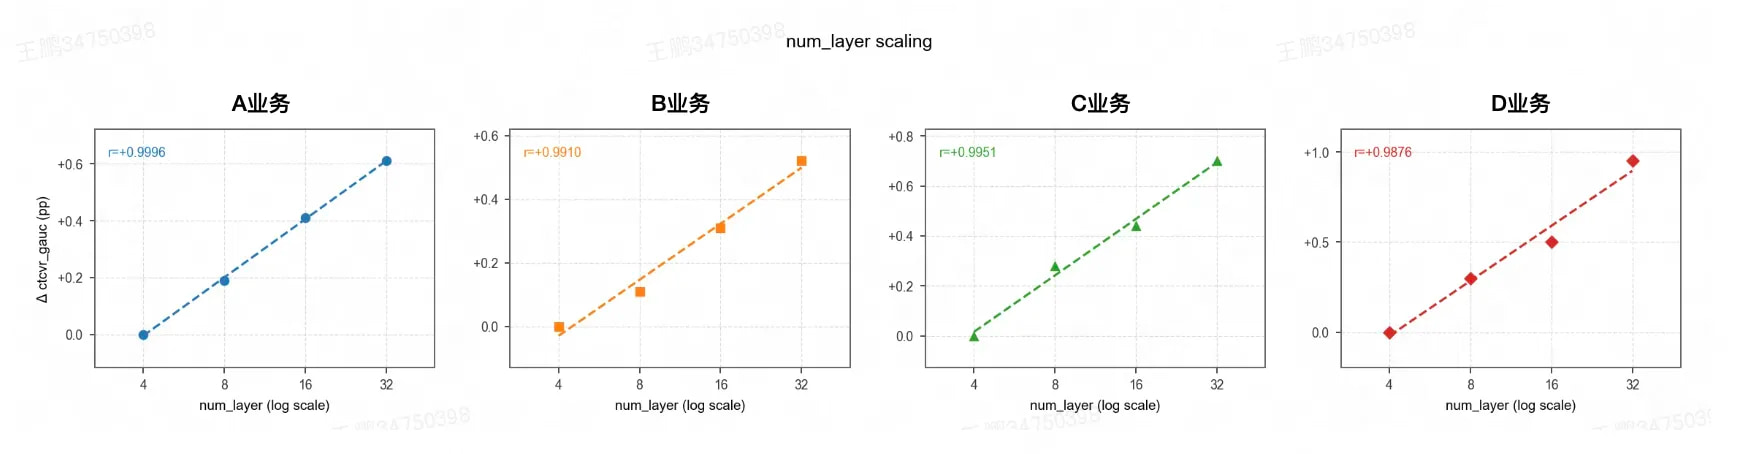
MTFM 在网络层数、Token 维度、序列长度三个维度上表现出了稳健的规模扩展能力(图5~7):
网络层数(图5):随着模型层数增加,各业务的离线效果稳步增长,离线指标与网络层数高度相关;
Token 维度(图6):随着 Token 维度增大,序列辅助信息(SideInfo)中的丰富语义得以充分表达,同时能够建模 Q、K 之间更丰富的交互关系,在 192~768 范围内观察到效果显著提升;
序列长度(图7):在 400~2000 范围内,序列长度的规模扩展效应明显。随着输入模型的序列长度增长,模型能够建模更长期的用户偏好,离线 GAUC 稳定提升。
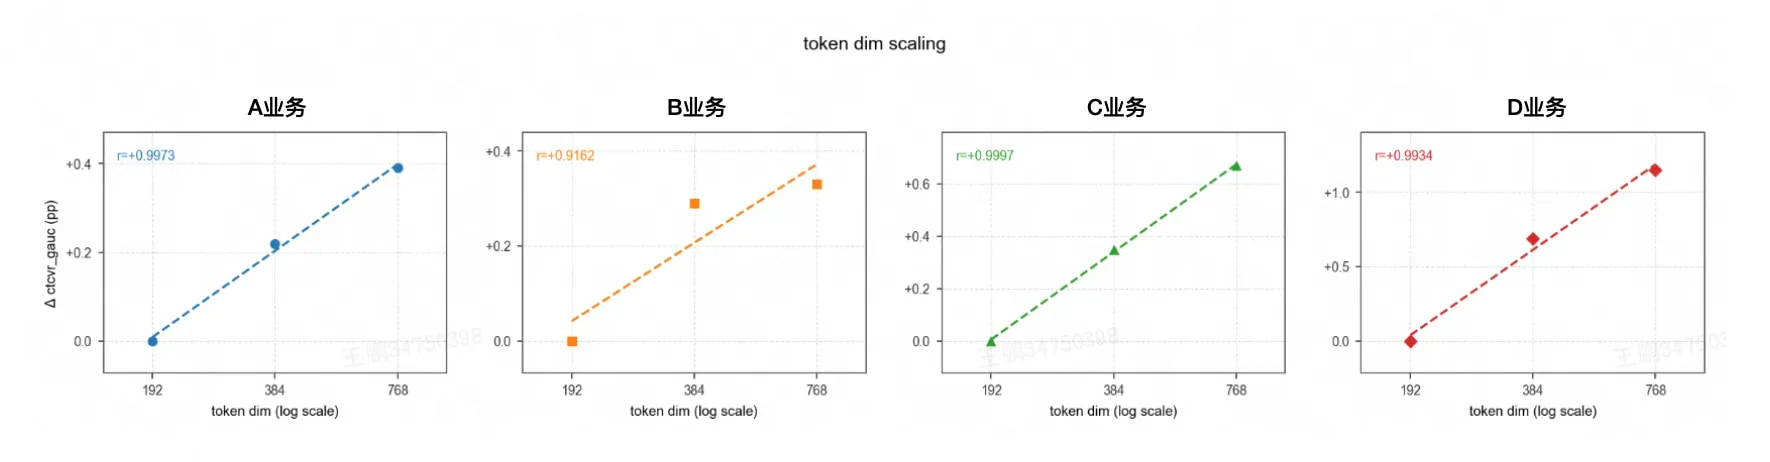
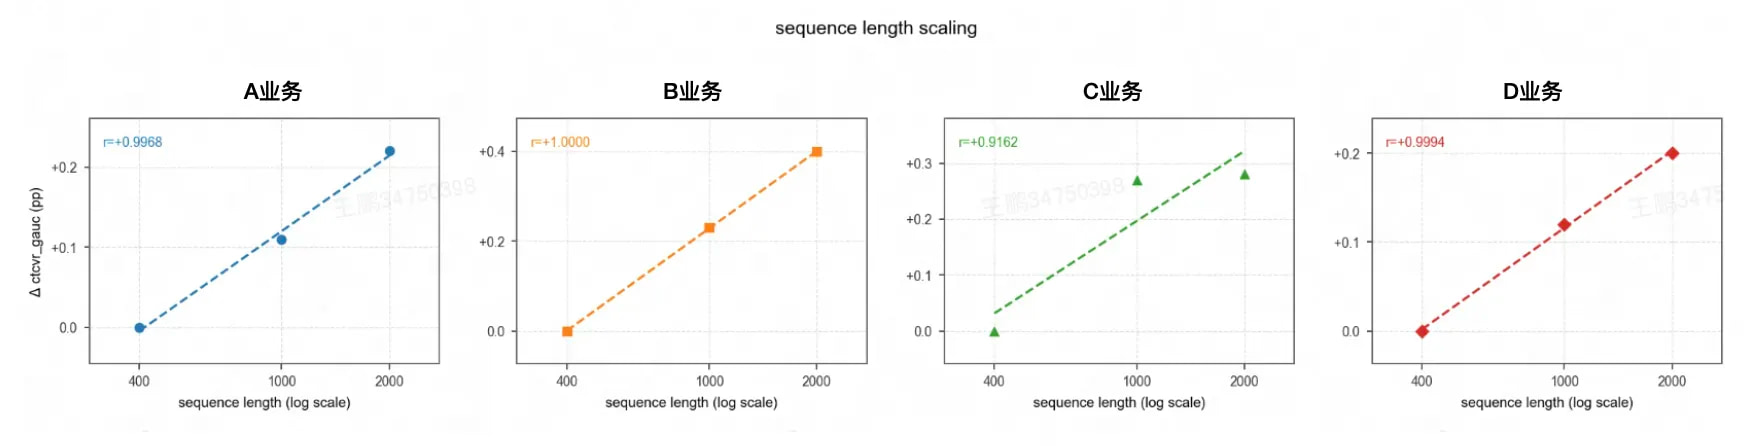
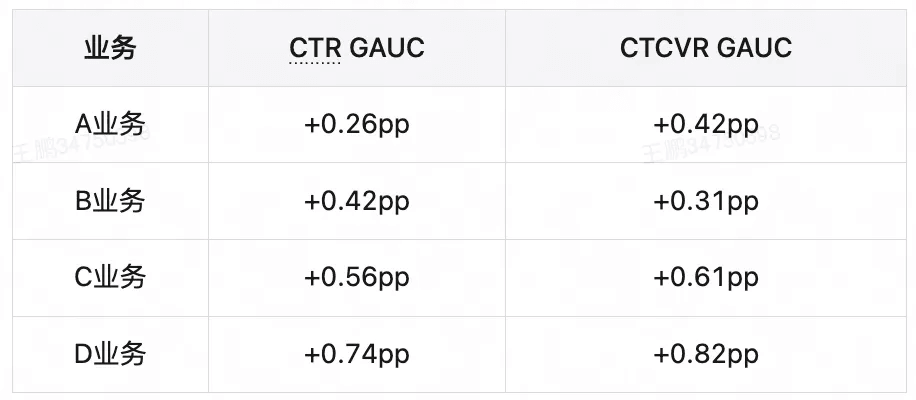
MTFM 统一模型的离线 GAUC 全面超越各场景基线,并且在 Target Token Scale-Up 上展现了更好的扩展效果。
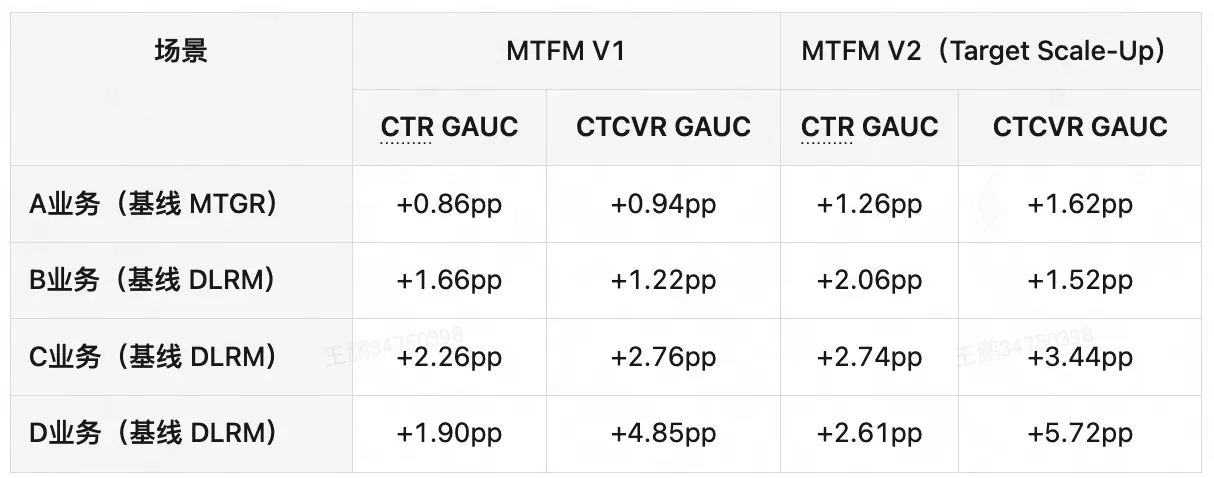
目前,MTFM V1 已在美团外卖多个业务中完成全量上线,核心订单指标提升显著。在线效果最显著的业务线订单增长超过 6%,这也是最近两年多个核心业务推荐场景中单次优化取得的最大收益。
MTFM 是一个真正实现多场景特征免对齐的推荐基座大模型架构,具备规模可扩展性(Scalability)、场景可延展性(Extensibility)和架构高效性(Efficiency)这三个关键特质。具体而言,以类 Transformer 骨干网络为基础,通过 Target Token Scale-Up 提升模型能力,借鉴 LLM 优化实践提升训练效果;设计异构分词器(Tokenizer)和动态掩码机制,支持多场景端到端统一建模;通过混合注意力、多场景用户级训练、高效 GPU 定制算子等提升训练与推理效率。首次实现外卖多场景统一精排模型,取得显著的离线 GAUC 与在线 A/B 效果提升,展现了良好的规模效应与算力经济性。未来,我们将与各团队紧密合作,充分吸纳 LLM 与推荐领域的业界最新进展,不断提升模型能力和基础设施能力,继续拓展基座模型在推荐场景中的能力边界。主要方向如下:
规模扩展与基础设施协同:通过算法与工程协同设计,实现更高效的基础设施,设计规模扩展投入产出比高的模型结构,平衡计算量与参数量,实现模型参数量提升 1~2 个数量级,进一步验证模型参数、序列长度的规模扩展定律(Scaling Law)。
基座模型场景延伸:将 MTFM 推广到更多业务场景,通过联合训练、蒸馏等方式实现 MTFM-Lite,以更低成本为各场景带来基座模型红利。
算法团队来自搜索和推荐平台部/推荐算法部,负责美团各场景的商家、商品自然流量分发,以及大模型相关创新能力建设,包括推荐算法、大模型应用算法等。业务核心,技术能力强,每年有多篇论文发表在 KDD、SIGIR、CIKM 等会议。当前,LLM 在推荐领域的落地仍在深度迭代中,机会广阔、潜力巨大,欢迎各路英才加入,联系方式:liuying153@meituan.com。此外,欢迎校招同学投递推荐大模型算法北斗岗位:【北斗】推荐大模型算法工程师。
搜索和推荐平台部/机器学习架构组,负责美团各业务搜索推荐机器学习引擎的工程架构工作,包括模型训练、模型推理、用户特征平台建设等。团队技术能力强,工作氛围好,当前正在深入探索下一代搜推架构等多个前沿方向,欢迎感兴趣的同学加入,联系方式:dengyuanyuan02@meituan.com。也欢迎校招同学投递大模型训练与推理引擎北斗岗位:【北斗】大模型训推引擎工程师(后训练/推理方向)。
[1] MTGR:Han R, Yin B, Chen S, 等。MTGR:美团工业级生成式推荐框架[C]//第 34 届 ACM 国际信息与知识管理会议论文集。2025:5731–5738。
[2] KDD 2026:MTFM:美团工业推荐中可扩展、免对齐的基座模型(https://dl.acm.org/doi/abs/10.1145/3770855.3818452)
[3] STAR:Xiang-Rong Sheng, Liqin Zhao, Guorui Zhou, Xinyao Ding, Binding Dai, Qiang Luo, Siran Yang, Jingshan Lv, Chi Zhang, Hongbo Deng, 等。2021。一个模型服务所有场景:用于多领域点击率预测的星型拓扑自适应推荐模型。载于第 30 届 ACM 国际信息与知识管理会议论文集。4104–4113。
[4] M3OE:Zijian Zhang, Shuchang Liu, Jiaao Yu, Qingpeng Cai, Xiangyu Zhao, Chunxu Zhang, Ziru Liu, Qidong Liu, Hongwei Zhao, Lantao Hu, 等。2024。M3OE:多领域、多任务混合专家推荐框架。载于第 47 届国际 ACM SIGIR 信息检索研究与开发会议论文集。893–902。
[5] MLoRA:Zhiming Yang, Haining Gao, Dehong Gao, Luwei Yang, Libin Yang, Xiaoyan Cai, Wei Ning 和 Guannan Zhang。2024。MLoRA:用于点击率预测的多领域低秩自适应网络。载于第 18 届 ACM 推荐系统会议论文集。287–297。
[6] ExFM:Ads Recommendation。2025。外部大型基座模型:如何高效地为在线广告推荐提供万亿参数规模的服务。arXiv 预印本 arXiv:2502.17494(2025)。
[7] LFM4Ads:Shangyu Zhang, Shijie Quan, Zhongren Wang, Junwei Pan, Tianqu Zhuang, Bo Fu, Yilong Sun, Jieying Lin, Jushuo Chen, Xiaotian Li, 等。2025。用于广告推荐的大型基座模型。arXiv 预印本 arXiv:2508.14948(2025)。
[8] RankMixer:Zhu J, Fan Z, Zhu X, 等。RankMixer:扩展工业推荐系统中的排序模型规模[C]//第 34 届 ACM 国际信息与知识管理会议论文集。2025:6309–6316。
[9] TokenMixer-Large:Jiang Y, Zhu J, Han X, 等。TokenMixer-Large:扩展工业推荐系统中大型排序模型的规模[C]//第 32 届 ACM SIGKDD 知识发现与数据挖掘会议论文集,第 2 卷。2026:7489–7500。
[10] HSTU:Zhai J, Liao L, Liu X, 等。行动胜于言语:用于生成式推荐的万亿参数序列转换器[J]。arXiv 预印本 arXiv:2402.17152,2024。
[11] OneTrans:https://arxiv.org/abs/2510.26104
[12] OneRec:Zhou G, Deng J, Zhang J, 等。OneRec 技术报告[J]。arXiv 预印本 arXiv:2506.13695,2025。
[13] STCA:Guan, Lin, 等。“加长序列,保持高效:抖音十亿规模下的端到端 10k 序列建模。”2026 年 ACM Web 会议论文集。2026。
[14] OneRec V2:Zhou, Guorui, 等。“OneRec V2 技术报告,2025。”https://arxiv.org/abs/2508.20900(2025)。
[15] Qwen3-Next:Team Qwen。“Qwen3-Next:迈向极致的训练与推理效率。”https://qwen.ai/blog?id=qwen3-next(2025)。
[16] MiMo-V2-Flash:Xiao, Bangjun, 等。“MiMo-V2-Flash 技术报告。”arXiv:2601.02780(2026)。
[17] AutoSplit:参考 OneTrans https://arxiv.org/abs/2510.26104
[18] RankMixer:https://arxiv.org/abs/2507.15551
[19] NVIDIA 开源自定义掩码:https://github.com/NVIDIA/recsys-examples/blob/main/corelib/hstu/README.md
[20] Flash-Muon:https://github.com/nil0x9/flash-muon/blob/main/README.md