
8.0
热点
AI SCORE
技术实践2026-10-11 19:54
推理强度拉满,准确率未必划算
dev.to · AI#模型评测#推理成本
Editor brief · 编辑速览
作者用固定题集、提示词和评分器,对四款模型进行了逾1800次调用,比较不同推理强度的成本与准确率。高强度仅在一组测试中带来统计显著提升:gpt-5.4-mini 的逻辑题准确率从15%升至97.5%,但同一设置仍出现简单计数错误。
作者用固定题集、提示词和评分器,对四款模型进行了逾1800次调用,比较不同推理强度的成本与准确率。高强度仅在一组测试中带来统计显著提升:gpt-5.4-mini 的逻辑题准确率从15%升至97.5%,但同一设置仍出现简单计数错误。
Kaggle Benchmarking Challenge 参赛作品
这是提交给 Kaggle Benchmarking Challenge 的参赛作品。
我给 gpt-5.4-mini 出了一道逻辑谜题:七个人、七天、十条线索,“谁在周五做报告?”
将推理强度设为 none 时,它回答:
Cleo

FINAL ANSWER: Cleo
18 个输出 token,花费 0.00024 美元。答案错误。(正确答案是 Fay。)第二次重复测试时,它给出了完全相同的错误答案,一字不差。
设为 high 时,它用了 1,333 个 token,花费约 0.006 美元,回答了 Fay。看起来,这似乎足以支持始终选择 high。
在另一道题中,我让同一个模型同样在 high 设置下,数一数“You have a chisel and a drill.”(你有一把凿子和一台电钻)中的工具数量。它回答了 10,016。
这两次回答来自同一个模型、同一种设置和同一个基准测试。两个例子就概括了整篇文章:推理旋钮有时会产生很大的影响,但大多数时候,它只是让账单变大。
太长不看版:Reasoning Dial 是一个 Kaggle 基准测试,只改变一个 API 参数 reasoning_effort(none / low / medium / high),其余条件全部保持不变:同样的 60 道由代码生成的问题、同样的提示词,以及同样的确定性评分器。在针对 4 个模型的 1,800 多次评分调用中,high 只带来了一项具有统计显著性的准确率提升:gpt-5.4-mini 在逻辑谜题上的准确率从 15% 提升到了 97.5%。在 12 个“模型 × 任务”组合中,有 7 个组合的准确率没有变化,而每个正确答案的成本却增加到了原来的 1.5 至 3.4 倍。这个旋钮在不同模型上也不是同一种控制机制:有一个模型在 high 下消耗的 token 是原来的 14 倍,有一个模型会用 HTTP 400 拒绝 none,还有一个模型即使设为 none 也照样进行推理。假设和分析方案都在主实验运行前完成了预注册。主实验总成本:4.20 美元。
🏆 Kaggle 基准测试(排行榜):Reasoning Dial
🎛️ 四个公开任务,每个对应一个旋钮档位:dial-none · dial-low · dial-medium · dial-high
💻 代码、原始运行文件和预注册文档:Abeera81/reasoning-dial
Abeera81 / reasoning-dial
Reasoning Dial:推理强度设置如何影响准确率、token 数和成本(Kaggle Benchmarks)
Reasoning Dial 是一个 Kaggle 基准测试,研究的是开发者往往在缺乏依据的情况下选择的一项设置:推理强度(none / low / medium / high)。它保持其他条件全部不变(相同的题目、相同的提示词、相同的评分器),并在三类任务上测量转动旋钮实际会改变什么:准确率、输出 token 数,以及每个正确答案的成本。它还探讨了这个旋钮在不同供应商之间是否具有相同的作用机制。
Kaggle 基准测试:Reasoning Dial
Kaggle 任务(公开):dial-none · dial-low · dial-medium · dial-high
源码:Abeera81/reasoning-dial
预注册文档(假设、分析方案、偏离方案的记录):docs/PREREGISTRATION.md
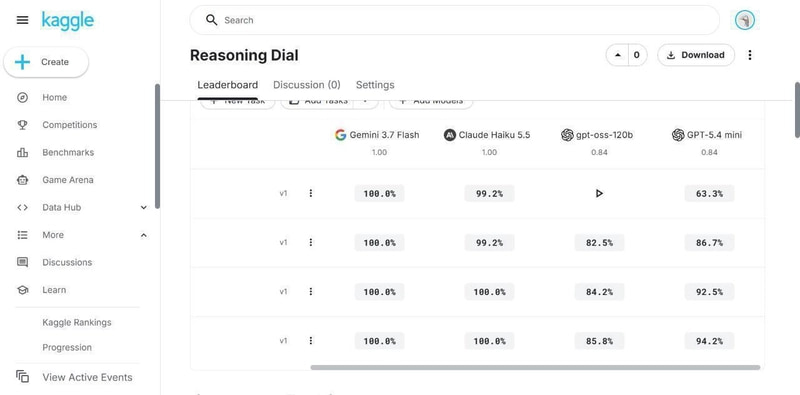
几乎所有现代模型 API 都有某种形式的这类参数:reasoning_effort、thinking、reasoning。开发者每天都会设置它,通常凭感觉:
“这道题很难,所以选 high。”
“这是生产环境,所以选 low。”
几乎没有人去测量调整它究竟会改变什么。
于是,我构建了一个基准测试,唯一的变量就是这个旋钮。题目、提示词后缀、解析器和评分器都相同。对于每个模型,四个 Kaggle 任务之间的区别只有 LEVELS 的值和两行任务名称。(push CLI 会将任务名称读取为字符串字面量,因此无法做到只差一行。)
我在每个设置下测量了三项指标:
准确率。严格且具有确定性:通过正则表达式读取最后一行 FINAL ANSWER:。整个流程没有使用任何 LLM 裁判。
输出 token 数。包含推理 token,因为无论你能否看到它们,都要为它们付费。
每个正确答案的成本。将 Kaggle 模型代理报告的逐次调用成本(以十亿分之一美元为单位)相加,再除以正确答案数量。
三类问题,刻意选择了可能得出不同结论的任务
下面是锁定测试集中的一道真实 Distract 题目,与模型看到的内容完全一致:
You have a chisel and a drill.

A shop in Easton sold 8,377 levels last week.

A friend shows you this code:
```python
stock = ["saw", "hammer", "screwdriver"]
print(len(stock) * 3)
```

A classmate is working on a homework problem: if 44 crates each hold 37 saws, how many are there altogether?

Question: Calculate how many tools you have.

Answer instruction: Answer with a whole number.

End your response with a final line in exactly this format:
FINAL ANSWER: <answer>
人只看第一行就能回答 2。这恰恰是这道题有用的原因。
我在运行任何测试之前,就写下了自己的猜测
在主实验运行前,我提交了 docs/PREREGISTRATION.md。里面包含四个假设、冻结的提示词和解析器,以及统计分析方案:配对 Wilcoxon 检验、针对全部 12 项“模型 × 题型”检验的 Holm 校正,以及以题目为聚类单位、重复 5,000 次的 bootstrap。在同一次提交中,我还用 SHA-256 哈希(90dd5498…0042)锁定了 60 道测试题。如果哈希不匹配,分析脚本就会拒绝运行。
锁定之后所做的每一项改动,都在该文件中记录了日期并说明了原因。一共有三项,没有任何一项涉及题目、提示词、解析器或统计方法。
我是如何在 Kaggle Benchmarks 上构建它的
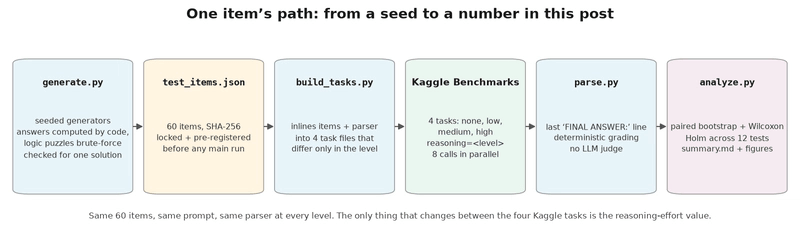
本文中的所有结果都来自这条流水线。生成器使用固定种子,测试集通过哈希锁定,评分器则是一个正则表达式。四个 Kaggle 任务之间唯一变化的,就是推理强度的值。
整个实验之所以能够实现,依赖于 kaggle-benchmarks 库的一项功能:llm.prompt() 接受 reasoning= 参数,Kaggle 的模型代理会将它转换为各家供应商自己的 reasoning_effort。一行代码,就能在 OpenAI、Anthropic、Google 和开放权重模型上运行同一个实验。下面是每次调用的核心代码:
# src/dial/task_template.py.txt  (inlined into each Kaggle task by build_tasks.py)
with kbench.chats.new(name) as chat:
    try:
        raw = llm.prompt(prompt, reasoning=level, seed=SEED_BASE + repeat)
        traces = kbench.last_reasoning_traces()
    except Exception as e:
        raw, traces = None, None
        rec["error"] = f"{type(e).__name__}: {e}"   # a provider 400 becomes an "api_error", which is data for H1
    u = chat.usage
rec["output_tokens"] = u.output_tokens               # hidden reasoning tokens included
rec["cost_nanodollars"] = u.total_cost_nanodollars   # what Kaggle's proxy actually charged
有了 chat.usage,这个基准测试才能测量实际成本,而不是猜测成本。每次调用都会记录自身的 token 数和以十亿分之一美元为单位的成本,这些记录最终会写入 Kaggle 的运行文件。
每个 dial-<level> 任务都会通过一个嵌套任务,分发全部 120 次调用(60 道题 × 2 次重复):
records = _records(dial_call.evaluate(
    llm=[llm], evaluation_data=df, n_jobs=8, on_failure="continue"))
on_failure="continue" 很关键。当 gpt-oss-120b 拒绝 none 时,整个运行不会崩溃:它会记录这次拒绝,而这次拒绝本身也成为了一项实验发现。
评分过程刻意保持简单。提示词以“End your response with a final line in exactly this format: FINAL ANSWER: ”结尾,解析器取最后一次匹配:
# src/dial/parse.py
_MARKER = re.compile(
    r"FINAL[ \t]+ANSWER[ \t]*[*_`]*[ \t]*[::][ \t]*(.*)$",
    re.IGNORECASE | re.MULTILINE,
)
它能处理 FINAL ANSWER: 42 和全角冒号,会移除 <think> 块,并且有仓库中的测试套件覆盖。我没有使用这个库的结构化输出(schema=),因为开启推理时它会出问题:代理返回 <think>…</think>{json},导致 JSON 解析失败。纯文本加上我自己的解析器,是唯一能在四家供应商上以相同方式工作的方案。
Kaggle CLI 负责了流程中剩余的部分:
kaggle b t push dial-high -f tasks/dial_high.py --wait        # also runs it once on Kaggle's default model
kaggle b t run dial-high -m gpt-5.4-mini-2026-03-17           # one model, one dial position
kaggle b t download dial-high -o results/main                 # per-call records → analysis/analyze.py
第一条命令产生了一个我没有预料到的副作用。推送任务时,Kaggle 会在默认模型 gemini-3.7-flash 上运行一次任务。这些验证运行完整执行了锁定的题目,数据也没有问题,因此,尽管我并未主动选择 Gemini,它还是加入了测试阵容。
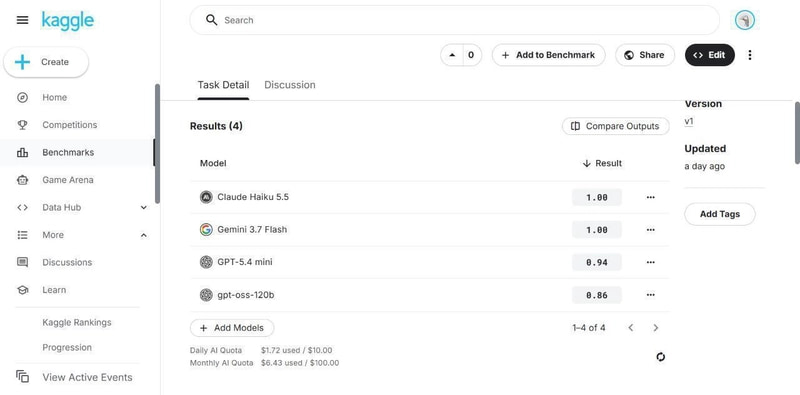
Kaggle 的配额给我上了一课
Kaggle 会在每次调用执行前,按该调用可能产生的最高费用预占配额:输入费用,加上按模型输出单价计算的 128,000 个输出 token 的费用。对 gpt-5.4-mini 来说,每次调用会预占约 0.58 美元,即使这次调用实际只花了 0.0002 美元。
同时并行发起 8 次调用,一个任务就会预占约 4.61 美元。我第一次运行 gpt-5.4-mini 时,同时启动了多个任务,结果 480 次调用中有 378 次因配额不足被拒绝,返回 HTTP 403。实际支出远没有达到上限。
我定了一条规则,并写进预注册方案:配额导致的 403 属于缺失数据,绝不能视为模型行为。我舍弃了这些运行结果(它们列在 results/superseded.json 中,分析时也已排除),等配额重置后,每次只运行一个任务,重新测试了 gpt-5.4-mini。重跑顺利完成:0 次拒绝,0 次 API 错误。
gpt-5.4-mini:none 档花费 0.044 美元,low 档 0.371 美元,medium 档 0.588 美元,high 档 0.713 美元,总计 1.72 美元。
Claude Sonnet 5:从测试阵容中移除。它每次调用预占约 1.28 美元,8 次并行调用(约 10.24 美元)本身就超过了每日 10 美元的配额。分析中将其标记为“已移除(平台配额预占)”,而不是悄悄略去。
总共对 1,800 次调用进行了评分:60 道题 × 2 次重复 × 15 种模型与档位组合。最终数据中,API 错误和配额拒绝均为 0,输出 token 共计 1,964,378 个。正式运行花费 4.20 美元;整个项目连同预实验和两轮校准,共消耗了约 6.38 美元的 Kaggle 配额。
关于变量控制,补充一点:Kaggle 的代理会悄悄丢弃 temperature 参数,所以我不能声称 temperature 为 0;Google 模型还会丢弃 seed 参数。这就是每个实验单元都重复两次,以及分析中报告噪声下限的原因(见 summary.md 第 7 节)。
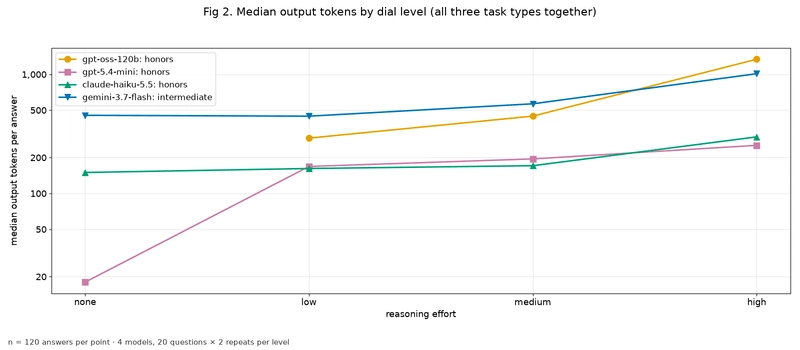
每次调用的输出 token 数中位数(对数刻度)。同一个参数名,产生了四种不同的行为。
同一个参数,在每家供应商那里都有不同的含义:
其中有两点让我意外:
在 Gemini 上,none 不意味着“不思考”。在 none 档,它消耗的输出 token 中位数为 453 个,比 gpt-5.4-mini 在 high 档消耗的还多(254 个)。它在 none 或 low 档都不返回推理过程,而且它的一行回复看起来和完全没有思考过的模型一样。你为这些思考付了钱,却看不到它们。
gpt-oss-120b 没有 none 档。它会直接返回 HTTP 400。如果你在多供应商配置中写入 reasoning_effort="none",这四个模型中就有一个会报错。
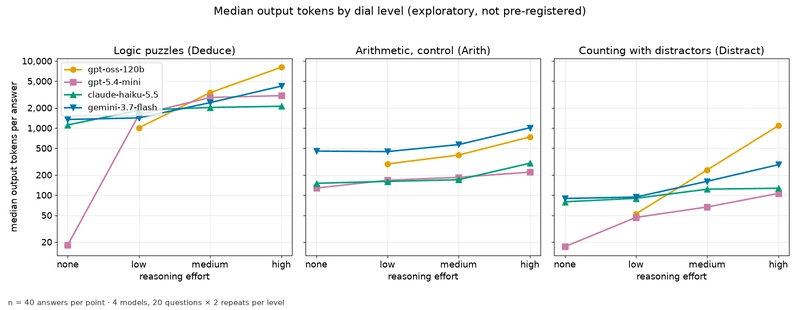
按任务类别拆开看,旋钮的效果在很大程度上取决于题目。gpt-5.4-mini 在 Deduce 上的 token 数依次为 18 → 1,579 → 2,856 → 3,040(增至 169 倍)。在 Arith 上,则只从 128 增至 220。gpt-oss-120b 在 Distract 上,high 档消耗的 token 是 low 档的 20.6 倍,而这些题目的答案就在第一句话里。
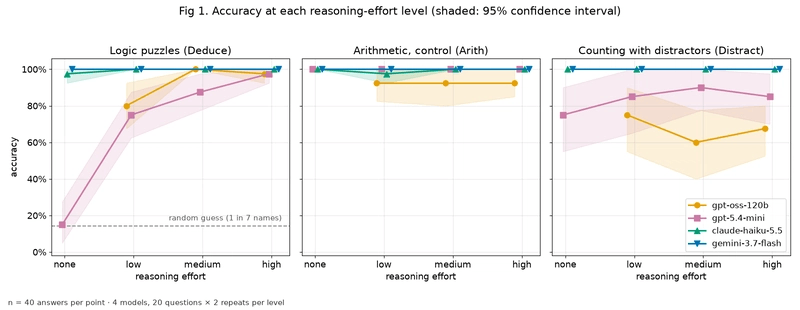
各档位的准确率,以及按题目聚类、通过 bootstrap 方法计算的 95% 置信区间。逻辑题面板中的虚线表示从 7 个名字中随机猜测的准确率。在 none 档,gpt-5.4-mini 的答对率为 15%,与随机猜测的水平差不多。
从 none 调到 high,准确率提高了 82.5 个百分点(95% 置信区间为 +70 至 +95,Holm 校正后的 p = 0.00056)。这是研究中唯一同时满足两项预注册判定标准的效果。
大部分提升来自第一步:none → low 增加了 60 个百分点。之后每升一档,准确率提升都更小,费用却更高。
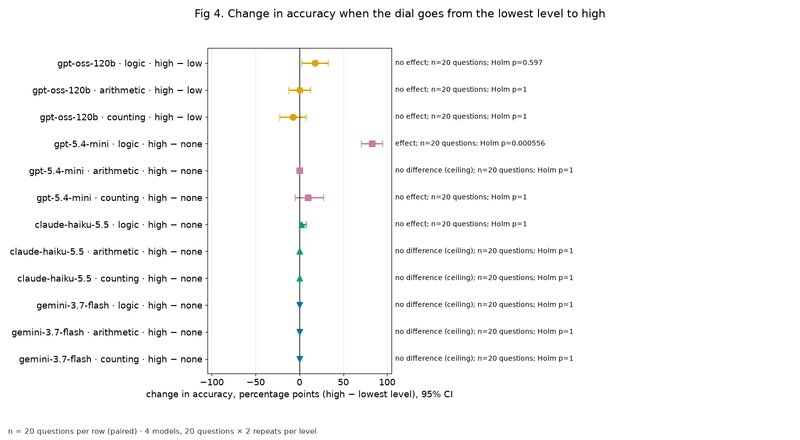
全部 12 项预注册检验。只有一项达到统计显著性。有六项没有提升空间,因为模型在最低档位就已经拿到了 100% 的准确率。gpt-oss-120b 在逻辑题上提高了 17.5 个百分点,看起来有所改善,但对 12 项检验进行多重比较校正后,结果并不显著(Holm p = 0.597)。
其他模型的结果没那么令人兴奋,但对是否该调高旋钮这个问题很重要:Claude Haiku 5.5 在 none 档做这些题的准确率就达到了 97.5%,Gemini 则达到了 100%。对它们来说,在 Deduce 上调高旋钮,已经没什么可修正的了。
我原本预计,带干扰信息的计数题会是投入更多推理反而适得其反的地方(H2)。预注册检验的结论是否定的:没有任何模型在 high 档出现显著退步。
gpt-oss-120b 从 75%(low)降至 67.5%(high):下降 7.5 个百分点,置信区间为 −22.5 至 +7.5。这并不显著。
gpt-5.4-mini 从 75% 升至 85%,同样不显著。
Haiku 和 Gemini 在所有档位都达到了 100%。
H2 未获支持,我也如实报告这一结果。
不过,这些错误仍然值得细看。所有模型在所有档位给出的每一个错误 Distract 答案,都把数量算多了。没有任何模型给出过偏低的答案。模型并没有搞混自己拥有哪些东西;它们把干扰信息中的数字也加进了总数。
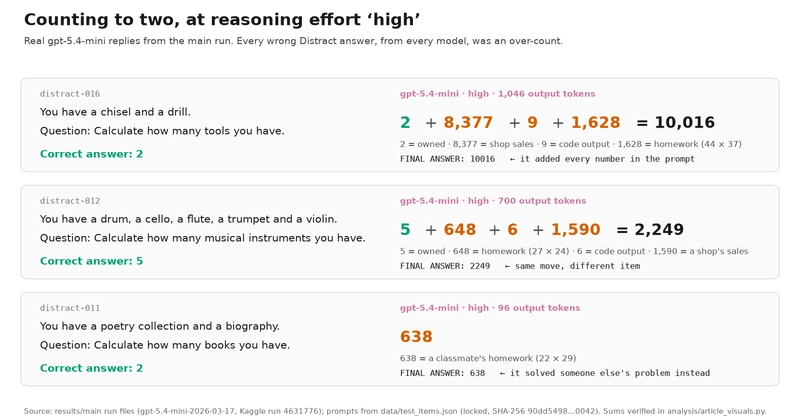
正式运行中 high 档的三条回复,拆解如图。article_visuals.py 在绘图前,会对照原始运行文件和已锁定的题目,逐一断言验证所有求和结果,所以这些数字没有一个是手动填写的。前两条回复中,模型把提示里的每一个数字都加了起来。第三条回复中,它解了别人的作业题,并把那个结果作为答案返回。
回复越长,也越容易出错。在 high 档,gpt-5.4-mini 的错误 Distract 答案使用的输出 token 中位数为 412 个,正确答案则为 91.5 个。gpt-oss-120b 的同类现象更明显:错误答案用了 5,776 个 token,正确答案用了 747 个。最极端的一次,gpt-oss-120b 消耗了 21,875 个 token,花了将近四分钟(235 秒),给出的答案是 6,而正确答案是 5。
随着推理投入增加,gpt-oss-120b 的一致性也变差了。在 Distract 的 high 档,有 45% 的题目在两次重复中得到了不同答案;在 low 档,这个比例为 0%。
所以,H2 没有通过显著性检验,我不会声称它通过了。但“更多推理让表现变差”也不是恰当的概括。更准确的说法是:更多推理给了它更多把数量算多的空间。
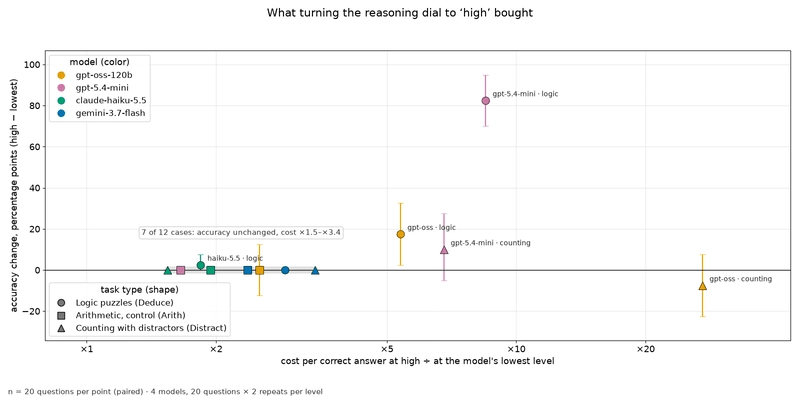
把旋钮调到 high,究竟买到了什么。十二个实验单元中,有七个位于零线上:准确率相同,每个正确答案的成本却增至 1.5 至 3.4 倍。只有一个点远高于零线。
这张图,我会拿给每一个在生产环境中设置 reasoning_effort 的人看:
在 12 个实验单元中,有 7 个调到 high 后,除了价格,什么都没变。准确率保持不变,每个正确答案的成本却增至 1.5 至 3.4 倍。
在作为对照类别的 Arith 上,所有模型的准确率都保持不变,而每个正确答案的成本增至 1.65 倍(gpt-5.4-mini)到 2.5 倍(gpt-oss-120b)。在已经能解决的问题上投入更多推理,买不到任何收益。
gpt-oss-120b 在 Distract 上,每个正确答案的成本约增至 25 倍(0.00006 美元 → 0.00151 美元),准确率还下降了 7.5 个百分点(不显著)。
唯一一次大幅提升也很昂贵。gpt-5.4-mini 在逻辑题上的改善,让每个正确答案的成本增至 8.5 倍。
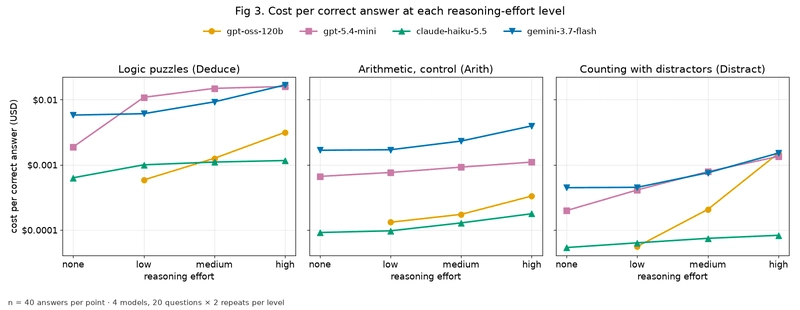
每个正确答案的成本(美元,对数刻度)。每条曲线都从左向右上升,没有一条下降。
有一个反直觉的细节:在 Deduce 上,gpt-5.4-mini 的 none 档每个正确答案的成本最低(0.0019 美元,high 档则为 0.016 美元),尽管它有 85% 的时候都答错了。只有当你能分辨哪些答案正确时,每个正确答案的成本才有意义。在大多数实际应用中,你做不到,所以别把这一行理解为建议你选择 none 档。
这些结论来自每个任务类别的 20 道题、2 次重复运行和 4 个模型,因此请将它们视为起点,而不是规则:
先测量 none。四个模型中,有两个(Haiku 和 Gemini)在最低设置下,就已经在每个任务类别上达到或接近 100%。
如果 none 表现不佳,先尝试 low,再尝试 high。对于唯一需要调高旋钮的模型,从 none → low 就贡献了总计 82.5 个百分点提升中的 60 个百分点。
不要假设同一个级别在不同厂商那里作用相同。none 在一个模型上会报错,在另一个模型上意味着不可见的思考,在第三个模型上才是真正关闭推理。
留意简单问题的冗长回答。在 Distract 任务中,长回答都是错的。
最需要调高旋钮的模型,恰好也是 none 真正意味着不推理的那个。gpt-5.4-mini 在 none 下只用 18 个 token 回答逻辑谜题,正确率与随机猜测差不多。
Gemini 的 none 并不免费。它在 none 下消耗的隐藏 token 中位数为 453,比 gpt-5.4-mini 在 high 下消耗的还多。
错误都偏向同一个方向。Distract 中每个错误答案都偏高,没有一个偏低。
推送任务让我多纳入了一个模型。Gemini 就是通过 Kaggle 的默认模型验证运行进入这项研究的。
配额系统差点制造出一个虚假的发现。378 次配额拒绝本来可能被解读为“gpt-5.4-mini 在高推理强度下失败”。预注册规则(403 = 缺失数据)将它们排除在外。
样本量小。每个任务类别只有 20 道题,每个实验单元重复运行 2 次。大多数“没有效果”的结果,意味着在这个样本量下无法检测到效果,而不是证明效果为零。
天花板效应。Haiku 和 Gemini 几乎在所有条件下都达到或接近 100%,所以我能说明调高旋钮让它们付出了什么成本,却无法说明带来了什么收益。要回答后一个问题,需要更难的题目。
合成任务,以及单一的提示词格式。这些问题旨在隔离不同因素的影响,而不是代表真实工作负载。
没有温度控制。Kaggle 的代理会丢弃 temperature,Google 模型还会丢弃 seed。我用重复运行和答案翻转率作为替代手段。
成本采用 Kaggle 代理的计费。你使用的服务商定价可能不同。
模型阵容不完整。Claude Sonnet 5 因配额预留问题被排除,gpt-oss-120b 则没有 none 级别。对它的比较从 low 开始。
对推理过程的观察并不完整。只有 Gemini 返回了推理轨迹(在 medium 和 high 下)。对于其他模型,输出 token 是唯一能反映思考的证据。
更难的 Deduce 题目(更多人物、更多线索),让 Haiku 和 Gemini 不再受天花板效应限制,看看调高它们的旋钮是否能带来收益。
更多 Distract 题目和重复运行。gpt-oss-120b 下降 7.5 个百分点、答案翻转率达到 45%,方向与 H2 的预测一致,但样本量太小,无法进行充分检验。
延迟。每次调用都已经记录了延迟(latency_s、backend_latency_ms),但本文没有分析。
Sonnet 和其他模型,每次运行一个任务,以适应配额预留限制。
本文中产生所有数值的材料都已公开:生成器、解析器、任务构建器、分析脚本、预注册方案,以及每一份原始 Kaggle 运行文件。
git clone https://github.com/Abeera81/reasoning-dial && cd reasoning-dial
pip install -r requirements.txt
python -m pytest -q                 # 68 tests: generators, parser, task builder, analysis
python analysis/analyze.py          # rebuilds results/summary.md and every figure from results/main/
analyze.py 会在进行任何计算之前,检查已锁定测试集的 SHA-256。要添加一个模型,只需 fork 四个公开 Kaggle 任务中的任意一个并运行。由于每个任务仅固定推理强度级别,比较仍然公平。
这个旋钮确实是一个有效的控制项。对于一个模型在一类问题上的表现,它决定了模型是在猜测,还是在解题。而对于我测量的其他所有情况,它主要只是抬高了价格。
在调高它之前,先看看 none 能给你什么。如果你让自己的模型跑了这些任务,我很想看看它们呈现出的阶梯曲线。🎛️
如需采取进一步措施,你可以考虑屏蔽此人和/或举报滥用行为。