
8.0
热点
AI SCORE
开源项目2026-10-16 20:03
零售分析开源案例:后端算数,模型解释
dev.to · AI#开源#数据分析#本地模型
Editor brief · 编辑速览
StockSense AI 将销售和库存计算交给传统分析后端,再由可选的本地语言模型解释结果,模型不可用时核心仪表盘仍可运行。项目提供数据库迁移、分析代码、测试数据和容器配置。
打烊时,一位店主看着一张有几百行数据的电子表格。销售记录都在,库存却介于“应该还够”和“昨天就该补货了”之间。Dashboard 可以显示一个总数,却未必能解释为什么某款产品排名第一、利润数字是否可信,或者还缺少哪些信息。
这个场景让我想到一个问题:小型零售商能否从销售和库存数据中获得有用的答案,同时不把算数的工作交给聊天机器人?
为了探索这个问题,我开发了 StockSense AI,一个开源的零售分析 MVP。它将传统的分析后端与可选的本地语言模型结合起来。计算负责提供证据,模型负责辅助解释。即使模型不可用,核心 Dashboard 依然可以正常运行。
代码仓库:sleepyaishik69/Stock-Sense
安装与产品说明:README
数据库 schema 快照:backend/schema.sql
Alembic migrations:backend/migrations
后端分析:analytics.py
AI 上下文构建:ai_context.py
API 与 AI 路由:main.py
Dashboard:frontend/app/page.tsx
用于体验工作流程的合成导入文件:test_sales_data.csv
容器配置:docker-compose.yml
下面是 Ask StockSense 界面的早期版本。在第一张图中,我问哪款产品卖得最多;虽然证据面板已经显示了销售汇总,回答却说无法判断。在第二张图中,我问如何增加销量,得到的却是宽泛的营销建议,没有产品层面的证据。这些回答让我看清了差距:在答案旁边展示指标,并不等于用这些指标回答问题。
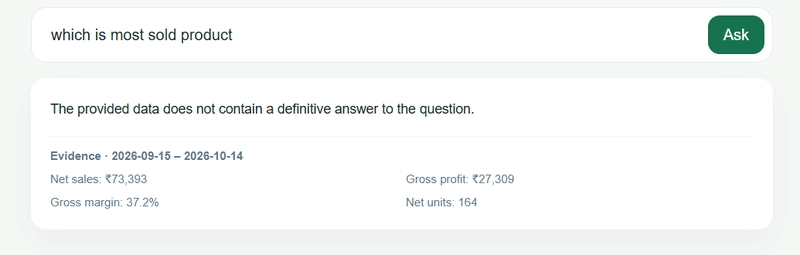
早期版本:尽管销售证据清晰可见,回答仍未指出最畅销的产品。
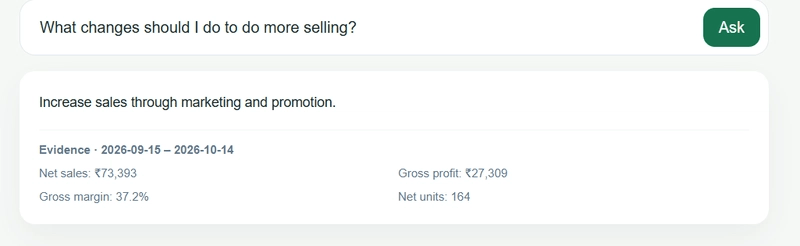
早期版本:泛泛的建议没有将推荐措施与具体产品或实际测量结果联系起来。
自然语言回答即使听起来很漂亮,也可能是错的。StockSense 把业务计算留在确定性的 Python 代码中。后端根据选定的 workspace、门店和日期范围,计算汇总值、对比结果、产品排名和库存信号。某些问题,包括“哪款产品售出的件数最多?”和“净销售额是多少?”,会直接依据这些事实作答。
对于更宽泛的问题,StockSense 会根据所选时段,以及此前一个等长时段,构建结构化且范围受限的分析上下文。其中包括销售额和利润趋势、产品与品类排名、销量变化、库存信号、购物篮模式,以及已知的数据缺口。如果 Ollama 和配置的 Gemma 模型可用,模型就会利用这些上下文生成解释。模型没有 SQL 工具,也不能修改库存或下订单。
界面会标明答案来自核心分析、Gemma,还是核心分析回退机制。同时还会显示日期范围,以及支持答案的指标、产品和库存证据。如果所选时段没有相关数据,应用会如实说明,而不是编造一个畅销产品。
这种分工很重要:模型可以帮助解读结果,但不应该悄悄变成结果的来源。
新用户注册后,系统会创建一个 workspace 和第一家门店,但不会预先填入任何产品或销售数据。产品、门店、销售记录和导入记录都归属于特定 workspace,API 查询也会限定在当前已认证的 workspace 内。用户可以通过邮箱和密码注册或登录;API 使用经过签名的 HttpOnly session cookie。
这样可以避免把演示数据伪装成用户真实的经营数据。仓库附带的 CSV 明确是一份合成测试数据,开发者想体验产品时,可以自行导入。
导入流程支持 CSV 和 Excel 文件。预览环节会识别常见的列名别名、展示数据样本,并建议如何将源文件中的列映射到 StockSense 字段。用户确认导入后,系统才会写入记录。
日期、数量和单价是必填字段。交易 ID、SKU、产品名称、品类、折扣、税额、单位成本和退货标记为可选字段。后端会校验日期和数字,拒绝数量非正数的记录以及重复行;它可以导入有效行,同时在导入历史中记录被拒绝的行及原因。如果遇到新的 SKU,导入流程还可以创建对应的产品记录。
这样,数据质量问题就能被看见。部分成功的导入不会被悄悄当成完全成功:用户可以查看被拒绝的行,并且应当在信任汇总结果之前解决这些问题。
分析代码使用 Python Decimal,并采用 half-up 舍入规则,将金额保留到分。主要指标的定义如下:
净销售额 = 销售总额 − 折扣 − 退款。税额会被存储,但不计入净销售额。
毛利润 = 净销售额 − 已售商品成本。只有所有相关销售明细都具备单位成本时,系统才会返回毛利润。
毛利率 = 毛利润 ÷ 净销售额。成本数据不完整或净销售额为零时,该指标不可用。
交易数按不同的交易 ID 统计,并限定在单家门店内。
平均交易金额 = 净销售额 ÷ 交易数。
库存价值使用产品当前成本和当前在手库存数量计算;它是对现值的估算,不是历史估值。
这些规则有助于避免 Dashboard 在真实答案是“未知”时显示“0”。成本数据缺失尤其重要:产品目录中的当前成本,不能反过来证明某条销售明细在售出时的成本是多少。
概览包含所选时段的经营快照,以及与此前等长时段的对比。它按周或月跟踪销售额和利润趋势,分别按销量、销售额和毛利润对产品排名,将产品销量与上一时段比较,并按品类汇总销售额。
Dashboard 分为多个实用视图,包括概览、销售分析、产品、库存、财务、营销、Ask StockSense、报表、导入和设置。这样,店主就可以从某个指标进一步查看背后的记录和运营细节。
报表可以导出为 CSV。目标不是让小企业淹没在图表里,而是让使用者能够回答日常问题、看清计算假设,然后继续经营门店。
StockSense 使用仅追加的库存变动台账,记录期初库存、实物盘点、到货、损耗和调整。每条记录都包含产品、门店、workspace、变动类型、数量变化、变动后的数量、可选备注、操作人和时间。直接修改产品库存也会生成一条变动记录。导入销售数据不会悄悄覆盖今天的库存。
这是一次有意的转变:不再把库存仅仅视为一个可以随时修改的整数。库存数量发生变化时,操作人员可以通过变动历史追溯核查。这份台账只能记录用户开始录入之后的变化,无法还原从未记录过的库存历史。
概览中的“每日行动中心”会标记库存未知、低库存或缺货风险、建议补货,以及产品成本缺失等问题。补货估算使用所选时段的日均销量、供货提前期和配置的补货阈值。这些建议只是供人工审核的提示:它们没有对季节性、已确认的在途订单、供应商包装规格或需求不确定性建模,也绝不会创建采购订单。
采购预算规划器会根据当前记录的成本和库存,将指定预算分配给有足够数据支持的补货建议。它只纳入信息足够、能够估算成本的产品,不会联系供应商,也不会下订单。
营销视图可以找出在交易购物篮中共同出现的产品。它使用支持度、置信度和提升度,并且只有在存在可用交易 ID 时才能发挥作用。这些只是描述性的共同购买模式,不能证明一种产品会带动另一种产品销售,也不能衡量促销效果。当前数据模型无法确定促销提升效果、价格弹性或客户分群。
AI 路径是可选的。StockSense 可以调用本地运行、配置为使用 gemma2:2b 的 Ollama 服务。Dashboard 会显示模型状态;由模型支持的洞察生成设有超时和并发上限。如果 Ollama 离线,确定性分析、报表、导入以及 Dashboard 的其他功能仍然可用。自然语言聊天则会回退为对计算事实的汇总,并明确标注。
这便于在本地实验,也让模型依赖与数据流水线保持分离。但这并不意味着整个应用已经完成生产环境加固:在本地运行模型,仍然需要合适的硬件,以及由运维人员管理的服务。
前端:Next.js 16、React 19、TypeScript、Tailwind CSS 和 Recharts。
API:Python、FastAPI、SQLAlchemy 和 Pydantic。
持久化:本地开发使用 SQLite;Docker Compose 方案使用 PostgreSQL。
Schema 变更:使用 Alembic migrations。初始 schema 和库存变动 migration 都在仓库中。
推理:通过可选的 Ollama HTTP 调用访问 Gemma;核心指标不依赖任何模型。
整体请求路径如下:
CSV / Excel import
        ↓
Preview → map columns → validate → confirm
        ↓
Workspace-scoped relational records
        ↓
Python Decimal analytics + inventory signals
        ├── Dashboard and CSV reports
        └── Bounded facts context → optional Ollama/Gemma explanation
使用 SQLite 时,API 会在启动时创建一个空 schema。PostgreSQL 部署则会执行 Alembic migration 链。仓库中的 schema.sql 是生成的 SQLite 快照;schema 演进以 migrations 为准。
克隆仓库:
git clone https://github.com/sleepyaishik69/Stock-Sense.git
cd Stock-Sense
在一个终端中启动 API:
cd backend
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
alembic upgrade head
uvicorn app.main:app --reload --port 8000
然后在另一个终端中启动 Next.js 应用:
cd frontend
npm install
npm run dev
打开 http://localhost:3000,创建 workspace,然后导入你自己的销售文件或那份合成测试 CSV。API 文档可在本地的 http://localhost:8000/docs 查看。
如果想体验可选的本地模型,安装 Ollama 后运行:
ollama pull gemma2:2b
ollama serve
API 会从配置中读取 OLLAMA_BASE_URL、OLLAMA_MODEL 和 OLLAMA_TIMEOUT_SECONDS。要运行基于 PostgreSQL 的本地技术栈,请将 .env.example 复制为 .env,替换开发用的 secret,然后执行 docker compose up --build。可选的 Ollama 服务可以通过 ai Compose profile 启用。
StockSense 是一个 MVP 基础版本,还不是成熟的 SaaS 产品。仓库的 README 列出了当前限制和路线图。一些重要缺口包括:PostgreSQL 行级安全、workspace 角色、密码重置、CSRF 防护、限流、供应商记录、已确认的采购订单与部分收货、历史成本快照、考虑季节性的需求预测、促销分析,以及浏览器端到端测试,目前都尚未实现。
当前 session cookie 支持本地 HTTP 开发;实际部署需要 HTTPS 和生产环境 cookie 设置、secret 管理、妥善配置的数据库凭据、备份、监控以及安全审查。Compose 中的凭据仅供开发使用。财务输出属于经营分析,不构成会计、税务或专业财务建议。
我认为,把这些限制纳入产品介绍是一个优点。零售商应该能够分辨:哪些数字来自实际观测,哪些是估算,以及哪些问题是当前数据无法回答的。
最有价值的工程决策,是在加入自然语言之前,先把数据路径明确下来。这迫使我定义清楚净销售额、退货、成本缺失、交易标识、库存历史,以及可测量事实与看似合理的解释之间的边界。
它也改变了我对“AI 分析”的看法。真正出色的部分,不只是让模型总结一张表,而是准备恰当的证据、保留指标语义、展示来源,并允许系统说“数据不足”。对于库存,这意味着记录变动,而不是假装当前库存数量能够解释过去。对于成本,这意味着让缺失清晰可见,而不是靠猜测填补空白。
如需采取进一步措施,你可以考虑屏蔽此人和/或举报滥用行为。