
8.0
热点
AI SCORE
编程提效2026-10-16 20:08
手写 ReAct 循环构建 CI 修复 Agent
dev.to · AI#智能体#持续集成#工具调用
Editor brief · 编辑速览
作者为 CI 故障修复助手放弃 AgentExecutor,改用约20行核心循环实现有界迭代、工具分发、可检查消息与步数耗尽后的回答回退。文章还讨论模型提供方抽象,以及框架透明度和版本变化带来的取舍。
我花了两天时间,想让 LangChain 的 AgentExecutor 按我的设想工作。它确实跑起来了,算是吧。Agent 能调用工具,也能给出答案,但我说不清它为什么会做出那些选择。尝试更换 LLM 提供商时,追踪功能坏了;尝试添加第二个工具时,工具分发逻辑又被缠进了层层抽象,而这些抽象既不是我写的,也不方便检查。
于是我删掉了它,自己写了一个大约 270 行的 ReAct 循环。这篇文章讲的就是这个决定、由此形成的架构,以及大多数 Agent 教程完全跳过的一件事:可观测性。
这个项目叫 RepoPilot,最终目标是做一个修复 CI 的 Agent:给它一次失败的 GitHub Actions 运行记录,它最终应该能诊断失败原因,并提出一个可由人工审批的修复方案。
不过,在实现这些之前,我需要先打好基础。这个 Agent 得具备以下能力:
这就是 Phase 1。本文讲的是我如何把它搭起来,以及为什么框架不适合这项工作。
LangChain、CrewAI 以及类似框架确实有价值:
对于某些项目,比如需要快速接入大量集成,或者框架的设计取舍恰好符合你的需求,它们确实能加快开发。
但在我的项目里,有三件事出了问题。
AgentExecutor 做出决策时,我很难看清原因。prompt 的串联、工具选择逻辑、中间结果解析,全都发生在我没有编写的抽象层里。
调试变成了阅读框架源码,而不是检查自己的代码。
LangChain 对 LLM 提供商做了抽象,但这套抽象有自己的结构和约定。
当我尝试把 Gemini 换成本地的 Ollama 模型时,追踪功能坏了。框架的回调系统与 LLM 抽象之间存在一些耦合,而这些耦合并不完全受我控制。
LangChain 的 API 经常变化。六个月前的代码,如今往往就需要重写。对于一个打算长期维护和扩展的项目,这是负担。
这些问题单独来看,都不足以让我放弃框架。但放在一起,答案就很清楚了:如果一个项目的全部价值都在于可审计性和控制力,那么黑盒就不适合拿来做基础。
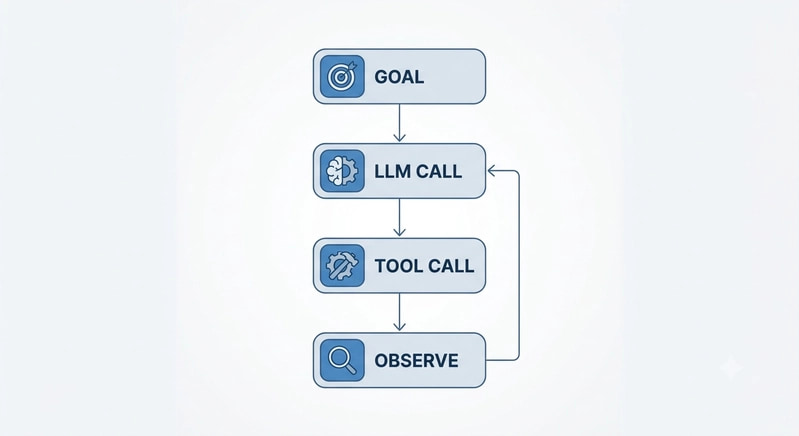
ReAct(Reason + Act)是一种简单的模式:
就这么简单。下面是我的核心实现:
python def run(self, goal: str) -> str: messages = [ {"role": "system", "content": SYSTEM_PROMPT}, {"role": "user", "content": goal}, ]
for step in range(self.max_steps):
    response = self.llm.chat_with_tools(messages, self.tools.schemas())

    if not response.tool_calls:
        return response.content

    messages.append({"role": "assistant", "content": response.content})

    for call in response.tool_calls:
        result = self.tools.execute(call.name, call.arguments)
        messages.append({
            "role": "tool",
            "name": call.name,
            "content": json.dumps(result),
        })

return self._request_final_answer(messages)
大约 20 行逻辑,就覆盖了我需要的一切:
代码是我写的,每一行我都理解。出了问题,我知道该去哪里找。
有一个设计决定,我很早就做对了:core/ 从不导入任何提供商的 SDK。Agent 面向接口通信,不直接对接 Gemini、OpenAI 或 Ollama。
python class LLMProvider(ABC): @abstractmethod def chat(self, messages: list[dict]) -> str: ...
@abstractmethod
def chat_with_tools(self, messages: list[dict], tools: list[dict]) -> NormalizedResponse: ...
Gemini adapter 实现了这个接口。更换提供商,只需要写一个新的 adapter,不需要重写 Agent。
我可以先用免费的云端 API 开发,之后只改一个环境变量,就能切换到本地模型。Agent 感知不到任何区别。
为什么这很重要?一旦我在 core/ 里写下 from openai import OpenAI,就已经把自己绑定上去了。adapter 模式让我多写了大约 50 行代码,换来的灵活性会在 Phase 2 派上用场。
在添加第二个工具之前,我先做了一件事:追踪。
Agent 每次运行都会生成结构化的追踪记录,包含每一次 LLM 调用、每一次工具调用、每一个结果,以及每一个错误。它不是几行日志,而是一套数据模型。
python @dataclass class AgentStep: step_number: int timestamp: float type: str # "llm_call" | "tool_call" | "tool_result" | "error" model: str | None tool_name: str | None arguments: dict | None result: Any | None error: str | None duration_ms: float
每次运行结束,RepoPilot 都会打印一份摘要:
text ───────────────────────────────────────────── RepoPilot Run Summary ───────────────────────────────────────────── Goal: Check the repository status Total steps: 4 LLM calls: 2 Tool calls: 1 Errors: 0 Total duration: 78.41s ─────────────────────────────────────────────
它还会把完整的追踪记录写入 .runs/{run_id}.json。
正是这些记录,让 Agent 变得可调试。运行失败时,我不用猜。打开追踪记录,就能准确看到发生了什么:传入了哪个 prompt、调用了哪个工具、返回了什么,以及循环在哪一步出了问题。
为什么我要在添加更多工具之前先做这个?如果我有 5 个工具,而循环又出了问题,我就不知道问题究竟出在哪里。有了追踪,我就能看清:究竟是循环运行正常、工具出了问题,还是反过来。
有两个真实的错误,值得分享。
第一个版本里,我在 Gemini adapter 内部记录 LLM 调用。看起来很合理,毕竟 API 调用就发生在那里。
但当我尝试更换提供商时,追踪功能就没了。
于是,我把它移到了核心循环里。现在,无论使用哪个提供商,追踪功能的行为都完全一致。
经验是:把横切关注点,也就是追踪、安全、审批这些贯穿各层的能力,放在核心层,而不是提供商层。
初稿里,我一口气写了 git_status、git_diff、read_file、list_files 和 search_code。
然后,我花了一整天调试工具 schema 和错误处理,那时甚至还没确认 ReAct 循环本身是否正确。
我把工具缩减到只剩一个:git_status。它已经足以验证循环能否正常工作。
经验是:验证架构,一个工具就够了。等基础稳固之后,再加功能。
Phase 1 已经完成。这个 Agent:
它还不是一个修复 CI 的 Agent,而是构建这类 Agent 的基础。但这套基础干净、经过测试,而且最重要的是,我能理解它。
到了 Phase 2,RepoPilot 才会真正名副其实:
确定性优先的设计,是它与其他方案的区别。大多数修复 CI 的 Agent 会把日志扔给 LLM,然后寄希望于它能解决问题。RepoPilot 会先用 regex 对失败进行分类,只有确实需要时才使用 LLM。
框架没有错,只是并不总是合适。
如果你在做一个快速原型,就用 LangChain。如果你在构建一个系统,而它的价值在于可审计性、控制力和安全保障,那就自己写循环。大约 100 行代码,每一行你都能理解。
而且,要先做可观测性。不是因为它有趣,而是因为它决定了你得到的是一个可以调试的 Agent,还是一个只能盼着它正常工作的 Agent。
代码位于 https://github.com/Ujma21/RepoPilot.git。Phase 2 正在开发中。如果你也在构建 Agent,并且像我一样碰到了框架的限制,我很想听听你是怎么解决的。
如果需要采取进一步行动,你可以考虑屏蔽此人,或者举报其滥用行为。