前端进阶之旅前端进阶之旅
基础篇
进阶篇
高频篇
精选篇
手写篇
面经篇
AI 篇
原理篇
每日一题
小程序题库
知识卡片
  • 场景篇按分类整理的大前端场景考点
  • 历年面经按年份追踪真实考点
  • 算法题库NEW在线编码即时判题
  • 专项自测100 题快速查漏
  • 前端基础
    • HTTP从报文一路讲到 HTTPS
    • 浏览器渲染、事件循环、进程
    • 计算机基础Linux、网络、操作系统
  • 进阶专项
    • 设计模式23 种模式怎么用
    • 前端系统进阶学习大型项目工程化
    • 前端综合文章长期沉淀的实践文
  • 工程与工具
    • Node学习指南从环境搭建到服务端
    • NPM工作流script、依赖与发布
    • Docker容器化部署上手
    • Canvas图形与动画实战
  • 路线与导图
    • 思维导图知识点全景图
    • 学习路线按图索骥不跑偏
  • 动态
    • 公众号动态公众号历史文章
    • 博客动态站长的技术博客
    • 开发者导航常用工具与文档站
  • AI 助手随时提问,即时解析
  • AI 模拟面试模拟真实面试 + 报告
  • AI 知识地图串起全站知识点
  • AI 定制路线按你的简历现排
AI 热点
旧版
返回 AI 情报前线
All News · 全部资讯9467
  • 企业AI Agent为何总缺知识而非数据
  • AI Agent测试用例:合成数据vs生产数据对比
  • x402协议教程:AI代理免API key按次付费
  • Harness Score:评估代码仓对AI编程助手的支持度
  • 欧洲AI公司发布Kolibri开源权重模型,Apache 2.0许可可商用
  • Jev:结构化AI判决工具链发布中文文档
  • Headless Claude Code中断恢复实战方案
  • tester-army/e2e:用自然语言描述目标的下一代 E2E 测试框架
  • AI Agent 为何演示惊艳、上线就崩
  • 2026 AI Agent 云端基础设施选型完全指南
  • 训练而非编写:Agent Skill 的数据驱动优化实践
  • RAG检索碎片化才是AI文档问答出错的根本原因
  • 高通获得华为逻辑折叠芯片专利许可,验证华为制造能力
  • YC CEO Garry Tan 开源 23 工具 AI 开发栈
  • pstack 转译版:Cursor 规范流向 Claude/Codex/Pi
  • LLM Agent 的「侦察惰性」:知道怎么修却反复扫描
  • AI 编程工具为何忘记团队决策:跨工具上下文共享方案
  • 英国NCSC发布AI Agent安全控制七项建议
  • 传统防火墙无法检测提示词攻击:LLM安全需重新设计
  • 用x402协议让AI Agent无账户付款:实战构建日志
  • 开源智能客服机器人:知道何时转人工
  • Hinton发表首篇RSI论文,AI造AI进入流水线
  • Harness决定AI Agent能力:同模型不同表现
  • Claude Code权限绕过:Read拒绝后Bash仍可读取
  • 生产级Agent系统实战:LLM路由、Prompt合约与PR安全审查
  • LCLM:16倍压缩的潜在上下文语言模型
  • Claude Code mods解析:何时需要构建插件
  • 通义千问三年发展史:从7B参数到2.4万亿
  • Linus确认Linux内核进入「AI新常态」
  • 如何验证Agent实际完成了它声称的任务
  • Claude Code /compact 后哪些内容真正存活
  • 开源安全模型 apex-flash-1:60 个遗留 Bug 任务解出 40 个
  • yOGI Neural Grid:强制验证模型引用来源的工程实现
  • AI推理将成为软件行业最大市场
  • 美团开源LongCat-Video:13.6B参数统一视频生成模型
  • Agent技能需要包管理器而非仅靠Prompt
  • n8n AI Agent 生产环境失败根因与修复方案
  • 565 行 Python 从零实现编程智能体
  • 四大前沿模型横向评测:Astra擅计算机使用、Argon强法律金融、Sol价格最优
  • 本地RAG开发113个评估问题后的实战总结
  • AI重写让我重新审视运行时成本:Node.js转Go/Rust的算账
  • MCP工具超90个时的平台化架构设计
  • Homa:专为AI集群设计的TCP替代网络协议栈
  • 我为编码Agent的测试篡改问题做了个AdversaryGate
  • SaaS支持文档检索应选语义嵌入而非关键词
  • AI 审核员知道太多会变差:验证者应不知情
  • 长文档JSON提取超时?先做好输入分片而非调大timeout
  • PostgreSQL pgvector混合搜索实战:向量相似度+全文关键词融合
  • 新版Claude不再需要"Think Step by Step":Osmani提示指南解读
  • CodeSmith三区架构:解决prefix drift导致Token重计费问题
  • 像读流水线一样读Transformer Block
  • 已加载 51 / 9467
8.0
热点
AI SCORE
开源项目2026-10-05 14:48

开源智能客服机器人:知道何时转人工

dev.to · AI#客服机器人#RAG#开源
Editor brief · 编辑速览

支持Web/Discord/WhatsApp多渠道,集成HITL、情感检测判断转人工时机,六阶段RAG+FAISS检索提升回答准确性。

文章思维导图
Knowledge map
拖拽缩放
Full translation

完整中文译文

每个人都遇到过那种客服机器人——它一遍遍说"抱歉,我没听懂",而你却越来越火大。

我想做的是相反的东西:一个能回答它能回答的问题、在需要真人时安静退出的机器人。它运行在 Web、Discord 和 WhatsApp 上,代码开源:github.com/Shahzaib30/ai-support-agent

这个系统有四层。客户从任意渠道与它对话,一个 FastAPI 后端处理所有事务,一些服务存储状态和发送告警,监控则监视着一切。
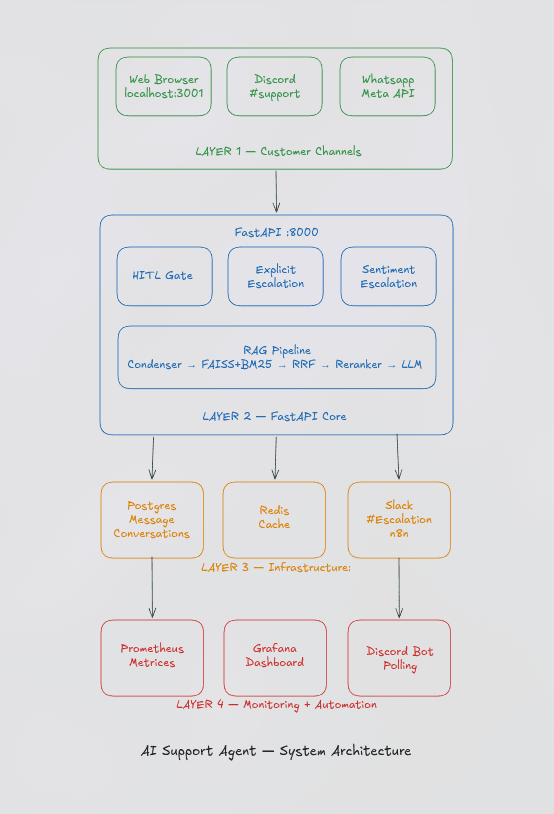
AI support agent system architecture: channels, FastAPI core, infrastructure, monitoring

FastAPI 核心中,答案引擎前面有三重关卡:HITL 关卡(human-in-the-loop,检查是否已经有客服在处理对话)、显式升级检查,以及情绪升级检查。PostgreSQL 记录对话历史,Redis 缓存答案,一切通过一条 Docker Compose 命令即可运行。

Bot 如何查找答案

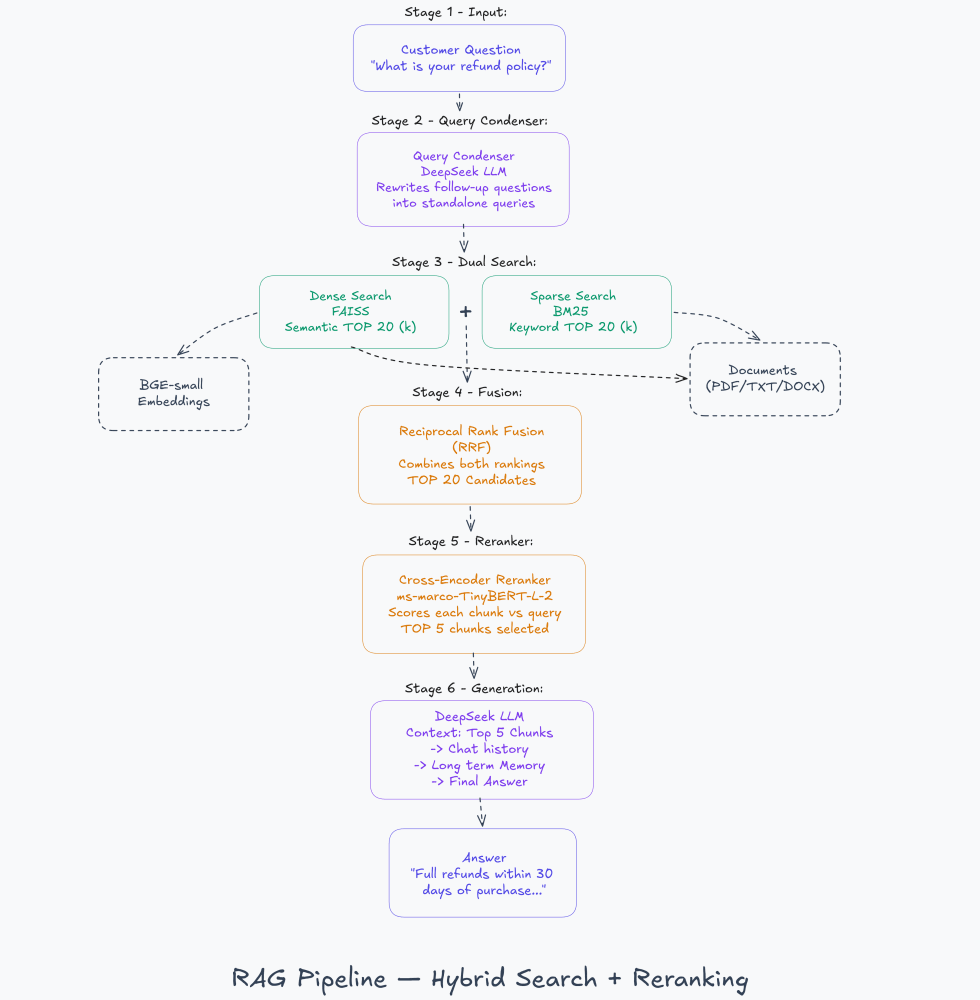
大多数 RAG 机器人搜一次就完事。我的系统把每个问题过六道关:

RAG pipeline: query condenser, hybrid search, fusion, reranker, generation

问题进来后,首先经过一个查询压缩器(query condenser)重写它。客户会说"那打折商品呢?"这样的话,单独看毫无意义。一个 DeepSeek 步骤先把后续问题转成独立问题。

然后两个搜索同时跑。FAISS 配合 BGE-small 嵌入模型按语义查找段落。BM25 按精确词汇查找。每个返回各自的前 20 条。

Reciprocal Rank Fusion 将它们合并成一个 20 条候选的列表。

交叉编码器(cross-encoder)重新排序。它把问题和每个段落一起读取,只有前 5 条通过。

DeepSeek 用这 5 个片段、聊天历史和长期记忆来撰写答案。

为什么要两个搜索?向量搜索理解语义,但在精确内容上弱——比如价格、邮箱、电话号码。问"Pro 方案多少钱?"它可能返回一段讲定价策略的好话,而不是带具体数字的那条。BM25 恰恰相反。两者合在一起互补,对于固定事实类问题,混合搜索明显优于单独使用向量搜索。

Bot 何时放弃

这里有两个触发器,而且我有意用不同方式实现。

1. 客户明显不高兴了(由 LLM 检查)

每条消息都会以一个严格 prompt 发给 DeepSeek API,回复必须是 JSON 格式,包含一个标签和 -1.0 到 1.0 的分数:

Rules:
- negative: customer is CLEARLY angry, frustrated, or complaining
- neutral: casual phrases, short responses, confusion, greetings
- positive: happy, satisfied, thankful

"oh no" → neutral
"wtf" → neutral (not clearly angry enough)
"this is terrible I want a refund NOW" → negative

Reply ONLY with JSON: {"label": ..., "score": ...}

这些示例才是让这套机制生效的关键。人们会随口说"oh no"和"wtf",所以它们算中立。只有明确的愤怒才算负面。

一条愤怒消息不会触发任何操作。Bot 需要连续三条负面消息才会升级,所以冷静下来的客户不会因为早期的坏情绪而受罚。

2. 客户要求人工(纯代码,不用 LLM)

def wants_human(text: str) -> bool:
    text = text.lower()
    return any(p in text for p in HUMAN_REQUEST_PHRASES)

# "talk to a human", "real person", "live agent", ...

如果消息中包含"talk to a human"或"real person"这样的短语,Bot 立即升级。要调用 API 来理解"I want a human"既费钱又费时间,所以一个简单的短语列表免费搞定。

这成了我的主要原则:需要判断时用 LLM,规则清晰时用纯代码。

一场对话,三种状态

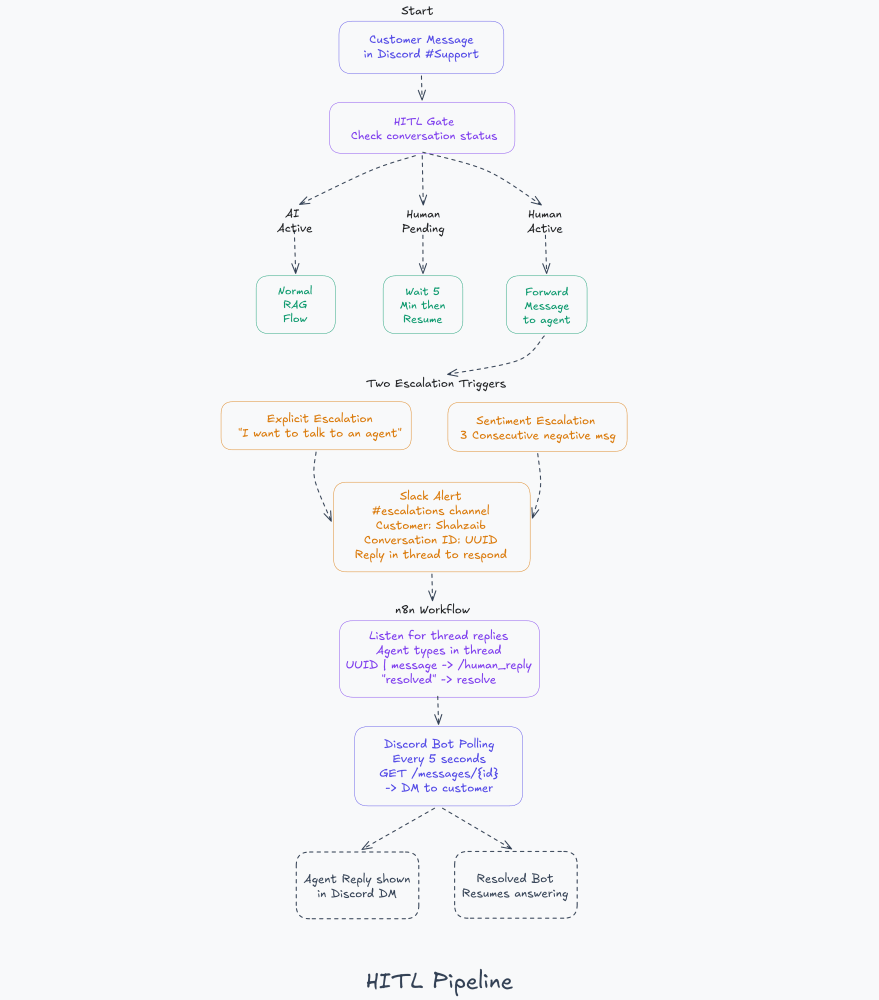
在回答任何问题之前,HITL 关卡会检查对话处于什么状态:

HITL flow: AI Active, Human Pending, Human Active

AI Active:正常 RAG 流程,Bot 回复。

Human Pending:升级已发出但还没有人工回复。如果 5 分钟内无人应答,Bot 会收回对话,以免客户干等。

Human Active:人工正在处理,所以 Bot 保持沉默,并把客户的消息转发给客服。客户永远不会收到两个回复。

当问题解决后,客户直接回到与 AI 对话。

发送告警很简单。两个触发器中任意一个触发时,Bot 会向 Slack 的 #escalations 频道发帖,包含客户、渠道、原因、情绪分数和对话 ID:
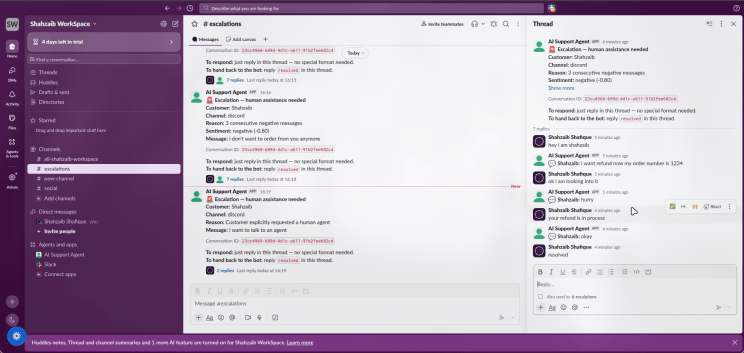
Slack escalation alert and reply thread

人工在帖子中回复,不需要特殊格式。客户的新消息也会出现在这个线程里,所以整个对话在一个地方完成。人工只需输入 resolved 就可以把对话交回给 Bot。

最难的一半:把回复传回客户

读取 Slack 回复并把它发给 Discord 上的某个人,这是最棘手的部分。我用 n8n 工作流解决了:
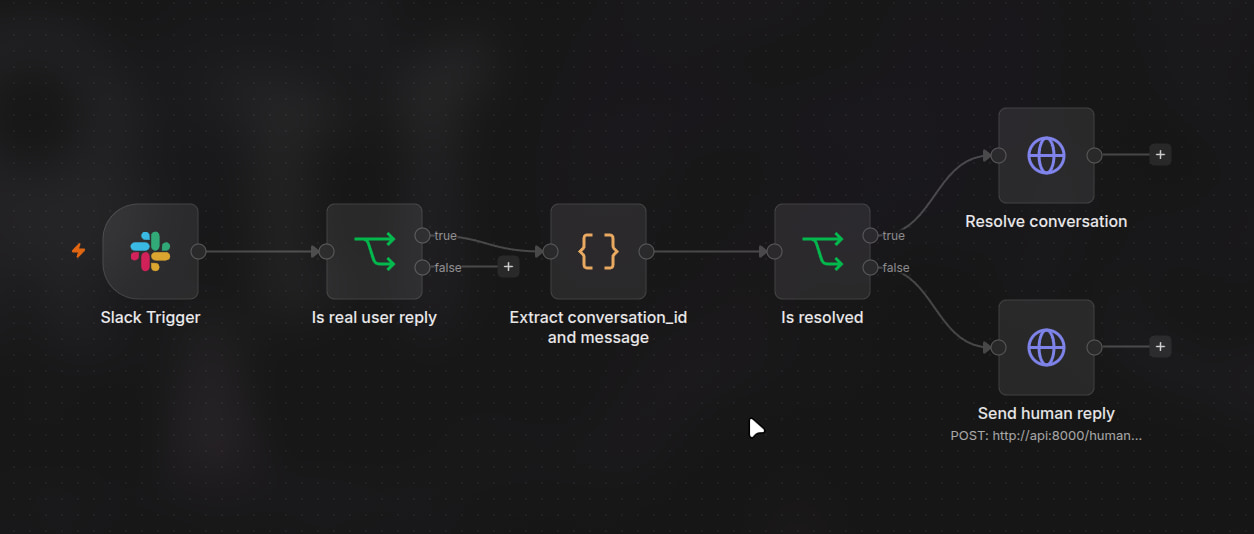
n8n workflow: Slack trigger, user check, extract, resolved branch

Slack Trigger 在线程中有新消息时触发。

Is real user reply 检查这是真人而不是 Bot 自己的消息。

Extract conversation_id and message 提取出 API 需要的两个东西。

Is resolved 分支:Yes:调用 API 在 PostgreSQL 中解决对话。No:调用 API(/human_reply)存储回复。

Discord 端,一个小 Bot 每 5 秒检查一次 API,把新的人工回复 DM 给客户。客户看到的是这样的:
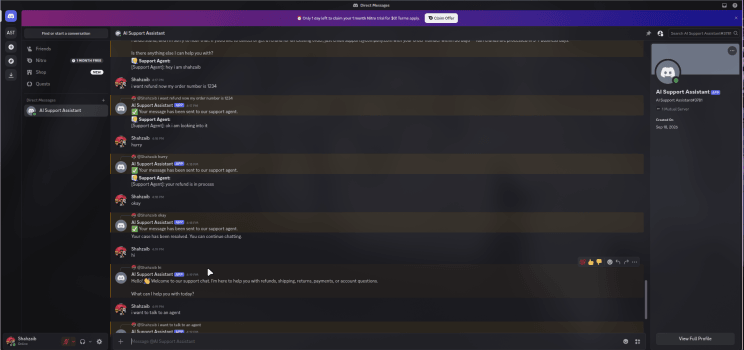
Discord DM: agent replies, case resolved, bot resumes

客户的消息被确认已发送给客服,专员的回复出现在对话中,一旦问题解决 Bot 会告知客户并重新开始回复。

监控

Grafana 仪表板有六个面板:总消息数、总升级数、缓存命中率、平均 RAG 响应时间、活跃对话数、缓存命中与未命中。
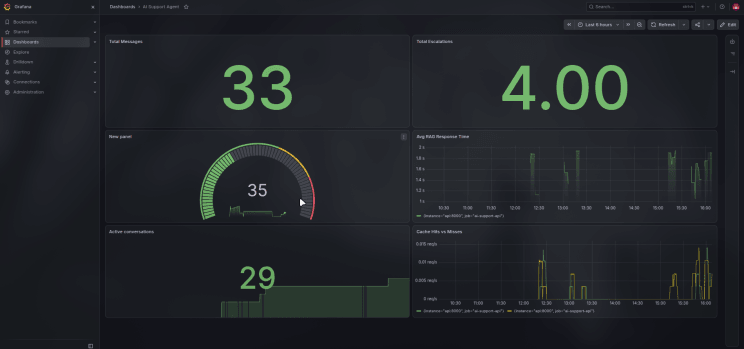
Grafana dashboard with six panels

LangSmith 追踪每个请求,所以我可以打开任意答案,准确看到管道内部发生了什么:
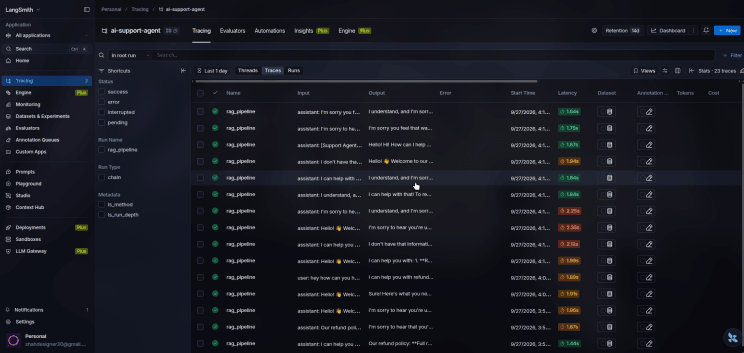
LangSmith traces of the rag_pipeline

我的测试运行(23 条追踪)中,端到端答案耗时约 1.4 到 2.4 秒。这些数字来自我自己的测试对话,不是真实客户。

经验总结

并非所有事情都需要 LLM。需要判断时用它,比如读情绪。规则清晰时用纯代码,比如短语匹配。

追踪节省大量时间。LangSmith 让我看到每个请求实际做了什么,所以我不再猜测哪里出了问题。

连接各种工具才是工作的主体。Slack、Discord、n8n 和数据库各有各的脾气,真正的功夫花在让它们互相通话上。

需要快速集成时用 n8n。它让棘手的步骤变得简单,并保持工作流对其他人可读。当需要深度定制、低延迟或自定义逻辑时,绕过它。对于那些场景,直接写代码。

Code: github.com/Shahzaib30/ai-support-agent

Upwork: My Upwork profile

Linkedin: My Linkedin profile

我是一名全栈 AI 工程师,构建 AI 代理、RAG 系统和自动化。如果你也在做类似的东西,欢迎联系我。

你遇到过最烂的客服机器人是什么样的?在评论区告诉我。

Original source

本文由 AI 翻译整理自 dev.to · AI,原文版权归原作者所有。

阅读英文原文
上一篇
用x402协议让AI Agent无账户付款:实战构建日志
下一篇
Hinton发表首篇RSI论文,AI造AI进入流水线