
8.0
热点
AI SCORE
编程提效2026-10-05 10:17
Claude Code /compact 后哪些内容真正存活
dev.to · AI#Claude Code#AI编程工具#最佳实践
Editor brief · 编辑速览
作者实测 8 次压缩后发现:根目录 CLAUDE.md 及 @import、SessionStart hook 规则始终保留,但通过 claude -p --resume 触发的压缩会丢失已调用 skill 的 body;嵌套 CLAUDE.md 不保证重新 Read。
8 次压缩中有 2 次丢失了我在会话中调用过的 skill 正文,尽管 Claude Code 文档说调用的 skill 正文会被重新注入:这两种都是通过 claude -p --resume 发送的 /compact,而在单个进程中运行的 6 次压缩则每次都重新附加了 skill。8 次压缩都把根目录的 CLAUDE.md 及其 @import 完全恢复到磁盘上的原样,将在聊天中输入的 passphrase 仅保留在摘要内,并仅在 Claude Code 压缩后会重新读取的文件中保留了嵌套的 CLAUDE.md,且没有触发新的 Read 操作。
今年 7 月,本账号发布了 What survives compaction in Claude Code — and how to keep your rules alive。它将指令分类为压缩后存活与消亡两类,并对其余情况推荐使用 matcher: compact 的 SessionStart hook。它没有给出任何测量数据,也没有提及 skill 会发生什么变化。文章末尾确实给出了一条建议:在会话中途手动运行 /compact,检查 agent 是否仍然保留该规则。此后 Claude Code 文档新增了一张表格,逐机制地列出压缩后会发生什么。本文就是那次手动检查,从 transcript 中读取结果,并将 7 月的文章与文档表格进行对比验证。
方法是来自 Six CLAUDE.md files, six codewords 那篇文章的方案,即测量每个 CLAUDE.md 何时首次加载。这次的问题变成:压缩后还剩什么。我在五个位置放置了标记字符串:根目录的 CLAUDE.md、由 @ 导入的文件、子目录中(在压缩前通过 Read 加载)的 CLAUDE.md、压缩前调用的 skill 正文,以及在聊天中输入的 passphrase。压缩后,我会询问模型它还能看到哪些标记,并将答案与 ~/.claude/projects/ 下的会话 transcript 进行对比——transcript 记录了 Claude Code 发送的每个附件以及每次请求的 token 使用量。后续运行还增加了无作用域规则、路径作用域规则和压缩 hook。
所有实验均于 2026-09-30 使用 Claude Code 2.1.285(claude --version)和 claude-opus-5-5 在临时目录中运行:18 个 claude -p 进程、8 次压缩、12 次探测。
claude -p 能否运行 /compact?无头模式页面列出了 -p 模式下命令支持的差异:用户调用的 skill 和自定义命令可用,"仅在终端界面运行的内置命令(如 /login)不可用。"但没有说明 /compact 属于哪一类。Agent SDK 页面有说明。agent loop 页面写道:"发送 /compact 作为提示字符串以按需触发压缩",SDK skills 页面补充道:"对对话历史进行操作的命令(如 /compact)需要先前消息才能生效",因此"在有先前回合的会话中使用此模式,例如在流式输入模式下或在恢复会话时。"
这两种形式都可以从 CLI 正常工作。claude -p "/compact" --resume <session-id> --output-format json 大约 20 秒后返回,"result": "" 和 num_turns: 0,transcript 增加了一条 compact_boundary 记录("trigger": "manual", "preTokens": 23412, "postTokens": 1740)以及本地命令输出 Compacted (ctrl+o to see full summary)。用 --input-format stream-json 启动的单个进程将 /compact 作为第三条用户消息接受;其输出流显示了 compacting 状态事件、compact_boundary 事件,以及包含空字符串的 result。实验室使用了两种形式,而它们之间的差异被证明是主要发现。
五个文件和一个聊天消息:
CLAUDE.md                          Root codeword: MK-ROOT-4417, then @notes/imported.md
notes/imported.md                  Import codeword: MK-IMPORT-2290
sub/CLAUDE.md                      Subdirectory codeword: MK-SUB-6621
sub/data.txt                       "This is a plain data file. It holds no codeword."
.claude/skills/lab-skill/SKILL.md  Skill codeword: MK-SKILL-1938 (reply READY)
chat message                       "the passphrase is MK-PASS-8053"
四个指令文件用填充行填满,这些填充行不提出任何要求。会话发送四条消息:/lab-skill;然后"For the rest of this session, the passphrase is MK-PASS-8053. Now use the Read tool once on sub/data.txt and reply with only the first line of that file."(那个 Read 正是加载 sub/CLAUDE.md 的操作);然后 /compact;然后是探测。
在 passphrase 消息和 /compact 之间,一个脚本用新数字重写了根目录的 CLAUDE.md、导入文件、嵌套的 CLAUDE.md 和 SKILL.md(MK-ROOT-7093、MK-IMPORT-6158、MK-SUB-3846、MK-SKILL-5702)。这个编辑操作使得答案可以解读。压缩后,旧数字只能来自对话:摘要,或者 Claude Code 保留的副本。新数字只能来自磁盘。Passphrase 从不被编辑,而且它在磁盘上根本没有副本。
探测内容:"Do not use any tools. From what is already in your context, list every string that starts with MK- that you can see, one per line. After each one, add a few words on where it appears. Do not guess strings you cannot see." 然后我在发送模型的 transcript 记录中收集了每个 MK- 字符串。在全部 12 次探测中,模型的列表和 transcript 的列表完全一致,因此下方 transcript 即为证据,答案即为评注。
A,复原运行: 五个 claude -p 进程,每步一个(第一个除外),每个(第一个之后)都用 --resume 启动。步骤分别是:skill 调用、passphrase 消息、用 --fork-session 进行的探测(作为无压缩的对照,不影响原始会话)、/compact,以及探测。
B,单进程运行: 同样的四条消息通过一个 claude -p --input-format stream-json 进程传递,中间有编辑操作。
BC:B 但无 /compact,作为对照。
C:B 加上 .claude/rules/always-on.md 中的无作用域规则、带有 paths: ["sub/**"] 的规则,以及 matcher compact 的 SessionStart hook(运行 cat .claude/reinject.md)。三者都带有标记,同样会被编辑。
D:C 的文件但无编辑,改为七次 Read 而非一次:sub/data.txt,然后是 other/f1.txt 到 other/f6.txt。我用 touch 将 sub/data.txt、sub/CLAUDE.md 和路径规则的时间戳回退了两天,使它们成为最近修改时间最旧的文件——这是长期存在的规则文件在如今修改过的文件旁边的典型样子。
A 和 B 使用 --settings '{"disableAllHooks": true, "autoMemoryEnabled": false}' 和 --strict-mcp-config 运行,因此没有用户 hook 或自动 memory 添加文本。C 和 D 需要 hook,因此只关闭了自动 memory 并使用 --setting-sources project,local 以排除用户设置。Read 操作通过 --allowedTools Read 允许。
项目根目录的 CLAUDE.md 在压缩后存活:/compact 后,Claude 从磁盘重新读取它并重新注入会话。子目录中的嵌套 CLAUDE.md 文件和带有 paths: 前端的规则会在 Claude 读取它们所适用的文件时重新加载。
上下文窗口页面在"What survives compaction"下有一张表格。以下是这里涉及的行:
表格下方:"路径作用域规则和嵌套 CLAUDE.md 文件在触发文件被读取时加载到消息历史中,因此压缩时会与所有其他内容一起被摘要掉。" skills 页面更详细地描述了 skill 行:"当对话被摘要以释放上下文时,Claude Code 在摘要之后重新附加每个 skill 最近一次调用,保留每个 skill 的前 5,000 个 token。"而上下文窗口页面的启动视图在 skill 列表说明中写道:"与启动内容的其余部分不同,此列表在 /compact 后不会重新注入。只有你实际调用过的 skill 才会被保留。"
还有一句话解释为什么编辑是一个公平的测试。Prompt caching 页面写道:"你的项目根目录和用户级别的 CLAUDE.md 文件在会话开始时读取一次并保存在内存中。在会话中期编辑它们不会使缓存失效,但编辑也不会生效。"新内容"在下次 /clear、/compact 或重启时加载。"
我在 2026-09-30 用 trafilatura 抓取了每个页面的完整文本。Trafilatura 丢失了表格和启动视图文本,所以我从页面的 markdown 版本中获取了这两部分,并对照其 HTML 进行了检查;措辞一致。
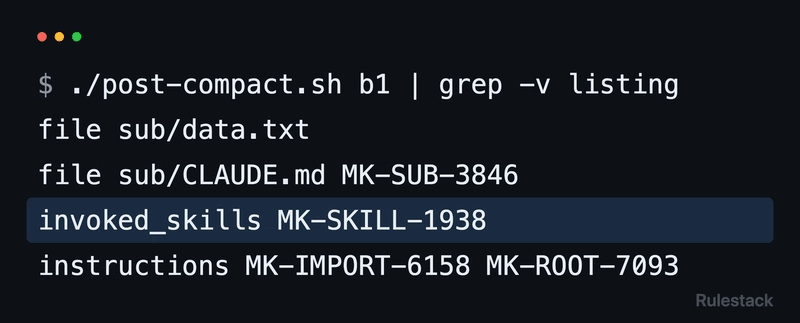
以下是单进程运行 B1 中在边界之后携带实验室文件回来的所有内容(过滤器隐藏了一行列表更新):
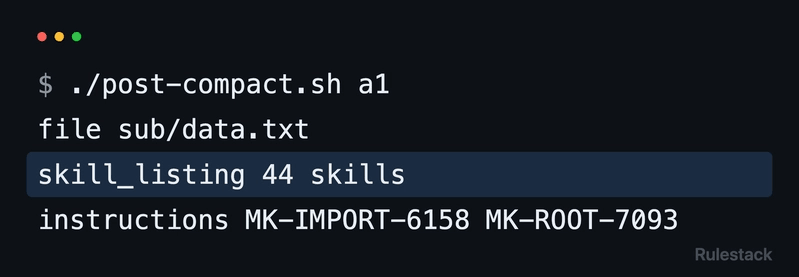
以及同一会话通过 --resume 压缩后的 A1:
根文件从磁盘回来,旁边是它的旧版本
在全部 8 次运行中,紧随压缩之后的第一次响应都携带了一个指令附件,其中 root CLAUDE.md 和 notes/imported.md 反映的是压缩那一刻磁盘上的状态。在 6 次有编辑操作的运行中,对应的是 7093 和 6158。未进行压缩的对照组 BC 验证了提示缓存页面:经过相同的编辑操作后,模型仍然只看到了 4417 和 2290。该页面的一句话将恢复操作计为重启。在 A 中进行的 fork 探测启动了一个全新的进程且没有经过压缩,它在一个附件中收到了新的 root 和 import,附件开头写道:"Instruction files were re-read when this session started; these differ from their earlier copies — each replaces its earlier copy"。
摘要是问题所在。全部 8 份摘要都列出了每个旧的标记,因此在 6 次编辑运行中,模型在压缩后持有两个 root codeword:摘要中的 4417 和文件中的 7093。携带新文件的附件没有说明替换任何内容,这与恢复的情况不同。全部 6 次编辑运行都注意到了这一点。A2:"要么文件变了,要么摘要有误。我从这里无法判断是哪一个。"B1 和 B2 也没有定论。C1 站在文件这边("上述文件内容才是值得信任的"),C2 也是,并解释说差距原因是"摘要可能把那五个值搞错了"。实际上摘要并没有错:它正确记录了那时已经改变的文件。A1 报告了不匹配,并指出只有新数字实际展示给了它。
在一个长会话中编辑 CLAUDE.md 然后压缩,正好创建了这种状态:新的文本在上下文中,旧的文本在摘要中被重述,而且没有任何东西使旧的文本失效。
在 B、C 和 D 中,在摘要和重新读取的文件之后,出现了一个 invoked_skills 附件,开头是:"The following skills were invoked EARLIER in this session (before the conversation was compacted), not on the current turn. They are shown here for context only so you remain aware of their guidelines."(以下技能在此会话的早期调用过——在对话被压缩之前,不是在当前轮次。它们仅作为上下文显示,以便你了解其指南。)后面跟着正文。这是记录在案的行为,6 次中 6 次都是如此。
但那是旧的正文。在 B 和 C 中,此时磁盘上的 SKILL.md 显示 MK-SKILL-5702,而重新附加的正文显示 1938。技能页面确实说了"最近的调用",所以这是技能运行时发送的副本,而不是重新读取。B1 和 B2 都注意到"技能 codeword 两处匹配。"确实匹配,因为两处都是旧的。
在 A 中根本没有 invoked_skills 附件。运行 /compact 的进程是用 --resume 启动的,而技能是在五个进程中的第一个里调用的。压缩后,技能的唯一痕迹是摘要中关于它的一句话。A1:"我不能再直接看到技能文件或 sub/CLAUDE.md 了,所以它们的 codeword 只来自摘要。"A2 用另一种说法表达了同样的意思。
A 得到的是技能列表。探测运行在另一个恢复的进程中,那个进程再次发送了完整的启动列表:44 个技能,约 19,000 个字符,标记为初始列表。在 B 和 C 中,压缩后的列表是一次性条目更新,只列出了 lab-skill,而 D 没有,这符合启动视图的"压缩后不重新注入"。在 A 中那句话不成立,因为新进程会发送自己的列表。压缩后的第一个请求在 A 中消耗了 22,676 和 22,776 个 token,而在 B 中是 18,748 和 18,950。
我没有阅读 Claude Code 的源代码,所以无法说调用记录存在哪里。观察到的规则足以制定应对方案:当压缩在与技能调用不同的进程中运行时,正文没有回来。
在 B 和 C 中,sub/CLAUDE.md 在摘要之后回来了,没有新的 Read,带着新数字 3846。它是如何回来的是有趣的部分。压缩之前,它作为内存附件到达,开头是 Contents of <lab>/sub/CLAUDE.md:(路径在此缩短)。压缩之后,它作为工具调用到达:"Called the Read tool with the following input: {"file_path":"<lab>/sub/CLAUDE.md"}",然后是"Result of calling the Read tool:"和带行号的文件。从未对该文件调用过 Read。五文件重新读取将嵌套的 CLAUDE.md 视为 Claude 读取的文件。在 C 中,路径作用域规则以相同方式回来,带着它的新数字 1409。两种记录在案的路径都没有涉及这一点。内存页面说嵌套文件"当 Claude 读取它们适用的文件时"重新加载,但没有发生这样的读取。上下文窗口页面说压缩"将它们总结掉",但在 B 和 C 中并没有。
无压缩的对照组指向同样的方向:在 BC 中,嵌套文件的编辑在下一轮就到达了模型,作为一条笔记,开头是"Note: <lab>/sub/CLAUDE.md changed on disk since you last read it.",而 root 文件的编辑根本没有到达。
D 测试了五个的极限。在读取了七个文件且 sub/ 文件被回溯的情况下,六个 other/ 文件中有五个回来了,sub/ 中没有任何内容:没有 sub/data.txt,没有 sub/CLAUDE.md,也没有路径规则。D1:"MK-SUB-6621:只在压缩摘要中。sub/CLAUDE.md 的内容本身不在我的上下文中。"六个 other/ 文件是在几毫秒内创建的,两次运行保留了不同的五个。D1 丢弃了最老的 f1.txt。D2 丢弃了 f3.txt,它与 f1.txt 和 f2.txt 共享修改毫秒,所以如果比较到毫秒级,记录的顺序成立;最后一部分是我的推断。在 A 中,只有 sub/data.txt 被重新读取,嵌套文件根本不在列表中,与技能的模式相同。
所以嵌套的 CLAUDE.md 在 8 次压缩中存活了 4 次,每次都是因为它是一个进程记得读取的五个最近修改的文件之一。对于一条规则来说,这是一个脆弱的依靠。
在 8 次压缩中,密码短语都在摘要中,不在其他任何地方,正如内存页面的"仅在对话中给出"案例所预测的。它每次都是原样输出,每份摘要三到五次,而且每份摘要都逐字引用了我的密码短语消息。我不会从中得出太多解读。实验室目录名为 compact-what-instructions-survive,文件称其字符串为 codeword,而且每份摘要都通过目的或目录名将会话识别为关于压缩后什么存活的实验室。一个知道正在测试什么的总结器会保留测试的字符串。将 8/8 视为最佳情况。
在 C 和 D 中,hook_success 附件跟在摘要后面:"SessionStart:compact hook success: Reinjected after compaction. Hook codeword: MK-HOOK-8316"(在 C 中,文件被编辑过),在 D 中是 MK-HOOK-2745(文件未被编辑)。钩子在压缩后运行,那时读取文件,所以像 root CLAUDE.md 一样,它传递的是磁盘上的内容,而不是启动时加载的内容。
其建议在所有测试的地方都有效。它遗漏的是技能,以及文件读取——一种工具输出——会回来。
以下来自上述运行。我没有测试每个改变是否在真实长会话中解决了问题。
将任何必须在压缩后保留的内容保存在 root CLAUDE.md、它导入的文件或无作用域规则中。这些每次都从磁盘回来了。
不要依赖嵌套的 CLAUDE.md 文件或路径作用域规则跨越压缩。它们只在是一个进程记得读取的五个最近修改的文件时才回来。
如果在会话中期编辑了 CLAUDE.md,预期模型在 /compact 后会看到摘要中的旧版本文本与新文件并列,没有说明哪个优先。通过 --resume 重启会添加明确的"each replaces its earlier copy"注释;压缩不会。
如果在会话中期编辑了 SKILL.md,在压缩后重新调用该技能。重新附加的正文是上次调用的副本。技能页面出于不同原因给出了相同建议:"在压缩后重新调用它以恢复完整内容。"
如果将压缩编写为脚本 claude -p "/compact" --resume <id>,预期调用过的技能之后会消失:重新调用它们,或者将整个会话保留在一个 --input-format stream-json 进程中。压缩钩子在 4 次单进程运行中都传递了它的文本,但我没有通过 --resume 运行它。
自动压缩。这里的每次压缩都是手动的 /compact。上下文窗口页面说"自动通过的工作方式与时间线中的 /compact 步骤相同"。我没有检查这一点。
其他入口点。没有交互式终端,没有 --continue,没有 Agent SDK 代码;只有 claude -p,恢复或流式传输。
--resume 下的压缩钩子。A 中钩子被禁用。
上限。只有一个小技能和小文件,所以每个技能 5,000 token 的上限、总共 25,000 token,以及超过 5,000 token 的文件作为引用回来,这些都没有被测试。
其他指令来源。没有用户级 CLAUDE.md、没有 CLAUDE.local.md、没有计划文件、没有附带焦点指令的 /compact,且每次运行中自动记忆均处于关闭状态。
服从性。探针询问的是模型能看到什么,而不是它是否遵从。
其他模型与实际体量。每个记录的请求都发往 claude-opus-5-5。会话在压缩前持有约 20,400 到 23,400 个 token,其中大部分是系统提示词和工具定义,所以压缩几乎没有缩小它们。
原因。恢复后的进程为何丢失了技能调用和嵌套文件,仅从转录文本推断。
线索。如上所述,总结器能看出测试的内容。
设置脚本写入版本 1 或 2 的四个文件:
#!/bin/bash
# usage: setup.sh <dir> <1|2>
set -euo pipefail
P="$1"; V="$2"
if [ "$V" = 1 ]; then ROOT=MK-ROOT-4417; IMP=MK-IMPORT-2290; SUB=MK-SUB-6621; SKL=MK-SKILL-1938
else ROOT=MK-ROOT-7093; IMP=MK-IMPORT-6158; SUB=MK-SUB-3846; SKL=MK-SKILL-5702; fi
mkdir -p "$P/notes" "$P/sub" "$P/.claude/skills/lab-skill"
filler() { for i in $(seq -w 1 "$1"); do echo "- Filler line $i for the $2 file. It asks for nothing."; done; }
{ printf '# Lab instructions (project root)\n\nRoot codeword: %s\n\n@notes/imported.md\n\n' "$ROOT"; filler 12 root; } > "$P/CLAUDE.md"
{ printf '# Imported notes\n\nImport codeword: %s\n\n' "$IMP"; filler 24 imported; } > "$P/notes/imported.md"
{ printf '# Lab instructions (sub directory)\n\nSubdirectory codeword: %s\n\n' "$SUB"; filler 36 subdirectory; } > "$P/sub/CLAUDE.md"
{ printf -- '---\nname: lab-skill\ndescription: Measurement skill for a lab. Only run it when the user types /lab-skill.\n---\n\nSkill codeword: %s\n\nWhen this skill runs, reply with exactly the word READY and nothing else.\n\n' "$SKL"; filler 48 skill; } > "$P/.claude/skills/lab-skill/SKILL.md"
[ -f "$P/sub/data.txt" ] || echo "This is a plain data file. It holds no codeword." > "$P/sub/data.txt"
形态 A。将 setup.sh 放在实验室目录外,这样模型不会意外发现版本 2 的数字,并使用 mktemp -d,这也能消除我运行中存在的目录名提示。$R2 和 $PROBE 分别保存了口令消息和上述探针:
SETUP="$PWD/setup.sh"; D=$(mktemp -d); SID=$(uuidgen | tr A-Z a-z)
S='{"disableAllHooks": true, "autoMemoryEnabled": false}'
F=(--output-format json --settings "$S" --strict-mcp-config)
"$SETUP" "$D" 1 && cd "$D"
claude -p "/lab-skill" --session-id "$SID" --max-turns 1 "${F[@]}"
claude -p "$R2" --resume "$SID" --allowedTools Read --max-turns 3 "${F[@]}"
"$SETUP" "$D" 2
claude -p "$PROBE" --resume "$SID" --fork-session --max-turns 1 "${F[@]}"
claude -p "/compact" --resume "$SID" --max-turns 1 "${F[@]}"
claude -p "$PROBE" --resume "$SID" --max-turns 1 "${F[@]}"
形态 B 是一个通过 stdin 供料的单进程。Node 驱动的核心部分:
const child = spawn('claude', ['-p', '--input-format', 'stream-json', '--output-format', 'stream-json',
  '--verbose', '--session-id', sid, '--allowedTools', 'Read', '--max-turns', '3',
  '--settings', settings, '--strict-mcp-config'], { cwd: dir })
// send() 将 {"type":"user","message":{"role":"user","content":text}} 作为一行写入 stdin
// 并在从 stdout 收到下一条 {"type":"result"} 行时 resolve
await send('/lab-skill')
await send(r2)
execFileSync(setup, [dir, '2'])
await send('/compact')
const answer = await send(probe)
child.stdin.end()
以及两张图片背后的过滤器,它在每个边界之后打印附件,并附上模型收到的文本中发现的标记(每条记录的 rendered 字段):
T=$(find ~/.claude/projects -name "$SID.jsonl" | head -1)
awk 'f; /"subtype":"compact_boundary"/{f=1}' "$T" \
 | jq -r 'select(.type=="attachment") | .attachment as $a
   | select(["file","invoked_skills","instructions","skill_listing","hook_success"] | index($a.type))
   | [$a.type, ($a.displayPath // (if $a.type=="skill_listing" then "\($a.skillCount) skills" else "" end)),
      ((.rendered|tostring) | [scan("MK-[A-Z]+-[0-9]{4}")] | unique | join(" "))]
   | map(select(. != "")) | join(" ")'
数字,记录在此
preTokens、postTokens 和压缩时间来自 compact_boundary 记录。"压缩后首次请求"是探针首次模型请求的输入 token 加上缓存读取和缓存创建的 token,其中每次运行都有 11,431 到 11,547 个 cache reads(固定前缀的缓存读取)。压缩前的最后一次请求在 A 和 B 中为 23,394 个 token,在 C 和 D 中分别为 20,393 和 21,594 个 token,因此压缩使下一次请求减少了 618 到 718 个 token(A)、4,444 到 4,646 个 token(B)、约 410 个 token(C)和约 3,090 个 token(D)。重新发送的约 19,000 字符的列表是 A 有而 B 没有的最大东西,但我没有逐个称量附件。两个 BC 对照组(无压缩)发送了 23,938 个 token 带探针。Claude Code 报告所有 18 个进程共计 2.73 美元;恢复的进程会报告其会话的运行总计,因此每个会话在该数字中被计算一次。
Rulestack 为 Claude Code 制作规则文件、技能和钩子,并在 rulestack.gumroad.com 销售。整个实验室只是一个设置脚本、一个探针消息和一个 jq 过滤器,足够便宜,可以在发布说明提到压缩时随时重新运行。
如果 --resume 在后续版本中保持了技能存活,请在下方评论中说明,并关注 @ai-shop.bsky.social 以获取本系列的下一项测量结果。