前端进阶之旅前端进阶之旅
基础篇
进阶篇
高频篇
精选篇
手写篇
面经篇
AI 篇
原理篇
每日一题
小程序题库
知识卡片
  • 场景篇按分类整理的大前端场景考点
  • 历年面经按年份追踪真实考点
  • 算法题库NEW在线编码即时判题
  • 专项自测100 题快速查漏
  • 前端基础
    • HTTP从报文一路讲到 HTTPS
    • 浏览器渲染、事件循环、进程
    • 计算机基础Linux、网络、操作系统
  • 进阶专项
    • 设计模式23 种模式怎么用
    • 前端系统进阶学习大型项目工程化
    • 前端综合文章长期沉淀的实践文
  • 工程与工具
    • Node学习指南从环境搭建到服务端
    • NPM工作流script、依赖与发布
    • Docker容器化部署上手
    • Canvas图形与动画实战
  • 路线与导图
    • 思维导图知识点全景图
    • 学习路线按图索骥不跑偏
  • 动态
    • 公众号动态公众号历史文章
    • 博客动态站长的技术博客
    • 开发者导航常用工具与文档站
  • AI 助手随时提问,即时解析
  • AI 模拟面试模拟真实面试 + 报告
  • AI 知识地图串起全站知识点
  • AI 定制路线按你的简历现排
AI 热点
旧版
返回 AI 情报前线
All News · 全部资讯9375
  • Harness决定AI Agent能力:同模型不同表现
  • Claude Code权限绕过:Read拒绝后Bash仍可读取
  • 生产级Agent系统实战:LLM路由、Prompt合约与PR安全审查
  • LCLM:16倍压缩的潜在上下文语言模型
  • Claude Code mods解析:何时需要构建插件
  • Linus确认Linux内核进入「AI新常态」
  • 如何验证Agent实际完成了它声称的任务
  • Claude Code /compact 后哪些内容真正存活
  • 开源安全模型 apex-flash-1:60 个遗留 Bug 任务解出 40 个
  • yOGI Neural Grid:强制验证模型引用来源的工程实现
  • 美团开源LongCat-Video:13.6B参数统一视频生成模型
  • Agent技能需要包管理器而非仅靠Prompt
  • n8n AI Agent 生产环境失败根因与修复方案
  • 565 行 Python 从零实现编程智能体
  • 四大前沿模型横向评测:Astra擅计算机使用、Argon强法律金融、Sol价格最优
  • 本地RAG开发113个评估问题后的实战总结
  • AI重写让我重新审视运行时成本:Node.js转Go/Rust的算账
  • MCP工具超90个时的平台化架构设计
  • Homa:专为AI集群设计的TCP替代网络协议栈
  • 我为编码Agent的测试篡改问题做了个AdversaryGate
  • SaaS支持文档检索应选语义嵌入而非关键词
  • AI 审核员知道太多会变差:验证者应不知情
  • 长文档JSON提取超时?先做好输入分片而非调大timeout
  • PostgreSQL pgvector混合搜索实战:向量相似度+全文关键词融合
  • 新版Claude不再需要"Think Step by Step":Osmani提示指南解读
  • CodeSmith三区架构:解决prefix drift导致Token重计费问题
  • 像读流水线一样读Transformer Block
  • Cloudflare OS:面向 AI 原生的企业工作台开源
  • AI 编程工具正在泄露凭据:Cursor、Claude Code、Copilot 和 MCP 均有风险
  • prompt-shelf:在 Claude Code 里暂存草稿、临时想法和常用 prompt
  • Agenshive:AI agent 专属 Q&A 平台,用执行验证替代投票
  • 评审容量已成交付新瓶颈:打字快不等于交付快
  • AI Agent 让 CI 成为瓶颈,加速流水线是错误解法
  • Claude Code Mods 沙箱机制深度解析
  • 已加载 34 / 9375
9.0
重磅
AI SCORE
模型发布2026-10-05 12:33

LCLM:16倍压缩的潜在上下文语言模型

dev.to · AI#大模型#上下文压缩#论文
Editor brief · 编辑速览

NYU等机构联合提出LCLM,在解码前先压缩输入16倍,在所有测试比例上均超越现有方法,百万token上下文可在单卡H200内存内容纳。

文章思维导图
Knowledge map
拖拽缩放
Full translation

完整中文译文

你的 agent 的 context window 就是一个持续燃烧的成本炸弹。每检索一份文档、每一条 reasoning trace、每一次对话回合,都会产生 token——而 token 的成本是二次方增长,不是线性的。本周,NYU、Columbia、Princeton、UMD、Harvard 和 Lawrence Livermore 的团队发布了一个真正能撑过生产环境的方案:Latent Context Language Models(LCLM)。它在 decoder 看到输入之前就将输入压缩了 16 倍——且在所有测试的压缩比上都超越了现有方法。

ELI5:为什么 context 是瓶颈

把模型的 context window 想象成桌面空间。Attention 意味着每个新 token 都要查看之前所有的 token——所以 context 翻倍,大约会让计算量和内存都变成四倍。标准的技巧——KV-cache 压缩——就像是先把整张桌子复印一遍,然后再扔掉页面。你仍然要支付完整的前置成本。

LCLM 翻转了这个顺序:先压缩,后解码。在 100 万 token 时,未压缩方案在单张 H200 GPU 上就会耗尽内存。LCLM 在 16 倍压缩下依然游刃有余。

架构采用 encoder-decoder 分离设计:

  • 一个 0.6B encoder 读取输入 token 的块,将每个块压缩成一小序列的 latent embeddings——这些是学习到的"摘要向量",代替原始文本。
  • 一个 4B decoder 处理这些 latent embeddings,而非原始 token。它永远不会看到完整的序列。

训练在 350B+ tokens 上进行,采用三部分配方:压缩和未压缩片段交错的持续预训练、在推理和长上下文任务上的监督微调、以及一个强制 encoder 保留细粒度细节的辅助重建任务。最后一个成分是关键所在:早期的压缩工作在优化忠实重建时总是会损失任务性能。这套配方两者兼顾。

架构搜索证实了 scaling 规则:扩展 decoder,而不是 encoder。更大的 encoder 几乎没有任何帮助。

对于 RAG 堆栈,集成方案很简单——在你当前将检索到的文档塞入 context 的任何地方换入 LCLM。只需先将文档通过压缩器。论文还演示了能够选择性解压缩有用片段的 agent——快速浏览,聚焦相关内容。

State of the art:数字说话

在 RULER 长上下文基准上:

  • 4 倍压缩:91.76% 准确率 vs 未压缩的 94.41%。context 缩减到原来的四分之一,准确率仅下降 2.65 个点。目前生产环境中的其他方法在这个权衡面前都相形见绌。
  • 16 倍压缩:75.06%——输入 token 减少了 93.75%。在同一压缩比下测试的所有 KV-cache 方法得分都更低。
  • 在 RULER 上 16 倍压缩时比 KV-cache 基线快 8.8 倍——因为节省的是 decoder 端的计算和内存,而不仅仅是存储。

在 GSM8K 上,当整个 prompt 被压缩而非仅检索文档时,LCLM 在每个压缩比上都超越了其他方法。

两个事实让这成为生产故事而非基准故事。首先,压缩发生在 decoder prefill 之前,所以这个比率直接转化为标准服务基础设施上的真实加速——不同于那些在驱逐条目前仍然物化完整 KV cache 的方法。其次,模型是开放的:HuggingFace at latent-context,代码在 GitHub(LeonLixyz/LCLM)。

坦诚的差距:reasoning-trace 压缩仍未解决。对于具有长思维链的 agent,trace 本身的 context 增长是一个独立的问题——团队表示定期 trace 压缩"可能有效,但这仍有待确定"。将这个集成到现有 RAG pipeline 的团队需要在发布前根据压缩行为重新调优检索质量指标。

  • Prefill 前压缩,而不是之后。 Decoder 端压缩是论文数字和生产加速之间的区别。
  • 4 倍压缩现在在长上下文任务上仅花费 2.65 个准确率点。 质量/压缩前沿本周移动了。
  • 扩展 decoder,而不是 compressor。 Encoder 大小对最终准确率几乎无关紧要。
  • 重建训练使其通用。 忠实度和任务性能不是权衡——如果你同时训练两者。
  • 未完成:在线 reasoning-trace 压缩。 密切关注这个领域——对于长时间运行的 agent 来说,这是下一个墙。

Paper: End-to-End Context Compression at Scale(arXiv 2606.09659)。模型在 HuggingFace 上开源,代码在 GitHub。

Diagram 1 — 为什么 context 是瓶颈 — attention 成本和内存 vs. context 长度
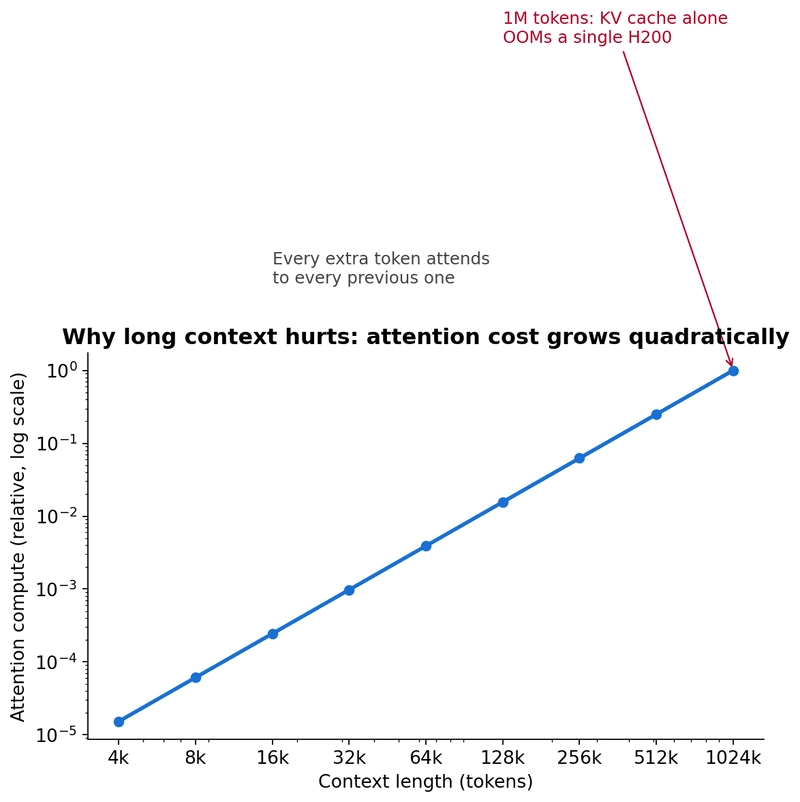
Diagram 1

Download: diagram-1-context-cost.png

Diagram 2 — LCLM 架构 — encoder 将块压缩成 latent embeddings,decoder 读取这些
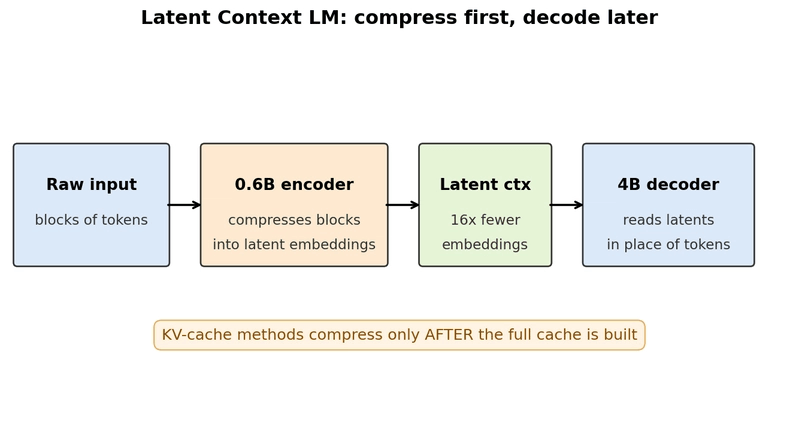
Diagram 2

Download: diagram-2-lclm-architecture.png

Diagram 3 — RULER 基准 — 4 倍和 16 倍压缩下的准确率 vs. 基线
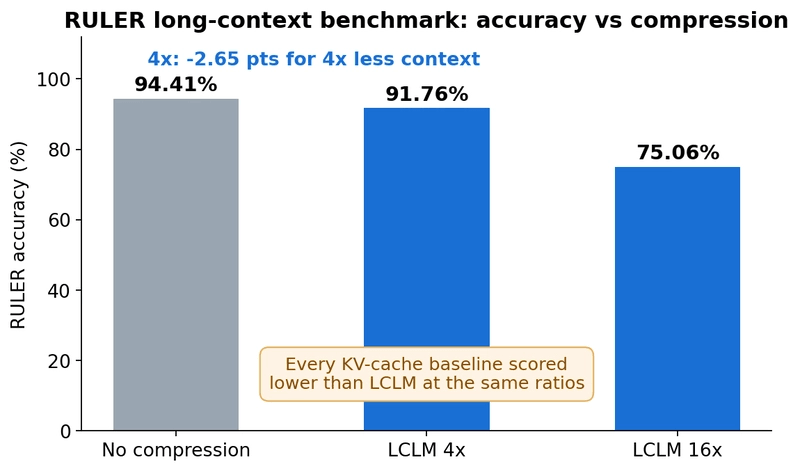
Diagram 3

Download: diagram-3-ruler-benchmark.png

Diagram 4 — 速度和内存 — 16 倍下的输出加速和内存节省
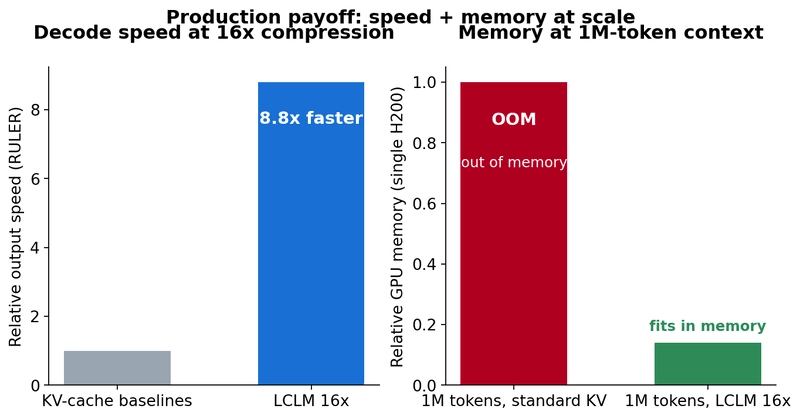
Diagram 4

Download: diagram-4-speed-memory.png

Companion notebook:这篇文章的可运行教程——在这里下载(用 Colab/Jupyter 打开)。

Original source

本文由 AI 翻译整理自 dev.to · AI,原文版权归原作者所有。

阅读英文原文
上一篇
生产级Agent系统实战:LLM路由、Prompt合约与PR安全审查
下一篇
Claude Code mods解析:何时需要构建插件