
8.0
热点
AI SCORE
技术实践2026-10-05 22:56
AI Agent测试用例:合成数据vs生产数据对比
dev.to · AI#AI Agent#测试#数据
Editor brief · 编辑速览
对比发布前用合成数据测试与发布后收集生产数据两种来源的优缺点,指导Agent测试策略。
在评估一个 Agent 之前,你需要有东西来作为评估的基准。你能得到哪些测试用例,很大程度上取决于时机。上线之前,你用来测试的一切都是团队自己构思的;上线之后,你的用户会开始为你编写测试用例,无论你是否主动收集。
这篇文章对比了主要的数据来源,并展示这些来源的组合如何随着 Agent 的成熟而变化。末尾有演示视频。
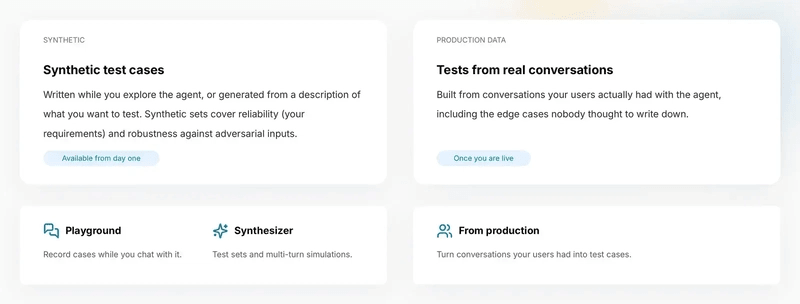
合成测试用例(Synthetic test cases)是指你自己创建的用例。你可以在 Playground 中探索 Agent 时编写它们,或者根据你想要测试的内容描述来生成它们。这类用例从第一天起就可以使用,是覆盖可靠性(Agent 是否满足你的需求?)和鲁棒性(是否能抵御越狱、提示注入和其他对抗性输入?)的主要手段。
来自生产数据的测试则来自真实用户与 Agent 的对话。其中包含了团队中没有人想到要记录下来的边界情况。但这类用例只有在你上线之后才能获取。
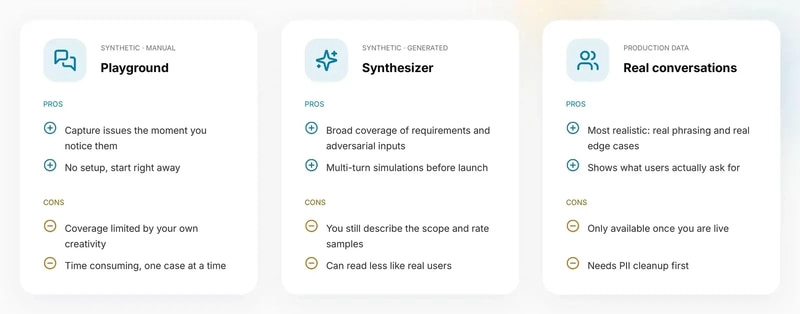
最快的起步方式。你与 Agent 对话,当它出错时,就把这段对话保存为测试用例。比如你的理赔助手告诉客户有 30 天可以提交,而你的政策规定是 14 天——这个对话只需几次点击就能变成一个回归测试。
局限性在于你自己。覆盖率只能达到你所能想到的场景,而且一个一个地记录用例也比较耗时。
你描述你想测试的内容,例如"用户询问取消期限的问题,包括试图让 Agent 承诺它无法给出的退款"。对几个样本进行标注让生成器学习你的意图,然后你就能得到一整套测试集。这同样适用于多轮模拟,即模拟用户不是在单个提示中,而是在多轮对话中推动 Agent。
你可以在没有任何用户接触过 Agent 之前,就获得对你的需求和对抗性输入的广泛覆盖。不过你仍然需要定义测试范围并审查样本。而且生成的输入往往比真实输入更干净——真实用户会打错字,也会在一条消息里问好几件事。
没有任何东西比用户实际输入的内容更真实。生产环境对话向你展示真实的措辞和真实的边界情况,并告诉你人们希望从 Agent 那里得到什么——这并不总是规格说明书所假设的那样。
但有两个问题:你需要已上线,而且通常你希望在用户发现问题之前就找到问题。另外,真实对话包含个人数据,在成为测试用例之前需要清洗。对于欧洲的团队来说,这更多是一个 GDPR 问题而非纯粹的技术问题。
以上所有步骤都不需要通过 UI。Rhesis MCP server 向 Claude Code、Cursor 和其他 MCP 客户端暴露了合成器和你的生产轨迹。粘贴一份产品规格,Agent 就会提出需求、指标和测试集,在你批准后创建它们。或者让它读取最近的轨迹,把值得保留的对话转化为测试用例。
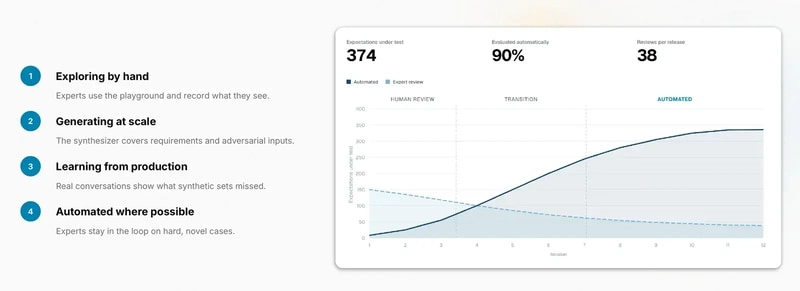
实践中,大多数团队最终会三种方法都用,大致按以下顺序:
手写探索。 在最初几轮迭代中,领域专家使用 Playground 并记录他们看到的东西。这是你最初期望的来源。
规模化生成。 一旦需求稳定下来,合成器和模拟器承担了大部分工作量,系统地覆盖需求和对抗性输入。
从生产中学习。 上线后,真实对话向你展示合成集合遗漏了什么。来自生产环境的一次失败也是生成新的合成变体的好种子。
尽可能自动化。 常规检查自动运行。专家在困难、新颖的用例上保持参与。
在视频中,我逐一演示了 Rhesis 中的每种方法,从 Playground 中记录的第一个用例,到从生产对话构建的测试用例。
Rhesis 是开源的。你可以在 app.rhesis.ai 上试用,也可以从 GitHub 自行托管。
最初发布于 Rhesis 博客。
你是如何为你的 Agent 获取测试用例的?主要是合成数据、主要靠生产数据,还是完全不同的方式?我很想在评论区听到你的看法。