
8.0
热点
AI SCORE
编程提效2026-10-05 12:39
Harness决定AI Agent能力:同模型不同表现
dev.to · AI#AI Agent#架构设计#LLM
Editor brief · 编辑速览
相同的LLM权重在不同的harness(上下文管理、工具接口、恢复逻辑)下,基准测试分数可从28%到49%不等,2026年行业终于承认wrapper是决定性变量。
换掉 AI Agent 中的模型,你会期待它变得更聪明。换掉 Harness(循环、上下文管理器、工具接口、恢复逻辑),同样的权重在一个基准上得 28 分,在另一个上得 49 分。2026 年,业界终于不再假装模型就是 Agent。证据表明:wrapper 才是变量。
ELI5:厨师与厨房
把语言模型想象成一位天赋异禀的厨师。Harness 就是围绕他的整个厨房:菜谱夹(上下文)、 pantry 和工具(工具接口)、操作台(状态)、火灾报警器和灭火器(护栏)、写着"停止装盘、上菜"的计时器(停止规则),以及记录一切发生的卫生检查员(追踪/审计)。
把这位厨师放进井井有条的商业厨房,就能完成晚市服务。把同一个厨师放进一间漆黑的屋子,只给一把黄油刀,什么都做不出来——不是因为厨师变了,而是因为厨师赖以行动的一切都不在了。Harness 就是那个厨房:它决定了模型能看到什么、能触碰哪些工具、失败后如何继续、以及何时停止。模型是最简单的部分。厨房才是困难的部分。
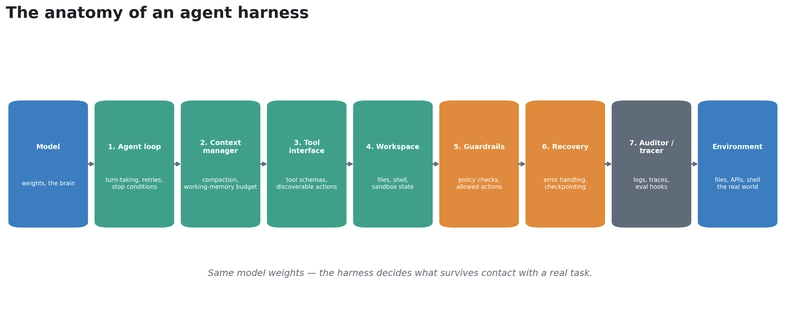
每个生产级 Agent 都是一个循环。模型提出建议,Harness 执行。具体来说,Harness 有七项职责:
Agent 循环。调用模型 → 解析其动作 → 运行工具 → 将结果反馈 → 重复。写起来trivial,保持运行却暗藏危险:一个连续运行 3 天的循环必须能扛住进程重启。
上下文管理。上下文窗口是有限的且昂贵的。Harness 构建提示词、在窗口填满时压缩或精简旧的对话、缩短过时的工具输出。上下文重置拯救了弱模型,但用在强模型上就成了纯开销——所以策略必须适配模型。
工具接口。工具如何声明、参数如何验证、结果如何返回和截断。一个糟糕的工具 schema 可以在重试循环中烧掉数千 tokens。
工作区状态。Agent 修改的文件、数据库和暂存空间。Harness 对其做版本管理、隔离(沙箱化),并使其可恢复。
护栏。权限、对不可逆操作的审批门控、迭代上限。这是问责层:推理能力的提升不会把模型的置信度变成修改账本的权限。
恢复。当工具挂起、API 返回垃圾数据、或任务在第 6 小时(共 8 小时)中断时会发生什么。带退避的重试、兜底路径、能从中断处恢复的持久会话。
审计与追踪。每一步操作都记录在案,每个产物都对照输出契约验证。没有这个,你无法调试 Agent——也无法信任它。
缺少任何一个,模型都帮不了你。这就是为什么预计到 2027 年底 40% 的 Agentic AI 项目将被中止(Gartner,2026 年 9 月行业报道):不是因为模型弱,而是因为 Harness 没搭好。
北京大学和启元科技的研究人员构建了一个诊断基准:106 个沙箱化、人工审查的任务(来自真实 Agent 使用模式),5194 条执行轨迹,在相同任务和预算下跨模型-Harness 配对进行比较。结果:完成度、效率和失败行为存在显著差异——驱动力来自 Harness,而非权重。他们的结论是年度金句:Agent 能力应该在"模型-Harness 配置"层级上报告,而不是单独归因于基础模型。配套分析指出,在共享任务上,最佳与最差可配置 Harness 之间存在 23.8 个百分点的差距。
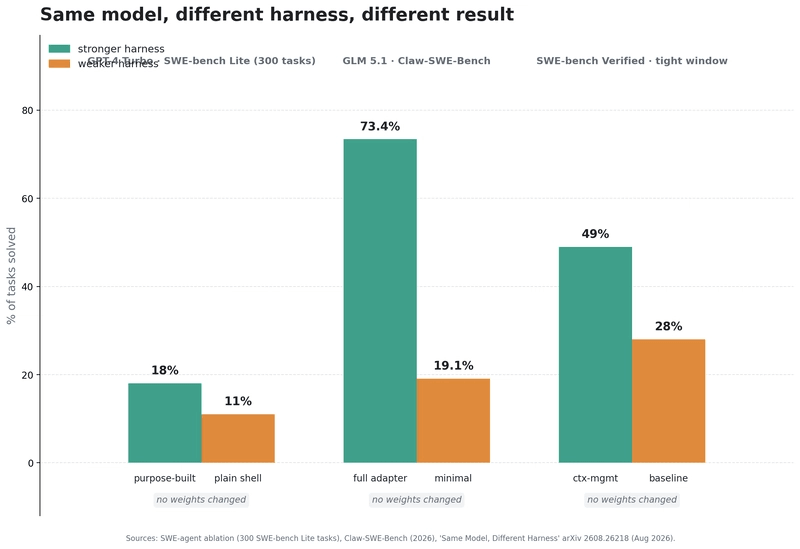
消融实验很残酷。固定模型,只改变 wrapper,分数剧烈波动:GPT-4 Turbo 在专用代码库接口上解出了 18.0% 的 300 个 SWE-bench Lite 任务,但仅用普通 shell 时只有 11.0%。在同一 GLM 5.1 主干上,最小适配器对完整适配器在 Claw-SWE-Bench 上得分 19.1% 对比 73.4%。在"Same Model, Different Harness"(arXiv 2608.26218,2026 年 8 月)中,一个纯机械的改动——在上下文填满时缩短旧的工具结果,加上卡顿检测——把 169 个 SWE-bench Verified 任务的平均 fail-to-pass 比例从 28% 提升到 49%,完整解决方案从 43 个增加到 72 个。权重没变。Wrapper 移动了分数。(坦诚的反例:使用强长上下文模型和完全可观测的环境,简单的脚手架就在 SWE-bench Verified 上达到了 50.8%——补偿弱推理的脚手架会随着模型改进而缩小。承担问责的控制项则不会。)
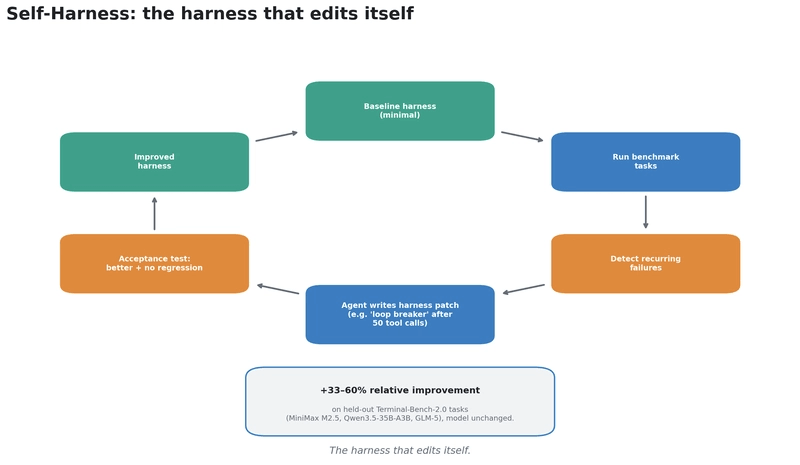
Self-Harness(arXiv,2026 年 9 月 VentureBeat 报道)让 Agent 重写自己的运行时规则。从 DeepAgent SDK 上的一个最小 Harness 开始,它运行 Terminal-Bench-2.0 任务,检测反复出现的失败模式,然后写出针对性补丁——例如,某个模型一直在探索数据集配置直到超时,所以系统写了一个"循环破坏者",强制它在 50 次工具调用后停止并提前产出交付物。在 MiniMax M2.5、Qwen3.5-35B-A3B 和 GLM-5 上的留出相对提升:33–60%——模型、工具和基准保持不变,只有 Harness 在变化。关键设计细节:验收规则只晋升那些能改善失败且不造成其他任务回归的编辑。
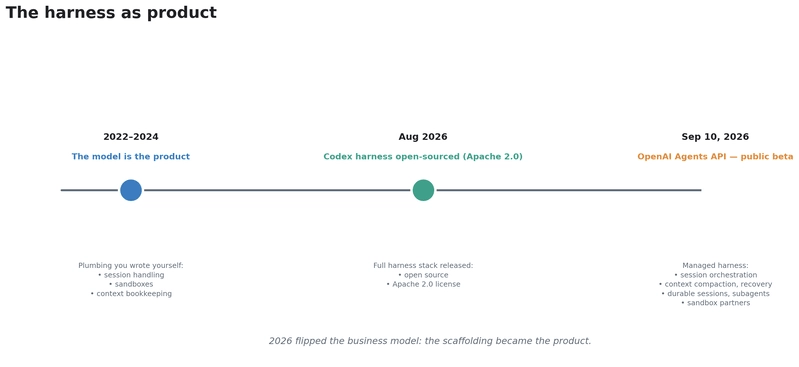
2026 年 9 月 10 日,OpenAI 以公开 beta 形式推出了 Agents API:托管的 Codex Harness——会话编排、自动上下文压缩、恢复、可持续运行数天的持久会话、沙箱(OpenAI 托管、自托管或通过 Cloudflare、Modal、Vercel 等合作伙伴)、子 Agent 并行化(Ciridae CTO 报告延迟降低 4 倍)、MCP 和自定义工具连接。一次 API 调用即可启动生产级 Agent;你只需为 tokens 和沙箱分钟付费,不收 Harness 费。战略解读在 OpenAI 于 2026 年 8 月将 Codex Harness 以 Apache 2.0 开源时已经明确:把规范免费送出去,卖运营版本。Gartner 预测到 2026 年底,40% 的企业应用将包含任务专用 AI Agent(2025 年还不到 5%)——现在供应商竞争的是谁搭的厨房最好,而不是谁训练的厨师最棒。
Harness 是变量,不是细节。把它当模型一样做预算:循环、上下文策略、工具接口、工作区、护栏、恢复和审计,才是 Agent 项目成败之所系。
报告模型-Harness 配对,而非模型。没有 Harness 名称的基准分数,就像评价厨师却只字不提厨房。
上下文管理是杠杆最高的层级。在 2026 年的研究中,压缩、陈旧输出缩短和卡顿检测比任何其他单一改动更能移动分数。
区分补偿与问责。支撑弱推理的脚手架会随着模型改进而缩小。护栏、权限和审计永远不会——没有模型增益会把置信度变成行动的授权。
先买或借,再自建。有了托管 Harness(Agents API)和开源的生产级 Harness(Codex,Apache 2.0),自定义编排现在是风险选项而非安全选项——而你的评估负担(任务级 evals、证据产物)无论哪种方式都是你的。
Harness-Bench: Measuring Harness Effects across Models in Realistic Agent Workflows (arXiv 2605.27922, May 2026, Peking University / Qiyuan Tech) · Same Model, Different Harness: Different Coding-Agent Results (arXiv 2608.26218, Aug 2026) · Self-Harness (arXiv, reported via VentureBeat, Sep 2026) · OpenAI Agents API public beta (announced Sep 10, 2026; Codex harness open-sourced Apache 2.0, Aug 2026) · Towards AI Fryday #8: 10 Agent Harnesses That Change What the Same Model Can Do (Sep 2026) · Oracle Developers: Building an agent harness that survives production (2026) · Gartner enterprise-agent forecasts via Sep 2026 coverage.
配套 Notebook:本文的可运行教程——在这里下载(在 Colab/Jupyter 中打开)。