
9.0
重磅
AI SCORE
编程提效2026-10-05 04:19
本地RAG开发113个评估问题后的实战总结
dev.to · AI#RAG#本地部署#Ollama
Editor brief · 编辑速览
作者记录了从头构建本地RAG(Ollama+Qdrant+Postgres)的完整实验日志,证明在CPU上跑Llama3可达98%准确率,中位响应48秒/次,并揭示了哪些常见优化手段实际无效。
我构建了 LocalCortex,一个完全在笔记本上运行的文档聊天应用:
模型层用 Ollama, 聊天历史用 Postgres, 用户上传 PDF、Word 或 Markdown 文件后提问,系统返回带来源的答案。如果答案不在文档中,它会拒绝回答而不是胡编乱造。
但应用本身并不是真正有趣的部分。
真正有趣的是,发现几乎每个听起来"这肯定会让它更好"的想法,要么完全没起作用,要么让情况变得更糟,要么需要花大量时间在数字里翻找才能弄清楚它到底有没有帮助。所以我在大部分功能之前就写好了 eval,并记录了每一次尝试的实验日志。
这篇文章是那个日志的精简版。
最终结果:在 62 道题的生产风格测试中,逐一手工阅读每一条回答,其中 61 条正确(98%),全部 14 道无关话题的提示都被正确拒绝。
速度方面,每次查询的中位回答时间是 48 秒。算不上快,但在 CPU 上跑 Llama 3 大概就是这样。
以下是达到这个效果的方法,以及没有效果的。
两个 eval 数据集:一份手写的 20 节员工手册,包含 58 道题(含故意设计来混淆检索的近似重复"干扰"章节),以及一个更大的 4 文档、最初 208 个 chunk 的政策语料库,包含 55 道题。共计 113 道题。
两个 eval 数据集:一份手写的 20 节员工手册,包含 58 道题(含故意设计来混淆检索的近似重复"干扰"章节),以及一个更大的 4 文档、最初 208 个 chunk 的政策语料库,包含 55 道题。共计 113 道题。
指标:检索用 Recall@1/3/5 和 MRR,拒绝用幻觉压力测试,后来又加上了人工评分的回答检查。
指标:检索用 Recall@1/3/5 和 MRR,拒绝用幻觉压力测试,后来又加上了人工评分的回答检查。
模型:nomic-embed-text 做嵌入,llama3 8B 生成最终答案,均通过 Ollama 调用。
模型:nomic-embed-text 做嵌入,llama3 8B 生成最终答案,均通过 Ollama 调用。
所有人都说要在嵌入旁边加上 BM25。我加了。每个 Qdrant 点都有一个稠密向量和一个稀疏向量,用 RRF 融合。
手册的结果:
稠密:56/58 在 rank 1 正确。
强化了关键词匹配、缩写处理、排序和相关性过滤后:55/58。
我的理论是手册太小,BM25 帮不上忙,于是构建了更大的语料库。混合搜索反而更差了。
加上缺失的 EAP 扩展后,混合搜索从 43/55 提升到 47/55,把整个 rank-1 差距补回来了。
那为什么混合搜索会输,明明它包含了稠密排序?
因为 RRF 融合的是排名位置,不是分数。
如果稠密排名第一的结果只是勉强赢了第二个,RRF 看到的是 rank 1 和 rank 2。如果排名第一的结果把第二个彻底碾压,RRF 仍然只看到 rank 1 和 rank 2。
这意味着一个带噪声的稀疏排序可以跳进来,翻转稠密搜索本来非常有信心的结果。
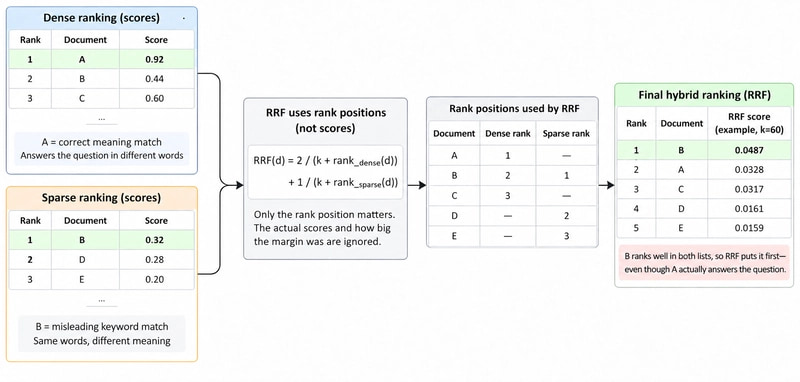
教训:混合搜索意味着额外的存储、额外的记账逻辑、额外的排序逻辑,而且自然会带来额外的检索出错方式。
在这些文档上,这套额外的 machinery 没有给我带来任何 rank-1 的整体提升。稠密和混合最终都是 105/113。
所以 LocalCortex 默认使用稠密搜索。混合搜索仍然在,但它是可选的。
这个有点伤人。
nomic-embed-text 训练时用了任务前缀:问题前加 search_query:,待索引文本前加 search_document:。
我之前在发送原始文本。添加前缀后得到这样的结果:
加前缀后,稠密和混合打成平手,都是 105/113。但更有趣的是相似度分数发生了什么。前缀把正确 chunk 的分数推高了。用我之前的 0.7 相关性阈值,被错误拒绝的有效 chunk 数量:
手册从 16 降到 7, 大语料库从 8 降到 3。
所以是的,在尝试了更多花哨的东西之后,最大的改进之一基本上就是加了两个字符串。
RAG 应用应该在没有相关内容时拒绝回答。
我的相关性阈值是 0.7。为什么是 0.7?因为 0.7 看起来合理。非常科学的做法。
于是我终于用 39 道不相关问题来正确测量它:10 道常识题如"法国的首都是什么?",以及 29 道问的是文档中根本没有的信息的问题。
Top-1 相似度范围如下:
可回答的问题:0.640–0.908 常识题:0.419–0.567 关于缺失信息的问题:0.514–0.739
在 0.7 时,我的阈值显然有点过于挑剔,把 9 道本可回答的 113 道题挡在门外了。降到 0.63 后让所有人都进来了,同时成功把随机的常识题挡在门外。当然,近似问题仍然试图混入,分数与真实问题一样高,这说明一件事:阈值不是万能的。在一次单独检查中,模型正确拒绝了收到上下文的全部 15 道此类问题。
教训:阈值是一个测量值。选定之前先画出分布,并且知道它无法捕获哪些失败。
模型并没有被告知哪些问题是在问缺失的信息。它把每个问题与检索到的段落进行比较。
提示词告诉模型只用提供的段落回答,当段落不支持答案时说信息不足。
假设文档告诉我们鸣人成为了第七代火影,但完全没有提到他的薪水。
问:"鸣人成为了哪一代火影?"很简单。答案就在里面。
问:"鸣人作为火影赚多少钱?"这时应该拒绝。文档可能讲的是鸣人成为火影,但从未告诉我们他赚了多少钱。
这基本上就是那 15 道题发生的情况。
检索到的段落与主题相关,但不包含具体答案。按照提示词,模型正确地说信息不足。这是那次测试的结果,不是它永远会这样决定的保证。
幻觉测试问 10 道文档不回答的问题,检查模型是否拒绝它们。
每次运行都返回:0/10 通过。
自然,我以为是模型的问题。
模型正确地在拒绝。我的正则表达式在找"insufficient context"和"couldn't"这类短语。与此同时,模型在说"the provided context is insufficient"和"I could not find"。
同样的拒绝。不同的措辞。我的评分器有自己的看法。
它偶尔还会看到问题中重复出现的词,比如"parking reimbursement",然后判定这是模型捏造的证据。
在调试过程中,发现了另一个惊喜:18 个集成测试因为 Vitest 在服务检查运行前就评估了 skip 条件,所以一直被跳过。
一旦这些测试真正开始运行,它们立刻发现了 4 个使用了无效 Qdrant point ID 的 case。
教训:测试你的测试。一个坏的评分器给出的绿色或红色数字,比没有数字更糟糕。
对话记忆让后续问题生效。
"那五年之后呢?"
孤立地看,这基本毫无意义。
简单的修复是把上一个问题与当前问题一起嵌入。
后续问题找到正确章节从 4/13 提升到 12/13。
然后它把拒绝搞坏了。
假设上一个问题是关于休假政策的,下一个问题是:
"法国的首都是什么?"
孤立地看,这个问题得分 0.479。
结合上一个休假问题,得分 0.682。
我的相关性阈值是 0.63。
恭喜巴黎,现在它显然属于员工手册了。
全部 6 道不相关后续问题都泄露进来了。
我加了一道第二关卡:当前问题单独也必须过 0.57。
测试的常识题中最高得分是 0.567,所以 0.57 就是我实际观察到的范围内最小的取整阈值。
10/13 后续问题正确。
但我不能把所有问题都过一遍重写器。
在一个早期测试中,在一段关于某人雇佣情况的对话后,我问:
"法国的首都是什么?"
Llama3 把它重写成了:
"他的雇佣期是什么时候?"
它基本上看着我这个完全不相关的新问题说:"不,我们还在聊之前的事。"
所以现在我只在问题看起来确实在回指早期上下文时才重写,并且拒绝那些丢弃用户原始措辞过多的重写。
加上这些护栏后:
11/13 后续问题正确。
教训:每个让回答更容易的功能,似乎都会找到一种创意十足的新方法让拒绝变得更难。两个都要测量。
一个 splitter bug:我的递归分割器把"## "作为分隔符。这听起来无害,直到你意识到它可能在标题标记本身内部分割。208 个 chunk 中有 61 个是坏的。有些 literally 就只是 #。有些是有标题没正文。修复了这个 bug。208 个 chunk 变成 117 个。分数不变。
更大的 chunk(800 字符):手册的拒绝从 0 升到 6,因为两个不相关的短章节被打包进了一个 chunk,其嵌入落在两个主题之间。
上下文检索(每个 chunk 一段 LLM 写的导语):我为每个 chunk 生成了 LLM 写的导语。它在简历 fixture 上产生了当时最好的 rank-1 召回率。但它在 CPU 上每个 chunk 花了 25–31 秒。而且一个模糊的生成导语成功把正确 chunk 从两道题的前 5 名里挤了出去。
语义分块:只在句子末尾切,所以手册变成了 48 片碎片,列表项被粘在一起。
保留的方案:在每个 chunk 上面加一个"标题 › 小节"的标题,但对于 Markdown 标题少于两个的文档(如简历和大多数 PDF)自动添加。在简历上 rank-1 召回率从 5/14 提升到 8/14。在结构化文档上每次损失一个拒绝,所以它是根据文本自动开启的,不是根据文件类型。
教训:大量检索问题其实是分块问题戴着假胡子。
在我的简历上,我问:"Sekharendu Dey 有多少个项目?"
回答回来:"至少三个。"
模型把工作经历算成了项目,因为我给了它五个按检索相关性排序的碎片,而不是按阅读顺序给出简历。
有些项目要点也没有附带项目标题。
于是我把检索和上下文组装分开了。
检索现在先回答一个问题:"这里有什么足够相关可以继续,哪些文档匹配了?"
然后上下文组装决定模型实际应该读什么。
如果匹配的文档在 1000 token 以内,在上下文预算允许的情况下,我会包含整个文档。
对于更大的文档,模型得到最强匹配的 chunk、文档的开头 chunk,以及阅读顺序上附近的 chunk,每个文档上限 1200 token,总上下文窗口上限 4096 token。
在一个虚构的简历 fixture 上,正确回答从 17/25 提升到 22/25。
在我的真实简历上,现在它说"两个项目"并且列出了两个。
当然有取舍。长文档回答慢了大约 2 倍。
而且有一道 48 页 PDF 上的题实际上变差了,因为答案消失在一个 2.5 倍长的提示词里。之后的上下文限制修复了那道题。不幸的是,额外的延迟没有收到通知。
我的关键词评分器给最后一次运行打分 57/62。
然后我读了答案。
五个"错误"回答中有四个实际上是正确的。
所以实际人工评分是 61/62。
一个回答正确但显然太短,评分器不喜欢。
另一个正确给出了丹佛办公室的开门时间,而评分器期望开门和关门时间都要。
只有一个真正的漏网:
"谁做的 CUGA 项目。"
措辞模糊到其检索分数低于 0.63 阈值,所以应用拒绝了它。
当我把它改述为清楚地问作者所在机构时,它正确回答了。
教训:自动评分告诉你该看哪里。它不能告诉你最终分数。
尽早构建评估集。在添加足够多功能让你无法再分辨到底是什么让系统变好之前做。
尽早构建评估集。在添加足够多功能让你无法再分辨到底是什么让系统变好之前做。
像认真对待回答一样认真对待拒绝。不相关问题是产品的一半。
像认真对待回答一样认真对待拒绝。不相关问题是产品的一半。
记录你尝试了什么、移除了什么。我构建的很多东西听起来有用,但在测量后被移除了。没有日志,我可能会忘记为什么。
记录你尝试了什么、移除了什么。我构建的很多东西听起来有用,但在测量后被移除了。没有日志,我可能会忘记为什么。
先试无聊的修复。前缀。Splitter bug。一个缺失的缩写。这些最终对我帮助比好几个花哨想法更大。
先试无聊的修复。前缀。Splitter bug。一个缺失的缩写。这些最终对我帮助比好几个花哨想法更大。
代码、eval 数据集和这些数字背后的所有脚本都在 GitHub 上:github.com/Sekharendu/LocalCortex(MIT)。
启动只需一条命令:docker compose --profile app up -d。
如果你在构建类似的东西,或者你知道如何在不让"法国的首都是什么"混入的情况下捕获俚语化的问题,我很想知道。