
8.0
热点
AI SCORE
编程提效2026-10-19 12:55
用代码知识图谱辅助编程智能体检索
dev.to · AI#代码检索#知识图谱#开源
Editor brief · 编辑速览
graphify 通过 tree-sitter 在本地解析代码,生成交互图谱、结构报告及供智能体查询的 JSON,可接入 Claude Code、Codex 和 Cursor。代码提取不依赖模型,但摘要未给出节省 Token 的实测结论。
这周,我的时间线上到处都是 graphify:它的 GitHub star 数突破了 12.6 万,入选了 Y Combinator,还上架了 Vercel Marketplace。它的卖点很简单:在 Claude Code、Codex 或 Cursor 中输入 /graphify,你的 Agent 就能查询代码的图谱,不必再逐个读取文件。
“节省 token”这句话说起来容易,验证起来却很难。所以,我在一台普通的 Linux 机器上安装了它,并拿一个真实仓库做了测试。不用云端试用,也不用 API key。下面是实际结果。
graphify 是一个采用 Apache-2.0 许可证的开源 Python CLI,同时提供 Agent skill。它通过 tree-sitter 解析项目,并在 graphify-out/ 中生成三个文件:
graph.html:可以在浏览器中打开的交互式力导向图。GRAPH_REPORT.md:汇总“超级节点”、社区以及意料之外的关联。graph.json:完整的图谱,Agent 可以通过 explain、path 和 query 查询。代码提取过程是确定性的,完全在本地执行。只有处理文档、PDF、图片、视频,或者给社区命名时,才会用到 LLM,而且前提是你配置了 backend。
我的测试机运行 Debian 13,装有 Python 3。注意,PyPI 包名里有两个 y:
python3 -m venv venv
venv/bin/pip install graphifyy      # installed 0.9.92
git clone --depth 1 https://github.com/encode/httpx testbed/httpx
测试仓库我选了 httpx:一个真实、知名的 Python HTTP 客户端,包含约 17,750 行 Python 代码,以及文档和更新日志。它的规模足够让测试有看头,又没有大到让我无法大致判断答案是否正确。
只针对代码构建图谱,不需要 AI 助手。直接在 CLI 中执行 update 命令即可:
cd testbed/httpx
graphify update .
Re-extracting code files in . (no LLM needed)...
  AST extraction: 101/101 uncached files (100%) [8 workers]
[graphify watch] Rebuilt: 2233 nodes, 4453 edges, 166 communities
首次构建耗时 2.1 秒。我修改一个文件后,增量构建只重新解析了这个文件,耗时 1.6 秒。报告底部也明确写着 Token cost: 0 input · 0 output。
生成的文件并不小:graph.json 为 1.7 MB,graph.html 为 1.9 MB,GRAPH_REPORT.md 为 24 KB。Markdown 文档的结构也被提取进来了,因此 CHANGELOG.md 和 docs/api.md 都出现在图谱节点中。

说实话,“超级节点”列表很适合放在新贡献者入门资料的第一页:
1. Response - 170 edges
2. Request - 111 edges
3. Changelog - 79 edges
4. Client - 69 edges
5. AsyncClient - 51 edges
6. BaseClient - 45 edges
这些确实是 httpx 的核心。88% 的边标记为 EXTRACTED,也就是直接从源码中提取;12% 标记为 INFERRED,平均置信度为 0.91。我很喜欢每条边都带有这种标签,因为它能帮助你判断哪些信息值得信任。
“意料之外的关联”就没那么有用了。每一项都是更新日志或文档标题与 Client 之间的关联。关联确实存在,但谈不上意外。
下面这些才是 Agent 实际执行的命令。我用 tiktoken 的 cl100k 编码统计了每次输出的 token 数:
graphify explain "httpx/_client.py::Client"
graphify path "httpx/_client.py::Client" "DigestAuth"
graphify query "how does a request get sent through the transport"
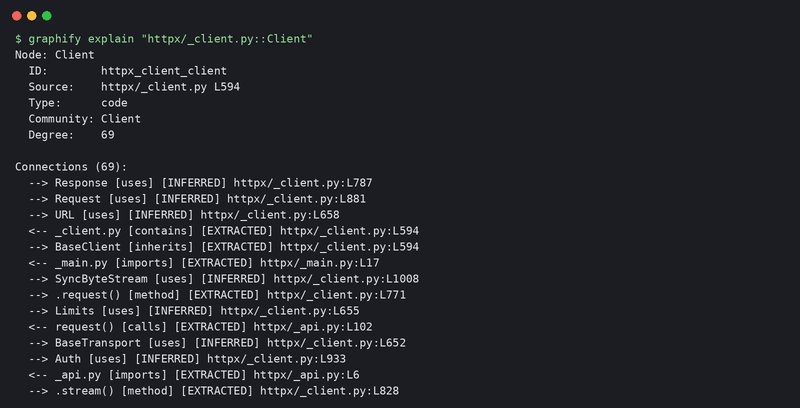
对 Client 执行 explain,输出共 628 个 token。它列出了 69 条关联,并附带文件名和行号,例如 --> HTTPTransport [uses] [INFERRED] httpx/_client.py:L731。而读取整个 _client.py 文件需要 13,659 个 token。
path 用一行返回了一条 3 跳路径:Client <-contains- _client.py -imports_from-> _auth.py -contains-> DigestAuth。
query 的输出为 1,728 个 token。它执行了一次 BFS,找到了 536 个节点,但只展示了其中 82 个,并明确输出了 TRUNCATED 警告,提示我把 --budget 提高到 14720,才能查看全部结果。
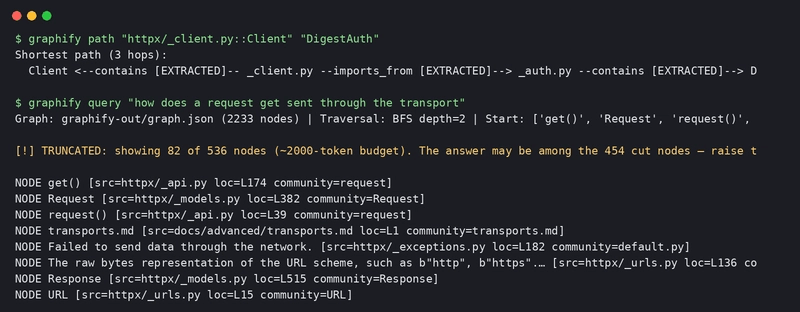
所以,对于“X 在哪里,哪些东西与它有关”这类问题,图谱查询消耗的 token 确实大约只有直接输出整个文件的二十分之一。但当 Agent 需要修改函数时,它仍然得读取代码。图谱能指向正确的代码行,却不包含这些行的具体内容。
名称歧义。 执行 graphify explain "Client" 时,它拒绝给出答案,因为 Client 同时匹配了 httpx/_client.py 中的类和 docs/api.md 中的一个标题。报错会提示使用 path::symbol 格式,这样确实能查到结果。不过,文档和代码一起建立索引,也意味着常见名称很容易冲突。
用小型本地模型给社区命名。 不提供 API key 时,这 166 个社区会用某个代表性文件或符号命名,例如 test_content.py、AsyncByteStream。graphify 可以调用 LLM 为它们重新命名,也支持 Ollama:
pip install openai     # the Ollama backend needs it; the first run told me so
graphify label . --backend=ollama --model=qwen3:1.7b
在我的机器上,用 CPU 运行一个 1.7B 模型,这一步跑了超过 11 分钟都没结束,最后我终止了进程。代码图谱完全不依赖这一步;但如果你想要更好懂的标签,就给它配一个像样的模型,或者提供 API key。我之前用 1.7B 本地模型运行 Anatomy 的 skill 时,也遇到过类似的小模型能力限制。
如果是处理代码,值得。它免费、在本地运行,而且速度很快。Agent 开始打开文件之前,explain 和 path 就能先以很低的 token 成本提供一份代码地图。我会把 graphify update . 加进 git hook,让 Agent 优先使用图谱。
以下内容我没有测试:付费 AI 助手中的 /graphify skill、对 PDF 和图片进行语义处理的环节,以及宣称“节省 80% token”的托管产品 Graphify Cloud。我的 628 对 13,659 这个数字,只是对一个仓库进行一次查询的结果,并不是整个 Agent 会话的基准测试。
仓库:github.com/Graphify-Labs/graphify
如果还想采取进一步措施,你可以考虑屏蔽此人和/或举报滥用行为。