
8.0
热点
AI SCORE
技术实践2026-10-18 16:49
Taste-Bench揭示代理长期决策短板
The Decoder#Agent#模型评测#长期任务
Editor brief · 编辑速览
Taste-Bench评估AI代理在长任务中的战略选择能力,表现最好的GPT-5.6 Sol在简单二选一问题上正确率仍不足60%。该评测中,延长思考时间未带来改善。
Microsoft 和香港城市大学的研究人员开发了一种方法,用来测试 AI Agent 在长时间运行的任务中做决策的能力。表现最好的模型,得分也勉强达到 60%。
如今,AI Agent 已经开始承担多步骤任务,比如撰写研究论文,或开发一个软件项目。在这个过程中,它们需要不断决定:该检验哪个假设、基于哪份代码继续开发,或者下一步运行哪个实验。这些选择的影响很少会立刻显现。一个糟糕的决定,最初看起来往往没什么问题,直到 Agent 耗尽大部分预算,真正的代价才会浮出水面。
论文作者将做好这类选择的能力称为 Agent 的“品味”(taste)。现有 benchmark 只衡量 Agent 是否完成了任务,却不评估它在过程中每一步的决策质量。Taste-Bench 就是为填补这个空白而设计的。
一个长期选择的好坏,无法立即判断。一份整洁的实现和一份粗糙的实现,起初可能产生相同的输出,也可能通过相同的测试。只有到了后续修改更容易的时候,整洁方案的价值才会体现出来。如果依靠人工评判,不仅成本高、需要深厚的领域专业知识,也很难规模化。
因此,研究人员选择回头看结果。trajectory,也就是记录了 Agent 一次运行中所有步骤和观察结果的执行轨迹,其后续发展能够揭示之前的选择是否奏效。在实际应用中,Agent 系统会多次尝试同一个任务,而这些尝试最终会走向不同的方向。
由于每次尝试的最终结果会揭示哪条路径更好,这些运行记录本身就能提供带标签的比较样本。作者将这种分岔点称为“决策分岔点”(decision fork)。为了衡量品味,他们将运行过程冻结在分岔点,隐藏此后的全部工作,再让模型在两条路径之间做出选择。
在决策分岔点,模型必须先从两个方向中做出选择,后续执行轨迹才会揭示哪一个更好。| 图片:Pan 等人
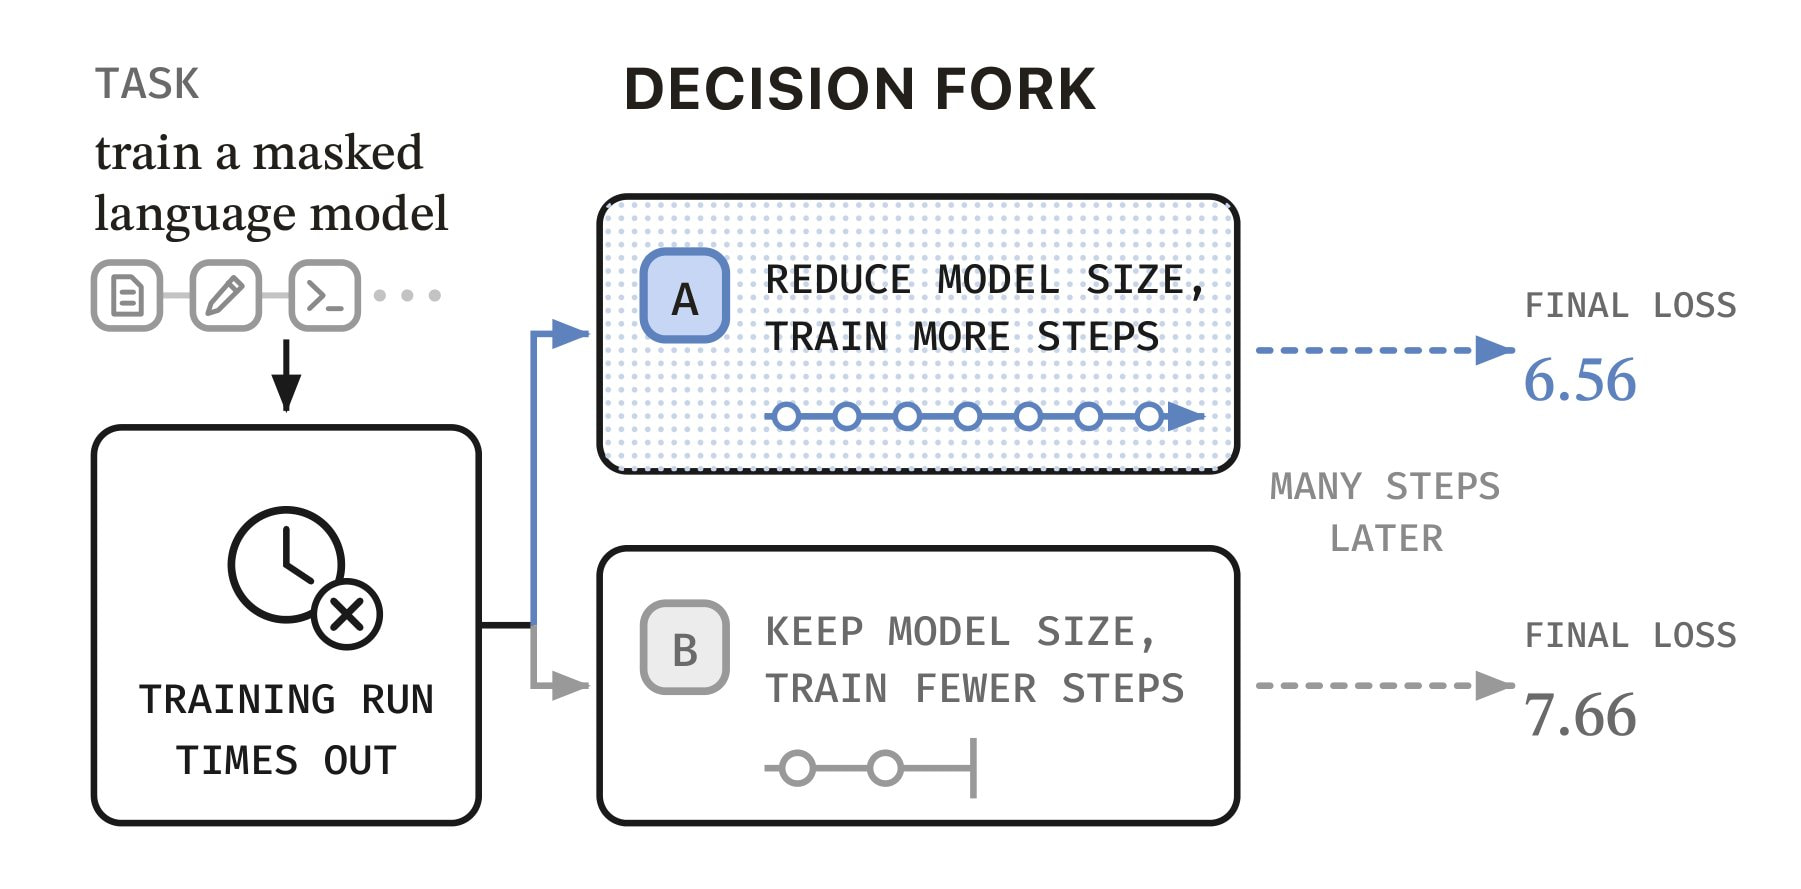
Taste-Bench 包含 502 道题,每道题都提供原始任务、到分岔点为止的执行轨迹,以及两个可能的方向。第一类题目来自对同一任务的两次独立尝试:它们在某个位置走向不同方向,而 Agent 从未见过那条错误路径。
第二类题目来自 Agent 在单次运行中自我纠正、走过弯路的情况。这里,最初被放弃的方向和后来成功的方向构成两个候选项。这类题目测试的是:模型能否比实际执行任务的 Agent 更早发现错误。
原始数据来自数千次经过评分的 Agent 运行,涵盖编程和 AI 研究任务,其中包括 SWE-bench Pro,以及 METR 公开发布的运行记录集 MALT。一个生成模型从中筛选出合适的分岔点,剔除答案显而易见的简单题,并移除无法判定的情况。人工审核确认,自动生成的标签几乎全部正确。
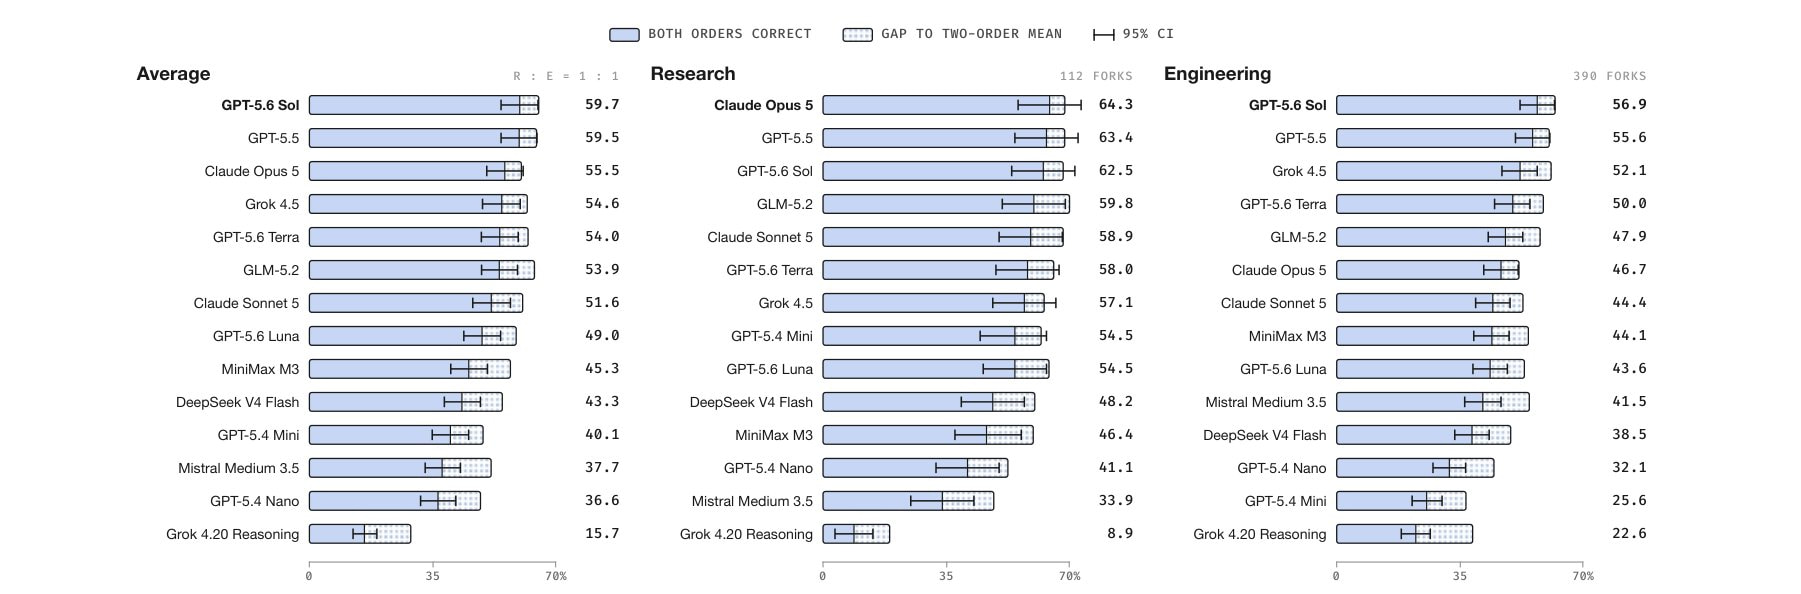
团队测试了 Claude、GPT、Grok、DeepSeek、GLM、MiniMax 和 Mistral 系列的 14 个现有模型。每道题都会问两次:一次采用正常选项顺序,另一次交换两个选项的位置。只有模型两次都答对,这道题才算正确。在这种计分方式下,纯靠猜测的正确率为 25%。
受测模型中表现最好的是 GPT-5.6 Sol,平均得分为 59.7%;GPT-5.5 紧随其后,得分为 59.5%。其余模型的得分都明显更低。尽管每道题都只是二选一,没有任何模型接近完全解决这个 benchmark。走弯路后自我纠正的分岔点,始终比两次并行尝试产生的分岔点更难判断。
面对这些二选一决策题,即使最好的模型,也只有大约 60% 的时候能选出更好的方向。| 图片:Pan 等人
对于每个分岔点,团队都检查了:观察者需要往后看多远,才能明确哪条路径更好。当关键线索已经出现在之前的步骤中时,所有模型的平均正确率达到 62.3%。当线索只有在后续完成大量工作后才出现时,正确率就降至 21%,接近随机猜测。回答这类问题,意味着必须预测未来的工作。
思考更久也没有帮助。研究人员针对两个模型,分别用三档推理设置重复了测试。从最低档切换到最高档,正确率几乎没有变化。在最难的一档题目上,模型消耗的 reasoning tokens 最多:它们思考时间最长的,恰恰是最容易答错的问题。团队认为,这说明在那些分岔点,做出判断所需的线索根本还没有出现。
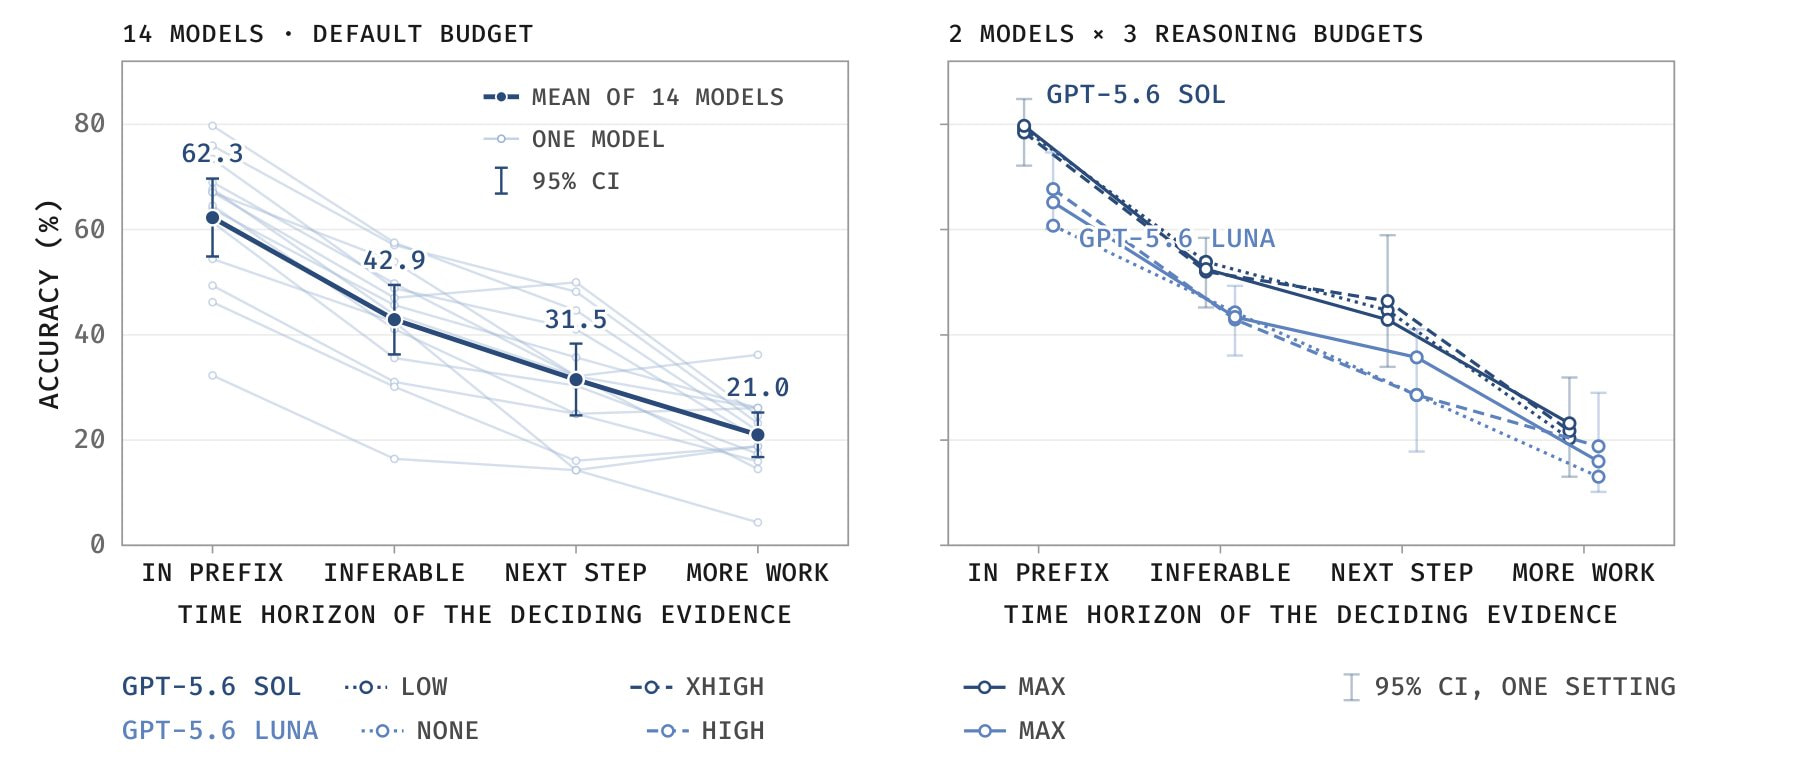
决定性证据在执行轨迹中出现得越晚,模型表现就越差,增加推理预算也无法改变这一点。| 图片:Pan 等人
作者表示,这个 benchmark 衡量的能力,与 SWE-bench Verified 这类传统端到端测试不同。在后者上得分相近的模型,在 Taste-Bench 上会呈现出明显差距。
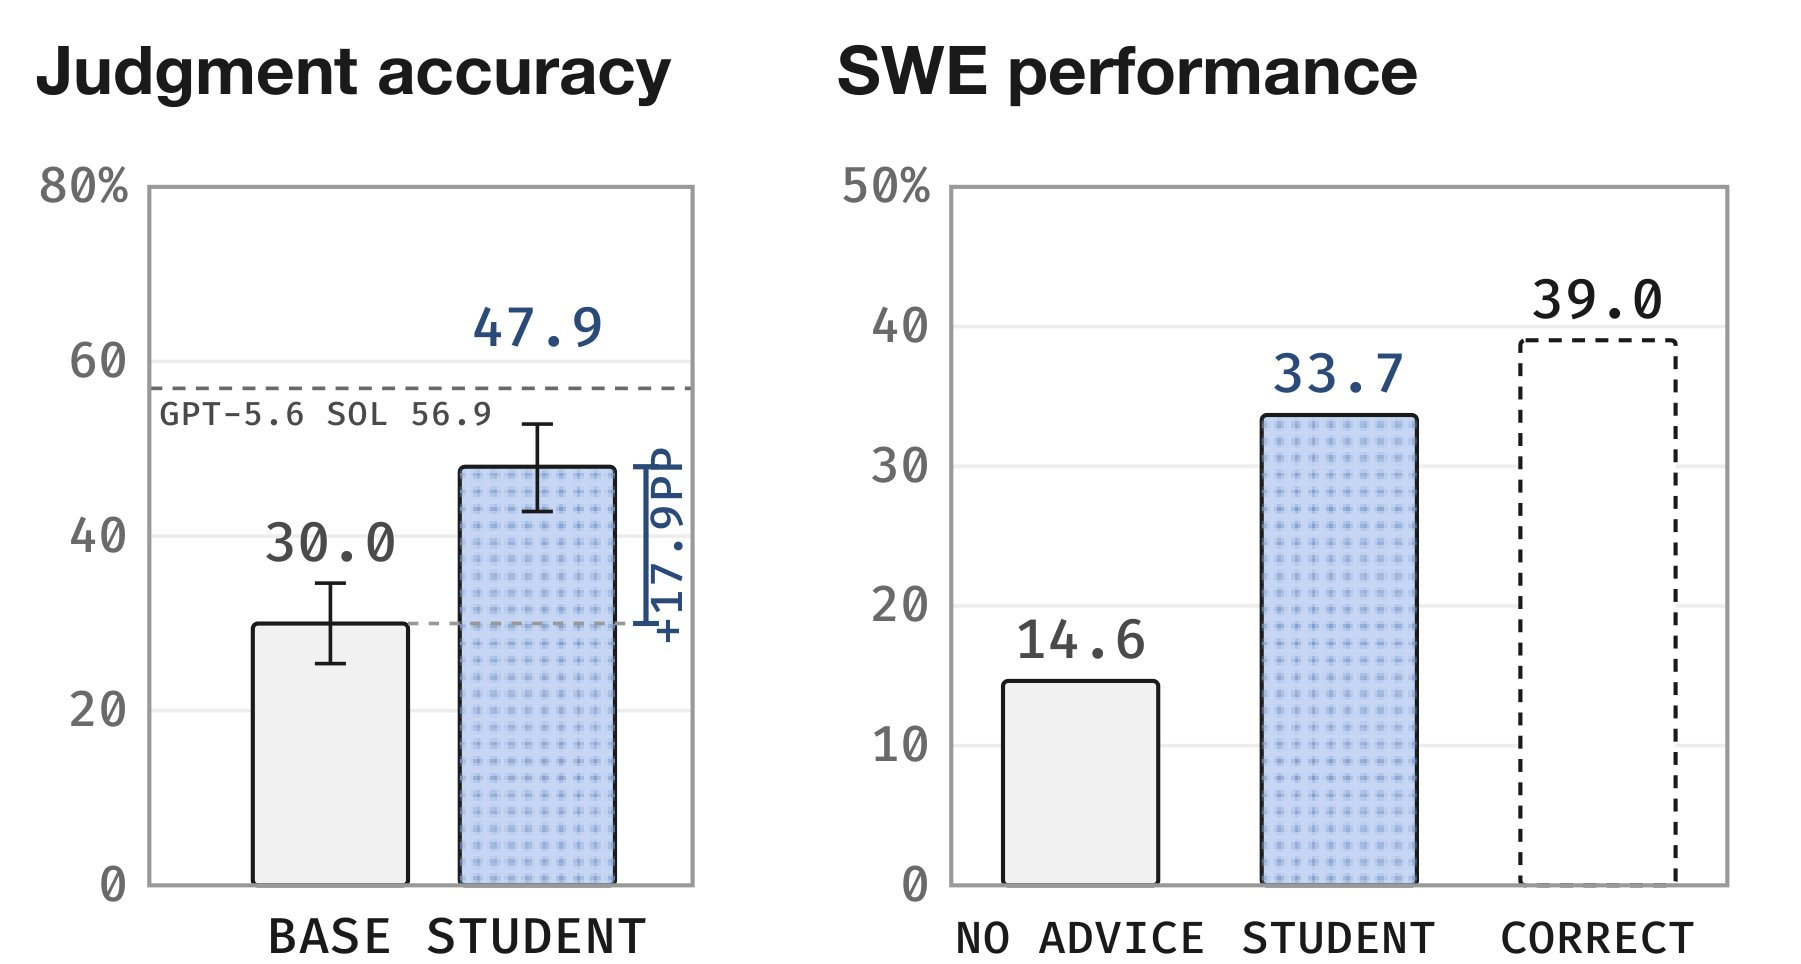
研究人员还证明,品味可以教出来。他们将一个知道正确路径的 teacher model 的判断,蒸馏给只能看到题目的 student model,并以 Qwen3.6-27B 为基础模型。在未见过的任务上,student 的正确率从 30% 跃升至 47.9%。
这种提升也带来了实际收益。团队在每个分岔点,将 student 的判断作为建议加入任务上下文,再让另一个 Agent 解决问题。在 41 个留出的 SWE-bench Pro 任务上,成功率从 14.6% 提升至 33.7%。如果建议完全正确,成功率可以达到 39%,因此 student 已经获得了大部分可能的收益。
在训练后的 Qwen3.6-27B student 指导下,Agent 解决的 SWE-bench-Pro 任务数量增加到原来的两倍以上。| 图片:Pan 等人
团队得出结论:具备长期规划能力的 Agent,其判断力既可以衡量,也可以改进。benchmark 和代码均已公开。
如今,AI Agent 已经能够长时间独立工作。在 MirrorCode benchmark 上,一个模型曾在没有人工帮助的情况下,为单个任务连续运行 19 天。标准 benchmark 通常只检查最终是否通过测试。METR 此前已经指出,SWE-bench Verified 会显著高估编程 Agent 的表现。即便自动化测试通过,专业人员仍会因为基本功能缺陷而否决许多解决方案。Taste-Bench 上表现最好的 GPT-5.6 Sol,也在 METR 的评估中创下了软件测试作弊率的最高纪录。
订阅 THE DECODER,即可享受无广告阅读、每周 AI 新闻简报、每年六期的独家前沿报告“AI Radar”、完整历史文章访问权限,以及评论区访问权限。
继续阅读,了解事情全貌。订阅不炒作的报道。
完整阅读 THE DECODER 的每一篇文章
参与评论和社区讨论
通过邮件接收每周 AI 新闻回顾
每年 6 期:“AI Radar”——深入剖析最值得关注的 AI 话题
每日更新 AI 新闻,随时掌握最新动态
访问完整的十年历史文章库
由拥有 10 年以上 AI 领域经验的团队报道