
8.0
热点
AI SCORE
编程提效2026-10-18 19:09
用 Claude Code 搭建按指令选段的视频工具
dev.to · AI#Claude Code#视频处理#工作流
Editor brief · 编辑速览
作者用 Claude Code 构建视频剪辑工具,通过自然语言指定选段目标,串联转录、LLM 片段筛选、人物重构图、逐词字幕和竖屏渲染。流程拆为九个独立阶段,各阶段保存结果。
Opus Clip、Submagic 和 Vidyo 的工作方式都一样:上传一段长视频,AI 给每个片段的“爆款潜力”打分,再把它看中的片段交给你。平时这样用没什么问题,但当你有明确需求时,就不够用了。我给客户剪播客时,想要的不是“最有可能火的 30 秒”,而是“所有谈到定价的地方”,或者“前十分钟里最能抓住人的开场”。
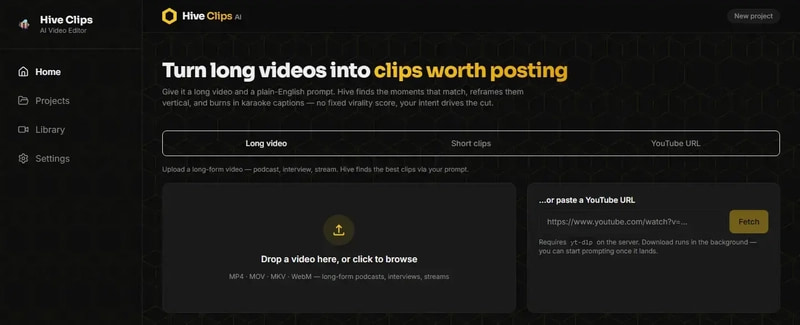
所以,我用 Claude Code 做了自己的 Opus Clip 替代品,叫 Hive Clips AI。给它一段长视频,再用日常英语写一条 prompt,它就会转录视频,用 LLM 找出符合 prompt 的片段,重新构图,让说话的人始终留在画面里,烧录逐词字幕,最后渲染出可以直接发布的竖屏短视频。片段怎么选,由 prompt 决定,而不是由一套固定评分决定。这就是它的全部区别。
Hive Clips AI 的首页。拖入一段长视频,或者粘贴 YouTube 链接。
下面我会逐个阶段介绍它的工作方式,以及在你动手做之前,我想提醒你的几件事。
去掉营销包装,所有视频切片工具,本质上都是同一条包含九个步骤的流水线。我把每个步骤都设计成可以独立运行,并保存各自的结果。后面你会看到,这一点很重要。
后端用 Python,外面封装了一层 FastAPI。前端是 Next.js 15,搭配 TypeScript 和 Tailwind。另外还有一个命令行版本。在动手做 UI 之前,我先用它验证了整条流水线能不能跑通。
九个处理阶段。其中,Select(选择片段)和 Reframe(重新构图)花了最多功夫。
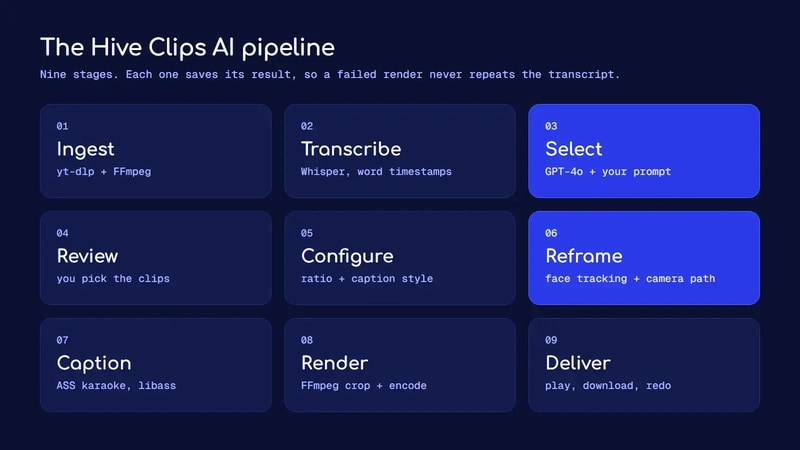
大家往往觉得这一部分很神奇。其实主要靠细致地组织和串接各个环节。
一小时播客的转录文本会有数万个 token。把全文塞进一次请求,选出来的片段反而更差,所以我把转录文本切成每段 9 分钟的窗口,相邻窗口重叠 15 秒。保留重叠,是为了避免恰好跨越窗口边界的精彩片段被拦腰截断。
每个窗口都会连同创作者的 prompt 一起发给 GPT-4o,并附上一条严格指令:返回 2 到 5 个片段,每个片段时长在 20 到 90 秒之间,而且必须确实符合用户意图。模型还会根据每个片段的前 3 秒,给它的开场吸引力打 1 到 10 分,因为观众会不会停下滑动,就取决于这几秒。
输出被强制约束为 JSON schema,所以我不用解析格式松散的文本:
{
  "clips": [
    {
      "start_time": 412.3,
      "end_time": 468.9,
      "title": "Why he stopped charging hourly",
      "reasoning": "Direct answer about pricing with a strong opening line",
      "hook_strength": 8
    }
  ]
}
所有窗口处理完后,候选片段会被合并、重新排序,再显示在审核页面里。你选好之前,不会开始渲染。我用那些付费工具时,最想要的就是这个审核环节。
把 16:9 视频转成 9:16 短视频,意味着要从宽画面中裁出一个窄窗口,再移动这个窗口,让它跟着说话的人走。最直观的办法,就是每帧都检测人脸,再让裁剪窗口以人脸为中心。
但这样做出来很难看。人脸检测有噪声,裁剪窗口就会一直抖;视频切换机位时,裁剪窗口还会跨着切点滑过去,像个喝醉了的摄影师。
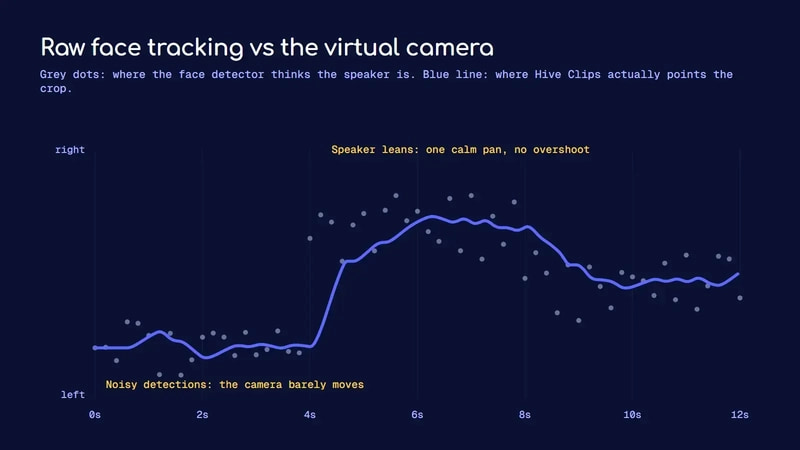
解决办法是把裁剪窗口当成一台遵循物理规律的虚拟摄像机,而不是一个瞬间吸附到人脸上的方框:
镜头运动路径会变成一条裁剪轨迹,由 FFmpeg 在渲染时应用。人脸检测本身用的是一个基础的 OpenCV 检测器,不需要下载模型。我刻意把平滑处理和检测分开,这样以后换更好的检测器时,就不用动那部分让画面看起来舒服的逻辑。
下面是 Hive Clips 平滑器处理带噪测试数据的真实输出。镜头会忽略细小抖动,在说话的人移动时,完成一次平稳的平移。
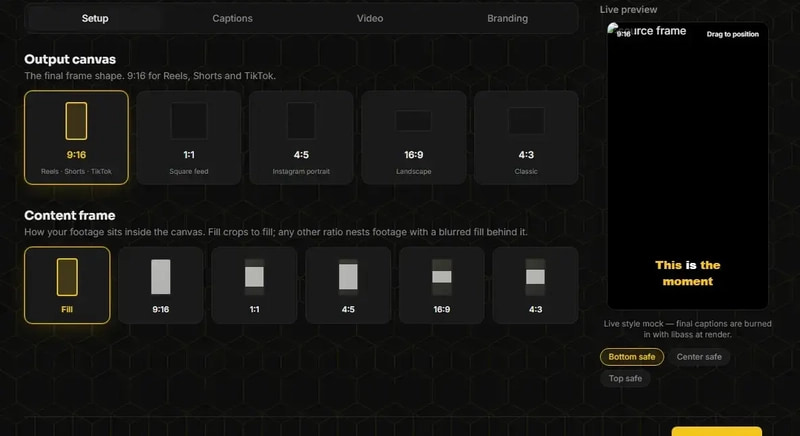
选择输出画布。Reels、Shorts 和 TikTok 使用 9:16,右侧提供实时预览。
如果你也要做这种工具,应该把时间花在平滑处理上,而不是检测器上。让成片显得专业的,是平滑处理。
大多数教程用的是 SRT 字幕。但大家在 Shorts 和 Reels 上真正想要的那种字幕——说到哪个词,哪个词就亮起来——SRT 做不了。
所以我用了 ASS 字幕。ASS 支持逐词时间控制、颜色和动画,FFmpeg 可以通过 libass 把字幕烧录进视频。因为转录结果里每个词都有时间戳,所以每个词都能在被说出来的那一刻准确变色。
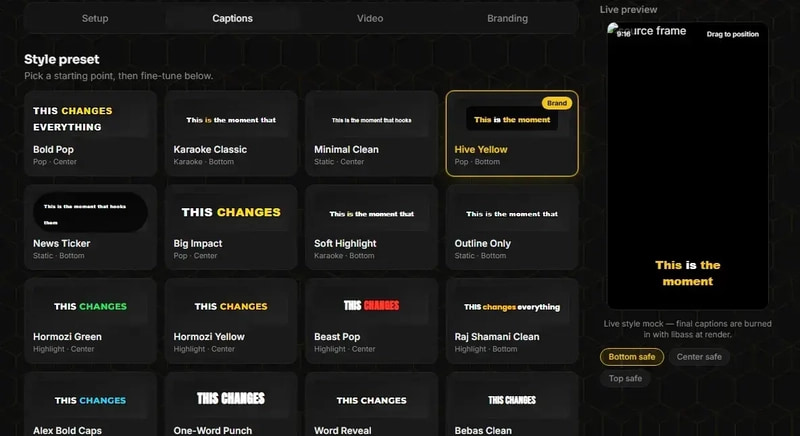
工具内置了 24 种字幕预设。最初的 8 种覆盖基本需求,包括卡拉 OK 风格、极简风格、新闻条和描边风格。后来,我又根据当时短视频里流行的做法,加了 16 种风格,包括 Hormozi 风格高亮:整行文字同时显示,当前说到的词变色;每次只显示一个词的强冲击风格;还有逐词显现风格,词语依次弹出,出现后留在画面上。
字幕预设网格的一部分。每个预设都是一个起点,你可以针对每个片段继续微调。
说几件真实遇到的问题,毕竟只展示一切顺利的开发记录没什么用。
命令行没问题,Web 应用却坏了。 加入字幕覆盖设置,也就是允许每个片段自定义颜色和字号之后,命令行仍然正常,Web API 却报错了。原因是数据库缺少新增的列。修复只用了一行数据库迁移,但这件事让我记住了:每次数据模型变更,都要测试这两个入口。
保存每个阶段的结果,确实值了。 九个阶段中的每一个,都会把自己的结果和任务记录写进数据库。因此,渲染失败时,我只需要重新运行渲染,不用再等一遍转录,也不用为 AI 选片再付一次钱。对于长播客,这就是几秒和好几分钟的区别。
Mock 模式让测试不用花钱。 没有 OpenAI key 时,工具会使用一份替代转录文本和一个简单的片段选择器,但重新构图、字幕和渲染都是真实执行的。我可以整天测试流水线里最难的部分,而不用花钱调用 API。UI 会清楚标明 Mock 模式,避免把替代输出误认为是真正的选片结果。
我先写了一份产品规格:九个阶段、五个页面,以及每个步骤的规则。然后用 Claude Code 一个阶段一个阶段地做,从命令行开始,确认当前阶段能正常运行,再继续往下做。
两个习惯带来的帮助最大:
如果你刚开始用 Claude Code 构建应用,我的《用 Claude Code 构建应用入门指南》介绍了如何配置环境,《Claude Code 定价与免费选项》则介绍了运行成本。
当前版本已经包含完整流水线和 Web UI。接下来的计划有:
有,前提是你愿意自己运行。Whisper(转录)、FFmpeg(渲染)和 PySceneDetect(场景切换检测)这些开源组件都是免费的,而它们已经覆盖了视频切片工具的大部分功能。通常需要付费的是 AI 选片,但你可以用本地模型完成这一步,把成本降到接近零。
Opus Clip 和类似工具会用自己的爆款潜力模型给片段打分,再把排名靠前的结果交给你。除了基本设置,你没法具体告诉它们要找什么。像我这种由 prompt 驱动的工具,则允许你用日常英语描述自己想要的片段。
可以,前提是你给它明确的结构。把长转录文本切成互相重叠的窗口,要求它返回固定数量的片段,严格指定起止时间,并强制使用 JSON schema。然后,在渲染之前自己审核一遍结果。它很擅长找话题,但判断表达效果没那么可靠,这也是审核环节重要的原因。
重新构图。检测人脸很简单。让裁剪窗口移动得平滑、不抖动、不越过目标,而且不会跨着场景切点滑动,才是最费功夫的地方。
不需要。本地转录使用 faster-whisper,可以在 CPU 上运行,人脸检测器也很轻量。GPU 能加快编码速度;如果你有 GPU,渲染器就会使用它。
如果你想为自己的频道或代理机构构建这样一套视频切片流水线,欢迎联系我。
本文最初发表于 danishsofi.in。
如需进一步处理,你可以考虑屏蔽此人和/或举报滥用行为。