
8.0
热点
AI SCORE
技术实践2026-10-18 17:09
用代码关系图定位维护者流失风险
dev.to · AI#知识图谱#代码维护#团队协作
Editor brief · 编辑速览
Bus Factor 将 Delta Lake 两年的公开开发记录建成 FalkorDB 图,关联人员、代码、评审和设计决策,分析知识集中风险。作者还复盘了一项测量错误,并指出代码评审对判断知识覆盖的重要性。
Bus Factor 将 Delta Lake 两年的公开历史转化为一张 FalkorDB 图谱,涵盖人员、代码、评审和设计决策。本文将介绍它发现了什么、我在哪项度量上出了错,以及为什么代码评审比我预想的更重要。
关于封面:每个方块代表 Delta Lake 中一个近期活动足够多、可以进行度量的代码区域;每条线将该区域连接到过去 12 个月里最活跃的代码作者。数据来源:delta-io/delta 的公开历史,查询于 2026 年 10 月 18 日。
想象一下,某个开源项目的群聊里,周五突然出现一条消息:最活跃的维护者之一要离开了。从技术上说,什么都没有丢失。每一次提交、每个拉取请求和每份设计提案都还在。
可到了周一,大家却无法准确回答那些真正重要的问题。最近有哪些代码只有这个人改过?还有谁至少看过这些改动?哪些设计决策有他的参与,现在是否还有其他参与者留下来?如果有人必须接手,应该从哪里开始阅读,又应该趁知情者离开之前问清哪些问题?
工程师给这种风险起了一个直白的名字:巴士系数,也就是要有多少人离开,项目的某一部分才会陷入无人了解的境地。我按代码区域来度量它:在过去 12 个月内,提交次数合计达到该区域总提交次数至少一半所需的最少人数。巴士系数为 1,意味着近期该区域至少一半的改动都由同一个人完成。
我为 WeMakeDevs × FalkorDB Graph Hacks 黑客松开发了 Bus Factor,想用它回答真实项目 Delta Lake 中的一个问题:如果这位维护者离开,项目会失去什么?
每个公开来源都掌握着一部分信息。Git 历史记录了谁修改了哪些文件。GitHub 记录了哪些提交属于哪个拉取请求,以及谁评审过它。protocol_rfcs 文件夹列出了 19 项设计决策(RFC),每项都有一个跟踪议题。CODEOWNERS 则说明了谁正式负责哪些部分。
但任何一个来源,都无法单独回答“还有谁了解这段代码?”。以 flink/inttest 为例,这是 Delta Lake 的 Flink 连接器的集成测试。在过去 12 个月里,Hao Jiang(@harperjiang)是唯一在这里有过至少两次提交的人。如果只统计提交次数,Hao Jiang 看起来就是唯一了解它的人。但沿着其中一次提交找到对应的拉取请求,情况就变了。
图谱中的七个真实节点。沿着“代码区域 → 文件 → 提交 → 拉取请求 → 评审者”这条路径,可以找到 scottsand-db:他评审过这次改动,但近期没有在该区域提交过代码。
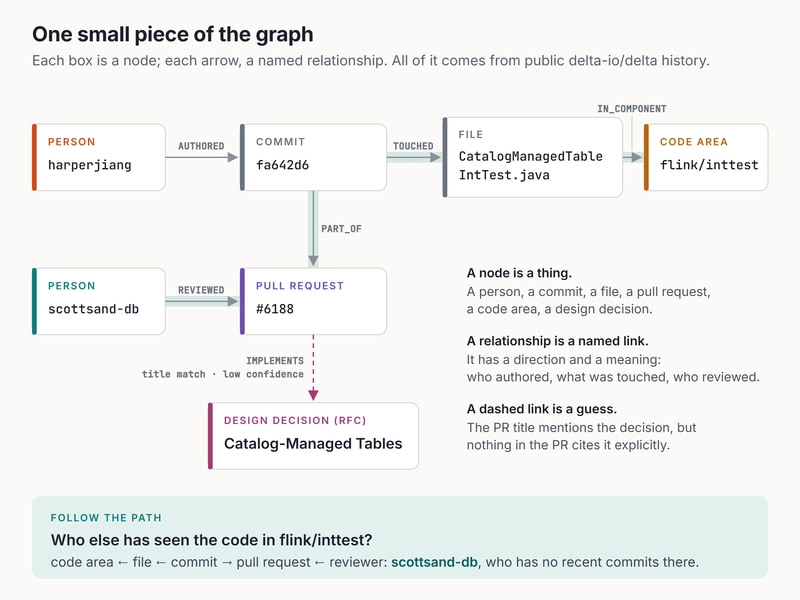
知识图谱就是这么回事:用具名、有方向的关系连接事物(节点),让问题变成一条可以沿着追踪的路径。FalkorDB 存储这张图谱,并执行用 Cypher 编写的查询。Cypher 中的模式,看起来就像图中的那些箭头。下面是 Bus Factor 用来查找谁评审过某个代码区域的模式(摘自 06_departure_impact.cypher,已换行以适应版面):
OPTIONAL MATCH (reviewer:Person:Active)-[review:REVIEWED]->(pr:PR)
               <-[:PART_OF]-(rc:Commit)-[:TOUCHED]->(rf:File)
               -[:IN_COMPONENT]->(component)
从左往右读:一位活跃人员评审了一个拉取请求;某次提交属于这个拉取请求;这次提交修改了一个文件;这个文件属于当前代码区域。SQL 也能通过几次连接完成同样的查询。图谱带给我的价值在于,每个答案都可以附带产生它的路径,而且同一组关系还能用于图算法、独立的记忆图谱,以及复制后进行模拟的步骤。下文会逐一介绍这些内容。
Bus Factor 加载了 delta-io/delta 两年的公开活动数据:2,240 次提交、3,602 个拉取请求及其评审、19 项 RFC 决策及其跟踪议题、CODEOWNERS,以及最新一次提交中存在的 4,427 个文件。文件按代码区域分组,也就是模块内部的包,例如 flink/inttest。最终得到的图谱包含 11,033 个节点和 39,869 条关系,利用仓库中一个 1.7 MB 的快照,大约 11 秒就能重建,因此任何人运行它都不需要 GitHub 令牌。
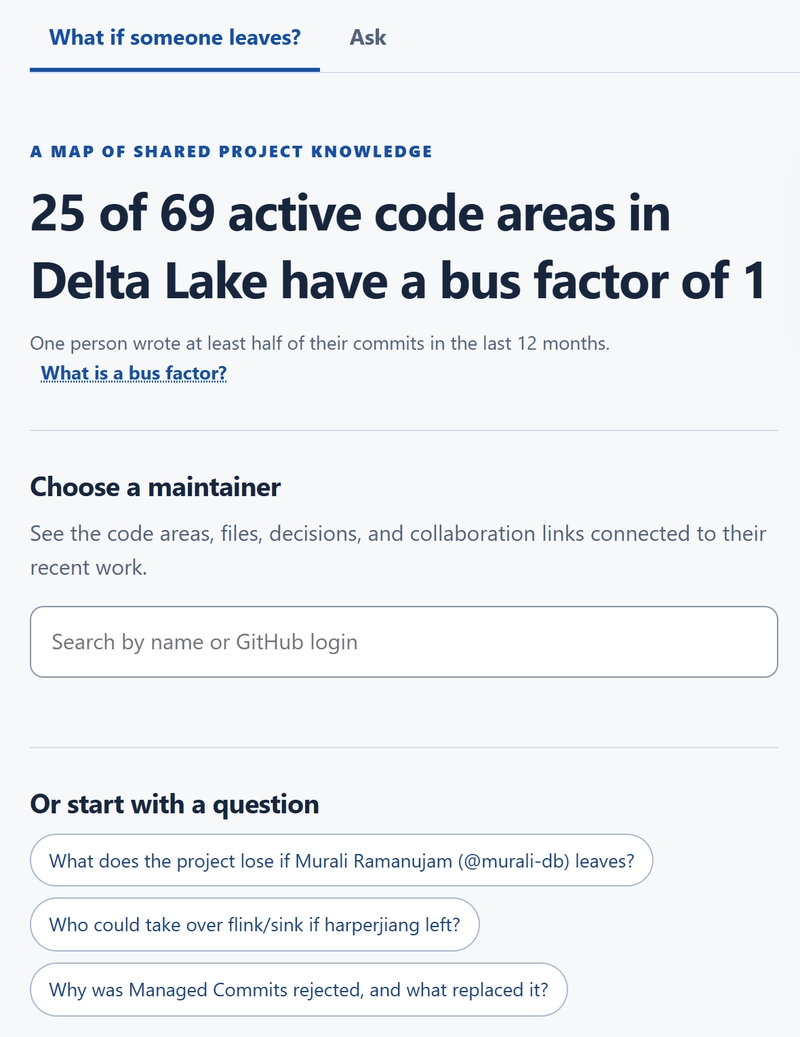
应用打开后,首先展示度量结果,并让用户作出选择:
首页视图。从按近期提交次数排序的列表中选择一位维护者,或者从一个建议问题开始。
在底层,数据向下流入 FalkorDB,答案则通过一组固定查询向上返回。
各部分如何协作。仓库事实、共享笔记和每位访问者的历史记录分别保存在独立的 FalkorDB 图谱中。由于 Cypher 无法跨图谱遍历,Python 通过一个稳定的键将它们关联起来。
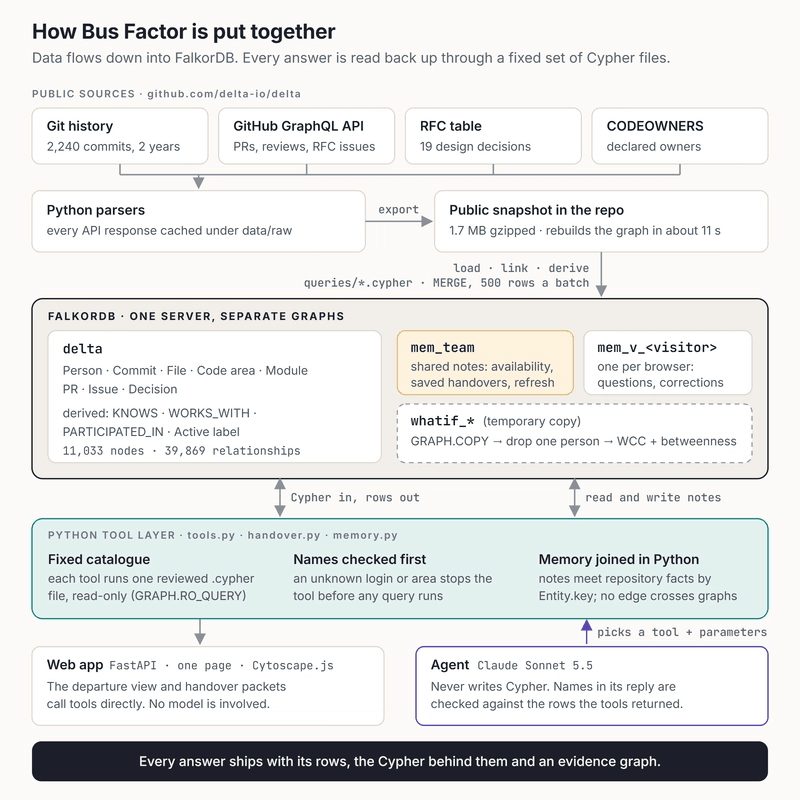
有两个决定影响了后续所有设计。第一,运行时不生成任何 Cypher。每项能力都封装为一个工具,由一个 .cypher 文件支撑,文件头部会说明它回答什么问题,以及为什么这样设计查询。离任影响视图和交接资料包直接调用这些工具,不涉及语言模型;只读工具则通过 GRAPH.RO_QUERY 执行。
第二,聊天智能体(Claude Sonnet 5.5)只负责选择工具并填写参数。它提到的每个登录名或代码区域,都会先在图谱中核验。因此,像 harper-jiang 这样的拼写错误会返回“不在图谱中”,而不是返回一个容易被理解成“没有任何风险”的空结果。之后,还会将它回复中的名称与工具返回的数据行进行比对。
我最初在首页放上统计数字时,写的是:87 个活跃代码区域中,有 42 个“在过去 12 个月内”的巴士系数为 1。这是个很吸引人的标题。但它实际度量的是另一回事。
提交作品的前一天,我请另一个模型(运行 GPT-6-Astra 的 Codex)像一位持怀疑态度的评委那样审查项目,再让 Claude Code 对照代码和实际运行的图谱核查每项发现。这些发现都得到了证实,其中最重要的两项都与风险的统计方式有关。
第一项是混淆了时间窗口。加载器会在每个人和每个代码区域之间派生一条 KNOWS 关系,记录此人在加载的完整两年内的提交次数,以及最近一次提交的日期。巴士系数查询先保留最近一次提交落在 12 个月窗口内的人,再累加他们两年内的提交次数。一个人如果有八次旧提交和一次近期提交,就会被算作有九次近期提交。
同一个标签,两种计算方式。10 月 18 日在同一张图谱上重新运行这两个查询,得到的结果依然分别是 87 个区域中的 42 个,以及 69 个区域中的 25 个:项目没有变,变的是度量方式。
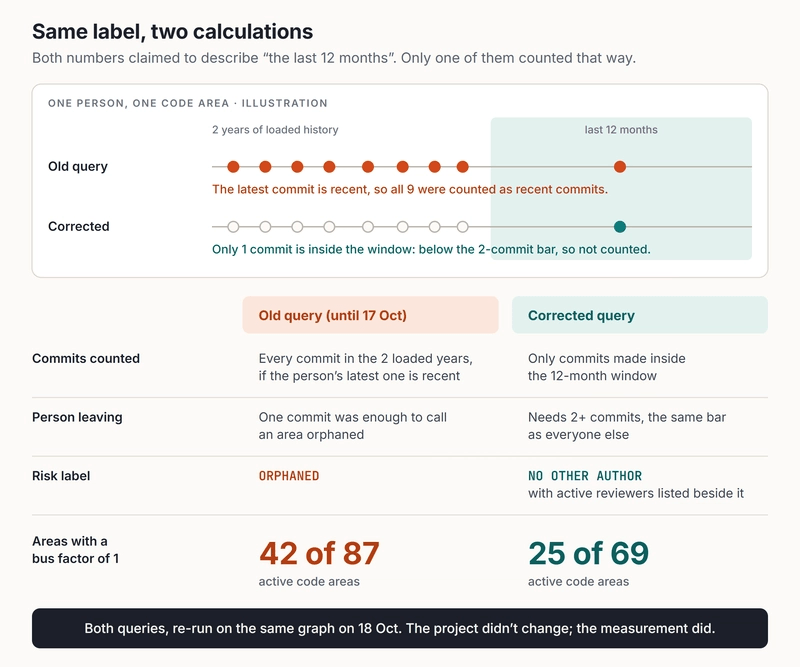
第二项是缺少阈值。留下来的人必须在某个区域有两次提交才会被计入,但离开的人只需要一次。当我模拟 Murali Ramanujam(@murali-db)离开时,有五个区域被标记为“无人接手”,其中四个区域的判断依据都只有一次提交。
修复后的查询直接从提交记录出发,严格按照标签所描述的口径统计(摘自 05b_bus_factor_component.cypher,已换行以适应版面):
MATCH (p:Person)-[:AUTHORED]->(commit:Commit)-[:TOUCHED]->(f:File)
      -[:IN_COMPONENT]->(component:Component)
WHERE commit.ts > $since AND coalesce(p.bot, false) = false
  AND coalesce(commit.bulk, false) = false
  AND coalesce(f.exists, true) = true
WITH component, p, count(DISTINCT commit) AS c
WHERE c >= $minCommits
count(DISTINCT commit) 和日期过滤条件同样重要:一次提交即使修改了某个代码区域中的 30 个文件,也只算一次贡献,而不是 30 次。修改超过 100 个文件的批量提交,以及此后已被删除的文件,都不计入专长评估。即将离开的人也和其他人一样,需要满足至少两次提交的要求。修正后的核心数字是:69 个中有 25 个。
项目并没有在一个下午变得更安全;只是衡量方式更贴近了标签所表达的含义。这是整个构建过程中最有价值的收获,因为它也改变了产品的用词。审查提出了一个更好的问题:如果代码作者身份只是一种信号,那么谁审查过这些代码?在最活跃的 15 个人中,有 19 个代码区域只有其中一人是近期作者,但每个区域都有 2 到 11 名活跃审查者。“无人接管”这个词并不准确。于是,标签改成了 NO OTHER AUTHOR(无其他作者),审查者列在旁边,始终单独展示,不合并计算,因为编写代码和审查代码是两种不同的证据。
为了展示完整流程,我会以 Hao Jiang 为例,因为相关数据能清楚地说明问题,并不是因为有任何迹象表明这位维护者即将离开。在应用中选中这位维护者,就相当于向图询问:这个人的离开会暴露哪些问题?应用会用一句话回答:
如果 Hao Jiang 离开:在过去 12 个月中其提交过至少 2 次的代码区域里,有 3 个将没有其他近期作者(这 3 个区域都曾由其他活跃人员审查),5 个将只剩一位其他近期作者;81 个现存文件将没有其他近期编辑者;0 人会失去与主要协作网络的联系。
这三个没有其他近期作者的 Flink 代码区域,各自都有五到六名活跃审查者。证据图展示了卡片统计所依据的关系;点线表示审查关系。
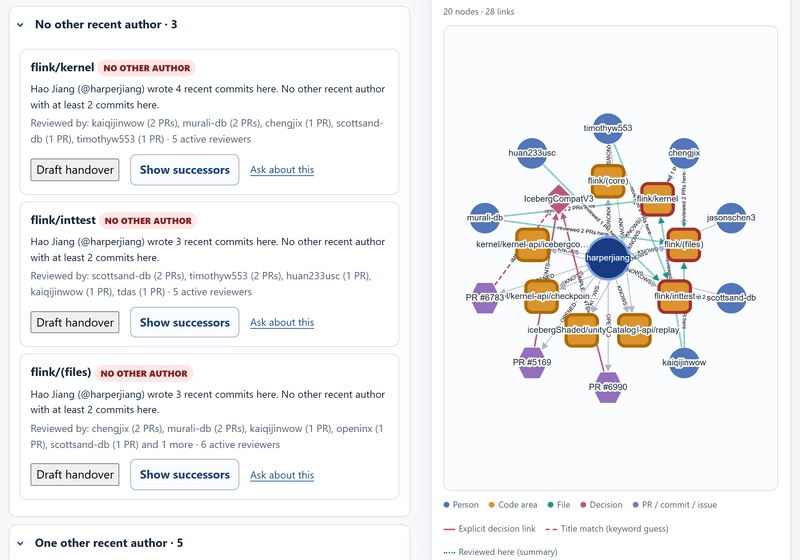
最后一个数字来自图算法,而不是模式匹配。派生的 WORKS_WITH 关系会连接近期编辑过相同文件的人。Bus Factor 使用 GRAPH.COPY 复制图,通过 algo.betweenness 计算该人员的排名,在副本中移除其 Active 标签,再用 algo.WCC 重新计算协作群组,检查哪些人脱离了最大的群组,最后删除副本。对于 Hao Jiang,没有人会因此失去联系。而对于介数中心性排名第一的 Murali Ramanujam,有三个人会失去与主要协作群组的联系。
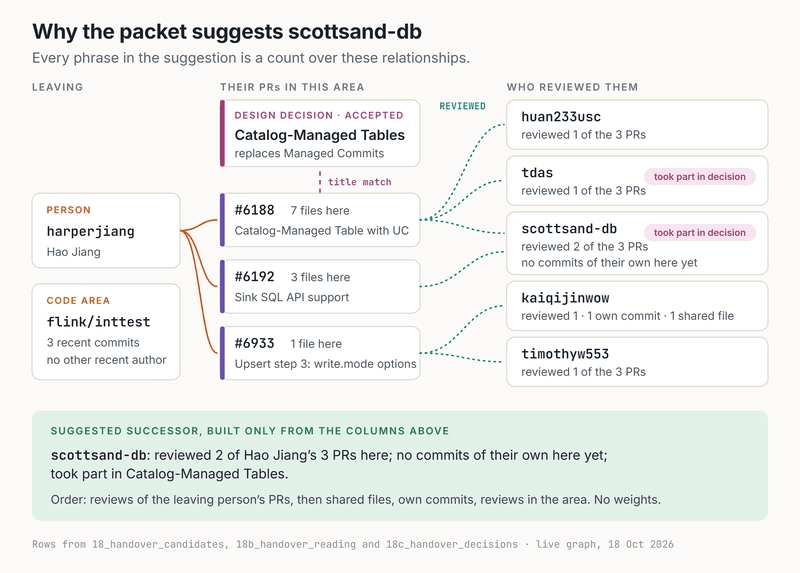
在 flink/inttest 卡片上,点击 Draft handover(起草交接材料),会通过四次查询,在大约十分之一秒内生成一份交接资料。候选人包括近期在该区域编写过代码,或审查过涉及该区域的拉取请求的所有人。每类证据都有独立的列,排序采用直接排序,而非加权评分:首先比较他们审查过多少个离任者在该区域的拉取请求,因为这些审查者已经看过这些具体改动;然后依次比较共同编辑的文件数、自己的提交数,以及在该区域的审查数。
下面是这项推荐背后的关系。拉取请求 #6188 与 Catalog-Managed Tables 之间的连线是虚线,因为这条关系来自标题中的关键词,而非明确引用。
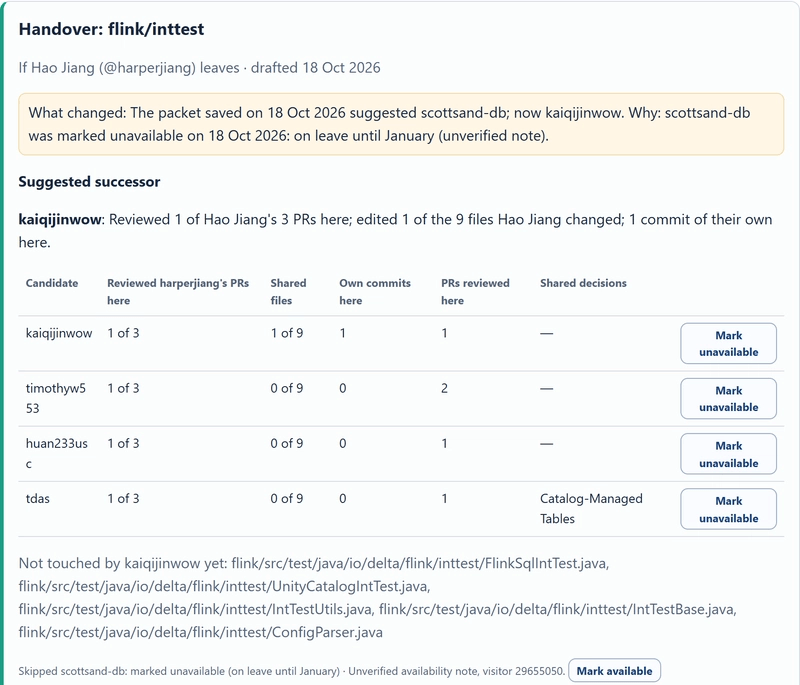
交接资料的顶部包括:建议接手的人选、证据表、该人选尚未修改过的文件,以及应优先阅读的拉取请求。
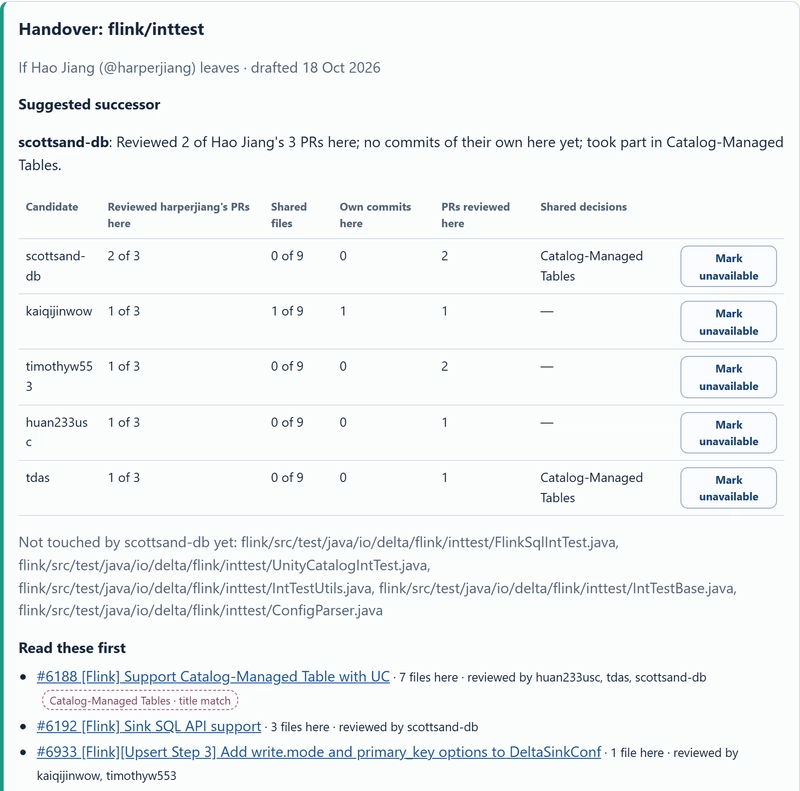
推荐说明中的每个分句都来自表格中的一列,整句话由 Python 根据该行数据拼接而成,并非模型撰写。特意把“尚未在此处提交过自己的代码”放在推荐旁边,是为了明确说明:审查者与作者的身份不同,交接资料也如实呈现这一点。
交接资料再往下,是需要保留的决策,其中的理由引用自跟踪议题 #4381,以及应在 Hao Jiang 离开前询问的问题。
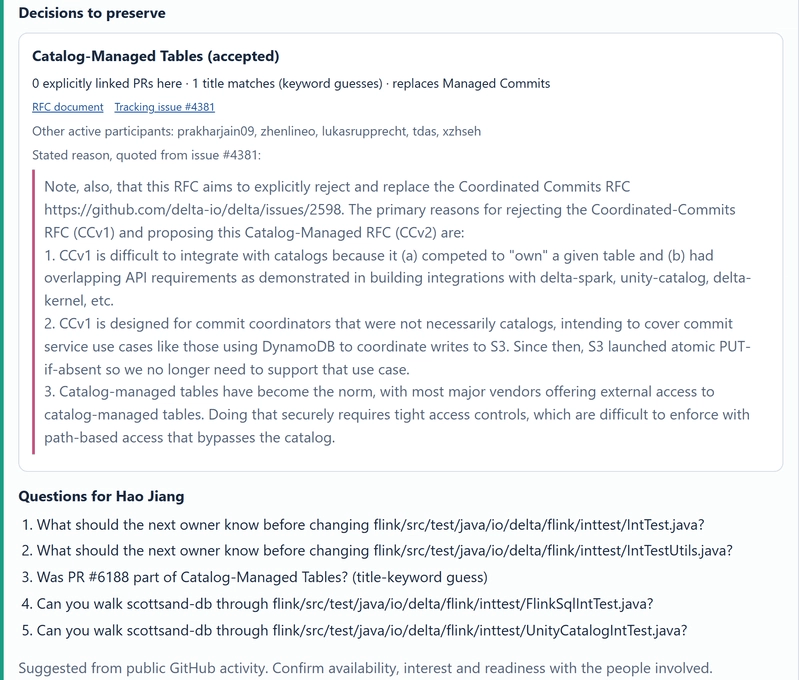
对决策也需要同样诚实。在拉取请求与 RFC 决策之间的 283 条关联中,只有 53 条是明确关联:拉取请求正文引用了 RFC 的跟踪议题,或者拉取请求修改了 RFC 文档。其余 230 条来自标题中的关键词,匹配时以完整单词为单位,避免让“ ICT ”匹配到“conflict”。因此,交接资料会注明“1 条标题匹配(基于关键词的猜测)”,并询问 Hao Jiang:PR #6188 是否确实属于 Catalog-Managed Tables。对于旧版 Managed Commits 设计(在议题 #2598 中以 Coordinated Commits 跟踪)被否决的原因,系统会在加载时从议题 #4381 逐字引用,并将 PR #4382 记录为新设计取代旧设计的证据。
这些都不是人员安排的决策,而是一次沟通的起点:谁看过这些改动,哪些内容他们还没看过,以及趁了解情况的人还在时,应该问些什么。
代码仓库无法知道被推荐的人是否有空。团队需要通过沟通了解这些情况,而一个有用的工具应当记住这些信息,同时不把它们当成提交记录那样的事实。
因此,Bus Factor 将备注保存在独立的图中:mem_team 用于所有人共享的备注,每个浏览器还对应一个 mem_v_<visitor> 图,用于保存该访客的问题和更正。为了撰写这篇文章,我先保存了交接资料,然后输入一条备注,说 scottsand-db“正在休假,直到一月才回来”。这条备注是我为演示虚构的,与任何人的真实计划无关。
仓库事实、未经核实的备注和推导出的建议彼此分开,只有在生成交接资料时才会汇合。
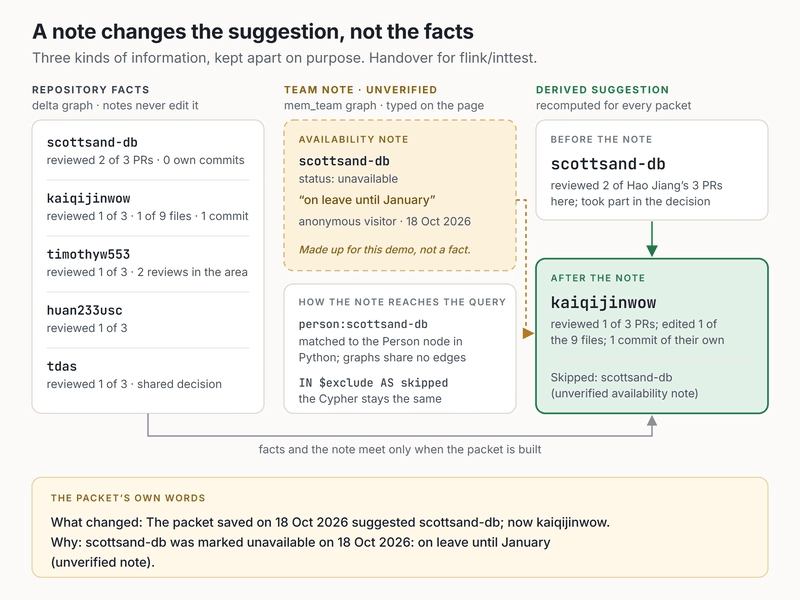
Cypher 无法从一个图遍历到另一个图,因此关联操作在 Python 中完成。这条备注以 person:scottsand-db 为键存储;交接代码收集所有被标记为无法参与的人,将他们的登录名作为 $exclude 传入同一个查询(摘自 18_handover_candidates.cypher,已精简):
WITH cand.login AS login, cand.login IN $exclude AS skipped,
     reviewedTheirPRs, sharedFiles, areaCommits, areaReviews
ORDER BY skipped, reviewedTheirPRs DESC, sharedFiles DESC,
         areaCommits DESC, areaReviews DESC, login
仓库图没有被修改,但下一份交接资料发生了变化:
添加备注后,推荐人选变成了 kaiqijinwow。交接资料说明了相较于已保存版本发生的变化,并将 scottsand-db 列为已跳过,原因是存在一条“未经核实的可用性备注”。
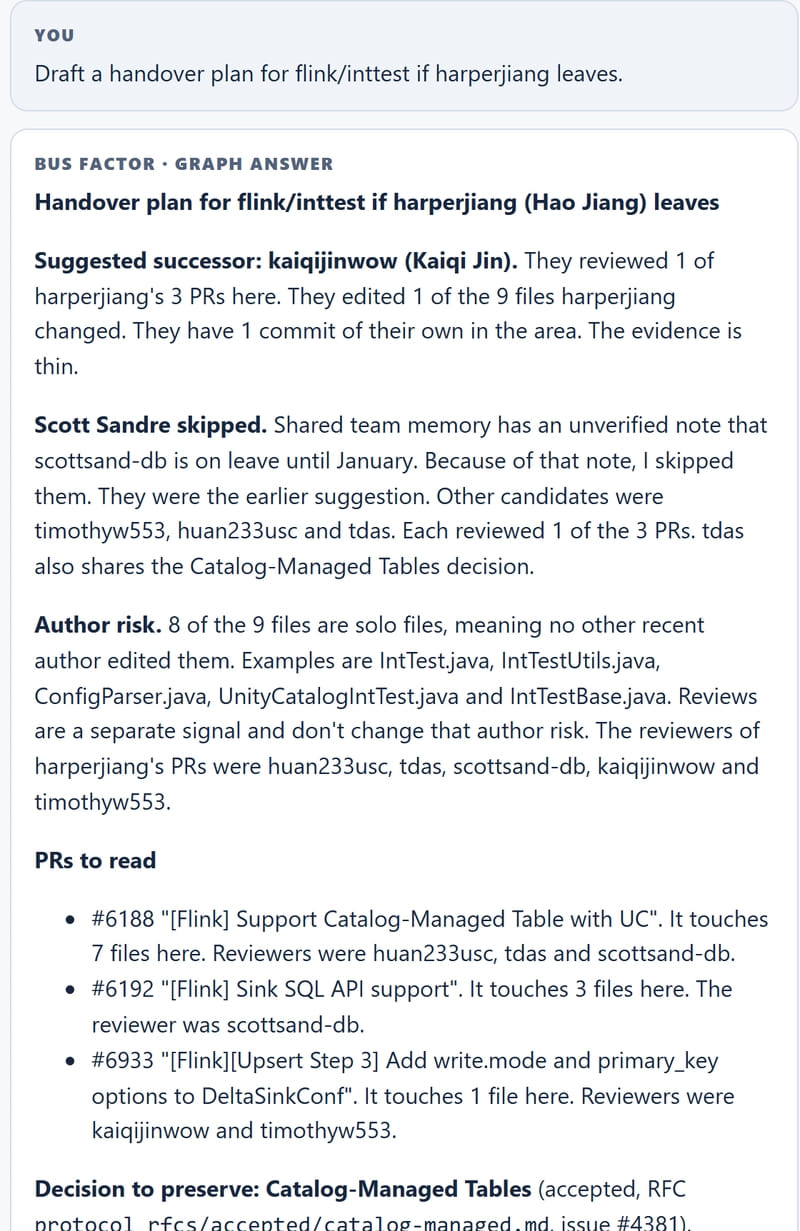
由于这条备注保存在共享记忆中,对话智能体也能看到它。当被要求“如果 harperjiang 离开,为 flink/inttest 起草一份交接计划”时,它调用了同一个 handover_plan 工具,并解释了建议发生变化的原因:
这是智能体的回答。它指出这条备注未经核实,并说明支持新建议的证据较薄弱——事实确实如此——同时将作者流失风险与代码审查情况分开呈现。
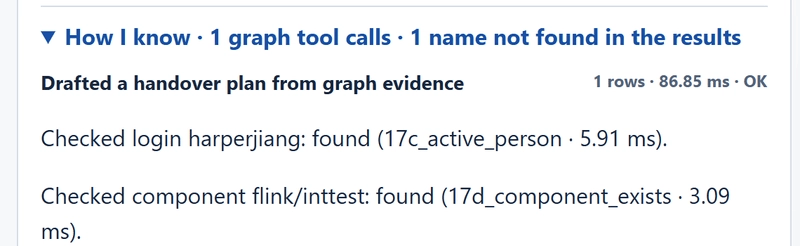
每条回答下方都有“How I know”(判断依据):执行了什么工具、执行前做了哪些名称检查,以及各项耗时。在这次运行中,回答检查发现,答案中有一个名字并未出现在返回的数据行中。
构建它让我学到了什么
查询即使有错,结果也可能看起来很有说服力。87 次中有 42 次,这个数字既合理,又来自真实数据。发现问题的关键,是对照查询的标签检查查询本身;而将每条查询保存在独立且带注释的文件中,让这项检查只花了几分钟。
不同的信号应该放在不同的列中。将提交、审查和共同修改的文件混合成一个专业能力评分,很有诱惑力。但每次我将它们分开,并标明每条关联的可信程度,输出就会变得更容易核查,也更容易质疑。记忆也是如此:备注可以改变建议,但绝不能改变事实。
图数据库也有自己的性能陷阱。在规划将应用部署到一个小型免费实例时,我测量了快照加载过程,发现一个仅占 12 MB 的图,加载时内存峰值竟达到了 681 MB。提交记录加载器会执行合并和删除,因此 FalkorDB 会在写入前将一个批次的所有行保存在内存中,而每个文件行都携带了其所属提交的完整文件列表副本。在 unwind 之后移除这个变量,内存峰值便降到了 51 MB,生成的图完全相同。
它是如何构建的,又由谁构建
这是一个借助 AI 编程助手完成的个人参赛项目,其中的分工很重要。黑客松开始前,我和 Claude 一起规划了这个项目:以人员离职为核心问题、使用 Delta Lake 作为数据源,以及图模型的设计。我确定了工作方式:OpenAI Codex 根据书面任务说明实现每个工作包,Claude Code(Claude Opus 5.5)则对照实际运行的图数据库审查每项成果。我选择 Claude Sonnet 5.5 而非 Opus 来驱动应用中的智能体,因为推理工作由图工具完成;一轮包含五个问题的评估表明,Sonnet 更快,成本约为 Opus 的三分之一。我以新用户的身份测试应用,并写下反馈,推动了一次全面重新设计:用可搜索的维护者列表替代登录名输入框,加入推荐问题,并在每次回答后提供后续问题。随后,我又通过截图重新测试。我安排了提交前的审查,并决定处理哪些发现。当 Codex 达到使用限额后,Claude Code 直接完成了证据展示和交接功能。我借助 Claude Code,根据代码仓库、任务报告和实际运行的图数据库起草了这篇文章,并在发布前进行了审阅。
有效的做法包括:书面任务说明、让审查者对照真实数据库运行所有内容,以及规定每条查询都必须保存在可读的文件中。没能奏效的地方是:有三次,单元测试通过了,实际运行的系统却出了问题。FalkorDB 的错误措辞与代码预期不同,localhost 在 Windows 上引入了两秒延迟,而 Claude API 拒绝了包含超过 24 个可选参数的工具 schema。时间窗口的缺陷也逃过了此前的所有审查。直到某次审查逐个核对数字,追问每个数字是否真的衡量了标签所声称的内容,才发现了这个问题。
它能告诉你什么,又不能告诉你什么
回到周五的那条消息。大约一秒钟内,Bus Factor 就能向团队展示:哪些代码区域将失去唯一一位近期作者,哪些人虽然没有编写这些代码却审查过它们,接手者应该阅读哪些决策和拉取请求,以及应该在对方离开前问些什么。它无法告诉任何人,谁理解这段代……