
8.0
热点
AI SCORE
编程提效2026-10-19 21:22
用DGX Spark承载本地n8n AI工作流
n8n Blog#本地部署#工作流#数据隐私
Editor brief · 编辑速览
文章介绍在NVIDIA DGX Spark上运行无需云端API的n8n AI工作流,面向不能上传客户数据的业务场景。任务涵盖邮件起草、通话摘要、发票读取、内部文档检索和图像生成。
大多数小企业对 AI 的需求都差不多:起草邮件、总结通话、读取发票、搜索内部文档,偶尔再生成一张图片。但其中不少企业无法将客户数据发送到云端 API 来完成这些工作。
原因通常在于数据隐私和数据主权。诊所、律师事务所或会计师事务所持有的记录,可能因合同、监管要求或职业义务而必须始终处于自身控制之下。数据一旦发送到云端 API,就会存放在别人的硬件上,可能位于另一个司法管辖区,并受制于服务商可以更改的条款。在自有硬件上运行模型,可以让数据留在办公场所内,也能向审计人员准确说明数据流向了哪里。
你的 n8n 工作流可以转录通话、读取发票、根据内部文档回答问题,以及起草回复,全程无需向云端 API 发送任何一个字节。本文将介绍如何用一台 NVIDIA DGX Spark 提供这些工作流所需的全部模型,并通过一个兼容 OpenAI 的端点统一对外提供服务,而 n8n 的 OpenAI 节点已经支持这种接口。
DGX Spark 配备了由 CPU 和 GPU 共享的 128GB 统一内存。只要选对模型,就足以让完成上述所有任务所需的模型同时驻留内存。本文的大部分内容都围绕这一点展开。
自托管 AI 入门套件让个人能够在笔记本电脑上运行本地模型。这里要更进一步:在办公室部署一台为整个团队提供服务的设备,为每类任务配备相应模型,并提供运行它们的代码。
本文将带你:
DGX Spark 的 GB10 Grace Blackwell Superchip 内存读取带宽为 273 GB/s。模型生成文本时,每生成一个 token,都要从内存中读取其活跃权重,因此读取的字节越少,运行速度就越快。
混合专家(MoE)模型每处理一个 token,只会激活少数几个专家。Qwen3.6-35B-A3B 总共有 35B 参数,但活跃参数约为 3B。以 NVFP4(NVIDIA 的 4 位浮点格式)存储时,这些活跃权重的体积仅为稠密模型的一小部分。
在我的 DGX Spark 上,Qwen3.6-35B-A3B 为单个用户生成文本的速度达到每秒 120 个 token,八个用户同时使用时,总吞吐量达到每秒 359 个 token。这些数字包含模型在作答前生成的推理 token。
由此得到第一条设计原则:用一个能力强的 MoE 模型处理所有文本类任务。摘要、分类、提取、起草、编程和读取截图,都交给同一个模型。每增加一个模型,就多一个需要固定版本、打补丁和监控的容器,因此,只有在 LLM 无法胜任的任务上,才为专用模型分配位置。
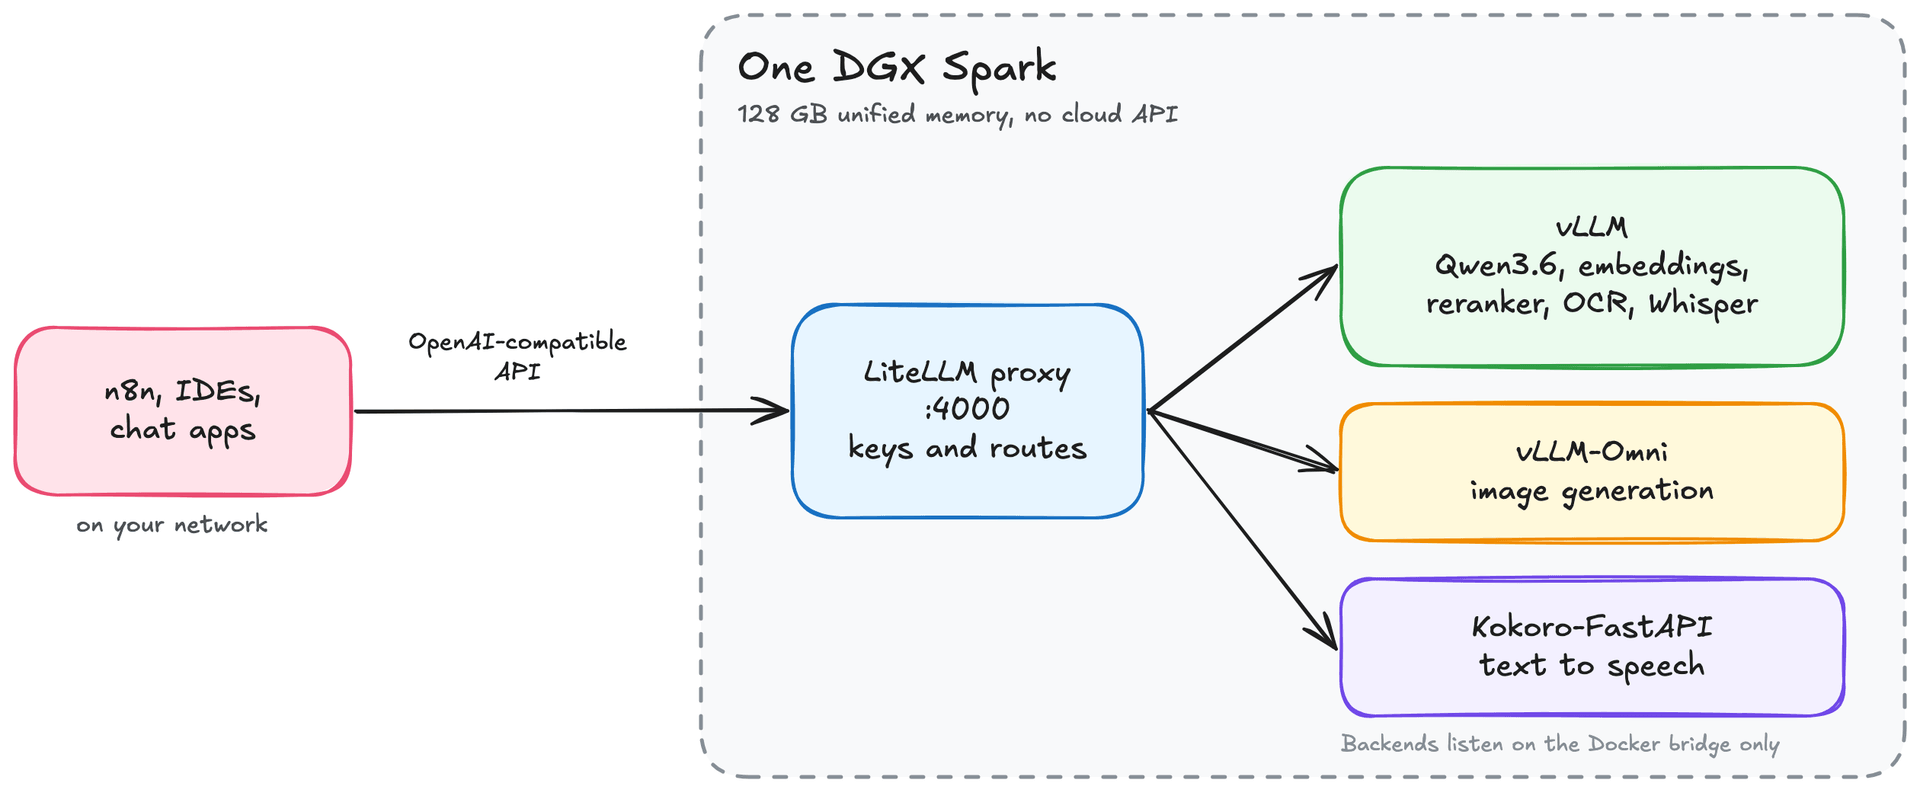
以下这些模型会常驻在一台 DGX Spark 的内存中:
这套技术栈中的所有模型都允许商业使用。这条要求带来的取舍,比任何技术要求都大,后文会专门讨论。
这套技术栈必须在拔掉网线后仍能运行,因此需要先下载所有模型,并记录实际下载的确切提交版本。下面的循环会缓存各个模型,并将仓库和提交版本写入锁定文件:
pipx install "huggingface_hub[cli]"
hf auth login

for repo in nvidia/Qwen3.6-35B-A3B-NVFP4 Qwen/Qwen3-Embedding-4B Qwen/Qwen3-Reranker-0.6B \
            openai/whisper-large-v3-turbo zai-org/GLM-OCR Tongyi-MAI/Z-Image-Turbo; do
  hf download "$repo"
  echo "$repo $(cat ~/.cache/huggingface/hub/models--${repo//\//--}/refs/main)" >> models.lock
done
启动模型时,通过 --revision 传入 models.lock 中的提交版本。这样,vLLM 加载的就是你测试过的权重,而不是当天 main 所指向的版本,上游变更也就无法悄然替换你使用的权重或许可证。
容器也要以同样的方式固定版本,并检查其中实际包含的内容。我第一次尝试使用了 vLLM 的 cu130-nightly 标签。这个标签已经停止更新,拉取到的镜像是五个月前的,其中搭载的是 vLLM 0.19,根本无法加载 Qwen3.6。报错并没有提到版本问题,而是因缺少权重缩放参数触发了 KeyError,看起来像是检查点损坏了。
在信任一个镜像之前,先打印其中的 vLLM 版本:
docker run --rm --entrypoint python3 <image> -c "import vllm; print(vllm.__version__)"
最终可用的是官方的 vllm/vllm-omni:v0.30.0 镜像,其中包含 arm64 构建的 vLLM 0.30.0。vLLM-Omni 在完整的 vLLM 基础上,额外提供了图像和语音服务模式,因此也能部署普通 LLM。它的默认入口点不是 vllm serve,所以需要简单封装一下:
printf 'FROM vllm/vllm-omni:v0.30.0\nENTRYPOINT ["vllm", "serve"]\n' | docker build -t vllm-spark:omni-0.30.0 -
Kokoro-FastAPI 镜像需要应用社区提供的修复,才能在 arm64 上构建。所用 Dockerfile 来自 swann.schilling 在 NVIDIA Developer Forums 发布的一篇帖子。
下面这条命令会在 vLLM 中启动主模型:
docker run -d --name qwen3.6 --gpus all --ipc=host \
  -p 172.17.0.1:8001:8000 \
  -e HF_HUB_OFFLINE=1 -e VLLM_API_KEY=<your-backend-key> \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  vllm-spark:omni-0.30.0 \
  nvidia/Qwen3.6-35B-A3B-NVFP4 --revision <commit-from-models.lock> \
  --served-model-name qwen3.6-35b \
  --gpu-memory-utilization 0.32 --max-model-len 65536 \
  --max-num-seqs 8 --max-num-batched-tokens 8192 \
  --trust-remote-code --kv-cache-dtype fp8 --moe-backend marlin \
  --enable-chunked-prefill --async-scheduling --enable-prefix-caching \
  --speculative-config '{"method":"mtp","num_speculative_tokens":3,"moe_backend":"triton"}' \
  --reasoning-parser qwen3 --enable-auto-tool-choice --tool-call-parser qwen3_xml \
  --host 0.0.0.0 --port 8000
在我的 DGX Spark 上,从执行 docker run 到模型准备好提供服务,用了 311 秒。
端口绑定在 Docker 的网桥地址 172.17.0.1 上,因此只有这台机器上的容器才能访问。VLLM_API_KEY 则会让 vLLM 拒绝所有未携带密钥的请求。
在 DGX Spark 上,最关键的参数如下:
--gpu-memory-utilization 0.32 将该模型的内存用量限制在总内存的大约三分之一,其余部分需要留给其他模型。--kv-cache-dtype fp8 将 KV 缓存所需的内存减半,让相同的内存预算能够容纳更多上下文。--moe-backend marlin 为量化后的专家层选择计算内核。草稿模型的专家未经过量化,因此需要在 --speculative-config 中单独设置它的 moe_backend。--speculative-config 开启多 token 预测(MTP)。模型会提前拟定三个 token,再通过一次前向计算验证它们。--reasoning-parser 和 --tool-call-parser 必须与模型家族匹配。工具调用失败时,先检查这些参数,再判断是不是模型的问题。检查启动日志,确认 vLLM 选择了哪些计算内核。以下内容来自我实际运行时的日志:
Using MarlinNvFp4LinearKernel for NVFP4 GEMM
Using 'MARLIN' NvFp4 MoE backend out of potential backends: ['FLASHINFER_TRTLLM', 'FLASHINFER_CUTEDSL', ...]
Your GPU does not have native support for FP4 computation but FP4 quantization is being used.
Weight-only FP4 compression will be used leveraging the Marlin kernel.
最后一条警告很关键,它决定了你该如何理解 DGX Spark 上的“NVFP4”。在这个 vLLM 构建版本中,权重以 4 位格式存储,但计算使用的是 16 位精度。你仍然能获得大部分收益,因为 token 生成速度受限于从内存读取权重的速度,而 4 位权重的体积只有 16 位权重的四分之一。后续构建版本如果引入更快的 GB10 FP4 内核,这些性能数据可能还会提高。
在 DGX Spark 上,GPU 和操作系统共享同一个 128GB 内存池。在我的设备上,Linux 报告的总内存为 121GB。这会改变你在使用独立 GPU 时可能习以为常的两件事。
首先,--gpu-memory-utilization 表示启动时按整个内存池计算的占用比例,并不是空闲内存的比例。如果不设置上限,一个实例就会尝试占用几乎全部内存,导致下一个模型启动失败。
其次,vLLM 会根据启动时的空闲内存来确定缓存大小。如果同时启动两个模型,它们就会争抢同一块内存。应该逐个启动,并等每个模型通过健康检查后,再启动下一个:
until curl -sf http://172.17.0.1:8001/health; do sleep 5; done
如果模型报出 CUDA error: out of memory,但 free 显示仍有大量可用内存,说明内存被 Linux 页缓存占用了。刚下载完 220GB 权重后,这种情况很常见。清理缓存,然后重新启动模型:
sudo sh -c 'sync; echo 3 > /proc/sys/vm/drop_caches'
下面是各项服务在预先清理页缓存后,从冷启动到加载完成所需的时间,以及各自占用的内存:
嵌入模型在 vLLM 0.30.0 上还需要额外添加一个参数 --convert embed,并且要等其余模型启动后再启动。全部七个模型加载完成后,DGX Spark 使用了 108GB 内存,还剩 13GB 可用。这已经是一台 DGX Spark 所能容纳的极限。要在有人需要使用之前提前启动整套服务:表中的六个服务大约花了 12 分钟才启动完毕。
vLLM 也可能在启动时出现 Error in memory profiling。原因是在 vLLM 测量可用内存期间,另一个进程释放了内存。在共享内存环境下,如果另一个模型正在加载或关闭,就可能发生这种情况。等机器上的其他操作平息后,重新启动该模型即可。
LiteLLM 为所有客户端提供一个兼容 OpenAI 的统一端点。每项任务都有一个命名路由,因此你可以替换路由背后的模型,而无需修改任何客户端。LiteLLM 的开源版本还支持虚拟密钥、团队和预算管理。
LiteLLM 的 config.yaml 中,每个路由都指向一个后端。下面的片段展示了其中三个:
model_list:
  - model_name: qwen3.6                 # main model: chat, coding, vision, extraction
    litellm_params:
      model: hosted_vllm/qwen3.6-35b
      api_base: http://host.docker.internal:8001/v1
      api_key: os.environ/BACKEND_API_KEY

- model_name: whisper
    litellm_params:
      model: openai/whisper-large-v3-turbo
      api_base: http://host.docker.internal:8101/v1
      api_key: os.environ/BACKEND_API_KEY
    model_info:
      mode: audio_transcription

- model_name: image                   # Z-Image-Turbo on vLLM-Omni
    litellm_params:
      model: openai/z-image-turbo
      api_base: http://host.docker.internal:8103/v1
      api_key: os.environ/BACKEND_API_KEY
    model_info:
      mode: image_generation

litellm_settings:
  drop_params: true                     # needed for the image route, see below

general_settings:
  master_key: os.environ/LITELLM_MASTER_KEY
  database_url: os.environ/DATABASE_URL
保留 drop_params: true。如果没有这项设置,LiteLLM 会拒绝任何设置了 response_format 的图像请求,并返回 400 错误,因为它没有为自托管图像模型映射这个字段。启用后,LiteLLM 会丢弃该字段,而 vLLM-Omni 仍然会以 base64 格式返回图像。
LiteLLM 也运行在 Docker 中。为了让它能够访问后端,需要在它的 Compose 服务配置中将 host.docker.internal 映射到宿主机:
    extra_hosts:
      - "host.docker.internal:host-gateway"
后端只监听 Docker 的桥接网络,并要求使用共享密钥,因此只有 LiteLLM 会暴露在办公网络中。让 LiteLLM 连接桥接网络地址,而不是机器的局域网地址。如果使用局域网地址,后端会拒绝连接,因为它们并没有监听那个地址。
通过镜像摘要固定 LiteLLM 版本,并使用 1.84.0 或更高版本。2026 年 3 月,PyPI 上的两个发布版本被植入了后门,而 1.84.0 修复了两处身份验证绕过漏洞。我使用的是 1.99.1。
现在,任何 OpenAI 客户端都可以连接 DGX Spark。下面的 Python 示例通过同一个客户端调用三个不同的模型:
from openai import OpenAI

client = OpenAI(base_url="http://<spark-ip>:4000/v1", api_key="<your-litellm-key>")

reply = client.chat.completions.create(
    model="qwen3.6",
    messages=[{"role": "user", "content": "Draft a two-line reply confirming Tuesday's delivery."}],
)

with open("call.wav", "rb") as audio:
    transcript = client.audio.transcriptions.create(model="whisper", file=audio)

image = client.images.generate(
    model="image",
    prompt="a delivery van outside a bakery at dawn",
    size="1024x1024",
    extra_body={"num_inference_steps": 8},
)
num_inference_steps 不是 OpenAI 参数,所以要放在 extra_body 中。LiteLLM 会将它透传给 vLLM-Omni。下一节会解释它为什么重要。
n8n 的 OpenAI 凭据支持自定义 Base URL,因此 n8n 可以像调用 OpenAI 一样调用 DGX Spark。要让 n8n 连接 DGX Spark,请按以下步骤操作:
为工作流所属团队创建一个 LiteLLM 虚拟密钥,并将其权限限制在团队需要的路由内。下面的命令使用 LiteLLM 主密钥创建虚拟密钥,并将其打印出来:
curl -s http://<spark-ip>:4000/key/generate \
  -H "Authorization: Bearer <your-litellm-master-key>" -H 'Content-Type: application/json' \
  -d '{"key_alias": "n8n-accounts", "models": ["qwen3.6", "ocr"]}'
在 n8n 中,创建一个 OpenAI 凭据。
在 API Key 中填入虚拟密钥。
将 Base URL 设置为 http://<spark-ip>:4000/v1。
每个团队都有自己的虚拟密钥,因此即使没有按 token 计费,LiteLLM 仍然可以按团队跟踪费用和用量。
要在 AI 智能体或 Basic LLM Chain 中使用 DGX Spark,请添加一个使用该凭据的 OpenAI Chat Model 节点,并通过 By ID 将模型设置为某个 LiteLLM 路由名称,例如 qwen3.6。然后,在节点选项中关闭 Use Responses API。从 1.3 版本开始,该节点默认调用 OpenAI 较新的 Responses API,而 DGX Spark 上的模型通过 chat completions 提供服务。
这个工作流会提供一个网页表单。上传发票图片后,表单会显示供应商、发票号码、日期和总金额,整个过程完全不调用云端服务。获取模板。
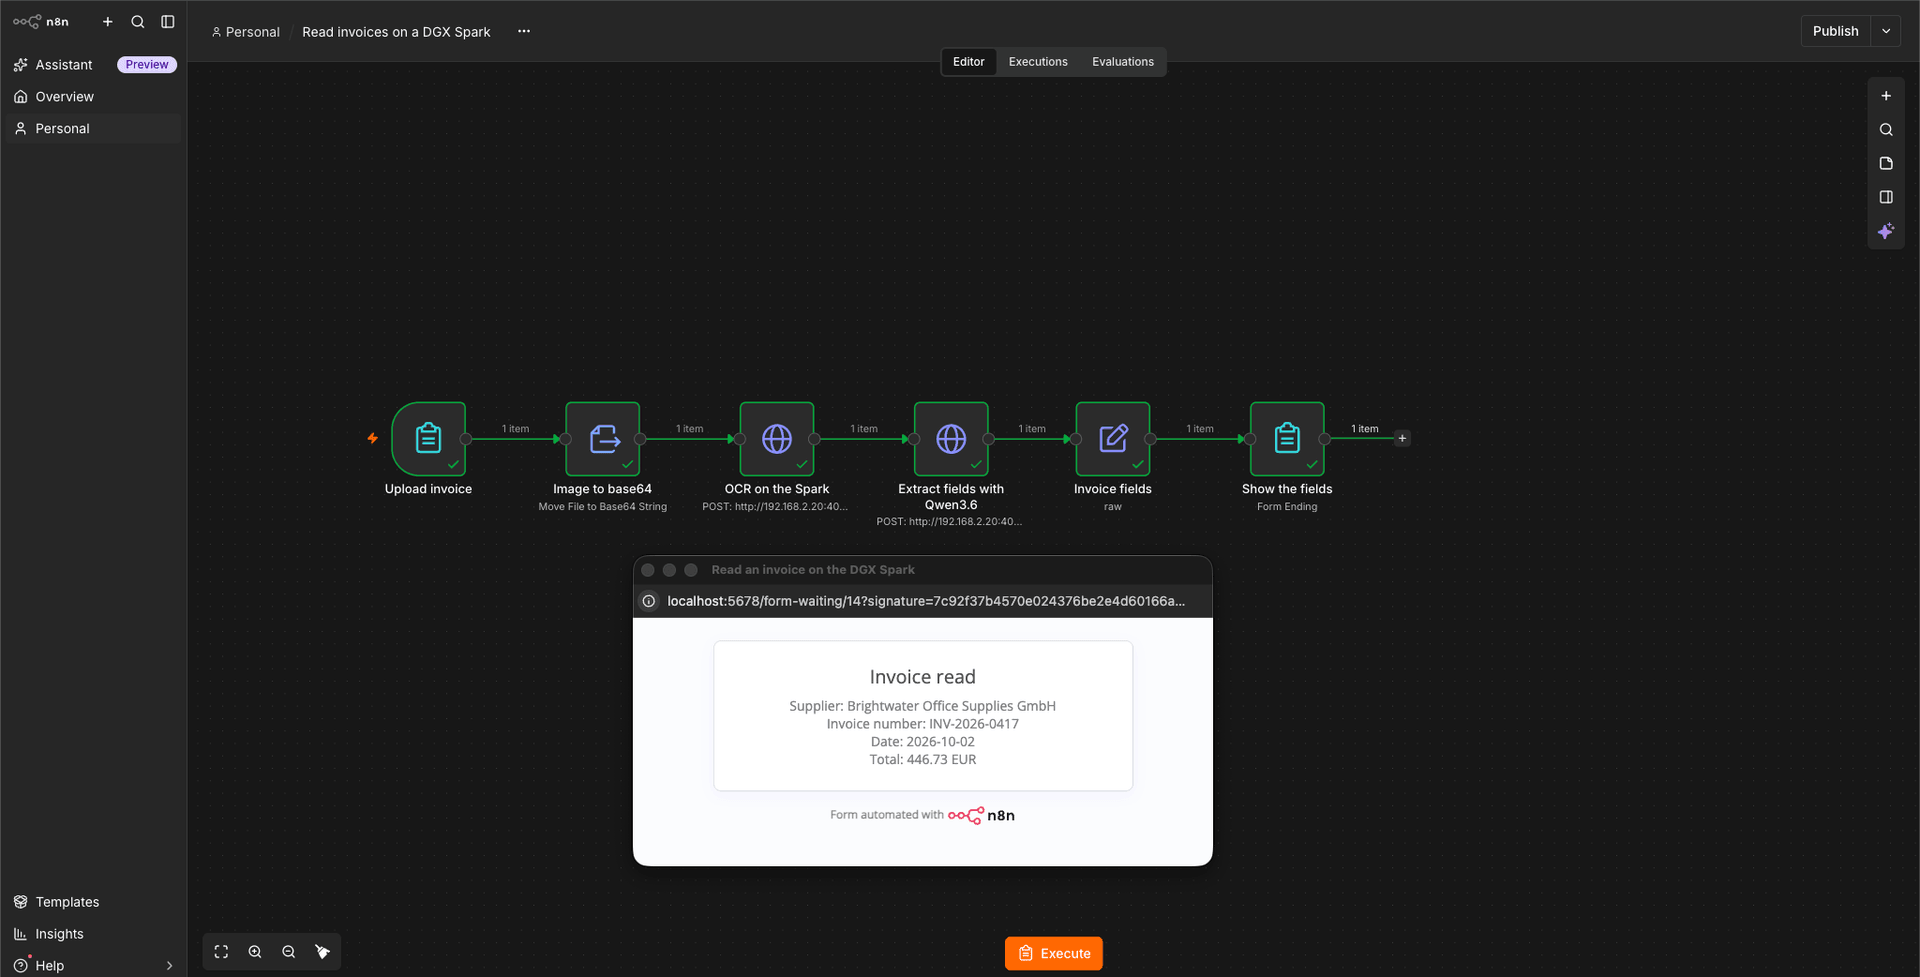
Upload invoice(n8n Form Trigger)提供一个只有一个文件字段的表单。
Image to base64(Extract from File)将上传文件转换为 base64 字符串。
OCR on the DGX Spark(HTTP Request)将图像发送到 ocr 路由,并获取页面的文本内容。
Extract fields with Qwen3.6(HTTP Request)要求 qwen3.6 以 JSON 格式返回供应商、发票号码、日期、总金额和币种。
Invoice fields(Edit Fields)将回复转换为一个包含这五个字段的数据项。
Show the fields(Form Ending)在表单结果页上显示这些字段。
要自动归档发票,可以将表单替换为 Email Trigger (IMAP) 节点,将结果页替换为 Postgres 或 Google Sheets 节点。
两个 HTTP Request 节点都使用上一节中的 OpenAI 凭据,因此发送的是同一个密钥。这里使用 HTTP Request 而不是 OpenAI 节点,是因为每次调用都需要一个 OpenAI 节点无法设置的字段:OCR 调用需要传入图像,字段提取调用需要设置思考开关。以下是字段提取请求的请求体:
{
  model: 'qwen3.6',
  max_tokens: 512,
  temperature: 0,
  chat_template_kwargs: { enable_thinking: false },
  messages: [{ role: 'user', content: 'Extract supplier name, invoice number, invoice date, total amount and currency from this OCR text. Reply with one JSON object and nothing else. Use null for anything missing.\n\n' + $json.choices[0].message.content }]
}
chat_template_kwargs 会关闭模型在此次调用中的思考功能,速度提升就来自这里。我用一张清晰的单页示例发票进行了测试:
开启思考时,模型先生成了 1,538 个推理 token,然后才给出一个 78 token 的答案。关闭思考后,它在不到一秒的时间里正确提取了全部五个字段。对于固定格式的信息提取,应关闭思考功能。
OCR 正确读取了每个明细项和总金额,但漏掉了增值税识别号中的一个零。归档前要校验这些标识号码。表单接受 PNG 和 JPEG 文件。PDF 发票需要先转换为图像,因为 GLM-OCR 接收的是图像。
扫描或拍摄的发票比这张清晰的页面更难识别,因此在依赖 OCR 之前,请先用自己的文档进行测试。
通话摘要:Whisper 转录录音,qwen3.6 生成摘要,再由 Kokoro 将摘要读出来,用作语音留言或内部情况通报。
基于自有文档回答问题:embed 将文档嵌入并写入向量存储,rerank 对匹配结果重新排序,再由运行在 qwen3.6 上的 AI 智能体根据这些结果作答。
所有数据都来自 2026 年 10 月 13 日的一次基准测试,使用 vLLM 0.30.0,并固定了各模型的提交版本。使用不同的镜像、模型或提示词,结果会有所不同。每条聊天提示词都以一个随机标签开头,避免前缀缓存让测试结果显得过于理想。
单用户速度是各请求生成速度的中位数,从首个 token 之后开始测量。总吞吐量则是生成的全部 token 数除以测试耗时,因此也包含首 token 等待时间,以及较慢请求带来的影响。在单用户测试中,五个请求里有一个的速度为每秒 43 token,其余四个为每秒 117 至 129 token,这将总吞吐量拉低到了每秒 87 token。
提示词长度为 8,537 token 时,首 token 延迟为 1.14 秒。
随着用户增加,单用户速度会下降,但总吞吐量会继续上升。这就是批处理发挥作用的结果:vLLM 每次遍历模型权重时,都会同时为多个用户提供服务。
语音处理在两个方向上都远快于实时速度:无论是转录还是合成,30 秒的音频都能在不到一秒内处理完成。Whisper 的转录内容准确,但它在末尾添加了一句音频中并不存在的“Thank you.”。Whisper 在静音片段中凭空生成文本是一个已知问题,因此转录前应先裁掉末尾的静音。
请自行设置图像生成的步数。Z-Image-Turbo 的设计目标是用大约 8 步生成一张图像,但 vLLM-Omni 默认运行了大约 48 步,每步耗时 1.5 秒,导致每张图像需要 72 秒。改为 8 步后,同样一张 1024x1024 图像只需 12.2 秒。
生成图像时进行聊天
这台机器上的所有模型共用一块 GPU。内存装得下,并不意味着它们能一起高效运行。我没找到已发布的 DGX Spark 相关基准测试,因此自己做了测量。我使用服务端默认步数,连续生成 1024px 图像,同时再次运行聊天测试。
在生成图像期间,聊天速度降到了正常水平的大约三分之一,图像生成也变慢了,耗时从 73 秒增加到 85 至 122 秒。
一台 DGX Spark 能容纳整套技术栈,但生成图像时会拖慢所有人的聊天。对于小团队,可以让图像任务排队执行,或安排在非工作时间运行。一旦图像生成成为日常工作的一部分,就把媒体处理迁移到第二台 DGX Spark,第一台专门用于文本处理。
难点不在模型质量,而在许可证。
一些最好的开放文本转语音模型和图像模型不允许商业使用。与 Z-Image-Turbo 竞争的 FLUX 模型,要么仅限非商业用途,要么需要另行付费获取许可证。截至撰稿时,最强的开放图像模型 Qwen-Image-2.1 采用研究用途许可证。有些仓库甚至会在采用宽松许可证的原版之外,另设一个非商业版本,因此缓存时选错仓库 ID,就会改变适用的许可证。
这套技术栈遵循以下规则:
只允许使用 Apache 2.0、MIT、CC-BY-4.0、OpenMDW 和 NVIDIA Open Model License。
将每个模型固定到一个 Hugging Face 提交,避免上游许可证变更在不知情的情况下进入系统。
在文档中为采用 CC-BY-4.0 许可证的模型注明署名信息。
这不构成法律建议。在将这套系统出售或为客户部署之前,请安排专人审核每个固定版本的许可证。
新的模型检查点可能需要比你固定的版本更新的 vLLM,而报错信息不会明确指出这一点。请先检查镜像内的版本。
faster-whisper 没有适用于 arm64 的 CUDA 构建版本,因此基于它构建的工具会在 CPU 上运行,而且不会提示你。
这套技术栈使用的是 vLLM,而不是入门套件自带的 Ollama。Ollama 适合个人在笔记本电脑上使用。对于团队,vLLM 会将多个用户的请求合并成批次,在每次遍历模型权重时一并处理,这正是其多用户吞吐能力的来源。
导入发票工作流模板。
如果你还没有 DGX Spark,可以先从自托管 AI 入门套件起步。
如果你在自己的 DGX Spark 上运行了这套系统,欢迎在 n8n 社区论坛分享你的测试数据。
n8n 用户有着不同的背景、经验水平和兴趣。我们一直希望通过博客文章,展示不同用户及其项目。如果你正在使用 n8n,并希望为社区带来启发,欢迎联系我们 💌