
8.0
热点
AI SCORE
编程提效2026-10-18 22:01
多 Agent 并行开发,数据库也要隔离
dev.to · AI#多智能体#数据库#开发环境
Editor brief · 编辑速览
多个 worktree 共用开发数据库时,一个 Agent 的迁移可能破坏另一个 Agent 的测试,引发错误修复。文章利用 Postgres 18 在适配文件系统上的低成本克隆,为每个 worktree 创建独立数据库并在结束后清理。
书籍:Database Playbook
我的另一个作品:Thinking in Go(两本书的系列)—— Go 编程完整指南 + Go 中的六边形架构
我的项目:Hermes IDE | GitHub —— 面向使用 Claude Code 和其他 AI 编程工具交付软件的开发者的 IDE
关于我:xgabriel.com | GitHub
一个 Agent 正在 ../app-auth 里,把 users.email 重命名为 users.login_email。另一个 Agent 在 ../app-invoices 里,马上要运行测试套件。每个 worktree 都有自己的分支、自己的文件、自己的 node_modules。但两个 .env 文件都指向同一个 app_dev 数据库。迁移一执行,invoices 的测试就因为 column users.email does not exist 报错而失败,第二个 Agent 随即开始修复原本没有问题的代码。
Worktree 给了每个 Agent 一份独立的代码,却没有隔离数据库。在开发机上,大家通常共用一个 Postgres。老办法是每个分支使用一个数据库,但过去这意味着每次都要完整复制一份已经填充好初始数据的数据库。Postgres 18 让这次复制在合适的文件系统上几乎不再产生额外开销。下面这份简短的脚本,会为每个 worktree 创建独立的数据库克隆,并在分支完成后清理它。
git worktree 允许一个仓库“同时检出多个分支”,每个分支各占一个目录。这也是那些并行运行多个编程 Agent 的工具建立在它之上的原因:不会有两个 Agent 编辑同一份检出目录。但仓库之外的一切仍然共享,而数据库恰好就是 Agent 会写入的共享资源。
迁移是在共享资源上修改 schema。一个会清空表的 seed 脚本,可能抹掉另一个 Agent 的测试数据;一个统计行数的测试,也可能因为别处插入了数据而时好时坏。你看到的结果,就是不相干的 worktree 里测试突然变红,而 Agent 还会积极尝试修复它。
你可以为每个 worktree 单独运行一个 Postgres 服务器,各用一个端口。这样确实可行,代价是每个 Agent 都要多占用一个服务器进程,并完整复制一份数据。只运行一个服务器、为每个 worktree 分配一个数据库会更轻量,前提是创建数据库足够便宜。
代码各自检出,数据库却只有一个:一个 worktree 的迁移,会破坏另一个 worktree 的测试。

CREATE DATABASE new TEMPLATE old 一直都能复制数据库。从 Postgres 15 开始,默认 STRATEGY 是 WAL_LOG:逐块复制模板,并把每个块写入预写日志。CREATE DATABASE 文档称它是“模板数据库较小时最高效的策略”。更早的 FILE_COPY 策略则在文件系统层面复制,每个 tablespace 只写入一条很小的 WAL 记录,代价是在复制前后各执行一次 checkpoint。
2025-09-25 发布的 Postgres 18 新增了一个名为 file_copy_method 的服务器变量,由 Nazir Bilal Yavuz 贡献。默认值是 copy。按照配置文档的说明,将它设为 clone 后,FILE_COPY 会在 Linux 和 FreeBSD 上使用 copy_file_range(),在 macOS 上使用 copyfile,“让内核有机会共享磁盘块”。在写时复制文件系统上,新数据库会指向模板的数据块,只有其中一方发生写入时,两者对应的数据块才会分开。
下面三个要素必须在同一个会话中配合使用:
SET file_copy_method = clone;
CREATE DATABASE wt_agent_auth
  TEMPLATE app_template
  STRATEGY = FILE_COPY;
如果省略 STRATEGY = FILE_COPY,就会使用 WAL_LOG,而它会完全忽略 file_copy_method。这个设置的 context 是 user,不需要重启(postgresqlco.nf),所以执行一条普通的 SET 就够了,不必修改 postgresql.conf。
公开的性能数据说明了为什么值得折腾。Radim Marek 克隆一个 6,289 MB 的数据库,使用 WAL_LOG 耗时 67,000 ms,使用 FILE_COPY 加 clone 只用了 212 ms。Ruohang Feng 报告,在 NVMe 上克隆一个 120 GB 的数据库大约需要 200 ms,克隆 797 GB 大约需要 569 ms。这些都是他们各自机器上的结果。后面的脚本部分会介绍如何测出你自己机器上的数据。
克隆会一直共享模板的数据块,直到有人写入;只有发生变化的数据块才会拥有独立副本。
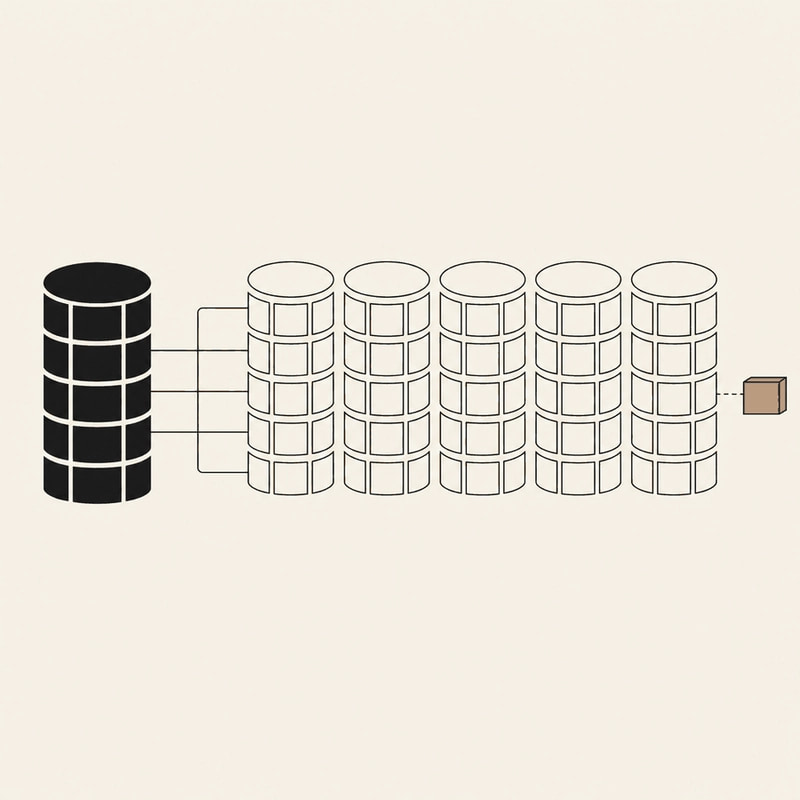
Clone 只有在写时复制文件系统上才能共享数据块:macOS 上的 APFS、支持 reflink 的 XFS、Btrfs,或者 ZFS(按照 Feng 的说明,需要 OpenZFS 2.2+,并启用 block cloning)。Christophe Pettus 对 ext4 的情况说得很直接:“ext4 上没有东西可以做 reflink。”
至于 ext4 上到底会发生什么,不同资料的说法并不一致。Pettus 写道,clone“会失败,而不是悄悄退回普通复制”。Feng 的表格则说,ext4“会退回传统复制”。Postgres 代码本身没有实现回退:系统调用失败时,clone_file() 会抛出错误;不过,Linux 循环中的一条注释提到,内核可能“退回较慢的复制”。在 macOS 上,它传入的是 COPYFILE_CLONE_FORCE,Apple 的 copyfile 手册明确说明,“如果克隆失败”,就会返回错误。无论你的环境最终走哪条路径,不支持 reflink 的文件系统都不会帮你节省什么。以此为基础搭建流程之前,先检查清楚。
真正需要检查的是 Postgres 数据目录所在的文件系统,而不是代码仓库所在的文件系统。如果 Postgres 运行在容器中,就在容器内部检查。
dir="$(psql -d postgres -Atc 'SHOW data_directory')"

# Linux: xfs, btrfs or zfs are good; ext4 is not
findmnt -no FSTYPE -T "$dir"
# XFS only: reflink=1 means clones can share blocks
xfs_info "$(findmnt -no TARGET -T "$dir")" | grep -o 'reflink=.'

# macOS: you want "APFS"
diskutil info "$(df "$dir" | awk 'END {print $NF}')" \
  | grep Personality
SHOW data_directory 需要超级用户权限,或者拥有 pg_read_all_settings 的角色。如果 Postgres 不接受将 file_copy_method 设为 clone,说明你使用的构建版本不支持 clone:引入这项功能的提交,只有在平台具备 copy_file_range,或者具备支持 clone 的 copyfile 时,才会把这个选项编译进去。
wt-db 提供三个命令。template 根据你的迁移和 seed 构建 app_template,然后将它锁定。clone <worktree> 创建一个以该 worktree 分支命名的数据库,并把连接 URL 写入这个 worktree 的 .env。drop <worktree> 则负责删除数据库。
#!/usr/bin/env bash
# wt-db: one cloned Postgres 18 database per git worktree.
# Uses PGHOST/PGUSER/PGPORT like psql does. MIGRATE is the
# command that migrates and seeds the DB in $DATABASE_URL.
set -euo pipefail

TEMPLATE="${TEMPLATE:-app_template}"
PGPORT="${PGPORT:-5432}"
: "${PGHOST:?set PGHOST}" "${PGUSER:?set PGUSER}"

sql() { psql -X -d postgres -v ON_ERROR_STOP=1 "$@"; }
url() { echo "postgres://$PGUSER@$PGHOST:$PGPORT/$1"; }

db_name() {
  local branch
  branch="$(git -C "$1" branch --show-current)"
  if [ -z "$branch" ]; then
    echo "no branch checked out in $1" >&2
    exit 1
  fi
  branch="$(tr 'A-Z' 'a-z' <<<"$branch" | tr -c 'a-z0-9\n' '_')"
  echo "wt_${branch:0:60}"
}

set_env() {
  local file="$1" value="$2" tmp
  tmp="$(mktemp)"
  if [ -f "$file" ]; then
    grep -v '^DATABASE_URL=' "$file" > "$tmp" || true
  fi
  echo "DATABASE_URL=$value" >> "$tmp"
  mv "$tmp" "$file"
}

build_template() {
  : "${MIGRATE:?set MIGRATE}"
  sql <<SQL
SELECT format('ALTER DATABASE %I IS_TEMPLATE false', datname)
FROM pg_database WHERE datname = '$TEMPLATE' \gexec
DROP DATABASE IF EXISTS "$TEMPLATE" WITH (FORCE);
CREATE DATABASE "$TEMPLATE";
SQL
  DATABASE_URL="$(url "$TEMPLATE")" bash -c "$MIGRATE"
  sql <<SQL
ALTER DATABASE "$TEMPLATE"
  IS_TEMPLATE true ALLOW_CONNECTIONS false;
SQL
}

clone() {
  local wt="$1" db
  db="$(db_name "$wt")"
  sql <<SQL
SELECT count(pg_terminate_backend(pid)) AS kicked
FROM pg_stat_activity WHERE datname = '$TEMPLATE';
SET file_copy_method = clone;
\timing on
CREATE DATABASE "$db" TEMPLATE "$TEMPLATE" STRATEGY = FILE_COPY;
SQL
  set_env "$wt/.env" "$(url "$db")"
  echo "$wt -> $db"
}

drop() {
  local db
  db="$(db_name "$1")"
  sql -c "DROP DATABASE IF EXISTS \"$db\" WITH (FORCE)"
}

case "${1:-}" in
  template) build_template ;;
  clone) clone "${2:?worktree path}" ;;
  drop) drop "${2:?worktree path}" ;;
  *) echo "usage: wt-db template | clone <wt> | drop <wt>" >&2
     exit 2 ;;
esac
其中有几个选择是有意为之。
模板是一个独立数据库,而不是你日常使用的 app_dev。CREATE DATABASE“如果在启动时存在任何其他连接,就会失败”(文档),而你平时使用的数据库几乎总有连接。ALLOW_CONNECTIONS false 会阻止新会话连接,但将这个标志设为 false 并不会结束已有会话(模板数据库文档),所以 clone 会先终止所有残留连接。IS_TEMPLATE true 则允许任何拥有 CREATEDB 权限的角色克隆它,而不只是数据库所有者(ALTER DATABASE)。
数据库名称来自分支名:转成小写,把所有非字母、非数字字符替换成 _,再截短,确保完整名称不超过 Postgres 的 63 字节标识符限制。超长名称会被截断,而 Postgres 只会给出一条 NOTICE;这就可能导致两个长分支名最终指向同一个数据库,删除一个 worktree 的数据库,也就把另一个的删了。这些清理操作也让名称可以安全地插入 SQL。仅标点不同的两个分支,例如 fix/login 和 fix-login,会映射到同一个名称;第二次克隆会在 CREATE DATABASE 时报错,而不会复用第一个分支的数据。
DROP DATABASE ... WITH (FORCE) 会终止 worktree 遗留的会话,例如仍在运行的开发服务器所建立的连接;只有在仍会留下 prepared transaction 之类的对象时才会失败(DROP DATABASE)。如果连接 URL 需要密码,可以在 url() 中添加。
为五个 Agent 接好这套流程:
export MIGRATE='npm run db:migrate && npm run db:seed'
./wt-db template

for name in auth invoices search billing docs; do
  git worktree add -b "agent/$name" "../app-$name"
  cp .env "../app-$name/.env"
  ./wt-db clone "../app-$name"
done
这里需要 cp,是因为 .env 没有纳入版本控制,git worktree add 不会把它带过去,而 clone 只会改写 DATABASE_URL 这一行。分支完成后,要先删除数据库,再移除 worktree,因为 drop 需要从 worktree 中读取分支名:
./wt-db drop ../app-auth
git worktree remove ../app-auth
如果 worktree 中存在未跟踪或已修改的文件,git worktree remove 会拒绝移除,除非传入 --force(文档)。所以,强制移除之前,先看看还剩下什么。
要测出自己机器上的数据,可以在 psql 中用三种方式克隆同一个模板,再对比 \timing 输出的 Time: 行:
\timing on
CREATE DATABASE t_wal TEMPLATE app_template;

SET file_copy_method = copy;
CREATE DATABASE t_copy TEMPLATE app_template
  STRATEGY = FILE_COPY;

SET file_copy_method = clone;
CREATE DATABASE t_clone TEMPLATE app_template
  STRATEGY = FILE_COPY;
创建 t_clone 前后,也在数据卷上运行一下 df -h。pg_database_size('t_clone') 仍会报告与模板相同的完整大小,因为它统计的是逻辑大小,不会扣除共享数据块;Marek 在文章中展示了这一点。如果你的 seed 数据只有几 MB,WAL_LOG 的速度能跟上也不奇怪:这正是文档所说、它专门针对的小模板场景。随着模板变大,Clone 的优势才会显现。测试完成后,删除这三个以 t_ 开头的数据库。
下面这些问题,大多会在运行一周、Agent 已经持续写入一段时间后出现。
Agent 不断写入,克隆也会逐渐分化。 只有在双方都没有修改时,数据块才会保持共享。Marek 观察到,一次更新 20 行的 UPDATE,让发生变化的 extent 分离出来,而表的其余部分仍然共享。他还指出,UPDATE 和 VACUUM 都会持续让页面脱离共享。一次重写大表的迁移,会让对应 worktree 拥有这张表的完整副本。规划磁盘容量时,要考虑 Agent 会重写哪些表;读取不会增加这方面的开销。
每次 FILE_COPY 都会强制执行两次 checkpoint。 复制前一次,复制后一次。在笔记本上运行的 Postgres 中,这通常开销不大。但在还有其他繁忙数据库的共享服务器上,文档警告说,它“可能对系统整体性能造成明显的负面影响”。
这是适用于本地环境的技巧。 使用托管 Postgres 服务时,你无法选择文件系统,因此不要围绕它规划托管环境。它适用于开发机,以及你能掌控的自建服务器。
克隆同时也是快照。 迁移合并进 main 后,要重新运行 wt-db template,让新的 worktree 从最新 schema 开始;已有 worktree 会继续保留克隆时的 schema,直到你删除并重新克隆它们。另外,如果测试运行器连接的是另一个数据库(很多框架会在库名后追加 _test),就要为每个 worktree 再创建第二个克隆,并把对应变量指向它,否则 Agent 共享的就会变成测试数据库。
每个 worktree 一个数据库,其实是一个更大设计问题的缩影:哪些状态是共享的,谁有权修改它的结构,以及当多个写入方依赖同一个 schema 时,一次迁移究竟要付出什么代价。Database Playbook 讨论的就是如何选择和更换数据存储(Postgres、SQLite、Redis、DynamoDB),以及每种存储所涉及的 schema 和迁移决策。我也在开发 Hermes IDE,所以评价这些内容时,请把这一点考虑在内:它会为每个任务分配一个 hermes/<name> 分支、一个 worktree 和独立端口,免费且源码可见;上面的脚本则补上了数据库这一环,否则这些 worktree 仍会共享同一个数据库。
如需采取进一步措施,你可以考虑屏蔽此人和/或举报滥用行为。