
8.0
热点
AI SCORE
开源项目2026-10-19 15:27
从基础到部署的大模型学习路线
GitHub Trending#大模型#学习路线#开源
Editor brief · 编辑速览
免费课程按基础知识、模型研发和应用工程划分学习路径,配套 Colab 笔记本。实践内容涵盖模型评估、合并、云端微调和量化。
𝕏 在 X 上关注我 • 🤗 Hugging Face • 💻 博客 • 📙 LLM Engineer's Handbook
本 LLM 课程分为三个部分:
🧩 LLM 基础是可选部分,涵盖数学、Python 和神经网络的基础知识。
🧑🔬 LLM 科学家侧重于使用最新技术构建尽可能出色的 LLM。
👷 LLM 工程师侧重于创建和部署基于 LLM 的应用。
基于本课程,我与他人合著了 LLM Engineer's Handbook。这是一本实践指南,涵盖了 LLM 应用从设计到部署的完整流程。本 LLM 课程将永久免费,你也可以通过购买这本书来支持我的工作。
如需了解本课程更全面的版本,请查看 DeepWiki。
这里汇集了我撰写的有关 LLM 的 Notebook 和文章。
本节介绍数学、Python 和神经网络的必备知识。你不一定要从这里开始,可以在需要时查阅。
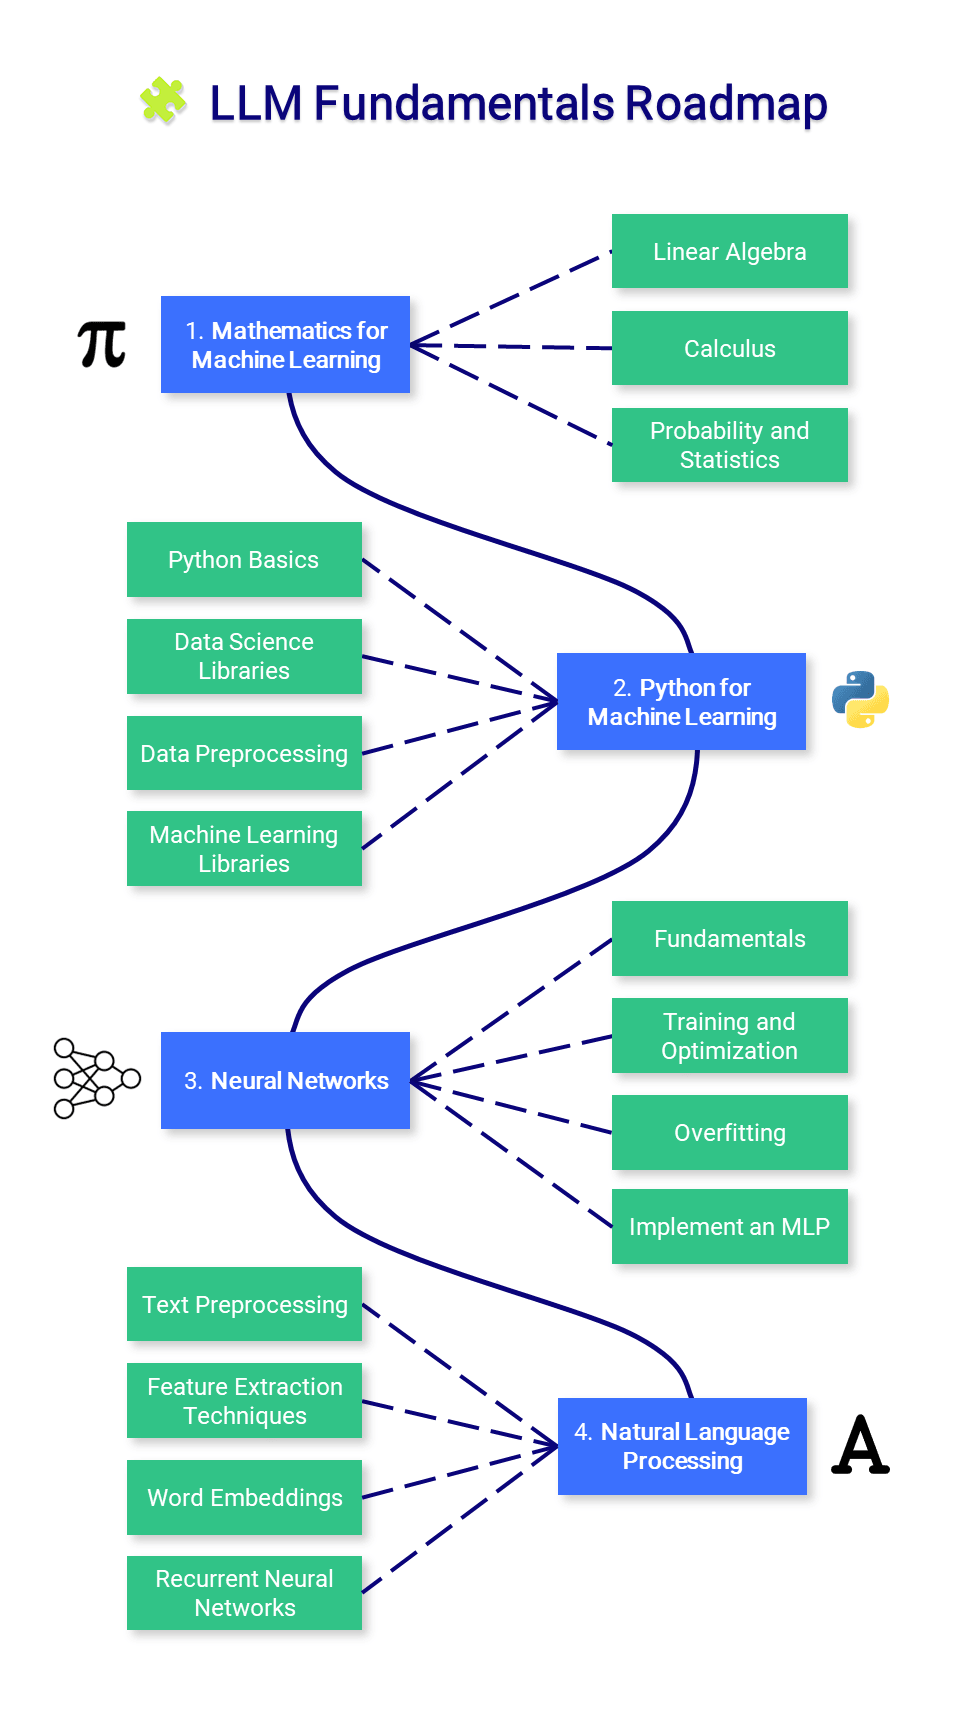
在掌握机器学习之前,理解这些算法背后的数学基本概念非常重要。
线性代数:它对于理解许多算法至关重要,尤其是深度学习中使用的算法。关键概念包括向量、矩阵、行列式、特征值与特征向量、向量空间以及线性变换。
微积分:许多机器学习算法涉及连续函数的优化,因此需要理解导数、积分、极限和级数。多元微积分和梯度的概念也很重要。
概率与统计:它们对于理解模型如何从数据中学习并进行预测至关重要。关键概念包括概率论、随机变量、概率分布、期望、方差、协方差、相关性、假设检验、置信区间、最大似然估计和贝叶斯推断。
3Blue1Brown — 线性代数的本质:一系列视频,帮助你从几何角度直观理解这些概念。
StatQuest with Josh Starmer — 统计学基础:以简单清晰的方式解释许多统计学概念。
Seeing Theory:布朗大学推出的概率与统计可视化入门教程。
Immersive Linear Algebra:另一份以可视化方式解读线性代数的教程。
Khan Academy — 线性代数:以非常直观的方式解释相关概念,非常适合初学者。
Khan Academy — 微积分:涵盖微积分所有基础知识的交互式课程。
Khan Academy — 概率与统计:以易于理解的形式讲解课程内容。
Python 是一种强大而灵活的编程语言。凭借良好的可读性、一致性以及成熟的数据科学库生态,它尤其适合机器学习。
Python 基础:使用 Python 编程,需要充分理解基本语法、数据类型、错误处理和面向对象编程。
数据科学库:需要熟悉用于数值运算的 NumPy、用于数据处理与分析的 Pandas,以及用于数据可视化的 Matplotlib 和 Seaborn。
数据预处理:包括特征缩放与归一化、缺失数据处理、异常值检测、类别数据编码,以及将数据划分为训练集、验证集和测试集。
机器学习库:熟练使用 Scikit-learn 至关重要,这个库提供了丰富的监督学习和无监督学习算法。你需要理解如何实现线性回归、逻辑回归、决策树、随机森林、k 近邻(K-NN)和 K-means 聚类等算法。PCA 和 t-SNE 等降维技术也有助于高维数据的可视化。
Real Python:内容全面的学习资源,包含讲解 Python 入门及进阶概念的文章和教程。
freeCodeCamp — 学习 Python:一部完整介绍 Python 所有核心概念的长视频。
Python Data Science Handbook:一本免费的电子书,是学习 pandas、NumPy、Matplotlib 和 Seaborn 的优质资源。
freeCodeCamp — 面向所有人的机器学习:面向初学者,通过实践介绍不同的机器学习算法。
Udacity — 机器学习入门:一门免费课程,涵盖 PCA 和其他多个机器学习概念。
神经网络是许多机器学习模型的基础组成部分,在深度学习领域尤其如此。要有效运用神经网络,必须全面理解其设计和运行机制。
基础知识:包括理解神经网络的结构,例如层、权重、偏置和激活函数(sigmoid、tanh、ReLU 等)。
训练与优化:熟悉反向传播,以及均方误差(MSE)、交叉熵等不同类型的损失函数。理解梯度下降、随机梯度下降、RMSprop 和 Adam 等优化算法。
过拟合:理解过拟合的概念,即模型在训练数据上表现良好,但在未见过的数据上表现不佳,并学习使用各种正则化技术(dropout、L1/L2 正则化、提前停止、数据增强)来防止过拟合。
实现多层感知机(MLP):使用 PyTorch 构建 MLP,也称为全连接网络。
3Blue1Brown — 神经网络究竟是什么?:这个视频直观地解释了神经网络及其内部工作原理。
freeCodeCamp — 深度学习速成课程:这个视频高效地介绍了深度学习中所有最重要的概念。
Fast.ai — 深度学习实践:一门免费课程,面向有编程经验、希望学习深度学习的人。
Patrick Loeber — PyTorch 教程:一系列面向零基础学习者的 PyTorch 入门视频。
NLP 是人工智能中一个引人入胜的分支,在人类语言与机器理解之间架起桥梁。从简单的文本处理到理解语言中的细微差别,NLP 在翻译、情感分析、聊天机器人等众多应用中发挥着关键作用。
文本预处理:学习各种文本预处理步骤,例如分词(将文本拆分为词或句子)、词干提取(将单词缩减为词干形式)、词形还原(与词干提取类似,但会考虑上下文)、停用词移除等。
特征提取技术:熟悉将文本数据转换为机器学习算法能够理解的格式的技术。主要方法包括词袋模型(BoW)、词频—逆文档频率(TF-IDF)和 n-gram。
词嵌入:词嵌入是一种词语表示方式,使含义相近的词具有相似的表示。主要方法包括 Word2Vec、GloVe 和 FastText。
循环神经网络(RNN):理解 RNN 的工作原理,这是一类专门用于处理序列数据的神经网络。探索 LSTM 和 GRU,这两种 RNN 变体能够学习长期依赖关系。
Lena Voita — 词嵌入:一门对初学者友好的课程,介绍词嵌入相关概念。
RealPython — 使用 Python 中的 spaCy 进行 NLP:一份详尽指南,介绍如何使用 spaCy 库在 Python 中完成 NLP 任务。
Kaggle — NLP 指南:通过几个 Notebook 和相关资源,结合实践讲解 Python 中的 NLP。
Jay Alammar — 图解 Word2Vec:理解著名的 Word2Vec 架构的优质参考资料。
Jake Tae — 从零开始用 PyTorch 实现 RNN:使用 PyTorch,以简单实用的方式实现 RNN、LSTM 和 GRU 模型。
colah's blog — 理解 LSTM 网络:一篇偏重理论的 LSTM 网络讲解文章。
🧑🔬 LLM 科学家
本课程的这一部分侧重于学习如何使用最新技术,构建尽可能出色的 LLM。
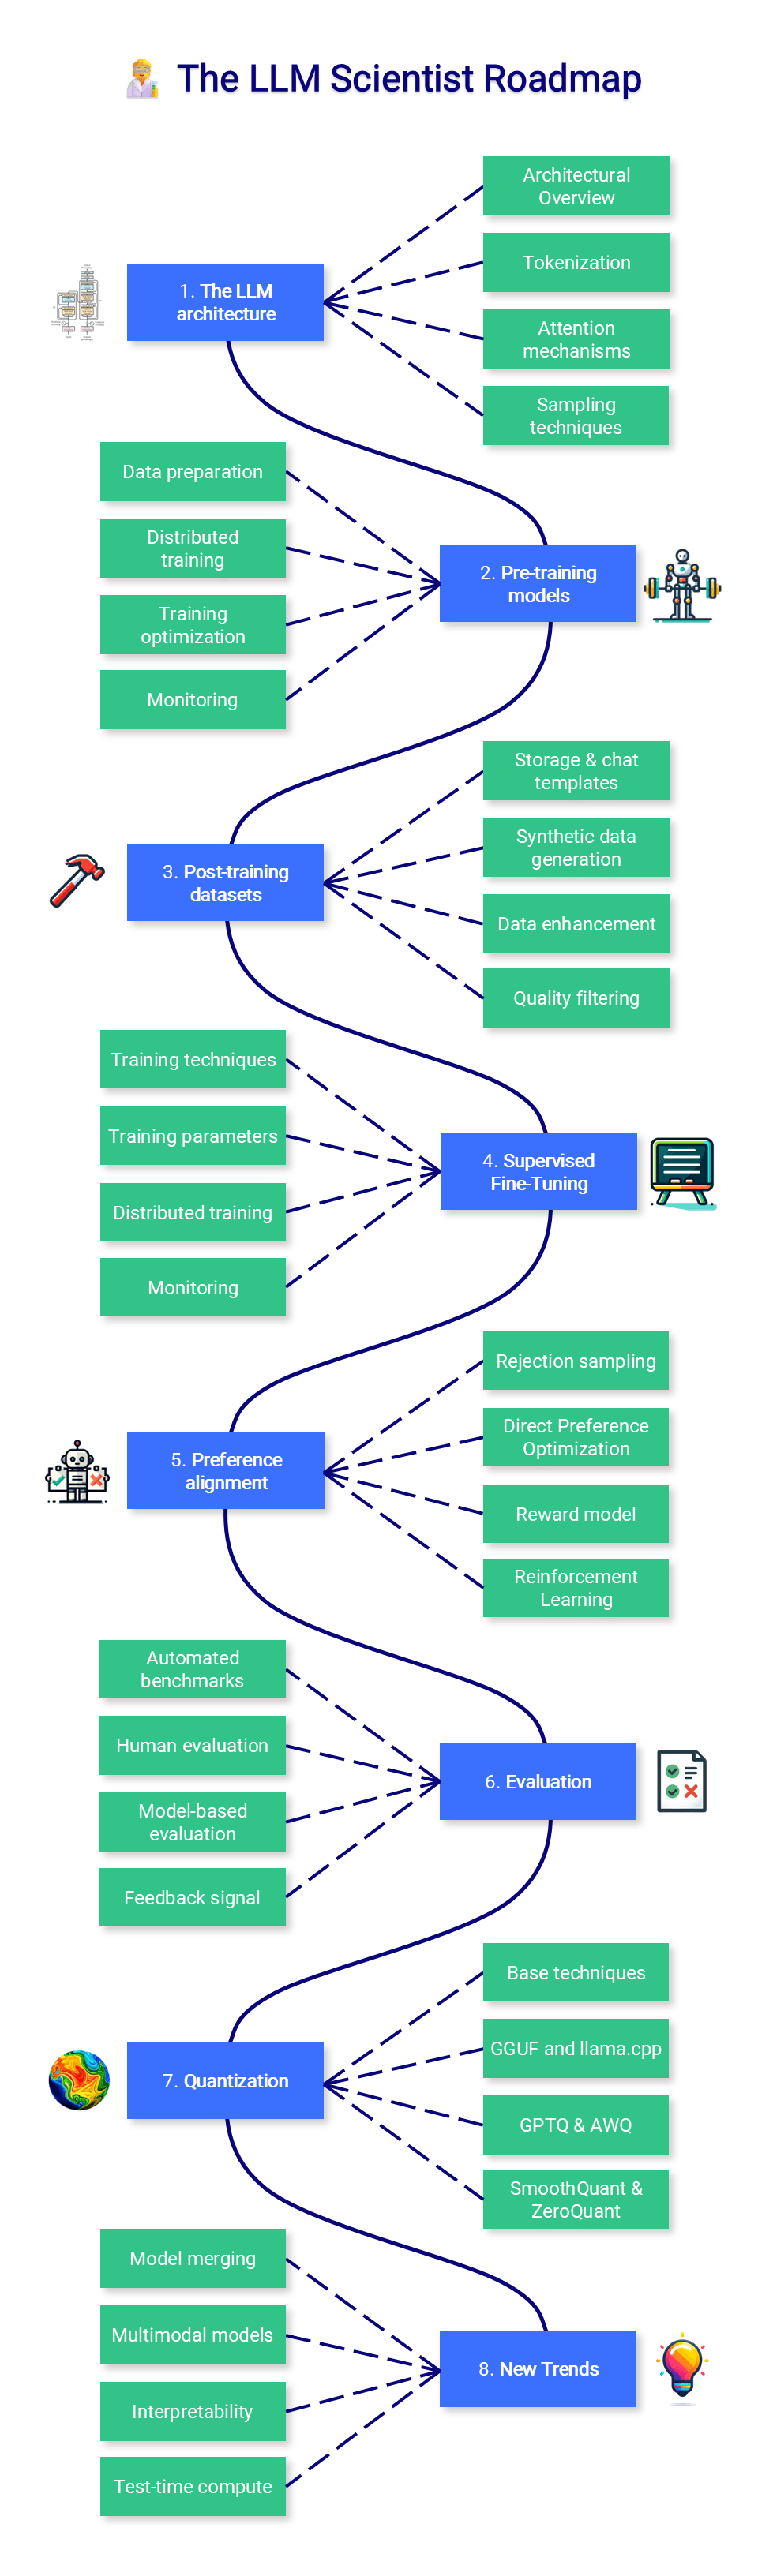
你不必深入掌握 Transformer 架构,但需要理解现代 LLM 的主要处理步骤:通过分词将文本转换为数字,让这些 token 经过包含注意力机制在内的各个网络层进行处理,最后通过各种采样策略生成新文本。
架构概览:理解从编码器—解码器 Transformer 到 GPT 等仅解码器架构的演进,后者构成了现代 LLM 的基础。重点从整体上理解这些模型如何处理和生成文本。
分词:学习分词的原理,即如何将文本转换为 LLM 能够处理的数值表示。探索不同的分词策略,以及它们对模型性能和输出质量的影响。
注意力机制:掌握注意力机制的核心概念,尤其是自注意力及其变体。理解这些机制如何让 LLM 处理长距离依赖,并在整个序列中保持上下文。
采样技术:探索各种文本生成方法及其权衡。比较贪心搜索、束搜索等确定性方法与温度采样、核采样等概率性方法。
3Blue1Brown 的 Transformer 可视化入门:面向零基础读者的 Transformer 可视化介绍。
Brendan Bycroft 的 LLM Visualization:以交互式 3D 可视化展示 LLM 的内部运作。
Andrej Karpathy 的 nanoGPT:一段时长 2 小时的 YouTube 视频,面向程序员,演示如何从零实现 GPT。他还制作了一段介绍分词的视频。
Lilian Weng 的 Attention? Attention!:从历史发展脉络出发,介绍为什么需要注意力机制。
Maxime Labonne 的 LLM 解码策略:通过代码和可视化介绍用于生成文本的各种解码策略。
预训练是一个计算密集且成本高昂的过程。虽然它不是本课程的重点,但扎实理解模型的预训练方式仍然很重要,尤其是数据和参数方面。爱好者也可以使用参数量小于 10 亿的模型开展小规模预训练。
数据准备:预训练需要海量数据集(例如,Llama 3.1 使用了 15 万亿个 token 进行训练),这些数据需要经过精心筛选、清洗、去重和分词。现代预训练流水线采用复杂的过滤机制,移除低质量或存在问题的内容。
分布式训练:结合不同的并行策略:数据并行(分配批次)、流水线并行(分配模型层)和张量并行(拆分运算)。这些策略需要优化 GPU 集群中的网络通信和内存管理。
训练优化:使用带预热的自适应学习率,通过梯度裁剪和归一化防止数值爆炸,采用混合精度训练提高内存效率,并使用经过超参数调优的现代优化器(AdamW、Lion)。
监控:通过仪表盘跟踪关键指标(损失、梯度、GPU 状态),针对分布式训练问题记录专项日志,并进行性能剖析,定位跨设备计算与通信中的瓶颈。
Penedo 等人的 FineWeb:介绍如何重建一个用于 LLM 预训练的大规模数据集(15 万亿个 token),其中还包括高质量子集 FineWeb-Edu。
Weber 等人的 RedPajama v2:另一篇介绍大规模预训练数据集的文章及配套论文,包含许多值得关注的质量过滤方法。
Hugging Face 的 nanotron:用于训练 SmolLM2 的极简 LLM 训练代码库。
Chenyan Xiong 的并行训练:概述优化与并行技术。
Duan 等人的分布式训练:一篇关于在分布式架构上高效训练 LLM 的综述。
AI2 的 OLMo 2:开源语言模型,提供模型、数据以及训练和评估代码。
LLM360 的 LLM360:面向开源 LLM 的框架,提供训练和数据准备代码、数据、指标及模型。
后训练数据集具有明确的结构:包含指令和回答(用于监督微调),或包含指令以及被选中和被拒绝的回答(用于偏好对齐)。与预训练使用的原始文本相比,对话结构的数据要少得多,因此我们通常需要处理种子数据并加以完善,以提高样本的准确性、多样性和复杂度。更多信息和示例可参见我的仓库 💾 LLM Datasets。
存储与聊天模板:由于采用对话结构,后训练数据集会以 ShareGPT 或 OpenAI/HF 等特定格式存储。随后,这些格式会被映射到 ChatML 或 Alpaca 等聊天模板,生成最终用于模型训练的样本。
合成数据生成:使用 GPT-4o 等前沿模型,基于种子数据创建指令与回答配对。这种方法能够灵活、可扩展地构建数据集,并获得高质量回答。关键在于设计多样化的种子任务和有效的系统提示词。
数据增强:使用多种技术改进现有样本,例如验证输出(使用单元测试或求解器)、结合拒绝采样生成多个回答、Auto-Evol、思维链、Branch-Solve-Merge、角色设定等。
质量过滤:传统技术包括基于规则的过滤、去除重复或近似重复数据(使用 MinHash 或嵌入向量),以及通过 n-gram 去除与评测数据重叠的内容。奖励模型和充当评判者的 LLM 则通过细粒度、可定制的质量控制,对这一步骤进行补充。
Argilla 的 Synthetic Data Generator:在 Hugging Face Space 中使用自然语言构建数据集,对初学者友好。
Maxime Labonne 的 LLM Datasets:精选的后训练数据集和工具列表。
Nvidia 的 NeMo-Curator:用于预训练和后训练数据的数据准备与整理框架。
Argilla 的 Distilabel:用于生成合成数据的框架,还包含 UltraFeedback 等论文的有价值复现。
MinishLab 的 Semhash:使用蒸馏后的嵌入模型进行近似去重和数据去污染的极简库。
Hugging Face 的 Chat Template:Hugging Face 关于聊天模板的文档。
监督微调(SFT)将基础模型转变为能够回答问题、遵循指令的实用助手。在这一过程中,模型学会如何组织回答,并重新激活预训练期间学到的部分知识。虽然也可以灌输新知识,但这种学习较为浅层,无法用来学习一门全新的语言。始终应将数据质量置于参数优化之上。
训练技术:全量微调会更新模型的所有参数,但需要大量计算资源。LoRA 和 QLoRA 等参数高效微调技术通过冻结基础权重、仅训练少量适配器参数来降低内存需求。QLoRA 将 4 位量化与 LoRA 结合,以减少显存占用。这些技术均已在最流行的微调框架中实现:TRL、Unsloth 和 Axolotl。
训练参数:关键参数包括学习率及其调度器、批次大小、梯度累积、训练轮数、优化器(如 8 位 AdamW)、用于正则化的权重衰减,以及用于稳定训练的预热步数。LoRA 还引入了三个参数:秩(通常为 16–128)、alpha(秩的 1–2 倍)和目标模块。
分布式训练:使用 DeepSpeed 或 FSDP 将训练扩展到多个 GPU。DeepSpeed 提供三个 ZeRO 优化阶段,通过划分训练状态逐级提高内存效率。两种方法都支持梯度检查点,以提高内存效率。
监控:跟踪损失曲线、学习率调度和梯度范数等训练指标。留意损失突增、梯度爆炸或性能下降等常见问题。
Maxime Labonne 的使用 Unsloth 超高效微调 Llama 3.1:演示如何使用 Unsloth 微调 Llama 3.1 模型的实操教程。
Wing Lian 的 Axolotl 文档:包含大量与分布式训练和数据集格式有关的有用信息。
Hamel Husain 的 Mastering LLMs:关于微调的学习资源合集,也涵盖 RAG、评估、应用和提示词工程。
Sebastian Raschka 的 LoRA 实践见解:介绍 LoRA 的实用经验,以及如何选择最佳参数。
偏好对齐是后训练流水线的第二个阶段,重点是让生成的回答符合人类偏好。这一阶段最初用于调整 LLM 的表达语气,减少有害内容和幻觉。不过,它在提升模型性能和实用性方面也变得越来越重要。与 SFT 不同,偏好对齐有许多算法。这里我们重点介绍其中最重要的三种:DPO、GRPO 和 PPO。
拒绝采样:对于每个提示词,使用已训练的模型生成多个回答,并对其评分,从而确定被选中和被拒绝的回答。这样可以创建同策略数据,即两个回答都来自正在训练的模型,从而提高对齐的稳定性。
直接偏好优化:直接优化策略,使被选中回答相对于被拒绝回答的生成似然最大化。它不需要奖励建模,因此计算效率高于强化学习技术,但质量略逊一筹。非常适合用于创建聊天模型。
奖励模型:利用人类反馈训练奖励模型,以预测人类偏好等指标。可以借助 TRL、verl 和 OpenRLHF 等框架,实现可扩展的训练。
强化学习:GRPO 和 PPO 等强化学习(RL)技术通过迭代更新策略,在尽量保持初始行为的同时最大化奖励。它们可以使用奖励模型或奖励函数为回答评分。这类方法通常计算成本较高,需要仔细调整超参数,包括学习率、批大小和裁剪范围。非常适合用于构建推理模型。
Hugging Face 的《图解 RLHF》:介绍 RLHF,包括奖励模型训练和通过强化学习进行微调。
Sebastian Raschka 的《LLM 训练:RLHF 及其替代方案》:概述 RLHF 流程,以及 RLAIF 等替代方案。
Hugging Face 的《LLM 偏好调优》:比较用于偏好对齐的 DPO、IPO 和 KTO 算法。
Maxime Labonne 的《使用 DPO 进行微调》:介绍如何使用 DPO 微调 Mistral-7b 模型,并复现 NeuralHermes-2.5。
Maxime Labonne 的《使用 GRPO 进行微调》:通过实践练习,使用 GRPO 微调一个小模型。
Alexander Vishnevskiy 的《DPO Wandb 日志》:展示需要跟踪的主要 DPO 指标,以及这些指标的预期变化趋势。
可靠地评估 LLM 是一项复杂但必不可少的任务,能够为数据生成和训练提供指导。评估能针对有待改进的方面提供宝贵反馈,据此可以调整数据配比、数据质量和训练参数。不过,始终应牢记古德哈特定律:“当一个指标成为目标时,它就不再是一个好的指标。”
自动化基准测试:使用精心整理的数据集和指标(如 MMLU),评估模型在特定任务上的表现。这种方式适用于具体任务,但难以衡量抽象能力和创造力,也容易受到数据污染的影响。
人工评估:由人向模型输入提示词,并为回答评分。方法涵盖凭直觉进行的简单检查、遵循具体指南的系统化标注,以及大规模社区投票(竞技场)。它更适合主观任务,但在评估事实准确性方面可靠性较低。
基于模型的评估:使用裁判模型和奖励模型评估模型输出。评估结果与人类偏好高度相关,但存在偏爱自身输出、评分不一致等问题。
反馈信号:分析错误模式,找出具体弱点,例如遵循复杂指令的能力有限、缺乏特定知识,或容易受到对抗性提示词的影响。可以通过改进数据生成方式和训练参数来改善这些问题。
Hugging Face 的《LLM 评估指南》:全面介绍评估方法,并提供实践见解。
Hugging Face 的 Open LLM Leaderboard:以开放、可复现的方式比较 LLM 的主要排行榜,采用自动化基准测试。
EleutherAI 的 Language Model Evaluation Harness:一个流行的框架,用于通过自动化基准测试评估 LLM。
Hugging Face 的 Lighteval:另一个可选的评估框架,也支持基于模型的评估。
LMSYS 的 Chatbot Arena:根据人类进行的对比,为通用 LLM 计算 Elo 评分,属于人工评估。
量化是将模型参数和激活值转换为更低精度的过程。例如,以 16 位存储的权重可以转换为 4 位表示。为了降低 LLM 的计算和内存成本,这项技术变得越来越重要。
基础技术:了解不同的精度级别(FP32、FP16、INT8 等),以及如何使用绝对最大值(absmax)和零点(zero-point)技术进行朴素量化。
GGUF 与 llama.cpp:llama.cpp 最初为在 CPU 上运行而设计,如今它与 GGUF 格式已成为在消费级硬件上运行 LLM 最流行的工具。GGUF 支持将特殊 token、词表和元数据存储在同一个文件中。
GPTQ 与 AWQ:GPTQ/EXL2 和 AWQ 等技术引入逐层校准,在极低位宽下仍能保持模型性能。它们通过动态缩放、选择性跳过幅值最大的参数,或对这些参数重新居中,来减轻极端异常值的影响。
SmoothQuant 与 ZeroQuant:有利于量化的新型变换(SmoothQuant)和基于编译器的优化(ZeroQuant)有助于在量化前减轻异常值的影响。它们还通过融合某些算子和优化数据流来降低硬件开销。
Maxime Labonne 的《量化入门》:概述量化、绝对最大值量化、零点量化和 LLM.int8(),并附有代码。
Maxime Labonne 的《使用 llama.cpp 量化 Llama 模型》:介绍如何使用 llama.cpp 和 GGUF 格式量化 Llama 2 模型。
Maxime Labonne 的《使用 GPTQ 进行 4 位 LLM 量化》:介绍如何通过 AutoGPTQ 使用 GPTQ 算法量化 LLM。
FriendliAI 的《理解激活感知权重量化》:概述 AWQ 技术及其优势。
MIT HAN Lab 的《在 Llama 2 7B 上使用 SmoothQuant》:介绍如何在 Llama 2 模型上使用 SmoothQuant,实现 8 位精度。
DeepSpeed 的《DeepSpeed 模型压缩》:介绍如何通过 DeepSpeed Compression 使用 ZeroQuant 和极限压缩(XTC)。
以下是一些未归入其他类别、但值得关注的主题。其中一些是成熟的技术(模型合并、多模态),另一些则更具实验性(可解释性、测试时计算量扩展),也是大量研究论文关注的重点。
模型合并:将训练好的模型进行合并,已成为一种无需任何微调即可创建高性能模型的流行方法。广受欢迎的 mergekit 库实现了 SLERP、DARE 和 TIES 等最流行的合并方法。
多模态模型:这类模型(如 CLIP、Stable Diffusion 或 LLaVA)通过统一的嵌入空间处理多种类型的输入(文本、图像、音频等),从而支持文本生成图像等强大的应用。
可解释性:稀疏自编码器(SAE)等机制可解释性技术已取得显著进展,帮助人们深入了解 LLM 的内部工作机制。相关成果也被应用于 abliteration 等技术,使你能够在无需 t