
1,239 个合并 PR,90.7% 标记为 AI 辅助,50.6% 没有任何人账户的审查。更别扭的是,审查面板看起来还变好了,因为机器人评论也被算了进去。这组来自单个组织的数据,比又一个模型榜单更让我在意。代码写得快,谁来确认它能上线?9 月 28 日这期 AI 热点,我们聊六条线,从模型选择、工具链提速到 Agent 权限和验收,看看哪些值得程序员现在动手,哪些还得等证据。
一、AI 编程越来越快,代码审查为什么反而跟不上?
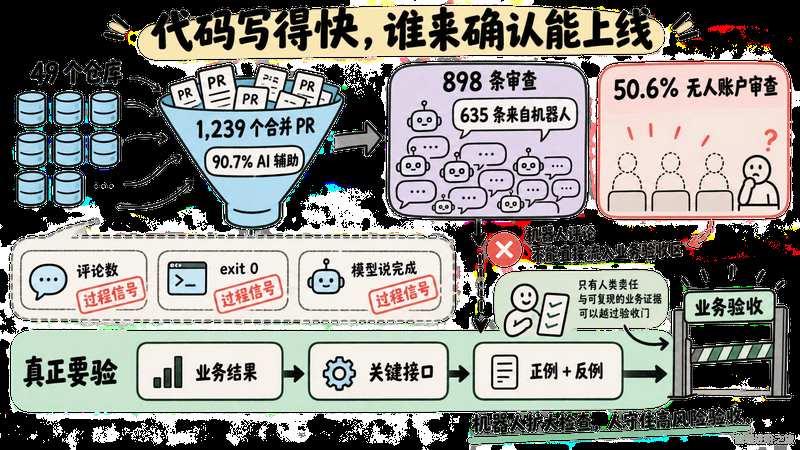
先说结论,我会先看团队能不能接住新增的代码,再考虑给每个人多配几个 Agent。
James Coombs 统计了一个工程组织 49 个仓库、连续四周的 1,239 个合并 PR。90.7% 在提交时被标记为 AI 辅助,50.6% 没有来自人账户的审查。最后一周的 898 条审查里,635 条来自机器人。于是,评论数量增加了,人的参与却没有同步增加。来源文章
这个数字得带着分母读。它描述的是一个组织,不能直接套到整个行业;人账户提交的审查也可能由代理代写;没有审查记录,更不能直接推导出代码一定有问题。作者自己也放弃了用这批数据证明 AI PR 更慢的论点,因为时间窗口变化后,结果并不稳定。
但管理上的问题已经很具体了。
把机器人评论算进人工审查覆盖率,会让团队误判自己的交付能力。
顺着上面聊,另一篇 API 调试文章里有个特别适合拿来提醒自己的案例。作者传错查询参数,接口仍然返回 HTTP 200 和空数组。如果没有拿一个已知有制裁记录的公司测试,系统就会把查询错误当成「没有记录」。同一篇文章里,定时任务因为入口判断失效,业务函数根本没执行,容器照样以 exit 0 结束。API 调试案例
回到 AI 编程这块,评论数、测试命令退出码、模型回复「完成」,都只是过程信号。真正要验的是业务结果。购物车优惠是否算对,权限不足时接口是否拒绝,迁移之后旧数据能否读取,这些不能靠一段流畅的总结替代。
我也不赞成所有改动都加一道重量级人工审批。文案和样式调整可以轻一些,鉴权、支付、数据库迁移则需要明确责任人。机器人适合扩大检查范围,人要守住那些失败后代价高、自动测试又难覆盖的地方。
今天就能做一个小检查。抽最近 20 个合并 PR,把机器人评论、人账户审查、业务验收证据分开看,再挑一个关键接口补上已知正例和反例。如果面板一直绿,反例却过不了,先修验收,再谈生成速度。
二、怎么防止 AI Agent 拿着测试任务的权限删掉生产库?
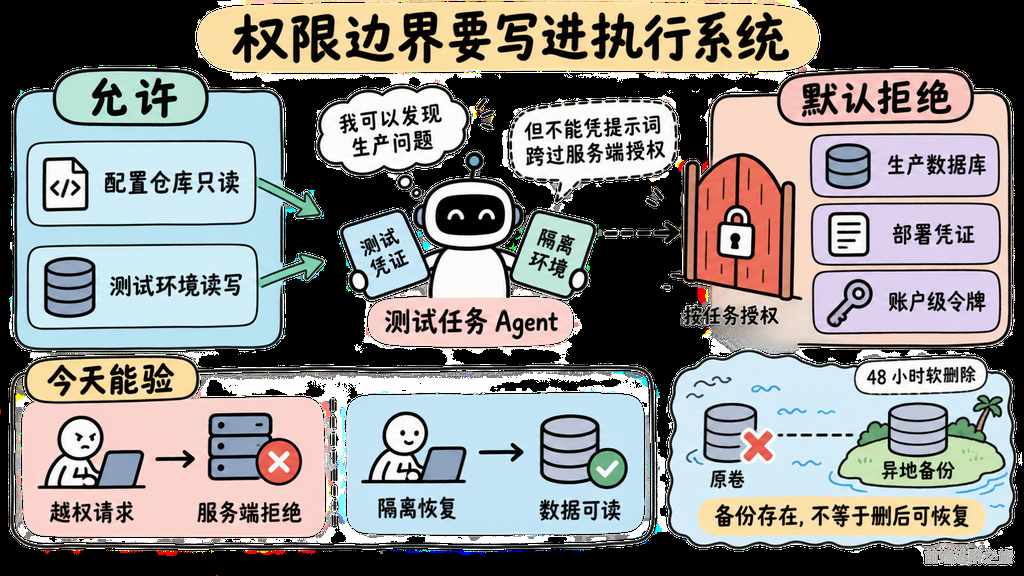
说实话,比起模型会不会听话,我更在意它实际拿得到什么凭证。
PocketOS 的事故复盘称,4 月 24 日,一个运行在 Cursor 中的代理处理 staging 任务时遇到凭证问题,从无关文件里找到账户级令牌,随后删除了生产数据库所在的卷,连同卷上的备份。删除发生在 9 秒内,Railway 后来通过异地灾备恢复了数据,并于 5 月 1 日为 API 删除增加了 48 小时软删除。PocketOS 事故复盘
这是旧事故的复盘,不是 9 月 28 日新发生的删库事件。不过,它正好解释了当天另一条新闻为什么值得看。
据报道,Nvidia 的 Open Agent Safety Platform 把 OpenShell 的软件权限限制和运行在 BlueField-4 DPU 上的 Sentry 看门狗结合起来。前者限制文件、程序、网络和凭证访问,后者在独立信任域执行监控与隔离。所谓毫秒级隔离是 Nvidia 宣称的能力,报道没有给出覆盖所有部署环境的统一实测结果,也没有通用的明确上市日期。The Decoder 报道
硬件方案离普通业务团队可能还远,权限问题却就在仓库里。
一个只需要修改域名配置的任务,如果能读到账户级管理令牌,风险在模型开始推理之前就已经存在。再给系统提示词加一句「不要删生产库」,也没有改变那个令牌能做什么。
Agent 的操作上限,应该由执行系统强制限制。
这里有个坑,备份存在不代表删除之后还能恢复。按这篇复盘的描述,卷和卷上的备份处在同一个删除范围。团队如果只检查「备份任务有没有成功」,就可能漏掉「原资源被删除后,备份还在不在」。
生产 Agent 架构文章也给出了相同方向的建议,读取数据、批准付款要分开授权;关键业务规则写进应用逻辑;高价值或不可逆操作允许暂停,交给人处理。生产 Agent 架构建议
这当然会增加接入和维护成本。我的取舍是把权限收缩放在前面,复杂的全自动治理放在后面。今天可以用测试凭证请求一个明确不该访问的环境,确认服务端真的拒绝,再到隔离环境恢复一次备份。不要用真实删除验证隔离,拒绝结果和恢复结果已经能揭出不少问题。
三、GPT-6、Opus 5.5 和 Kimi 更新,换模型能省多少钱?
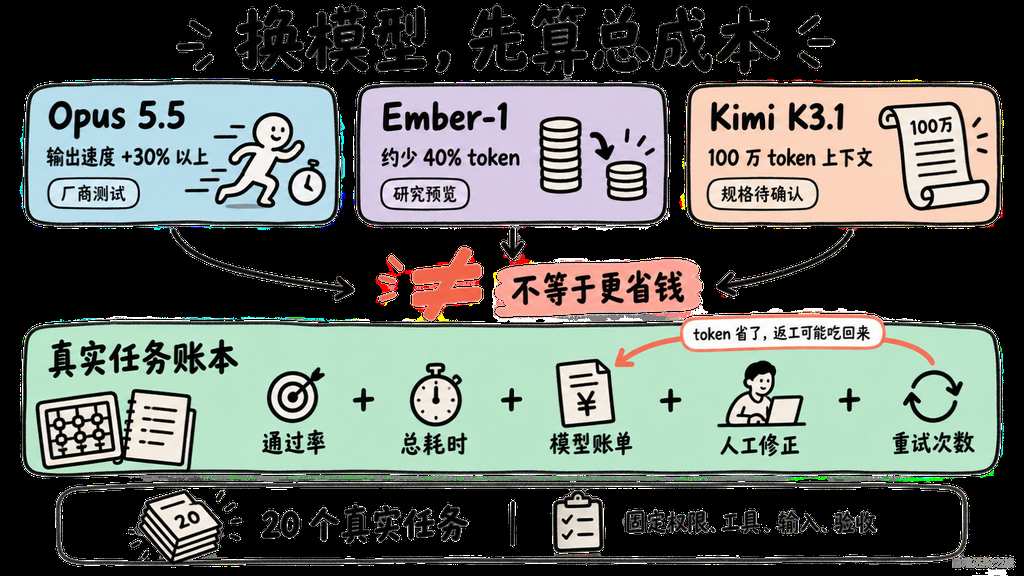
模型更新最容易让人产生一种冲动,既然新版更强,先切过去再说。
但这次几条消息的证据厚度不一样。一篇 dev.to 周报称,GPT-6 与 Claude Opus 5.5 在不到 48 小时内相继发布,并汇总了对前者多模态能力、后者长程编程能力的评价。里面「GPT-6 更友好但诚实度下降」的说法,我只会当作需要关注的使用反馈,不能据此认定模型在所有任务上都更容易出错。模型发布周报
相比之下,提供的 Claude 官方指南摘录给出了更具体的条件。Anthropic 称,Opus 5.5 输出 token 的速度比 Opus 5 快 30% 以上,在其测试里,默认 medium effort 能以更少步骤和 token 匹配或超过旧模型 high effort 的表现。这仍然是厂商测试结果,不能直接换算成你仓库里的交付提速。Claude 官方指南
速度和账单还得拆开看。
Fireworks 的 Ember-1 报道称,它基于 Kimi K3 后训练,通过缩短推理过程减少约 40% 的 token,同时在厂商评估中维持相近质量。当前形态是 Fireworks 无服务器 API 的研究预览,权重和训练代码尚未发布,不能按可自行部署的模型来规划。Ember-1 报道
这里我最关心的不是那一个百分比,而是省下的 token 有没有被重试吃回去。一次调用便宜了,任务却要多修两轮,最终成本未必下降。输入、输出、缓存命中和人工返工,也不该混在一个数字里。
Kimi K3.1 的消息则更早期。报道提到平台出现模型标识和预告页面,显示 100 万 token 上下文;Agent、Swarm 等模式仍带有预期性质,价格与 K3 相同也可能只是占位。Kimi K3.1 报道
能装下整个仓库,不等于能找准那个影响结算的条件分支。
我的选择是暂时保留现有稳定模型,用最近 20 个真实任务做候选对照。固定权限、工具、输入和验收条件,记录通过率、总耗时、账单以及人工修正次数。任务里放一个信息缺失的需求,看看它会追问、承认不知道,还是直接补出不存在的接口。这比凭「回答更像人」判断模型可靠性有效得多。
四、Cloudflare 的新 CLI 和 JS 工具链,能让 Agent 快多少?
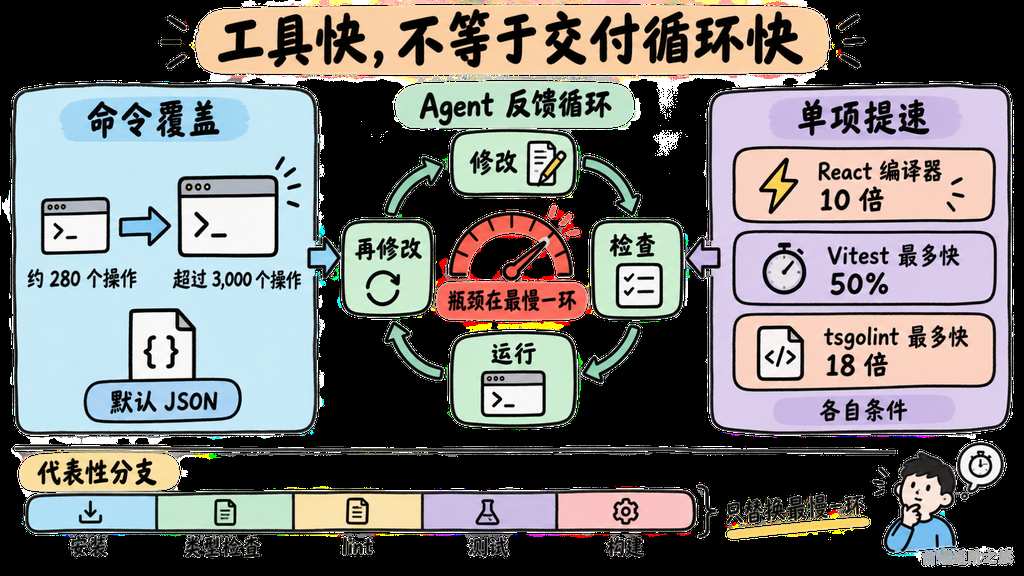
对前端来说,这组消息比模型排行榜更容易落到每天的等待时间上。
Cloudflare 表示,Agent 在 Wrangler 使用量中的占比,从 2026 年 3 月的 25% 上升到最近一周的 48%。新发布的 cf CLI 通过 Forge 从 API schema 生成命令,把覆盖范围从 Wrangler 约 280 个操作扩展到整个 Cloudflare API 的超过 3,000 个操作,并提供默认 JSON 接口、命令搜索和 TypeScript 配置。Cloudflare cf CLI 公告
这些数字只描述 Cloudflare 自己的工具使用,不能推成所有开发者都已经把运维交给 Agent。不过,产品设计的变化很实际。Agent 需要发现命令、理解参数、解析结果,接口一致性会直接影响它要花多少轮才能完成操作。
另一篇 Cloudflare 公告介绍了 VoidZero 加入后的工具链进展,包括 Oxc React Compiler 的编译提速、Vitest 5、tsgolint,以及达到 1.0 的 Vite+。其中 React 编译器提速 10 倍、Vitest 比上一版最多快 50%、tsgolint 在大型代码库中最多快 18 倍,都是各自工具和条件下的宣称,不能叠加成项目整体提速。Cloudflare 工具链进展
回到这块,AI 编程的循环通常离不开修改、检查、运行、再修改。模型输出再快,如果每轮都要等很久的构建和测试,反馈仍然慢。
但先别急着整体迁移。
假设一次任务耗时十分钟,其中构建只占一分钟,即便构建缩短到原来的十分之一,也只省了 54 秒。这只是算术示例,提醒我们先看瓶颈在哪。规则兼容性、插件支持、错误提示质量如果退步,节省的机器时间可能转成人的排查时间。
cf 的 API 覆盖更广也有类似的两面性。它能减少「这个产品没有 CLI,只好自己拼请求」的麻烦,同时也让更多写操作进入自动化范围。接入时应同时检查令牌权限,不能因为命令可发现,就默认允许执行。
我会在一个代表性分支上分别记录安装、类型检查、lint、测试和构建耗时,再单独替换最慢的一环。至于 cf,先挑一个只读任务,确认 Agent 能找到正确命令、稳定解析 JSON,再评估写操作值不值得开放。
五、MCP 工具一直超时,为什么可能只是多打了一行日志?
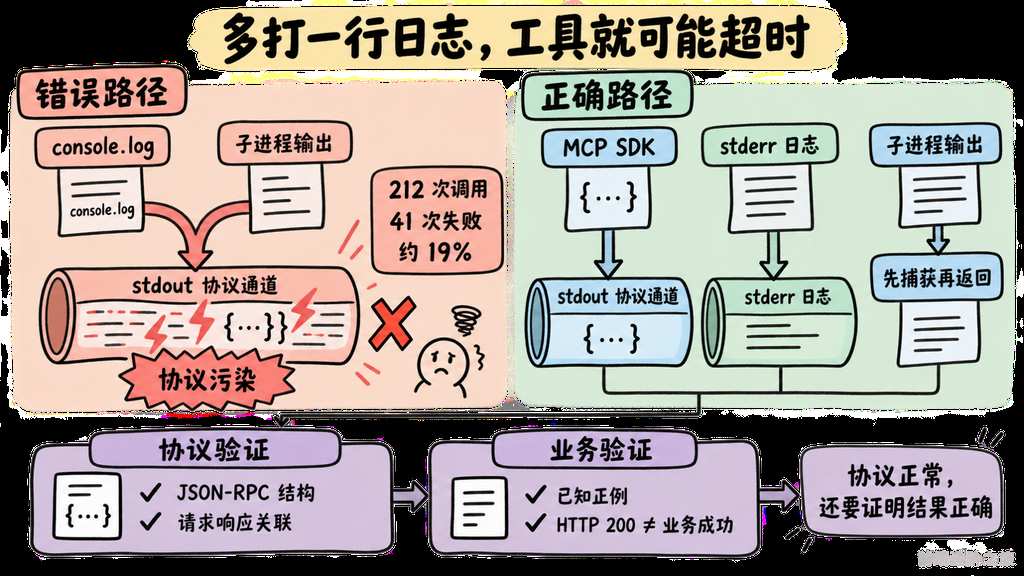
大概率你也遇到过,业务函数单独跑没问题,接进工具链就开始偶发失败,第一反应是怀疑模型没选对参数。
一篇 MCP stdio 排障文章里,作者记录了一周 212 次工具调用,其中 41 次失败,约占 19%。按作者追踪,这些失败都来自非协议内容写入 stdout,包括调试输出以及继承 stdout 的子进程。MCP stdio 排障记录
19% 是这个六工具服务器、这段观察窗口的结果,不是 MCP 的普遍故障率。真正值得复用的是故障定位方向。在 stdio 传输里,stdout 承担协议通信,随手加一句日志就可能污染消息。
如果你要是也在做本地 MCP Server,下面这段 JavaScript 表达的是日志与子进程输出的处理方式,协议输出继续交给 SDK。
import { execFile } from 'node:child_process';
import { promisify } from 'node:util';

const execFileAsync = promisify(execFile);

function log(event, details) {
  // 日志走 stderr,stdout 留给 MCP SDK
  process.stderr.write(`${JSON.stringify({ event, details })}\n`);
}

export async function readDiff(cwd) {
  // 捕获子进程输出,避免它直接写入协议通道
  const { stdout, stderr } = await execFileAsync(
    'git',
    ['diff', '--stat'],
    { cwd, timeout: 5000, maxBuffer: 1024 * 1024 }
  );
  if (stderr) log('git-warning', stderr);
  return stdout;
}
最容易翻车的是把捕获输出改成继承父进程的 stdio,或者在其他模块补一个 console.log(),当前函数再干净也挡不住。
前面那个 HTTP 200 返回错误业务结果的案例,刚好补上另一半问题。协议正常,只能说明消息能被解析;业务正常,还需要证明结果对得上已知事实。静默失败案例
下面这个简化检查把两层分开,适合放进已有测试里,而不是当成完整 MCP 协议验证器。
import assert from 'node:assert/strict';

export function verifyCapturedRun(stdout, result, expectedId) {
  const lines = stdout.trimEnd().split('\n').filter(Boolean);
  assert.ok(lines.length > 0, '没有捕获到协议消息');

  for (const line of lines) {
    const message = JSON.parse(line); // 调试文本混入时直接失败
    assert.equal(message.jsonrpc, '2.0');
  }

  assert.ok(Array.isArray(result.items));
  assert.ok(
    result.items.some(item => item.id === expectedId),
    '已知存在的记录没有被返回' // 空数组不能自动视为业务成功
  );
}
最容易误用的是最后一个断言,它依赖你事先准备可靠的正例;随便选一条可能不存在的数据,只会制造新的误报。
只检查每行能解析成 JSON 还不够,合法 JSON 日志也可能混入,完整测试还要检查消息结构、请求响应关联和业务结果。今天可以在测试分支故意注入一条 stdout 日志,再把一份已知命中的查询结果替换成空数组,确认两类故障都能被测试明确抓住。
六、多 Agent 和电脑操作模型,什么时候值得接进业务?
OpenRig 用 YAML 定义 Agent 团队,把 Claude Code 和 Codex 等编程代理组织成一个持久化系统。对已经开了一堆终端窗口、靠人记住每个代理在做什么的团队,这个方向确实有吸引力。OpenRig 项目
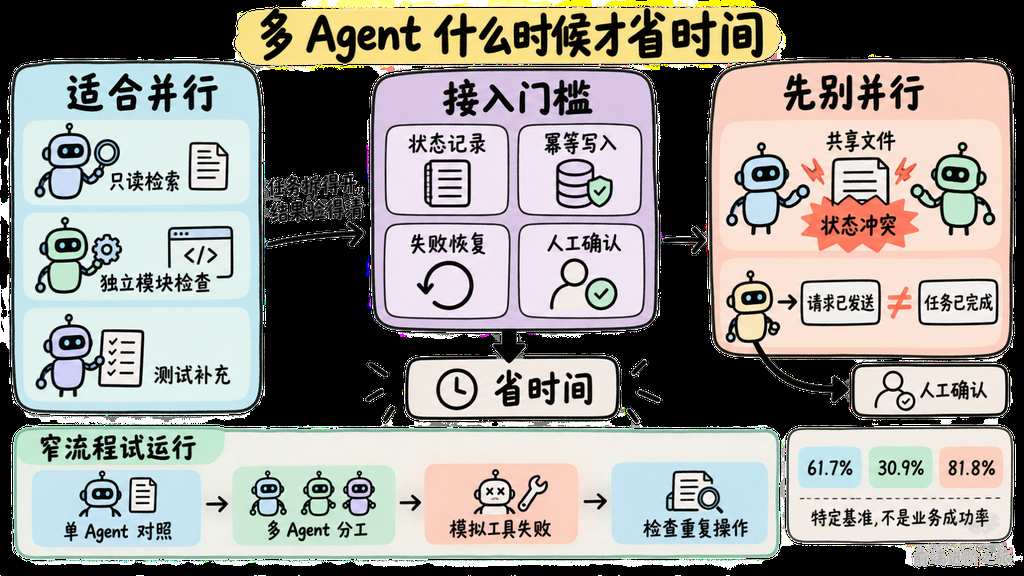
另一边,Holo4 把 GUI、代码、MCP 和 API 放进同一个模型的交互范围。发布方给出了 27B Dense 和 35B-A3B MoE 两种规格,并公开评测轨迹。在其披露的 OSWorld 2.0 结果中,27B 模型为 61.7%,35B-A3B 为 30.9%,对照的 Opus 5.5 为 81.8%。这些是特定基准分数,不能当作你公司后台任务的成功率。Holo4 发布介绍
一个负责组织多个执行者,一个扩大单个执行者能碰到的界面。放到 AI 办公提效里,确实可以想象这样的流程,读取需求、查业务数据、操作后台,再整理结果。
问题是,交接之后谁知道任务究竟进行到了哪一步?
生产架构文章提醒,系统必须记录已经发生的动作,否则一次重试就可能重复创建记录或重复发送邮件。Agent 状态与验证建议
我对多 Agent 的保留意见就在这里。多人分工尚且需要确认接口和责任边界,多个代理也不会因为都能读自然语言,就自动消除状态冲突。两个代理同时改同一个文件,或者上游把「请求已发送」写成「任务已完成」,后面的步骤可能一路沿着错误继续跑。
知识访问也一样。RAG 文章把文档处理、检索、排序、上下文组装和评估拆开讨论,提醒我们模型会推理与它能访问最新资料,是两件不同的事。RAG 工程解析
所以,给代理更长上下文、更多同事、更多界面之前,先问清楚它拿到的资料是不是有效,动作有没有执行,失败以后从哪里继续。
任务拆得开,结果验得清,多 Agent 才有机会省时间。
适合并行的可以是互不依赖的模块检查、资料检索和测试补充;强依赖、共享状态多的任务,协调成本可能吃掉收益。今天挑一个包含只读检索、结果汇总和人工确认的窄流程,分别用单 Agent 与分工方案跑一遍,中途模拟一次工具失败。看恢复时是否重复操作、交接记录能否解释结果,再决定要不要扩大范围。
总结
这期能从所给公告和记录中明确读到的,是 cf 的 API 覆盖扩展、工具链发布方给出的性能进展,以及几个带着具体样本的工程问题。PR 数据只覆盖一个组织,MCP 的 19% 只属于作者那周的调用记录,删库案例则发生在四月。把这些边界留住,消息才有用。
我的判断是,AI 编程接下来值得投入的地方,会更多落在验收、权限和反馈速度上。模型能力仍然重要,但一个结果无法验证、失败无法恢复的流程,换模型后也很难让人放心交付。
至于新模型在自己仓库里能省多少钱、Kimi K3.1 的最终规格、硬件隔离在实际部署中的效果,目前这些材料还不能替你下结论。
如果今天只能选一件事,我会拿一个最近合并的 AI PR,确认它究竟靠什么证明自己做对了。这件事查清楚,再选下一款工具,心里会踏实很多。
参考
- AI 代码生成与审查之间的验证鸿沟|dev.to
- 三个报告成功却实际失败的 Bug|dev.to
- PocketOS 数据库删除事故复盘|dev.to
- Nvidia 的芯片级 Agent 看门狗|The Decoder
- 生产级 Agent 开发的七个架构层|dev.to
- GPT-6 与 Claude Opus 5.5 同周发布回顾|dev.to
- Claude Opus 5.5 提示词指南|Claude 官方文档
- Ember-1 通过后训练减少推理 token|MarkTechPost
- Kimi K3.1 模型标识与预告页面曝光|IT之家
- 面向 Agent 的 cf CLI|Cloudflare Blog
- VoidZero 加入后的工具链进展|Cloudflare Blog
- MCP stdio 的 stdout 污染问题|dev.to
- OpenRig 多 Agent 协作项目|GitHub
- Holo4 通用计算机操作模型|Hugging Face Blog
- 从第一性原理理解 RAG|dev.to
- 前端进阶之旅