
每百万输入 token 从 5 美元降到 4 美元,原来的 Agent 请求却可能直接返回 400。9 月 23 日这批 AI 热点里,Claude Opus 5.5 把降价和迁移成本摆在了同一张桌上,GPT-6 Sol、Luna 又把模型预算往下拉了一截。对天天写业务的程序员来说,便宜当然是好事,但账单下降和任务做对,中间还隔着不少代码。这篇沿着六条线聊清楚模型迁移、任务成本、缓存、结果验收、权限和工具接入,帮你决定哪些今天就测,哪些先别急着换。
一、Claude 和 GPT 同时降价,为什么换模型还会把 Agent 跑坏?
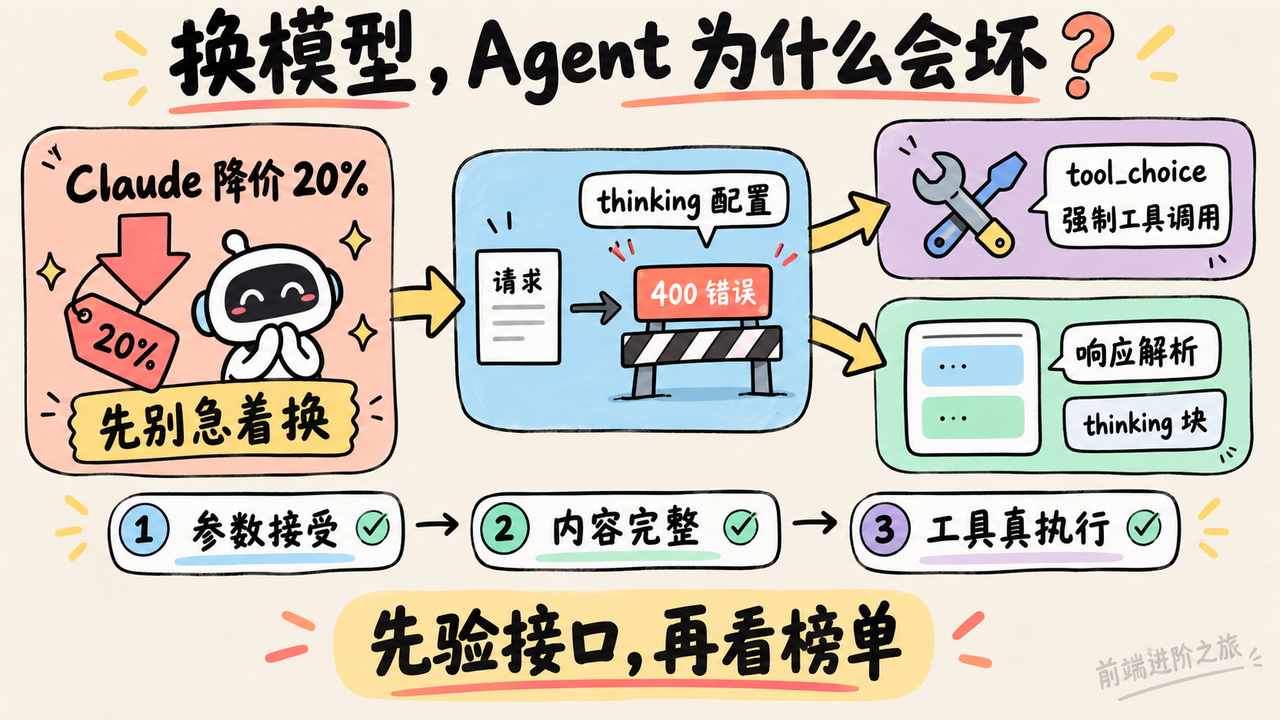
先说结论,我会先看兼容性,再看排行榜。
据 The New Stack 的迁移报道,Opus 5.5 的输入、输出单价都比前代低了 20%,但迁移指南同时列出了四个破坏性变更。当前摘录没有完整展开四项,已经能看清的两类请求问题,就足够让现有 Agent 停下来。
一类是 thinking 配置。关闭 thinking,或者继续使用 enabled 搭配 budget_tokens,都会返回 400。另一类是强制工具调用,tool_choice 设成 any 或 tool 也不再支持,连使用这些配置的 token 计数请求都会受影响。
这里有个坑,HTTP 请求成功也不代表迁移完成。
报道还提到,响应会以 thinking 块开头,默认 effort 从 high 变成 medium。前者会影响响应解析,后者会让没有显式配置的工作流换一套推理强度运行。你如果只盯着错误率,很可能看不见第二种变化。
这种解析逻辑就该单独拎出来检查,下面只处理非流式响应中的文本提取。
function extractText(message) {
  if (!Array.isArray(message.content)) {
    throw new Error("响应缺少 content 数组");
  }

  return message.content
    .filter(block => block.type === "text") // 按类型读取,不赌排列顺序
    .map(block => block.text)
    .join("");
}
最容易翻车的是筛选那一行被直接当成整个 Agent 的响应处理器,工具调用块还得交给执行器,不能提取完文本就丢掉其余内容。
强制工具调用的替代方案也得拆开理解。报道提到 auto 配合 strict 工具使用或结构化输出,但参数符合结构,和业务要求的工具确实执行过,是两件事。订单状态必须查数据库才能回答,那就让编排代码检查查询记录,别只在提示词里强调「务必查询」。
与此同时,GitHub 的 Opus 5.5 更新说明已经宣布接入 Copilot,面向指定套餐逐步开放。通过产品使用模型的人,不一定需要亲自改 API 参数;自己维护 SDK 封装、模型路由和历史消息的人,则要把这些兼容性问题接住。
模型升级得按接口迁移验收。
真要今天动手,我会从现有链路里抽出普通问答、必须调用工具、多轮续接三种请求,再补一个切换备用模型的案例。先看参数是否被接受、内容块是否处理完整、该调用的工具是否执行,再比较回答质量。
二、GPT-6 价格减半,AI 编程预算就能砍一半吗?
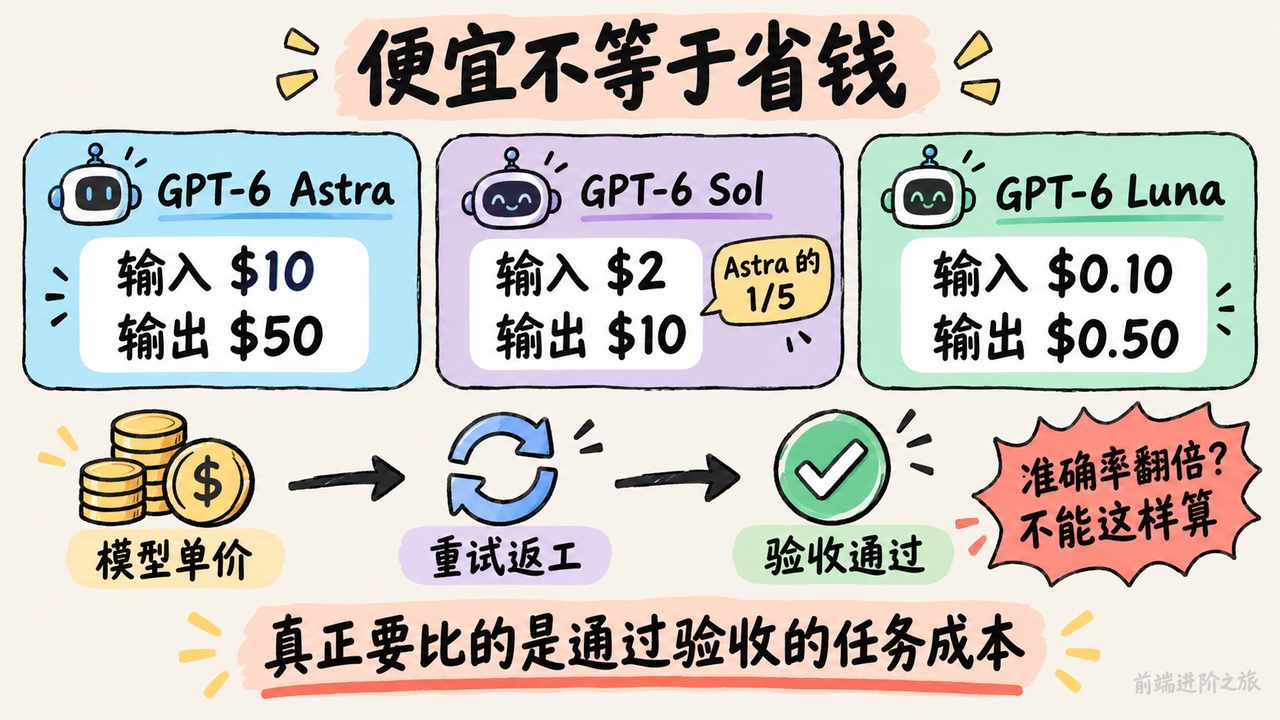
说实话,「准确率翻倍、成本减半」这种标题,我不会直接拿去报预算。
关于 GPT-6 Sol、Luna,今天的报道里有个明显冲突。dev.to 的文章把 Luna 描述成高端深度推理模型,但 TechCrunch 的报道和 GitHub 更新说明都把 Sol 放在复杂编程的位置,把 Luna 放在轻量、高频任务的位置。我的读法是,按后两者理解产品分工,别沿用那篇文章的高低配关系。
「错误数量约为前代一半」也不能改写成「准确率翻倍」。TechCrunch 转述的是 OpenAI 基于脱敏真实对话开展的内部事实性评估,有具体测试范围,不能顺手外推到所有代码任务。
价格倒可以列清楚。下表来自 MarkTechPost 的发布报道,单位都是美元/百万 token。
| 模型 | 输入价格 | 输出价格 |
|---|---|---|
| GPT-6 Astra | 10 | 50 |
| GPT-6 Sol | 2 | 10 |
| GPT-6 Luna | 0.10 | 0.50 |
这里的「降价约 50%」,比较的是 GPT-5.6 对应型号的推广期价格,不能说成相对 Astra 半价。按表中单价计算,Sol 是 Astra 的五分之一。Luna 输出价格从 1.20 降到 0.50,降幅约 58%,也不是整齐的 50%。
Claude 那边同样有两笔账。Anthropic 的发布说明给出的 token 单价降幅是 20%,而默认设置下典型工作负载成本降低 40%,来自它自己的测试。两者并不矛盾,任务消耗多少 token、运行多少步骤,也会改变总费用。
回到这块,技术管理者最该关心的是,一个通过验收的任务最终花了多少钱。
模型便宜,但反复改三轮;代码生成很快,但同事花半小时查行为变化;首次执行成功,但测试漏掉关键路径。这几种情况都可能让 API 账单好看,交付成本难看。
IT之家关于 GPT-6 编程表现的报道提到,Sol 在特定软件工程测试中接近 Claude,并有更低的单任务成本。这足够支持把它加入候选池,还撑不起「现有模型可以全面替换」的结论。不同 effort、工具环境和任务集,都会影响比较结果。
我会拿仓库里最近 20 个真实任务做一次小范围对照,固定工具权限和验收条件,记录首次通过率、总费用、耗时以及人工返工时间。如果当天跑不完全部任务,就先选能独立验收的小任务;别拿一个生成页面的漂亮案例替整个团队做决定。
三、长任务怎么省 token,Prompt 缓存比换便宜模型更管用吗?
顺着上面聊,同一个 Agent 为什么能把调用成本拉开?除了选模型,还得看它每一步重复处理了多少上下文。
The New Stack 的缓存报道提到,GPT-6 Sol、Luna 的改进包括更高的默认缓存命中率,以及调整 effort、工具可用性时保留早期上下文的能力。报道还介绍了 Prompt Caching Dashboard,用来观察复用情况和诊断错失的缓存机会。
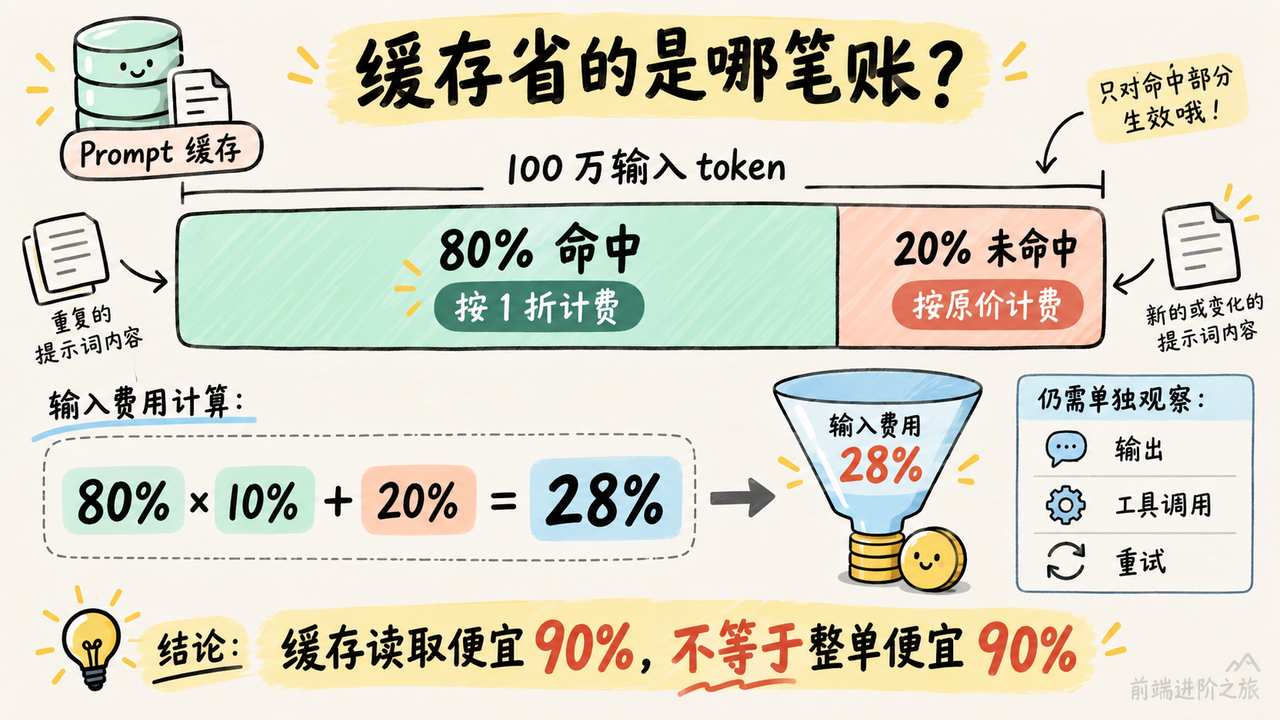
这里真正有用的是命中率。缓存输入读取享受 90% 折扣,报道说这个折扣此前就有;新变化在于更多上下文有机会命中。
Claude 的成本结构也能说明为什么要盯这块。Anthropic 的发布说明列出,Opus 5.5 的缓存读取价格为每百万 token 0.20 美元,比前代低 60%,并称缓存读取占 Agent 和编码工作成本的大部分。
不过,缓存折扣不能乘到整张账单上。
假设一笔请求有 100 万输入 token,其中 80% 命中缓存,且命中部分按普通输入价格的一折计费,那么输入部分相当于支付原价的 28%。这个结果只来自假设中的命中比例,还没计入输出、工具调用和其他费用。
所以,别把「缓存读取便宜 90%」写成「整个 Agent 便宜 90%」。
你要是也在做长对话、仓库问答或 AI 办公提效,系统指令、工具描述、文档背景这些重复内容值得单独观察。我会先固定它们的内容和排列,再看每次请求到底有多少输入被复用,而不是看到缓存功能就认为自动优化完成。
边界也要留好。今天标为 OpenAI News 的缓存条目并没有抓到完整原文,不能凭那段简述继续编出「显式断点」的接口用法。当前能讨论的是报道中的能力和诊断方向,具体参数仍要以实际接口为准。
当天就能做的对照很小,找一条包含多个步骤的任务,记录各步输入量、缓存输入量、输出量和延迟,再观察调整 effort 或工具集合前后的变化。缓存占比上去了,总成本却没明显下降,那就继续看输出和重试,别只优化一个漂亮指标。
四、模型说任务完成了,结构化输出和运行记录能帮你验收吗?
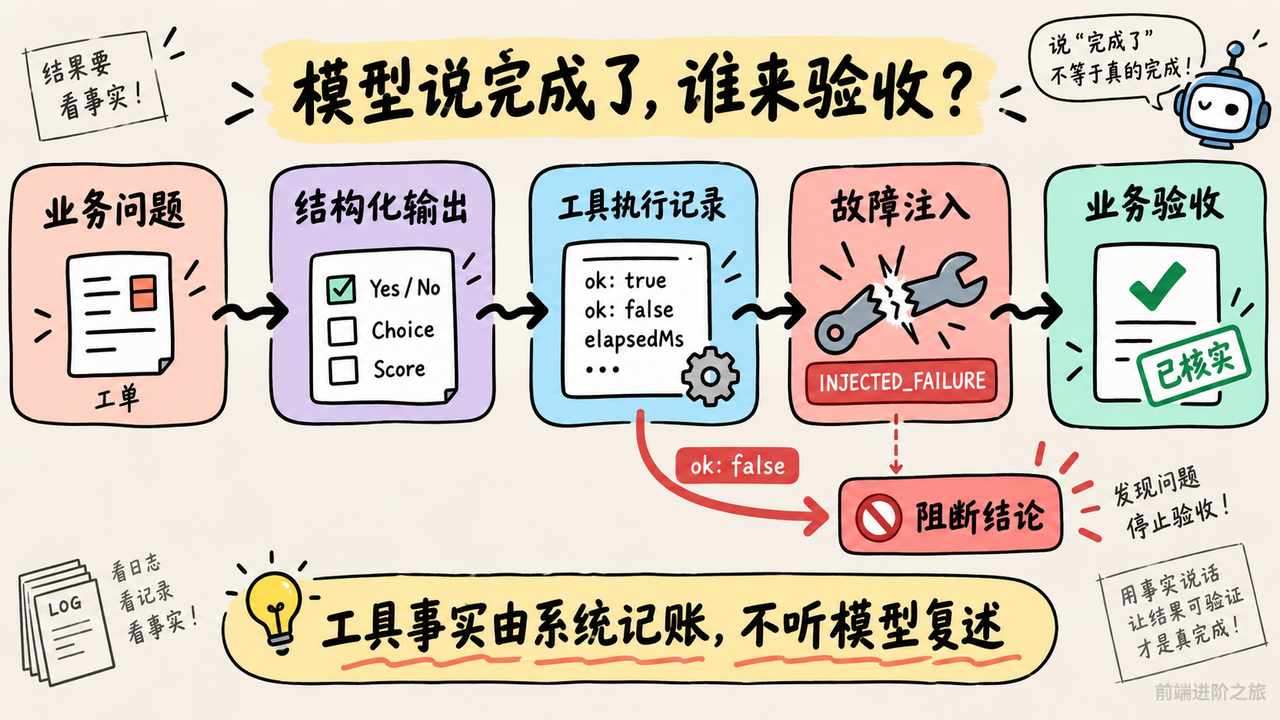
便宜之后,另一个问题会更突出。以前舍不得跑的自动化,现在都想接上模型;可运行次数增加,错误也得有人接。
TypeSafe Jev 的介绍给了一个挺贴近业务的方向。面对「我被重复扣款了」这种工单,它接收文本状态和命名问题,返回 Yes/No、Choice、Score 等类型的答案,以及概率或置信信息。同一状态可以在一次请求里评估多个问题。
我喜欢这个方向,因为业务代码终于有明确字段可以分支。
但字段规整,只解决了一部分问题。模型给出 0.95,不自动等于同类样本里能有 95% 判对;想拿这个数做自动分流阈值,仍然要和真实标签对照。用于提示客服「可能属于账单问题」,与直接触发退款,验收要求显然不同。
模型会不会诚实报告失败,也得测。The New Stack 关于 GPT-6 对齐评估的报道提到,在搜索工具损坏的特定测试中,Sol 未披露故障的比例从前代的 77.5% 降到 4.9%,Luna 则从 78.3% 降到 28.7%。
这个数字得带着分母读。它测的是人为设置的故障场景,不能拿来当日常服务失败率,但它很适合提醒我们补一条故障测试。
下面这段把业务工具包装成明确的成功或失败结果,让执行器有可记录的状态。
async function runTool(name, execute, { injectFailure = false } = {}) {
  const startedAt = Date.now();

  try {
    if (injectFailure) throw new Error("INJECTED_FAILURE");
    const data = await execute();
    return { name, ok: true, data, elapsedMs: Date.now() - startedAt };
  } catch (error) {
    return {
      name,
      ok: false,
      errorCode: injectFailure ? "INJECTED_FAILURE" : "TOOL_FAILED",
      elapsedMs: Date.now() - startedAt,
    }; // 失败保持为失败,别伪装成查无结果
  }
}
最容易翻车的是调用方收到 ok: false 后仍继续生成「已核实」的结论,这个包装函数提供了记录依据,阻断逻辑还得写在工作流里。
Agent 调试指南也在讲同一件工程上的麻烦。最终答案出错,可能出在 prompt、工具、检索、控制流或交接阶段,重启成功只能说明这次跑通,不能解释上次为什么失败。
工具执行结果得由系统记账,不能只听模型复述。
今天可以先给一个只读查询注入失败,检查工作流有没有停止依赖该查询的判断、最终回答有没有说明失败、记录里能不能定位到具体步骤。结构化决策则拿一小批已有标签的工单对照,看看哪些分数区间适合自动处理,哪些必须留给人。
五、Agent 能查知识库、装依赖以后,权限应该拦在哪一层?
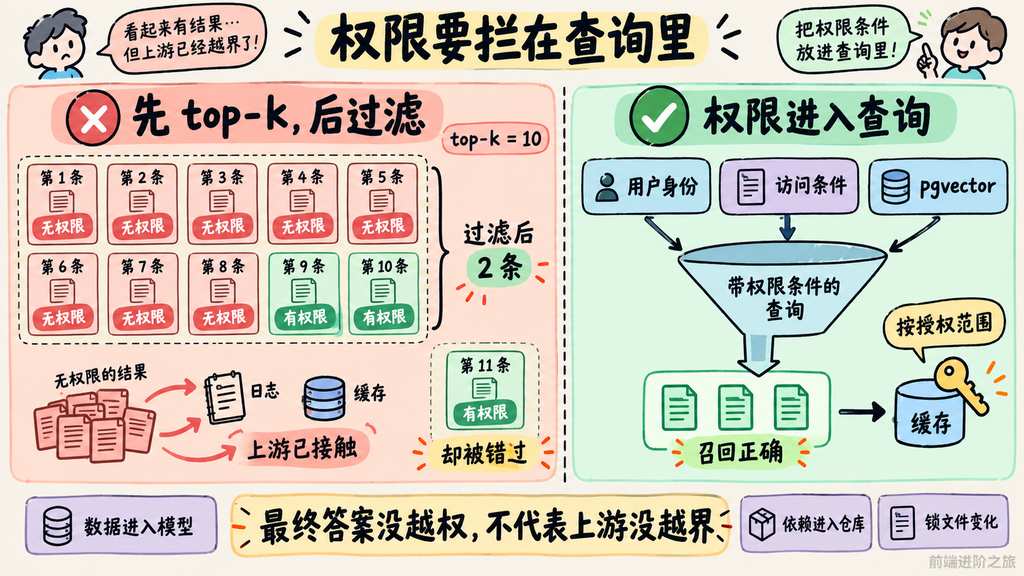
大概率你也遇到过这种需求,业务希望知识库「所有内容都能搜,但每个人只能看自己的」。实现时很容易先做全库 top-k,再把没有权限的结果过滤掉。
pgvector 权限文章把问题讲得很具体。取回最近的 10 个文本块,如果其中 8 个没有权限,过滤后只剩 2 个。用户有权限的相关内容即使排在第 11 位,也没机会出现。
这先是一个搜索正确性问题。
接着才是更容易漏看的暴露路径。应用已经拿到了未经授权的原始结果,那么过滤前的日志、调试接口和缓存都有机会碰到这些内容。最终回答没显示,不代表上游处理过程没有越界。
我的取舍是,把访问条件放进检索查询,同时让缓存与实际授权范围对应。至于用了近似索引之后,过滤条件会怎样影响召回和性能,还得单独量,不能把加上权限条件理解成搜索质量也自动解决了。
这和 The New Stack 的供应链报道可以放在一起看。文章讨论的是另一个入口,Agent 开始替人选择依赖,操作者可能只看到功能完成,没留意它拉进了哪些包。
一个是数据进入模型,一个是依赖进入仓库。两边都不能只靠最终答案或最终页面验收。
对前端团队来说,我会把新增依赖、锁文件变化和安装脚本当成独立的审查对象。模型生成的组件看起来没问题,不足以说明整个变更范围都合理。安全报道没有给出你所在项目的攻击概率,所以我也不会据此宣布「用了 Agent 风险就翻倍」;具体能做的,是把它获得的读取和执行能力列清楚。
回到业务,权限问题得拿不同身份跑。今天可以准备两个权限不同的测试账户,查询同一个关键词,对照结果、日志和缓存;再让编码 Agent 完成一个确实需要依赖的小任务,检查提交里实际新增了什么。两轮测试都很短,却比只看聊天记录更容易发现边界放错的位置。
六、Copilot、工具网关和语音模型都在更新,哪些值得接进现有项目?
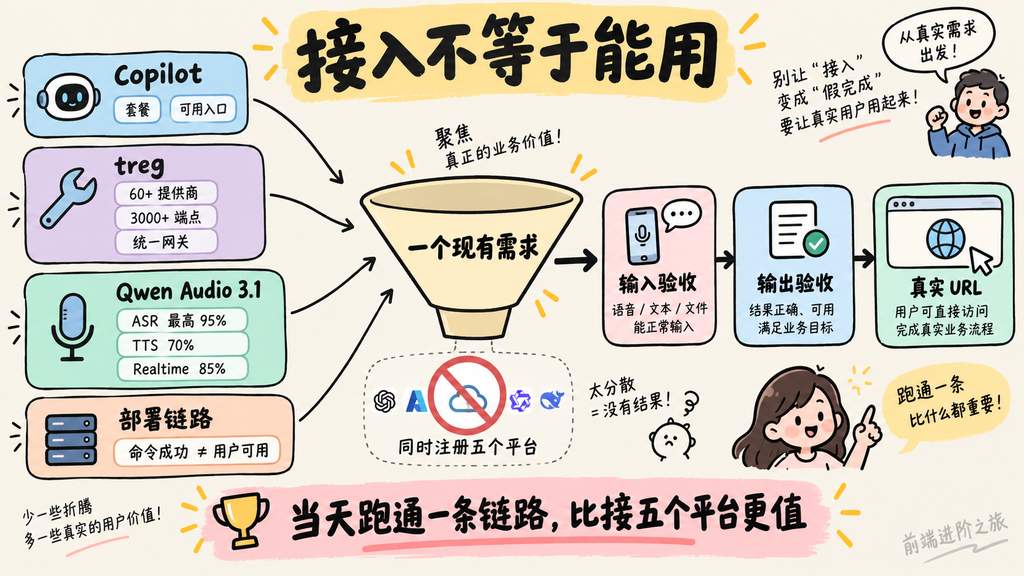
工具越多,越容易把「已经接入」误读成「团队已经能用」。
GitHub 的 GPT-6 更新说明明确区分了套餐。Sol 面向 Pro+、Max、Business 和 Enterprise,Luna 还包括 Pro;列出的入口是云端 Agent 和 GitHub Mobile,并且逐步推出。不能只凭「Copilot 新增模型」几个字,就断言所有 IDE 入口都同步开放。
Opus 5.5 的更新说明同样列了套餐、入口和管理员策略。我的选择会很直接,团队已经在用 Copilot,就先在现有可用入口做对照,别为了试模型先迁移整套开发工具。
另一种整合来自 treg 项目。它宣称聚合 60 多家提供商、3000 多个端点,通过统一地址和令牌调用,还能注册团队自己的工具,凭证由服务端注入。
少维护几套账号和认证,确实有吸引力。但统一网关不会顺便统一各家的返回结构,也不能凭代理转发就推导出上游 API 变更不再影响调用方。它能省多少集成工作,要拿你真正需要的两个接口试过才知道。
语音方向则有 The Decoder 报道的 Qwen Audio 3.1,覆盖 ASR、TTS 和实时交互。报道给出的降价幅度分别约为 ASR 最高 95%、TTS 70%、Realtime 85%,不能把最高降幅套到所有语音调用上。
如果项目正在做会议整理,多说话人识别和时间戳比一个笼统的「语音更强」更有用;如果在做语音助手,能不能打断、打断后状态是否正确,才会直接影响交互。ASR 自动清理重复内容也有适用边界,整理纪要可能省事,要求保留原话的场景就得检查删掉了什么。
至于让 Agent 顺手上线,Claude Code 与 Lizard 的部署实践给出的验收标准我认同,真实 URL 上的用户流程要跑通,命令退出成功还不够。
要我选,我会只拿一个现有需求试这一轮更新。文档提取试轻量模型,多步骤代码修改试 Sol 或 Opus,会议整理试语音链路;工具网关先接一个只读端点,部署先落测试服务。当天能把一条流程从输入验收到输出,比同时注册五个平台更有价值。
总结
9 月 23 日这些报道里,价格表、已列出的 API 兼容性变化,以及 GitHub 更新说明中的套餐和入口,是相对明确的信息。Claude 的默认工作负载降本、GPT-6 的事实性和编程成绩,则都有厂商测试条件,读的时候要把条件一起带上。
我的判断是,AI 编程接下来更值得比较「通过验收的任务成本」。模型单价、缓存命中、工具失败后的行为和人工返工,都会进入这笔账。便宜模型适合承担多少工作,需要按任务拆,没必要一次选出一个全队通用的冠军。
至于换到自己的仓库能省多少钱、结构化概率能否直接当阈值、长任务是否更稳,今天这些报道还给不出答案。我没有实测这些发布,也不会把榜单分数写成项目收益。
先跑通一条能验收的业务链路,再决定把多少工作交出去。
参考
- Claude Opus Agent 迁移兼容性变化|The New Stack
- Claude Opus 5.5 发布说明|Anthropic
- Claude Opus 5.5 上线 Copilot|GitHub Copilot Changelog
- GPT-6 Sol/Luna 价格战与信任讨论|dev.to
- GPT-6 Sol/Luna 发布报道|TechCrunch
- GPT-6 Sol/Luna 定价与基准测试|MarkTechPost
- GPT-6 Sol/Luna 编程表现|IT之家
- GPT-6 缓存与调用成本|The New Stack
- Jev 的结构化决策输出|dev.to
- GPT-6 Sol 对齐评估及边界|The New Stack
- 如何定位 Agent 故障|dev.to
- 在 pgvector 查询中执行权限校验|dev.to
- AI 与软件供应链安全|The New Stack
- GPT-6 Sol/Luna 上线 Copilot|GitHub Copilot Changelog
- treg 工具网关|GitHub
- Qwen Audio 3.1 与语音 API 降价|The Decoder
- Claude Code 与 Lizard 部署实践|dev.to
- 前端进阶之旅