
昨天这批 AI 热点里,最抓眼球的是一个价格数字。Cognition 放出 SWE-2,FrontierCode 上 50.0%,对着 Fable 5.1 的 50.9%,差 0.9 个点,成本低 64%。放进采购表是一句很好听的话。可同一份报道往下翻两行,Terminal-Bench 4 上两者是 27.3% 和 55.8%。一个便宜六成的模型,和一个在终端任务上掉一半的模型,是同一个模型。这篇挑六条线聊清楚,也说说我自己会怎么取舍。
一、便宜 64% 的代码模型,为什么先别急着换
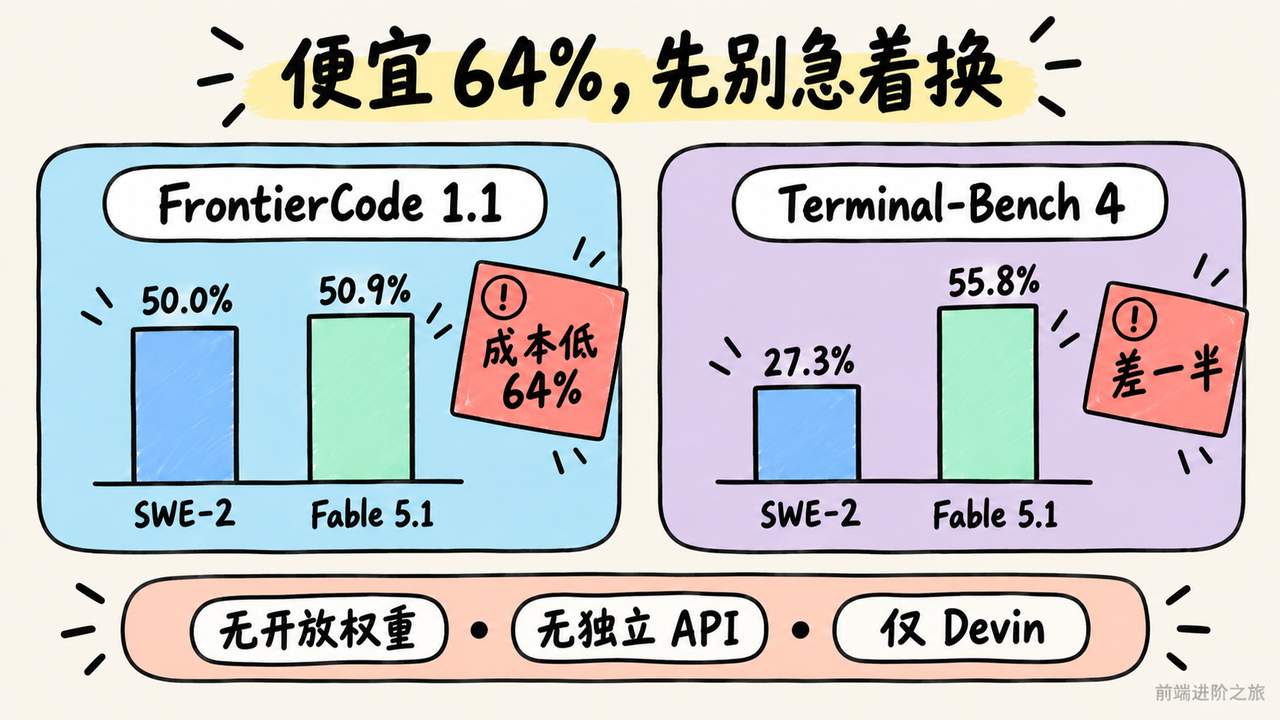
先把数字摆齐再下判断。据 MarkTechPost 转述,SWE-2 是在 Kimi K3 上做的后训练,FrontierCode 1.1 Main 拿到 50.0%,Fable 5.1 是 50.9%,报道给的成本降幅是 64%。同一篇里,Terminal-Bench 4 的成绩是 27.3% 对 55.8%。MarkTechPost:SWE-2
那为什么同一个模型在两个榜上差这么多?我的读法是,前者更接近「给你一个仓库和一个 issue,产出一个补丁」,后者更接近「你自己在一台机器上,一步一步把事情做完」。这是我的理解,准确口径还得看两个基准的官方说明。
回到选型这件事上。你得先问自己,你的 Agent 平时干的活更像哪一类。如果它主要帮你改组件、补类型、写单测,单次补丁的能力够用,这 64% 是真省。如果你让它跑 yarn build、看报错、改 Dockerfile、失败了再重试,那就是多步终端任务,27.3% 这个数你必须认。
还有一层更硬的限制。报道里说 SWE-2 没有开放权重,也没有独立 API,当时只能在 Devin Desktop 和 CLI 里跑。所以对想把模型嵌进自家服务的全栈团队来说,它现在连候选都算不上。
省下来的 64%,很可能以人工复核时间的形式重新付出去。
同一天 The Decoder 报道的 Iris,给了另一种更值得学的评估姿势。团队说 Iris mini 和 pro 是同类开源权重搜索 Agent 里最强的,同时专门跑了开启和关闭上下文管理的两组对照,用来区分模型本身和运行框架各贡献了多少。The Decoder:Iris
这个做法比结论本身有价值。你现在看到的任何「某某 Agent 很强」,都是模型乘框架乘工具权限乘提示词的结果,厂商换一套 harness 分数就能动。素材里对 Iris-mini 的参数和基座描述前后不太一致,所以部署资源我不敢照着估,这块你自己看官方说明。
真要判断换不换,我会拿仓库里最近 20 个真实任务,固定权限和验收条件跑两个候选,最后只看一个数,每个被接受的结果花了多少钱、多少人工分钟。榜单负责帮你缩小候选,这个数字才决定换不换。
二、模型说「做完了」,你凭什么信
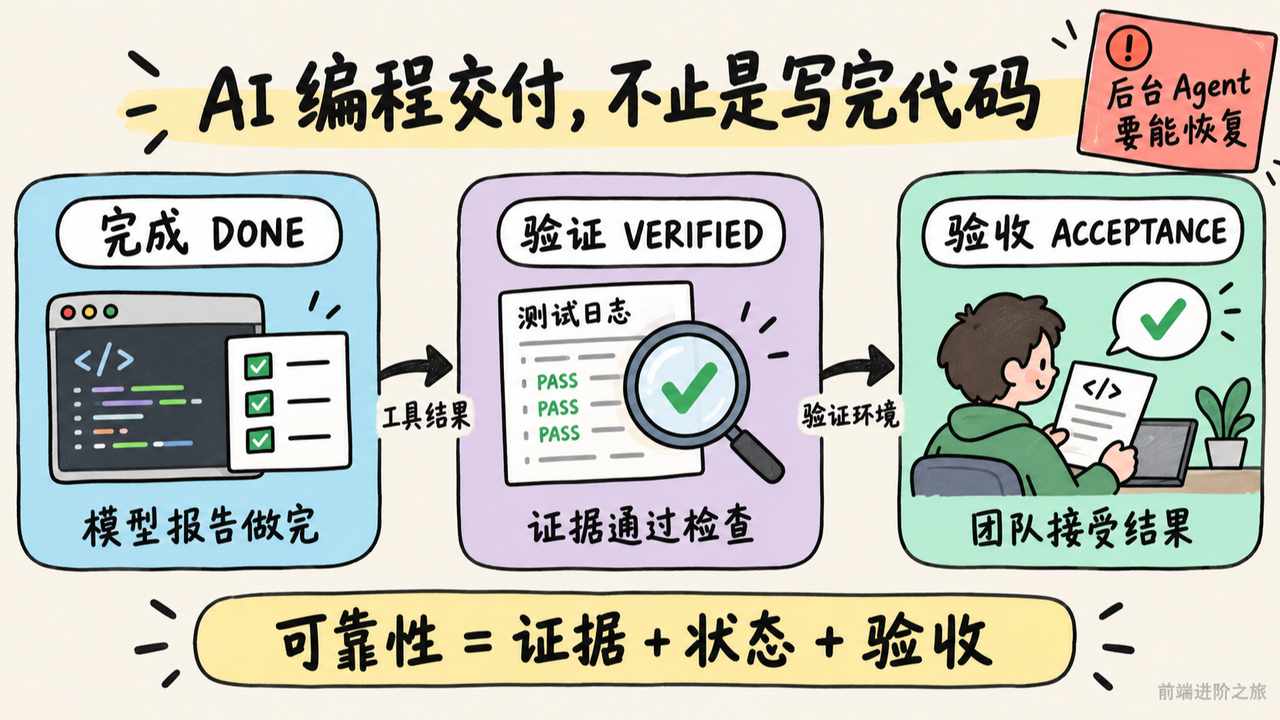
昨天有三个互不相干的作者,在解决同一个问题的不同段。
Loomwright 的作者受不了编程 Agent 在「完成」被定义之前就开始改文件,干脆做了个 plan-first 的壳。先出一份含可行性、受影响文件和子任务的简报,再交给 Supervisor 执行,Worker 各自在 git worktree 里干活,文件重叠就排队,按顺序合。默认交付边界是一个待审阅的 PR 而不是静默合并,他也留了受信任门禁下的可选自动合并,别把默认行为读成「任何配置都绝不合并」。Loomwright 作者实践
KIRA 卡的是另一头,运行时必须拿到真实的工具返回,才允许报告操作完成。KIRA 作者介绍
第三篇讲跨工具交接,把状态拆成 DONE、VERIFIED 和接收方验收三层,流程写成 WORK → HANDOFF → ACCEPTANCE → WORK,接收方先确认关键文件、URL 和测试结果,再接着往下做。跨 AI 交接实践
一个管执行前,一个管执行中,一个管交出去。三件事拼起来是同一句话。
模型说「做完了」和团队收货之间,隔着一份证据。
举个前端每天都能碰到的例子。需求是「完成租户切换」。Agent 大概率改完导航和请求参数就宣布完成,而验收真正要看的是旧租户数据有没有残留、切换失败怎么回退、刷新之后租户状态还对不对。这三条不写进任务描述,它不会做,做了你也没法判断它做没做。
所以验收单这东西不用上工具,一个对象就够,跟着 PR 一起提交,或者直接塞进任务描述给 Agent:
// 一次 AI 编程任务的交接记录,字段少但每个都得填实
const handoff = {
  goal: '切换租户后刷新页面,仍然停留在新租户',
  status: 'verified', // implemented → verified → accepted,三种状态别混用
  changes: ['src/stores/tenant.ts', 'src/app/(web)/layout.tsx'],
  evidence: {
    tests: 'yarn test:web --grep tenant-switch → 12 passed',
    env: 'staging', // 这行最容易被省掉,省掉整份证据就没了意义
    artifact: 'https://ci.example.com/runs/8421'
  },
  blocked: [],
  nextForReviewer: '重点看切换失败时的回退分支'
}
env 那一行是我见过被省得最勤的。这里唯一要拿捏的也正是验证强度。不是所有任务都得在生产验证,但每条证据必须写清环境。开发环境通过、测试环境通过、生产环境通过是三种完全不同的交付状态,混在一起写成「已测试」就等于没写。
小任务别上这套。改个文案还要走一遍简报,前置成本比返工成本还高。跨模块改造、涉及状态和缓存策略的,才值得付这笔钱。真要看值不值,拿首次验收通过率、遗漏项个数和人工复核分钟数跟同类历史任务比一比,几轮下来心里就有数了。
三、规则文件和 Hook,到底哪个能拦住事故
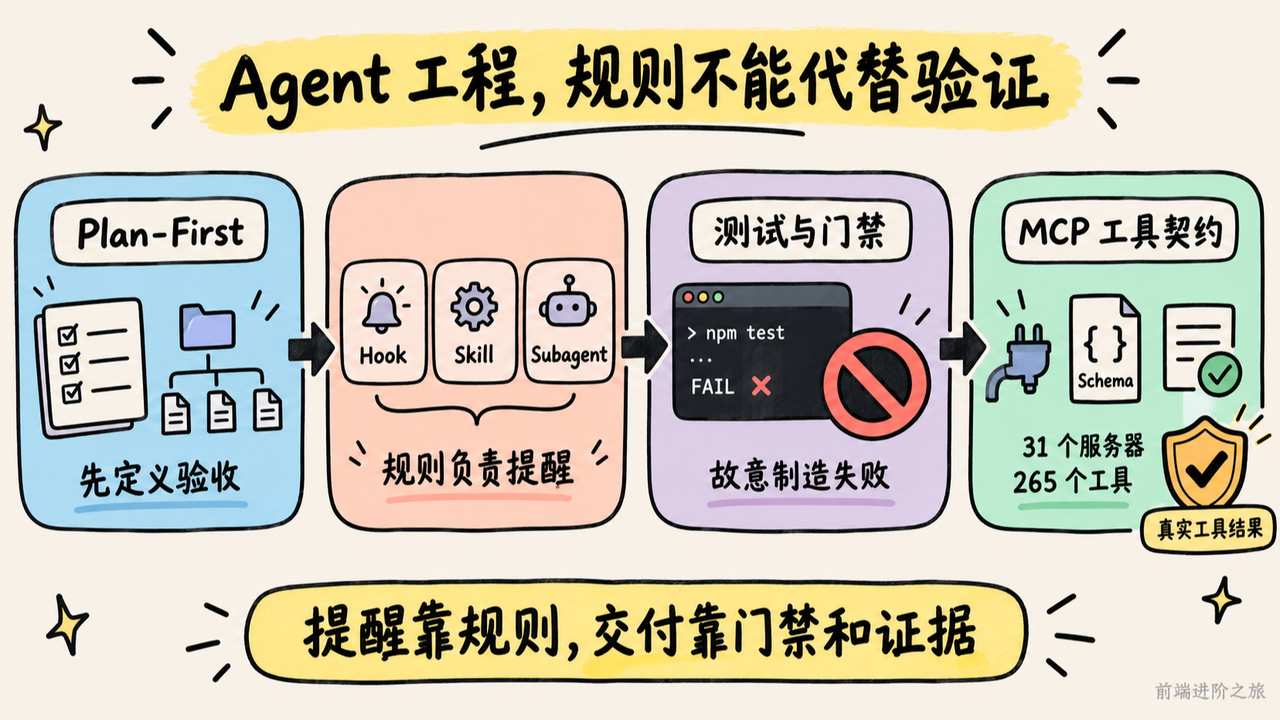
有篇 Claude Code 扩展实践把三种机制分得挺清楚。Hook 由事件触发,Skill 是模型按需取用的知识和流程,Subagent 用独立上下文处理工作。作者踩的那个坑很典型,他把「总是要跑 linter」写成了 Skill,结果模型时不时就跳过。Claude Code 扩展实践
这个坑值得单拎出来说。Skill 是「你可以用」,Hook 是「你必须经过」。把强制性要求写成建议性文档,约等于没写。
另一篇审计了 50 个用 Cursor 和 Claude 生成的项目,列了四类反复出现的问题,查询缺租户隔离、敏感值比较方式不对、数据库事务里塞第三方网络请求、用浮点数算钱。作者的对策是把这些写成可注入的规则文件。AI 辅助项目审计
我对规则文件这条持保留意见。不是说它没用,而是素材里没有给出注入前后的独立效果测量,提示词变长和问题变少之间隔着一个没人测过的假设。
更稳的分工是让规则负责提醒,测试和门禁负责验证。租户隔离要有跨租户访问的用例,金额计算要有边界样例,事务范围得人眼过一遍执行路径。这三样谁都替代不了一句「请注意不要」。
Hook 也不是万能的。事件触发确定,不等于命令执行正确、覆盖了全部改动、失败之后会真的挡住后续动作。配完之后去隔离分支故意提一个该被拦住的改动,看它到底拦不拦,这一步五分钟,能省掉一次「我们明明配了 CI」的尴尬。
顺着上面聊,工具那一层也一样。KIRA 要求拿到真实工具结果再报完成,这比凭模型自述更接近可审计流程,但 mcp-drill 的测试揭了下一层的底。作者说自己扫了 31 个服务器、265 个工具,报告里约 3% 具备能拒绝腐化响应的契约。mcp-drill 作者测试
这个数字得带着分母读。摘录里百分比对应的分母不够明确,不能改写成「只有 3% 的 MCP 服务器能用」,它测的也是特定故障模式,不是整体服务质量。但方向是可信的,大量工具对自己的输出根本没有约束。
对你更有用的是自己把那几种失败复现一遍。故障注入不需要什么框架,一个数组加一个循环就能跑:
// 对一个关键 MCP 工具做故障注入,重点不是「会不会崩」
const faults = [
  { name: '字段缺失', payload: { ok: true } },
  { name: '响应截断', payload: { ok: true, data: '{"items":[{"id"' } },
  { name: '未知工具名', payload: { ok: false, error: 'unknown_tool' } },
  { name: '超时', payload: null, delayMs: 30_000 },
  { name: '业务状态离谱', payload: { ok: true, data: { balance: -1 } } }
]

for (const fault of faults) {
  const result = await agent.callTool('queryOrder', { id: 'A-1' }, { mock: fault })
  // 要断言的是它有没有拿着坏数据继续执行依赖动作,而不是进程还活着
  console.log(fault.name, result.rejected ? '拦住了' : '漏过去了,这条就是要修的')
}
最后那条 balance: -1 最阴。结构完全合法,Schema 校验一路绿灯,错误结果直接进了下一步决策。
四、后台 Agent 跑起来之后,状态放在哪
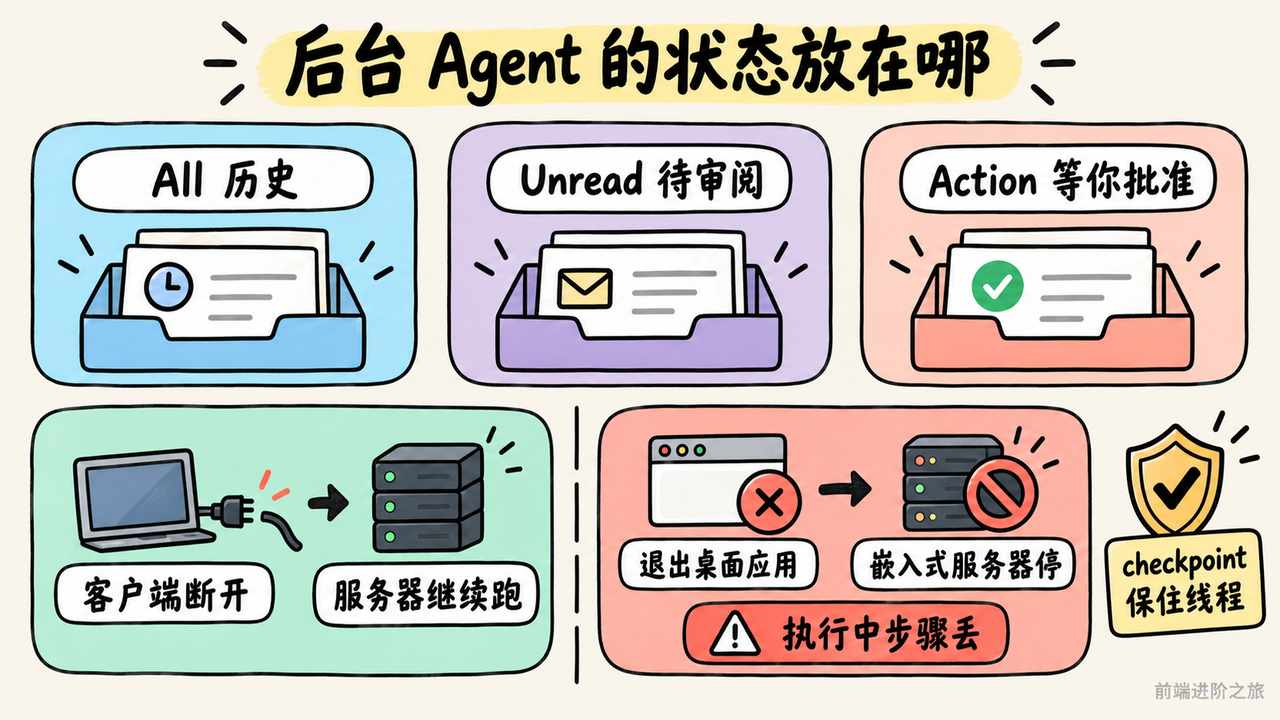
AWS 开源的 Pizza Bot 把后台 Agent 做成了收件箱,线程分 All、Unread 和 Action 三栏,分别装历史、已完成待审阅、等你批准或回复的任务。支持手动、cron 和 webhook 触发,用 LangGraph checkpoints 保存线程状态和审批暂停点。MarkTechPost:Pizza Bot
收件箱这个隐喻我挺喜欢。它承认了一件被很多产品回避的事,后台 Agent 的产出不是结果,是待办。全都混在聊天记录里,用户每次回来都得自己重建一遍进度。这一点和交接实践里的 ACCEPTANCE 层是一回事,总得有一个明确的接收时刻,让人决定接受、补信息还是退回去重做。
部署边界得看清楚。报道里明确区分了两种断开,客户端断开不会停掉服务器的工作,而退出桌面应用会停掉它的嵌入式服务器并结束正在跑的任务。checkpoint 保住线程,执行中的那一步可能丢。想让它在你合上电脑之后继续干活,就得有常驻后端。
所以评估这类 AI 办公提效产品,我会先安排一次中断演练。关窗口、退应用、重启后端,三种情况分别发生什么,任务会不会重复执行,用户看不看得见恢复位置。这比宣传页上「支持持久化」五个字有用得多。
另外两篇讲的是运行时怎么记事。一篇把上下文工程拆成压缩、记忆、预算和待办状态四个机制,另一篇比较了滑动窗口、摘要和向量存储,窗口简单但丢旧信息,摘要留主线但损细节,持久化存储用于跨会话检索。MarkTechPost:上下文工程、Agent 记忆实践
把两篇并排看,能提炼出一条可操作的建议,把信息分类维护,稳定偏好、项目约定、当前进度、执行证据各归各的。摘要可以压缩讨论过程,但绝不能把「计划测试」压成「已经测试」。长期记忆也未必都得上向量库,选什么存储该由查询方式和更新频率决定。
错误的记忆比缺失的记忆难发现得多。
想知道自己这套有没有问题,故意改掉一条旧偏好,或者撤销一个已经做过的决定,看 Agent 还会不会拿着过期信息往下跑,一次就能看出来。
五、「超越人类」这类结论,该打几折看
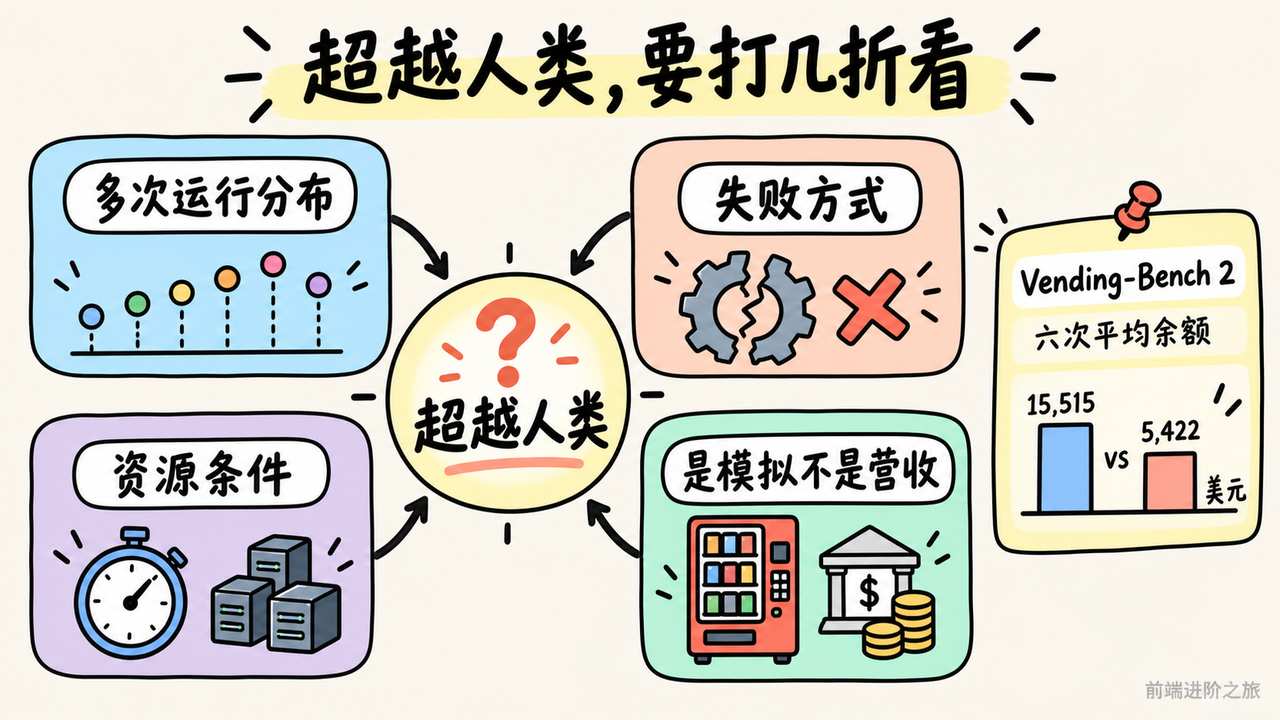
The Decoder 转述了 Andon Labs 的测试。GPT-6 Astra 在六次 Vending-Bench 2 运行里,平均最终银行余额是 15,515 美元,Fable 5.1 是 5,422 美元。注意这是模拟经营结束后的银行余额,不是真实营收、利润或者投资回报,换个词味道就全变了。同一篇里的无人机结果,限定在五项子任务的最佳尝试超过人类与 AI 开发基线,成功率本身还有波动。The Decoder:GPT-6 Astra 测评
把它和 Iris 那套对照实验放一起,我的判断是长程任务表现确实该进选型清单,但任何一条成绩只要没同时给出多次运行的分布、失败方式和资源条件,就只能当作线索。
培训这块也有一份两年期数据。法学课堂研究比较了禁用 AI、无指导使用和结构化培训三组,2024 年 66 名学生,2025 年 164 名。无 AI 组两年都垫底,但第二年各组表现已经接近,培训带来的优势明显缩小。The Decoder:课堂 AI 研究
这话可能有点刺耳,但它不能证明程序员用 AI 必然提效。课堂任务、软件交付和线上维护之间的差距太大了。真正能借鉴的是它的比较方式,用同类任务对照不同流程,同时记录完成时间、错误率和审阅成本,而不是只收集「感觉更快」的主观反馈。
六、Agent 拿到发布权限之后,谁来兜底
RubyGems 那篇事件分析称,2026 年 5 月出现了 2000 多个软件包的集中投送,重点落在发布权限、依赖准入和行为记录上。原文明确提到关于 Agent 的归因包含间接证据,所以这里按该文描述的事件与归因呈现,不能当成已经独立确认的攻击结论。RubyGems 事件分析
另一头,enterprise-claude-kit 在 Claude API 调用前后加了 PII 检查、预算控制和审计日志,用的是追加式、基于 SHA-256 的篡改可检测记录。这和「日志天然不可修改」不是一回事,更不能凭一份功能清单就宣称满足企业合规。enterprise-claude-kit 作者介绍
两份材料指向同一个动作,把「允许生成内容」「允许调用外部工具」「允许发布产物」拆成三份独立授权,再用真实操作记录去核对。很多团队现在是一把梭,一个 token 什么都能干,出事之后连是谁干的都查不出来。
最简单的自查是把你给 Agent 的凭证作用域列出来,在测试环境执行一次受控操作,看身份、时间、对象、结果这四项能不能对上。对不上就说明你现在的追溯能力是假的。
总结
这一批 AI 热点里,能确认的事实是多个独立项目正在把验收、状态和权限做成显式机制。Loomwright 把计划前置,KIRA 要求工具证据,Pizza Bot 给出审批和待审阅状态,mcp-drill 去检查工具的输出契约。它们都提出了机制,但没有一份材料能证明这些机制已经普遍改善了生产交付。
我的判断是,AI 编程和 AI 办公提效接下来会越来越多地按交付结果算账。生成速度、调用价格和对话体验仍然重要,但任务一旦跨多个步骤和工具,审查、恢复、交接的成本就得进同一本账。
这里也有反方信号。一份关于 OpenAI 内部实践的播客转述说,部分用来补偿旧模型长任务弱点的机制,会随着模型进步失去必要性。这提醒我们别把今天的绕行方案永久固化。不过它属于二手转述,具体范围还得等一手信息确认。Codex 安全门禁实践转述
一个折中的做法是把目标、权限、任务状态和验收证据当成稳定接口,把摘要策略、上下文阈值和模型特定提示做成可替换配置。前者表达你对交付的要求,后者跟着模型能力重新测。
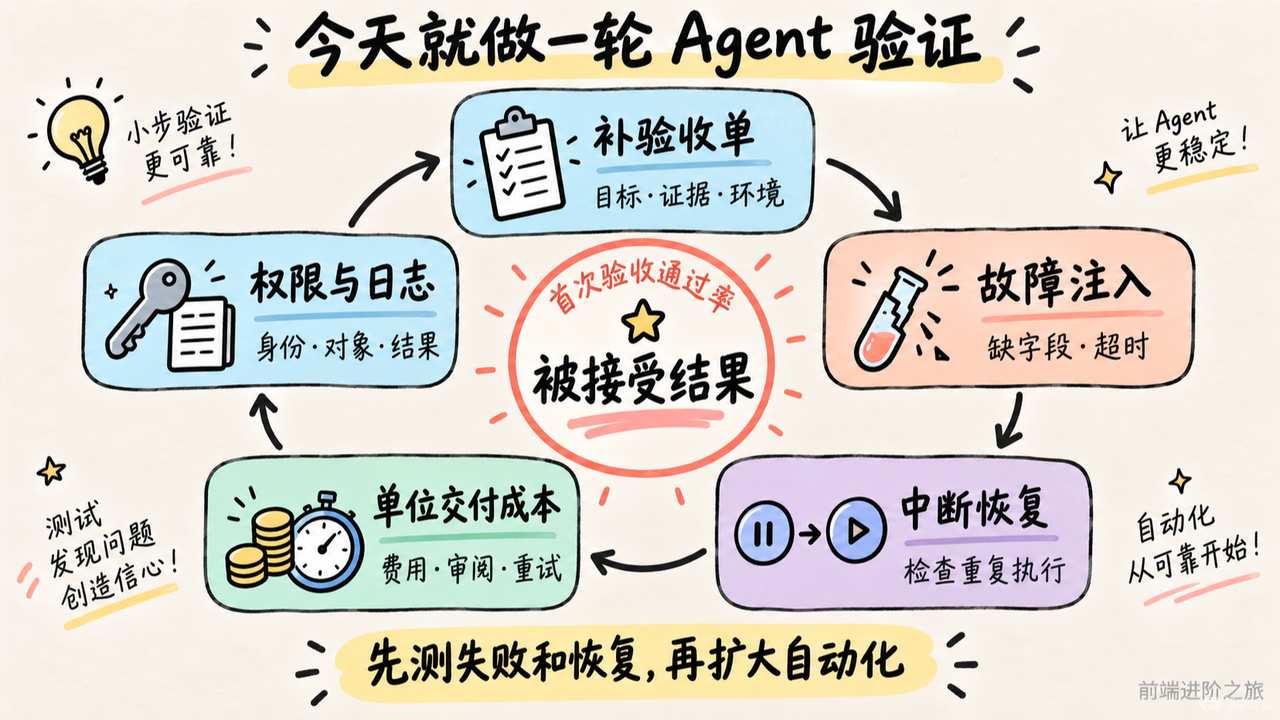
还没被验证的假设是,更强的模型配更完整的运行框架,能不能持续压低单位交付成本。要验证它,得同时记录模型费用、人工介入、失败恢复和最终验收。这四项一起往下走,才有底气扩大自动化范围。
说到底,今天这批消息真正在问的是同一件事,你那套工作流到底是省下了时间,还是把时间挪到了审查和返工上。
参考
以下是本文实际引用的原始实践文章与媒体报道。项目效果多为作者自述,模型和研究结果涉及媒体转述,文中保留了相应归因与限制。
- Loomwright:Plan-First 编程工作流|dev.to
- KIRA:以工具结果证明任务完成|dev.to
- 多 AI 协作的交接与验收设计|dev.to
- Claude Code Hooks、Skills 与 Subagents|dev.to
- AI 辅助项目的四类安全问题|dev.to
- MCP 输出契约故障注入测试|dev.to
- Pizza Bot 后台 Agent 收件箱|MarkTechPost
- 长程任务的上下文工程|MarkTechPost
- Agent 的窗口、摘要与持久化记忆|dev.to
- 两年课堂 AI 使用研究|The Decoder
- Cognition SWE-2 发布与测试结果|MarkTechPost
- Iris 搜索 Agent 与上下文管理评估|The Decoder
- GPT-6 Astra 经营与无人机基准测试|The Decoder
- RubyGems 包投送事件与凭证边界分析|dev.to
- enterprise-claude-kit 治理层介绍|dev.to
- Codex 安全审查与长任务机制实践转述|dev.to
- 前端进阶之旅