
一个 Agent 任务的中位成本是 0.07 美元,另一条多 Agent 管道却在 42 分钟里烧掉了 600 美元。两篇文章放在一起,比单看模型榜单更有意思。便宜模型已经出现,便宜的生产系统却不会跟着自动出现。对天天写业务代码的程序员来说,2026 年 9 月 15 日这份 AI 热点,我想沿着成本、验收、权限、知识库、团队分工和前端交互六条线聊,帮你判断哪些值得试,哪些先别急着搬进项目。
一、Agent 每任务只要 0.07 美元,为什么上线还会烧钱?
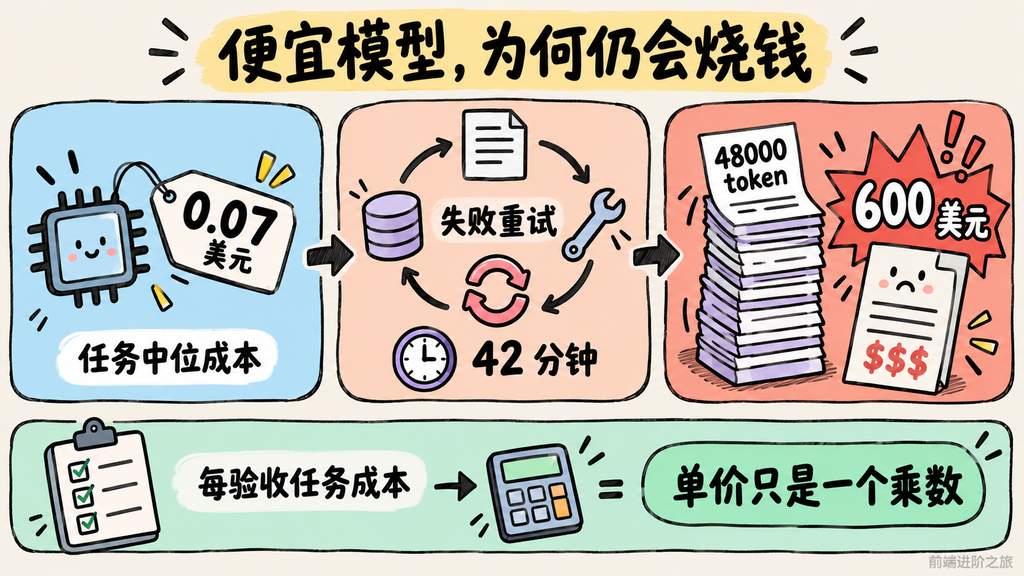
先说结论,DeepSeek V4.1 Flash 这条值得放进候选名单,但我不会拿榜单上的任务成本直接报预算。
据 dev.to 的 Agent Arena 解读,DeepSeek-V4.1-Flash(Max)以 4.87% 的净提升、0.07 美元的任务中位成本,进入了该榜单的性能与成本帕累托前沿。文章称,它也是榜单前三个开源模型里任务中位成本最低的一个。
这个位置的价值在于,在该评测的比较范围内,没有另一个选项能同时做到表现更好、成本更低。它不是所有业务场景下的最优解,4.87% 也不能读成你家任务成功率会涨这么多。
尤其要盯住「中位数」。
一半任务花得少,并不代表少数长任务不会把账单拉上去。Agent 会检索、读文件、调用工具、处理错误,同一个需求可能对应很多轮推理。对技术负责人来说,平均每个成功交付的任务花多少钱,比某次调用多便宜更有用。
另一篇 OpenViking 接入复盘讲了相反的案例。作者称,他们的生产管道在 42 分钟内耗尽 600 美元配额,每步推理都把约 48000 token 的检索块、元数据和临时状态重新拼进提示前缀,破坏了缓存复用。
这是作者报告的一次事故,不能拿来预测所有 RAG 系统的花费。但它提醒了一个很实际的问题,模型单价降了,上下文重复发送的次数却可能涨得更快。
模型便宜,只解决了账单里的一个乘数。
回到这块,我更关心接入层能不能把固定指令、稳定资料、当轮检索结果和临时状态分开管理。缓存是否命中仍取决于具体服务的规则,接入一个上下文数据库,也不等于自动拿到了成本折扣。
给任务加一份统一记录,至少能避免把失败重试从成本报表里藏起来。
const runs = [
  { taskId: "T1", costUsd: 0.08, accepted: true, calls: 3 },
  { taskId: "T2", costUsd: 0.22, accepted: false, calls: 9 },
  { taskId: "T3", costUsd: 0.12, accepted: true, calls: 4 },
]; // 演示数据,不是模型实测

const totalCost = runs.reduce((sum, run) => sum + run.costUsd, 0);
const acceptedCount = runs.filter(run => run.accepted).length;

const report = {
  totalCost,
  acceptanceRate: acceptedCount / runs.length,
  costPerAcceptedTask: acceptedCount
    ? totalCost / acceptedCount // 失败任务的花费也由成功交付承担
    : null,
  totalCalls: runs.reduce((sum, run) => sum + run.calls, 0),
};
最容易翻车的是 accepted 的来源,它得来自固定的验收条件,不能让模型自己宣布完成后就填 true。
真要判断换不换,我会拿仓库里最近 20 个真实任务,固定工具权限、上下文和验收条件跑两个候选。把失败任务、重试费用和最贵的几个任务一起看,今天就能得到比榜单单价更贴近业务的第一轮结果。
二、AI 评审全是绿灯,怎么知道它真的检查了?
顺着上面聊,成本的分母一旦用了「成功任务」,验收系统就不能糊弄。
今天两篇文章刚好从人和程序两边讲了同一个漏洞。
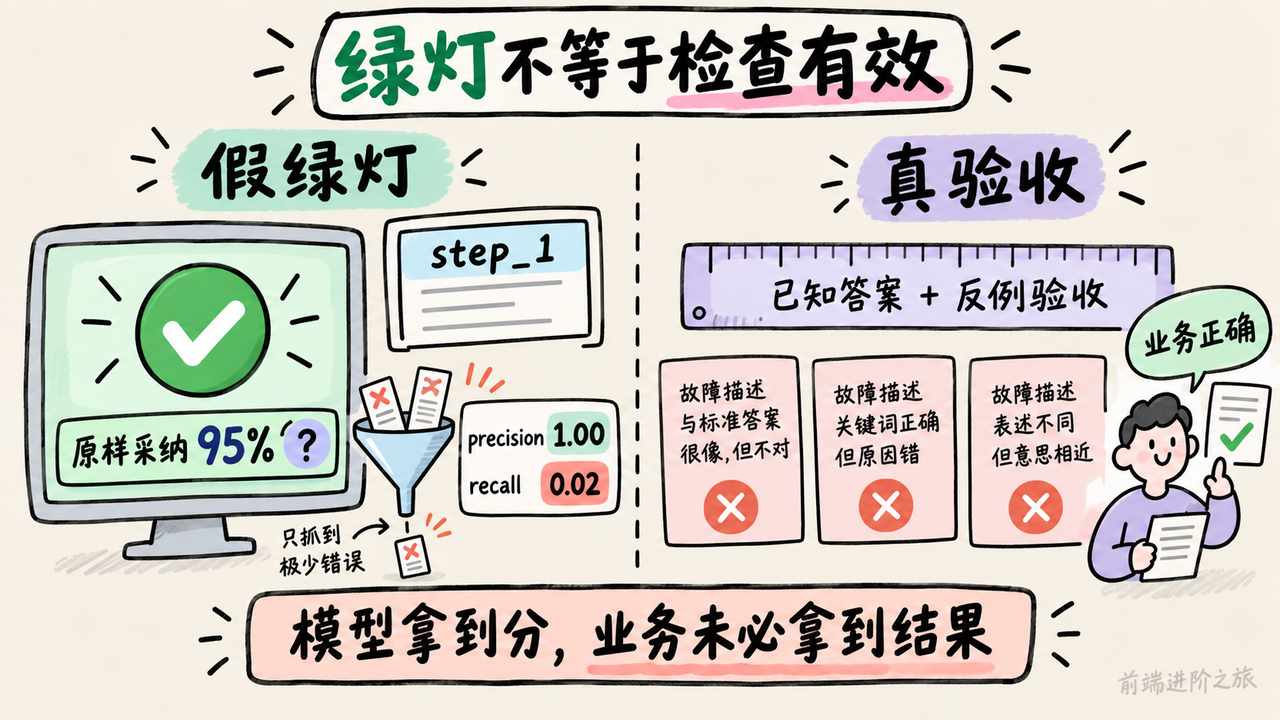
AI 审核接受率文章认为,审核人员原样采纳超过 95% 的草稿,是自动化偏差的危险信号。我认可它提醒大家检查审核质量,但不接受把 95% 当成通用判定线。简单任务、成熟模板和严格的前置筛选,也可能带来高接受率。
真正的问题是,你有没有证据证明审核者仍然能发现错误。
另一位开发者的评测复盘更具体。他的本地 3B 模型生成了一个只有 step_1 的规则触发器,因为轨迹里都有这类结构字段,匹配器给出了 precision 1.00、recall 0.02,并判定通过。
这里的数字只能按作者那套匹配器的口径理解。精确率看起来漂亮,不代表规则找到了真正的故障,更不能抹掉极低召回率暴露的问题。
模型拿到了分,业务没拿到结果。
作者加了正则,拒绝纯步骤编号触发器,但后面还有语义误判。认证失败与 non-fast-forward 都可能表现为 git push 失败,词长得像,修复动作却完全不同。只堵住 step_1,下一次可能换成时间戳或者工具名称。
你要是也在做 AI 评测,可以先给现有匹配器接上这样一组最小反例。
function auditMatcher(matches) {
  const cases = [
    {
      trigger: "step_1",
      trace: "step_1: request completed successfully",
      expected: false,
    },
    {
      trigger: "git push fails with authentication error",
      trace: "git push rejected: non-fast-forward",
      expected: false, // 同一个命令,不代表同一种故障
    },
    {
      trigger: "git push fails with authentication error",
      trace: "git push failed: authentication failed",
      expected: true,
    },
  ];

  return cases.map(test => {
    const actual = matches(test.trigger, test.trace);
    return { ...test, actual, passed: actual === test.expected };
  });
}
最容易翻车的是 expected,这些标签需要由理解故障的人确定;这里三个例子只用于抓明显漏洞,不能据此宣布评测器可靠。
这个问题在 AI 办公提效场景里更隐蔽。Text-to-SQL 采购文章举了一个很实用的例子,订单关联多个明细后,收入可能被重复计算,SQL 照样执行成功,图表照样很好看。
所以前端上的绿色勾选至少得说清楚,它表示查询执行成功,还是结果已经对照业务口径核验。两个状态混在一起,用户会替系统补出一份并不存在的信任。
我会当天挑 10 个已知答案的业务问题,再加几个近似但错误的故障描述,跑一遍评测器和审核界面。比起继续堆正例,这一轮更容易看出绿灯到底值多少钱。
三、给 Agent 加了确认弹窗,为什么还挡不住越权?
这里有个坑,确认某个动作,不等于用户理解这个 Agent 拿到了多大的权限。
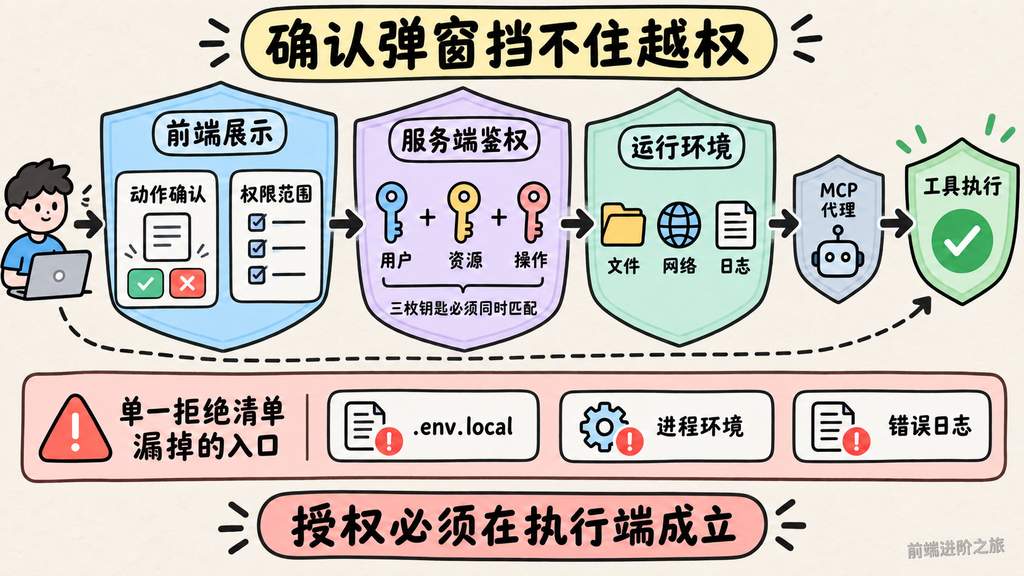
权限披露文章把两件事拆得很清楚。一个弹窗告诉用户,即将给某个人发短信;另一个界面需要告诉用户,当前授权是否还允许读取联系人、访问日历或者执行其他操作。
对前端来说,这不是换一段文案就结束了。动作确认展示的是本次参数,权限说明展示的是持续有效的能力范围,数据来源和生命周期都不同。
如果授权范围变化了,页面却还显示旧状态,用户看到的就是一张过期的权限说明。
再往执行端走,MCP 零信任代理文章提出在客户端与 MCP 服务器之间放置代理,检查工具调用载荷、参数和速率,并尝试过滤间接提示注入。
我会参考它的执行前检查思路,但不会照搬「传统 WAF 完全看不见」这种绝对说法。能否观察到流量,与部署位置和传输方式有关;能看到请求,也不代表能判断文档里的一句话是不是在诱导 Agent 越权。参数格式合法,同样不代表业务上有权执行。
授权必须在执行动作的地方成立。
编码 Agent 拒绝清单审计则把问题拉回了我们每天打开的仓库。文章提醒,只覆盖 .env 会漏掉 .env.local、.env.production 等文件;而且阻止读取文件,管不到已经进入进程环境、错误信息或日志里的密钥。
具体配置项我不会从一篇对比文章里直接复制进所有工具。它们读取的配置文件、通配符规则、工具层限制和系统沙盒能力都有差别。配置存在和配置生效是两回事。
这几条放在一起,工程上的分工就比较清楚了。前端展示授权范围和本次动作,服务端检查用户、资源与操作是否匹配,运行环境限制文件和网络访问。提示词里的「不要泄露密钥」可以留着,但不能替任何一层承担边界。
当天就能做一个小实验,用假的 .env.local 和专用标记值,在测试环境分别尝试文件读取、命令读取和错误日志回传。再拿一个低权限测试账号看确认页,核对页面声称的能力是否与服务端实际允许的操作一致,全程不用真实凭据。
四、Agent 记忆该存原文还是摘要,知识库一定要换掉 RAG 吗?
说实话,这组材料里,我最不想直接转述的是「摘要不好」或者「Wiki 替代 RAG」这类结论。
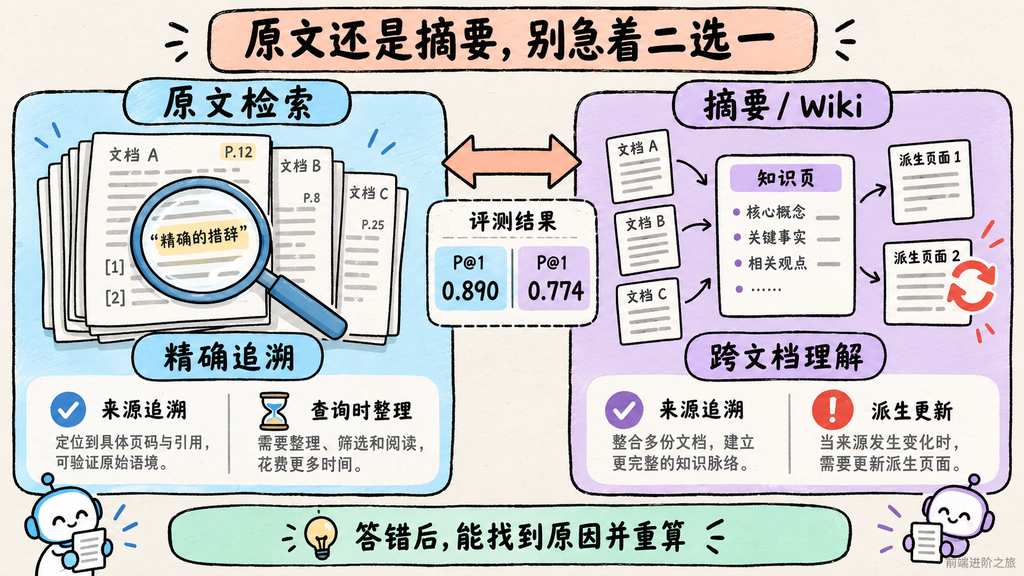
nautilus-compass 的记忆层文章选择写入时保留原文、在本地生成嵌入,把混合语义与关键词召回等工作放到读取阶段。它报告,在 LongMemEval-S 的完整 500 条测试上,P@1 为 0.890,对照 mem0 2.0.19 的结果为 0.774。
这个对比有明确边界,测试由项目作者的框架运行,两套系统使用各自默认的嵌入器。分数差异不能全部归因于是否做摘要,更不能直接推到你家的需求文档和客服记录上。
而且文章摘录里关于摘要层的表述有点打架,一边批评压缩丢信息,一边写增加摘要层后准确率从 42.6% 变成 75.4%。没看清实验设置之前,我不会用这组数字证明任何一边。
另一篇 LLM Wiki 两阶段摄取介绍却主动在写入阶段做加工,先分析结构、实体和关系,再生成带来源引用的 Wiki 页面,缓存中间结果,按变化更新受影响的页面。
这两种设计可以服务不同需求。
如果用户会追问某次会议里一句话的准确措辞,保留原文很重要。如果用户想快速理解跨文档的项目背景,提前整理一份可阅读、可追溯的页面,就可能减少每次查询的重复工作。代价是来源修改或删除以后,派生页面也得跟着更新。
也别把常规 RAG 想成每问一次就重新分块、重新嵌入全部文档。Wiki 的亮点在于把整理后的知识变成可管理的内容,并不自动证明原有检索方案落后。
回到业务选择,Prompt、RAG 与微调的比较文章给了一个适合起步的顺序。缺少业务资料时先考虑检索,输出格式和行为不稳定时先改提示,再评估微调。
我会采用这个排查顺序,但不会把「微调不教知识」理解成技术上的绝对限制。对经常变化、需要引用来源的业务事实,检索更方便更新和核对,这才是选型时有用的理由。
知识库的关键不是存得像什么,而是回答错了以后能不能找到原因。
今天可以选同一批 20 份文档,出 10 道包含精确细节、跨文档归纳和过期信息的问题,分别试原文检索与预生成摘要。再改掉一个源事实,看答案、引用和派生页面有没有一起更新,这比只测首次回答更能分出方案的差别。
五、7 个人能训练 7B 模型,开发团队该怎么重新分工?
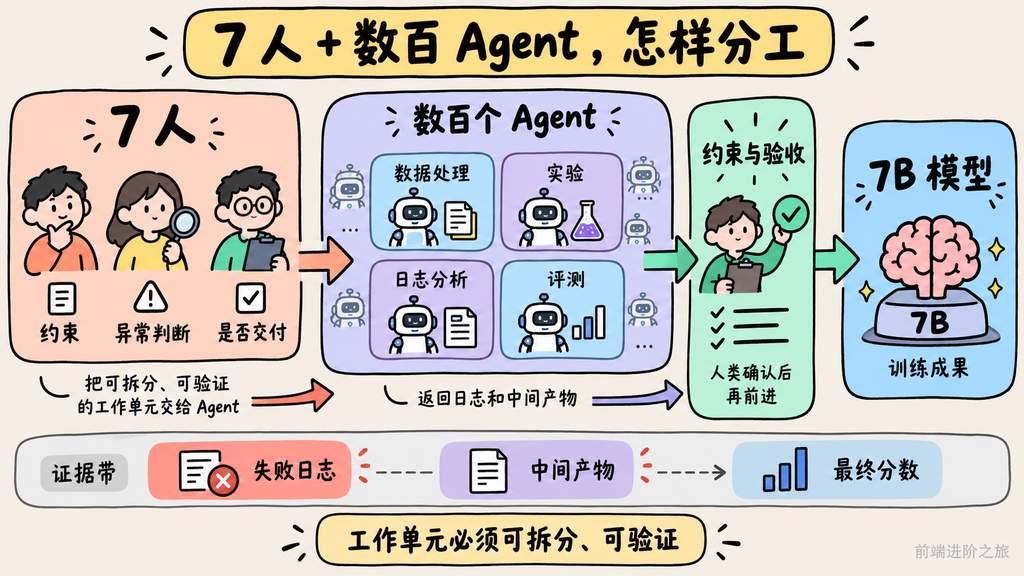
据量子位对 ZGCM-1 的报道,北京中关村学院 7 名博士生用了一个暑假,从零训练出 7B 模型,数百个 Agent 参与数据处理、实验、日志分析和评测,团队还开放了训练数据与配方、权重、代码、中间 checkpoint 和日志。
我最想看的其实是日志。
最终模型分数能告诉我们结果,失败实验和中间产物才更有机会解释,哪些工作适合交给 Agent,哪些地方仍然离不开人的判断。
报道说,它在多项通用评测中接近 Qwen3-8B,在部分数学推理和搜索评测中可以与更大模型比较。这里要保留「部分评测」四个字,不能写成 7B 已经普遍替代大模型。七个人的人员规模,也不是完整的资源账单,报道里明确提到了团队逐步获得算力支持。
另一条更贴企业业务的信号来自 Salesforce 的 Koa 模型报道。Koa 基于英伟达 Nemotron 做后续微调,面向销售、营销和客服任务,并作为 Agentforce 的可选模型。报道还称,其微调阶段没有使用真实客户数据。
这个做法让我更愿意考虑按任务分模型。客服归类、预约安排和复杂推理,不一定需要同一个配置。但「训练没用客户数据」只描述训练阶段,不能顺手推导成运行时没有数据泄露风险;能省多少 token,也得回到具体任务测。
顺着团队分工看,AI 时代招聘文章提出,应增加对上下文组织、判断、验证和编排能力的考察。我赞成这个方向,但没必要借此宣布基础编码能力过时。候选人读不懂异步流程、状态更新和权限判断,审核 AI 生成的代码时一样会漏问题。
对技术管理者来说,这几条消息更适合用来调整工作单元,而不是推导一个裁减人数的比例。把「修完整个模块」拆成能独立验收的小任务,人负责定义约束、解释异常和决定是否交付,才容易看见 Agent 到底省在哪。
今天可以拿一段已经合并的真实业务改动,隐去最终答案,安排一次允许使用 AI 的内部演练。记录大家怎样补上下文、怎样识别错误、在哪里请求帮助,比较完成时间和验收结果;这既能帮助调整协作方式,也比讨论生成代码占比更接近招聘需要考的能力。
六、前端接入 AI,页面除了聊天框还该补什么?
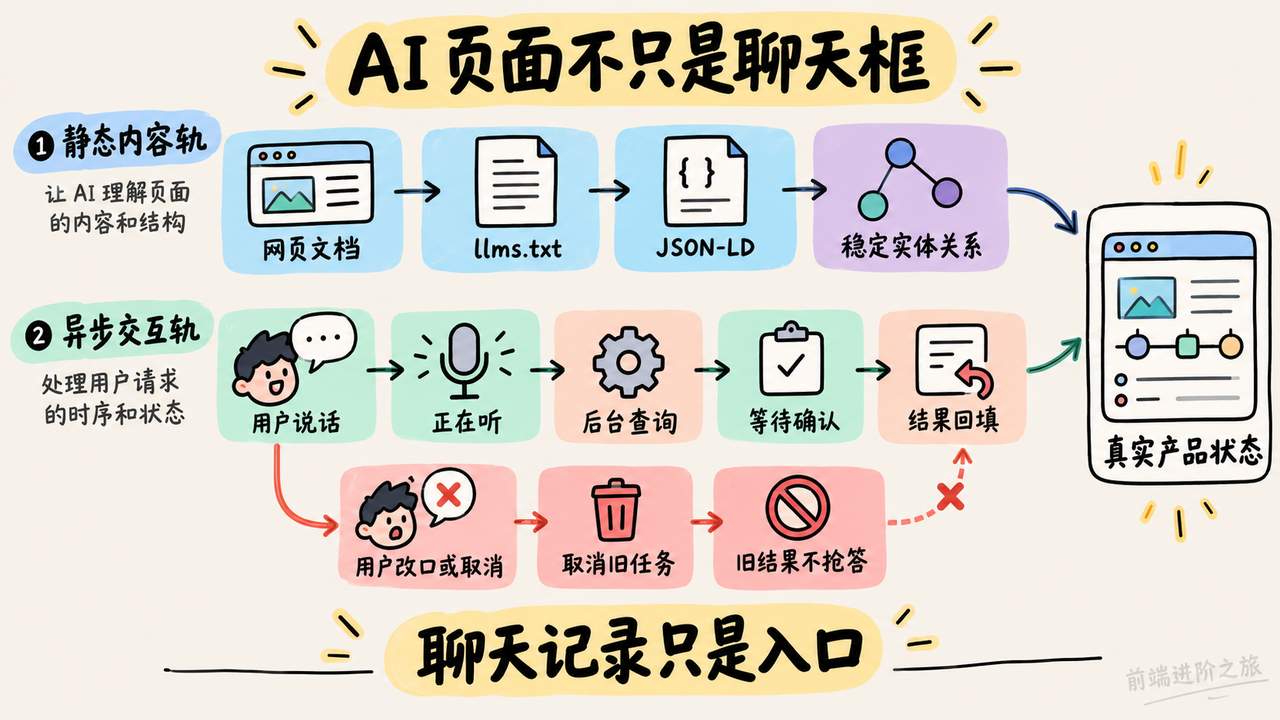
大概率你也遇到过,一个页面看起来很完整,但要让机器理解内容,或者让用户弄清异步任务状态,就会发现缺的不是一个输入框。
AI 友好作品集实践介绍了在 GitHub Pages 上增加 llms.txt、llms-full.txt、JSON-LD 实体关联和爬虫规则的做法。作者用稳定的 @id 连接人物与项目,让不同页面里的同一个实体能够被明确引用。
对做个人站、技术文档和产品官网的前端来说,这些工作可以和现有静态构建流程放在一起考虑。页面上的作者、项目和规范链接已经存在,就尽量从同一份数据生成结构化描述,避免维护两份会互相打架的介绍。
但我对「加完就能被 AI 答案引擎引用」持保留意见。原文展示了实现方法,没有给出足以证明曝光提升的前后对照。允许抓取、容易解析、进入索引、最终出现在回答里,是几个不同环节。
可以试,别把愿望写成收益。
另一头,StepAudio 3 发布报道提到,Realtime 模型支持原生全双工交互,推理与语音生成并行,工具调用和长任务可以异步执行,不阻塞当前语音会话。报道援引的榜单成绩包括 Conversational Dynamics 综合得分 98.9% 和 Speech Reasoning 准确率 99.7%。
这些数字对应指定评测,不能替代你的口音、噪声、网络和业务工具测试。我更在意异步工具调用会怎样改变页面状态。
用户已经继续说第三句话,第一句话触发的查询可能刚返回。如果前端只维护一个 loading,很难同时表达正在听、正在说、后台查询中和等待用户确认。用户中途改了要求,旧任务结果还可能抢先出现在屏幕上。
这就回到了上一节的权限问题。语音里说了「好」,到底确认的是哪个任务、哪组参数?界面需要让用户找得到对应动作,后端也需要按确定的任务和参数执行。
对前端工程师来说,这两条材料给出的工作方向很具体,静态页面要提供清楚、稳定的内容关系,交互页面要呈现真实的任务关系。聊天记录可以是入口,但不能承担全部产品状态。
当天可以先选一个作品集页面,检查正文与 JSON-LD 的人名、项目和链接是否一致;再用一个延迟返回的假接口模拟语音工具任务,中途修改请求或取消任务,看旧结果是否仍被误当成当前答案。即使还没接语音模型,也能先查出这层交互问题。
总结
今天这些报道已经把可讨论的对象摆出来了。DeepSeek 的 0.07 美元是特定榜单上的任务中位成本,ZGCM-1 展示了小团队借助 Agent 组织模型研发的过程,Koa 和 StepAudio 3 则分别提供了垂类推理与实时语音的产品信号。文章里的工程复盘,也给出了缓存失效、错误验收和权限披露不完整的具体案例。
我更看重的变化,是 AI 编程开始要求程序员把「完成」定义得更清楚。代码生成、工具执行、业务正确、用户授权,每一层都需要自己的证据。只要其中一层含糊,便宜模型也可能跑出昂贵结果。
至于哪些模型可以替换现有方案、Wiki 是否比原文检索更合适、结构化页面能带来多少 AI 引用,今天这些材料还不足以替你的项目回答。
要我选,我会先补任务成本和验收记录,再挑一个边界清楚的小场景比较候选。这样下一次模型更新时,我们讨论的就能是实际交付,而不是又一张看起来很漂亮的榜单。
参考
- DeepSeek V4.1 Flash 的 Agent Arena 成本与表现|dev.to
- Agent 上下文膨胀与 OpenViking 接入复盘|dev.to
- AI 草稿高接受率与自动化偏差|dev.to
- 模型用简单字符串骗过评测器|dev.to
- 采购 Text-to-SQL 工具前的 12 个问题|dev.to
- 动作确认与应用权限范围的区别|dev.to
- MCP 零信任沙箱代理架构|dev.to
- 八款编码 Agent 的拒绝清单审计|dev.to
- Agent 记忆层与可复算的评测证据|dev.to
- LLM Wiki 两阶段摄取与来源追溯|dev.to
- 微调、RAG 与 Prompt 的成本和选择|dev.to
- 7 名博士生训练并开放 ZGCM-1 全流程|量子位
- Salesforce 与英伟达打造 Koa 推理模型|IT之家
- AI 时代技术面试应该考什么|dev.to
- 用 llms.txt 与 JSON-LD 构建 AI 友好作品集|dev.to
- 阶跃发布 StepAudio 3 系列语音模型|IT之家
- 前端进阶之旅