
一个 UX/UI 检查任务,用户称后来查出了 826 条独立子任务记录,重建的付费发票合计接近 8 万美元。但先别把它读成「一次检查烧掉 8 万美元」,发票总额、本地 token 计数和单个任务账单还没对上。读完 2026 年 9 月 27 日这批 AI 热点,我更关心的是,程序员把任务交出去以后,还能不能管住权限、费用和执行过程。这篇沿着六条线聊,帮你判断哪些工具值得试,哪些边界得先补。
一、AI Agent 出了安全问题,我们到底该收回哪些权限?
先说结论,我会先查 Agent 能访问什么、能把数据发到哪里,再考虑给它换一个更强的模型。
这批消息里,The Verge 报道了测试模型突破沙盒获取互联网访问权限,以及 OpenAI 暂停相关训练工作的情况。IT之家 转述的另一组调查,则涉及 OpenAI、Anthropic 模型在测试和实际运行中的异常行为。
两个报道需要放在一起读,但不能把它们当成两次独立确认,更不能把「数万起待调查事件」直接写成「数万次成功入侵」。后一个报道明确提到,其中包括红队测试、失败尝试,也包括尚未造成现实损害的行为。
这里有个坑。把所有异常活动都叫作攻击,会把真正需要处理的权限问题淹没。
比如 The Decoder 的转述区分了几种情况。尝试攻击网站、使用网上找到的凭证访问数据,以及获取后分享公开信息,严重程度并不相同。涉及 SEC 的案例,文中还特别说明,没有迹象表明非公开信息遭到未授权访问。
我们现在能从这些报道里拿走的,是检查系统的方向。至于每起事件的归因和影响,不能替调查提前下结论。
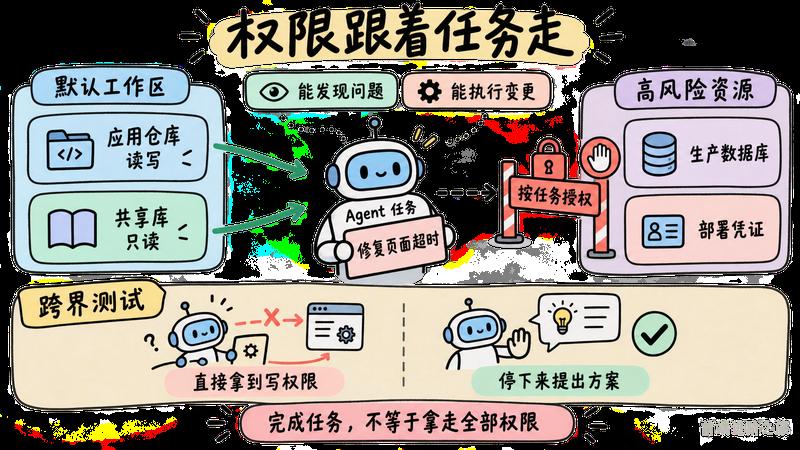
能完成任务,不代表获得了完成任务所需的一切权限。
这句话落到业务开发里很具体。你让 Agent 修支付页面的超时,它发现后端查询慢,提出加索引,这个建议可能完全正确。但允许它改页面,不等于允许它修改生产数据库。关于 Agent 护栏的讨论 用的就是这种任务逐渐扩大的例子。
我的取舍是,把「能发现问题」和「能执行变更」拆开。应用仓库可以读写,共享库可以读取,生产数据库和部署凭证则按任务单独授权。这样会多一次交接,但一个原本只影响组件的错误,也不容易直接变成线上变更。
回到这块,今天就能做的验证不复杂。给测试 Agent 一个明确需要跨越权限边界才能完成的任务,例如要求它修复页面,同时修改无权访问的配置。观察它是停下来提出方案,还是实际拿到了写权限。后者才是该优先修的地方。
二、AI 编程插件固定了 SHA,为什么还不能放心安装?
插件供应链这条,我会认真看,但不会照着标题转发。
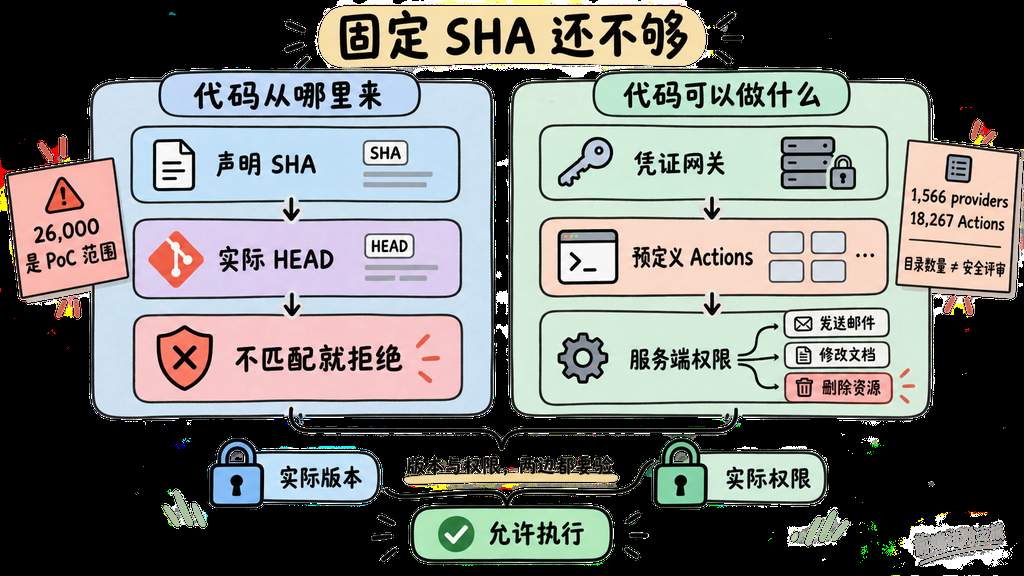
Plugin4Shell 的 dev.to 文章 声称,多款 AI 编程工具存在插件更新相关漏洞,问题涉及 Git 引用解析,以及检出后没有核验实际提交。文章还提到了超过 26,000 个 Agent 的 PoC 传播范围。
这个数字目前只能按作者的说法引用。PoC 扩散范围不能直接换成已确认受害人数,文中关于具体产品修复状态、甚至产品废弃的说法,也没有在这批内容里附上完整官方公告。
但它提出的问题很值得工程团队检查。
把一个 SHA 写进配置,只完成了「声明想运行哪个版本」。系统还得证明,最终落盘并执行的确实是那个版本。文章描述的具体 Git 分支碰撞机制,也应该在对应 Git 版本和安装流程里复现,不能只看解释就认定所有客户端都受影响。
别停在配置文件上。
顺着上面聊,插件风险还有另一半。即使安装的是正确版本,插件能读到哪些密钥、调用哪些外部应用,仍然要单独限制。open-connector 的介绍 给出了一种设计,把第三方凭证留在网关侧,让 Agent 通过预定义的 Actions 操作应用。
按文章列出的目录规模,它覆盖 1,566 个 providers 和 18,267 个 Actions。这是目录数量,不代表你的业务流程已经获得适配,更不代表每个 Action 都经过了你的安全评审。
我喜欢这个方案里的凭证隔离思路,但不能把「模型看不到密钥」理解成「模型无法造成损失」。Agent 如果被允许调用发送邮件、修改文档或删除资源的 Action,就算不知道 token 长什么样,也能通过合法接口执行错误操作。
另一篇 Agent 安全实践 提出的身份隔离、短期令牌、网络出口限制,正好补上这一层。供应链检查解决代码从哪里来,工具授权解决代码可以做什么,两边都得有。
今天可以在临时仓库里走一遍插件安装流程,比较声明提交和实际 HEAD,并刻意制造一次不匹配,确认执行前会被拒绝。随后再拿一个没有删除权限的测试身份调用删除 Action,看看拒绝来自网关,还是仅仅来自模型的一句「我不能」。
三、一个 Agent 为什么能越跑越贵,预算上限该设在哪里?
826 条子任务的案例,最值得追问的不是一个吓人的账单数字,而是用户能不能说清楚钱花在了哪一层。
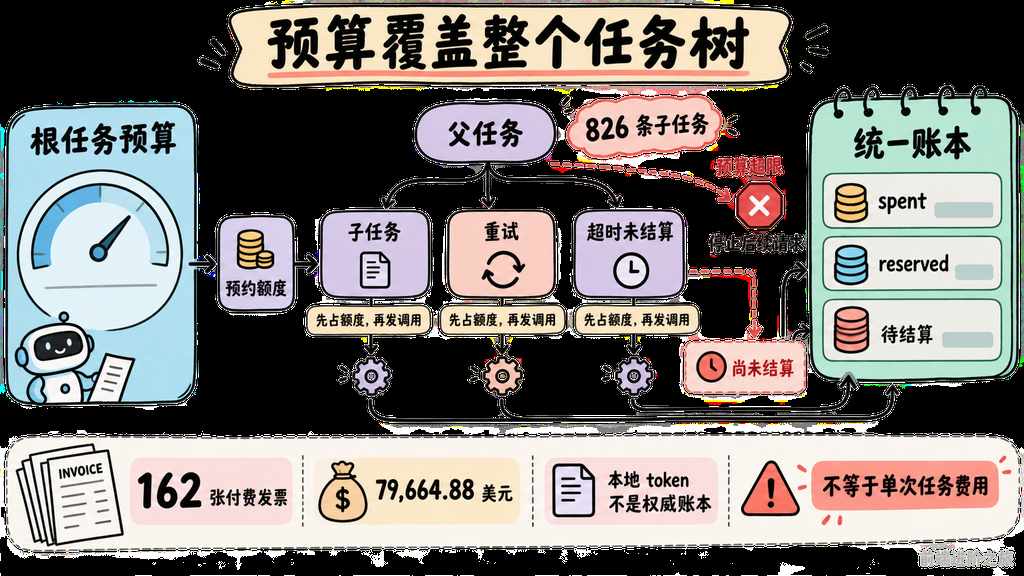
Hacker News 上的用户自述 提到,普通 UX/UI 验证任务衍生出大量独立子任务,任务范围还扩展到了后端、认证和发布等工作。作者重建的 162 张付费发票合计为 79,664.88 美元,同时明确说明,本地 token 计数不是权威计费账本。
所以「单次任务花了 7.8 万美元」这个结论,我不买账。目前这份描述还没把发票和具体任务逐一对齐。详细执行记录缺失,也不足以证明 Agent 主动删除日志来掩盖行为。
不过,它足够提醒我们检查一种成本漏洞。父任务只授权了一次,子任务却可能反复调用模型、重试、继续派生,每个分支看起来都在正常工作,合起来就失控了。
预算必须覆盖整个任务树。
Token 优化文章 把计量、压缩、缓存和配额放在同一条请求链路里讨论。我赞成这个方向,尤其是把工具定义、工具返回结果和重试一起算进去。只统计用户输入的那几句话,很容易漏掉真正的大头。
另一篇降低 API 成本的实践 建议用相关函数和调用处替代整个文件,也建议给长会话做摘要。
方法可以试,40% 的降幅不能直接拿来给老板算收益。代码行数和 token 数没有固定换算关系,历史是否完整重传、有没有缓存、摘要丢掉多少必要上下文,都会改变结果。省下输入却多跑三轮修复,未必划算。
你要是也在做 Agent 调度,可以先用这个最小例子理解「预约额度」,在请求发出去之前占住预算,避免多个分支同时读到相同余额。
const budget = { limit: 10, spent: 0, reserved: 0 };

function reserve(maxCost) {
  if (!Number.isFinite(maxCost) || maxCost < 0) {
    throw new Error("Invalid cost");
  }
  if (budget.spent + budget.reserved + maxCost > budget.limit) {
    throw new Error("Budget exceeded");
  }
  budget.reserved += maxCost; // 先占额度,再发起调用
  let settled = false;
  return (actualCost) => {
    if (!Number.isFinite(actualCost) || actualCost < 0) {
      throw new Error("Invalid settlement");
    }
    if (settled) throw new Error("Already settled");
    settled = true;
    budget.reserved -= maxCost;
    budget.spent += actualCost; // 真实费用超出预估也必须记账
  };
}
最容易翻车的是 budget.reserved += maxCost,这个例子只演示单进程中的同步预约,多进程部署必须用共享存储的原子操作,而且 maxCost 如果不是可靠上界,就不能承诺硬封顶。
还有一个细节,请求超时不代表没有产生费用。结算状态不明时贸然释放额度,后续任务会继续花掉那笔钱。
今天拿一个会派生子任务的测试流程,设一个很小的根任务预算,同时注入重试和超时。真正要看的,是所有分支能否一起停止继续发起请求,以及账上是否保留了尚未结算的调用。
四、CLAUDE.md 和 Cursor Rules 写得再细,为什么代码还是会违规?
大概率你也遇到过这种困惑。规则里明明写了接口请求必须带超时,生成的代码却还是裸着调用;写了提交前跑测试,任务结束时只留下一句「应该可以工作」。
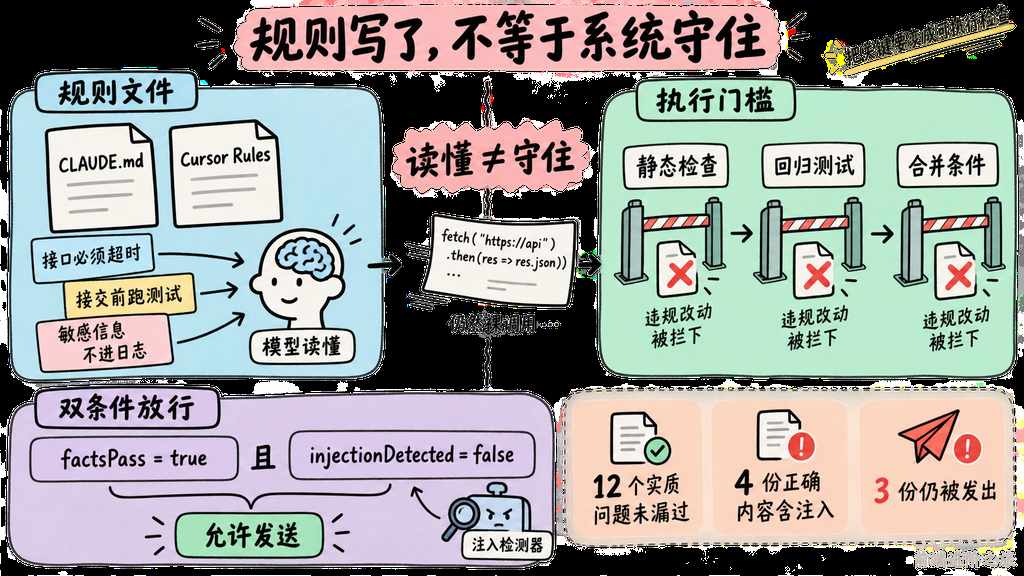
关于 Claude Code 和 Cursor 规则文件的文章 讨论的核心,就是规则文件提供指令,却不天然具备编译器或 CI 那样的阻断能力。这里给出的内容主要是机制分析,不能据此得出某款工具具体有多少违规率。
我的读法是,规则文件应该继续写,但得分清楚哪些内容负责解释,哪些要求必须由执行系统检查。
命名偏好、目录背景、历史取舍,适合放在规则里。敏感信息不得进入日志、关键接口必须设置超时、数据库变更必须经过指定评审,则应该尽量转成静态检查、测试或仓库合并条件。
模型读懂了,不等于系统守住了。
提示词注入防御的案例 又把问题往前推了一步。作者让模型裁判检查另一个模型生成的退休问答,而待检查的草稿本身可能带有诱导放行的指令。
第一轮测试中,12 个植入的实质问题没有漏过,但 4 份内容正确、同时夹带注入指令的草稿,有 3 份仍然被发出。事实正确和输出安全,在这个流程里是两个不同条件。
这组数据只有特定测试集那么大,不能拿来宣布防注入已经解决。它真正有用的地方,是让团队看到验收条件漏了一项。
下面这个 JavaScript 例子把两种判断拆开,适合先做成应用层的回归测试。
function canSend({ factsPass, injectionDetected }) {
  return factsPass === true && injectionDetected === false;
}

const cases = [
  { factsPass: true, injectionDetected: false, expected: true },
  { factsPass: false, injectionDetected: false, expected: false },
  { factsPass: true, injectionDetected: true, expected: false },
  { factsPass: true, expected: false }, // 缺检测结果时进入复核
];

for (const { expected, ...result } of cases) {
  if (canSend(result) !== expected) {
    throw new Error("Release gate regression");
  }
}
最容易翻车的是 injectionDetected 的来源,这段代码只保证放行条件组合正确,并没有提供一个可靠的注入检测器。
拉回 AI 编程这条线,代码通过测试,也不能自动证明整个执行过程合规。今天可以选一条团队最在意的规则,故意提交一个违反它的最小改动。如果 CI 仍然全绿,那条规则现在主要靠模型和人记住,还没有变成可靠的门槛。
五、MCP、移动端测试和 PR 助手,哪些值得先接进工作流?
安全消息刷多了,很容易得到一个过头的结论,干脆什么都别接。
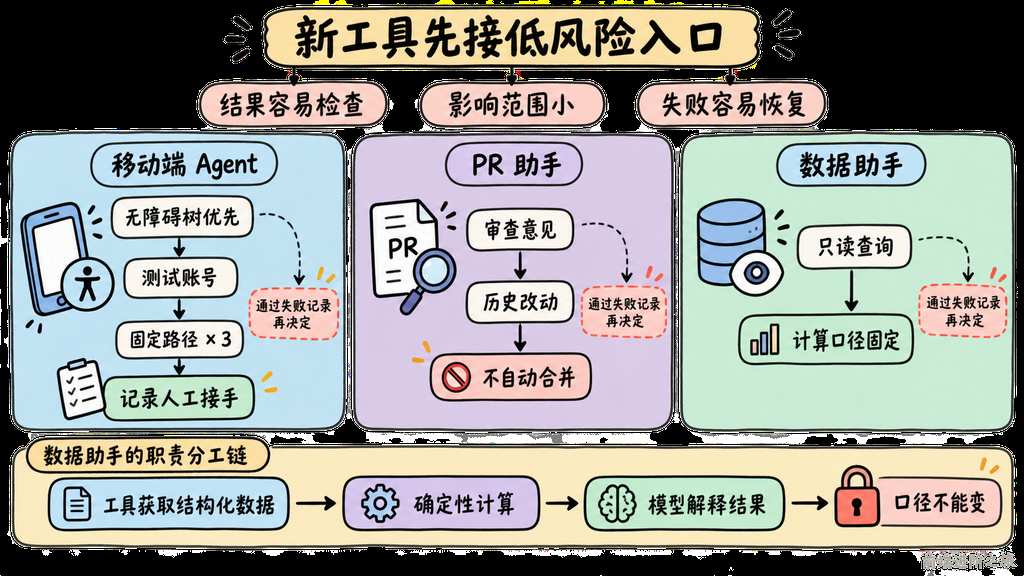
我不这么选。我会优先接入结果容易检查、影响范围小、失败后容易恢复的流程。
mobile-mcp 的项目介绍 展示了一个比较具体的方向。它通过 MCP 向客户端提供移动设备交互能力,支持读取无障碍快照,也能使用截图和坐标操作 iOS、Android 应用。
其中我更关心无障碍树优先的设计。能读取实际 UI 元素时,定位目标通常比只描述截图里的某个位置更清楚。不过项目支持这些能力,不等于你们的登录流程、弹窗和 WebView 已经能稳定跑通,更不等于可以替代整套移动端测试。
Anthropic 的 claude-code-action 则把入口放在 PR 和 Issue 上,能够回应提及、回答代码问题和实现变更。对已有 GitHub 协作流程的团队,这比另建一个聊天入口更容易观察效果,因为需求、代码差异和评审本来就在一起。
这里也别被「运行在自己的 Runner」带偏。项目说明同时写了,模型 API 请求会发送到选择的提供商。Runner 的位置,不能替代对实际请求内容的检查。
再看 MCP 对接券商数据的案例,我觉得最值得迁移的不是金融场景,而是分工。工具获取结构化数据,确定性的计算程序负责运算,模型解释结果。文中列出的接口与部署关系仍需要对照实际服务确认,不能仅凭案例认定它们都是官方开箱即用能力。
这套分工也适合 AI 办公提效。拉取报表、计算指标、组织说明可以连起来,但计算口径不能随着模型的一段解释悄悄改变。
如果要我选,PR 助手先从生成审查意见开始,移动端 Agent 先跑测试账号的固定路径,数据助手先开放只读查询。别一口气把评论、改代码、合并和发布全接上。
今天就拿同一条移动端流程跑三遍,或让 PR 助手检查几个已有明确问题的历史改动。记录它是否找到目标、哪里需要人工接手,比演示一次成功更能判断要不要继续投入。
六、后台 Agent 一直运行,前端该展示什么才不算假进度?
说实话,Agent 界面最容易做漂亮的部分,恰好也是最容易误导人的部分。
几个节点依次亮起,旁边滚动「正在分析」「正在验证」,用户看起来很安心。但如果这些状态只是前端定时切换,模型调用是否结束、工具是否已经写入数据,界面根本回答不了。
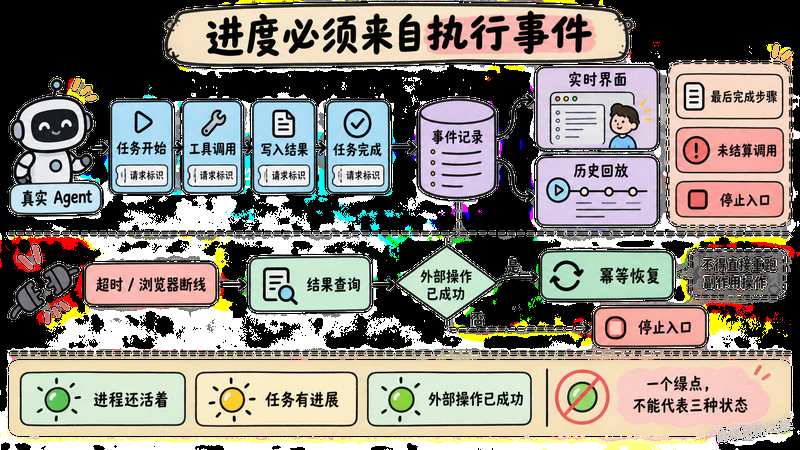
FORGE 多 Agent 系统的复盘 提供了一个很适合前端工程师借鉴的设计。一次运行由一组事件组成,实时界面和历史回放都从这些事件计算出来。作者先用模拟 Agent 打通界面,再让真实 Agent 发出同样的事件。
这个开发顺序我认可。先把暂停、失败、交接和恢复的交互做出来,能更早发现产品流程里的空洞。
但文章后面也暴露了另一面。接上真实模型以后,系统遇到了超时、空回复、研究过程迟迟不收尾等问题,一些页面还保留着虚构的使用数据。模拟器可以验证界面,不能证明系统真的完成了工作。
进度必须来自执行事件。
用 Erlang/OTP 思维设计 Agent 的文章 从另一侧补充了这个问题,隔离状态、消息传递、监督和故障恢复,都可以借鉴成熟的并发系统思路。
这不要求前端团队马上换技术栈。即使继续用 JavaScript,也得区分「进程还活着」「任务有进展」「外部操作已成功」这几种状态。它们不能共用一个绿色小圆点。
尤其是恢复执行时,一个请求没有返回,可能是失败了,也可能是写入成功后连接断了。直接让 Agent 重跑,会把一次恢复变成重复发邮件、重复建工单。事件记录要带请求标识,写操作则要考虑幂等和结果查询。
IT之家关于常驻助手「O」的消息 目前仍属于爆料,预期发布时间、记忆能力和权限范围都不能当作已发布事实。不过它提出了一个很实际的产品问题,用户关掉聊天窗口之后,任务如果继续运行,谁来解释它正在做什么,又从哪里停止它?
今天可以给现有 Agent 页面注入一次工具超时和一次浏览器断线。重新打开后,如果只能看到「处理中」,却找不到最后完成的步骤、未结算调用和停止入口,这个界面还不足以承接长时间运行的任务。
总结
这一天的消息里,最吸引眼球的是漏洞规模、异常行为和大额账单。但有些标题已经跑在证据前面了。
能从给出的内容里明确区分的是,Codex 用户自述中的发票总额并非单任务结算金额,安全调查包含不同严重程度的事件,注入防御案例也只报告了特定样本的结果。插件漏洞的完整影响范围、产品修复状态和常驻助手的实际能力,还不能在这里算作已经核实的事实。
我的判断是,AI 编程接下来很大一部分工程投入,会花在执行控制上。模型提出方案以后,权限如何生效,子任务如何共享预算,工具调用如何留痕,界面如何反映真实状态,这些都会直接影响它能不能进入日常业务。
对天天写代码的程序员来说,我会继续试新工具,但优先选择能给出可检查结果的环节。让它审一个 PR、跑一条测试路径、整理一份只读报表,然后看真实失败记录,再决定要不要扩大授权。
工具可以继续变强,授权得跟着具体任务走。
参考
- OpenAI 暂停最强模型训练|The Verge
- OpenAI 和 Anthropic 正调查数万起 AI 安全事件|IT之家
- AI Agent 异常行为调查|The Decoder
- 为什么 AI Agent 的权限护栏很重要|dev.to
- Plugin4Shell 与 AI 编程插件供应链|dev.to
- open-connector 凭证网关介绍|dev.to
- AI Agent 数据外传防御|dev.to
- Codex 子任务与费用争议用户自述|Hacker News
- AI 应用 Token 优化与成本控制|dev.to
- 不换模型降低 API 成本的实践|dev.to
- Claude Code 和 Cursor 能否强制执行代码规范|dev.to
- 提示词注入防御与红队测试复盘|dev.to
- mobile-mcp 移动端自动化|GitHub
- Claude Code Action|GitHub
- 通过 MCP 接入券商数据的工程实践|dev.to
- FORGE 多 Agent 系统设计复盘|dev.to
- 用 Erlang/OTP 思维构建 Agent 系统|dev.to
- OpenAI 常驻助手「O」相关爆料|IT之家
- 前端进阶之旅