
快 100 倍、便宜 200 倍,Jev 这组数字很容易让人想换模型。但它只做分类、路由和打分,不负责把整件事做完。另一边,AI 写出的限流器可能通过公开测试,却让两个租户共用额度。放在一起看,省下调用费和交付可靠功能,中间还隔着不少工程活。这份 2026 年 9 月 16 日的 AI 热点日报,我想沿着六条线聊聊模型分工、AI 编程、上下文、Agent 协作、语音交互和验收,帮你判断哪些值得试,哪些先别急着接进生产。
一、AI 调用成本怎么降,分类任务值得单独换模型吗?
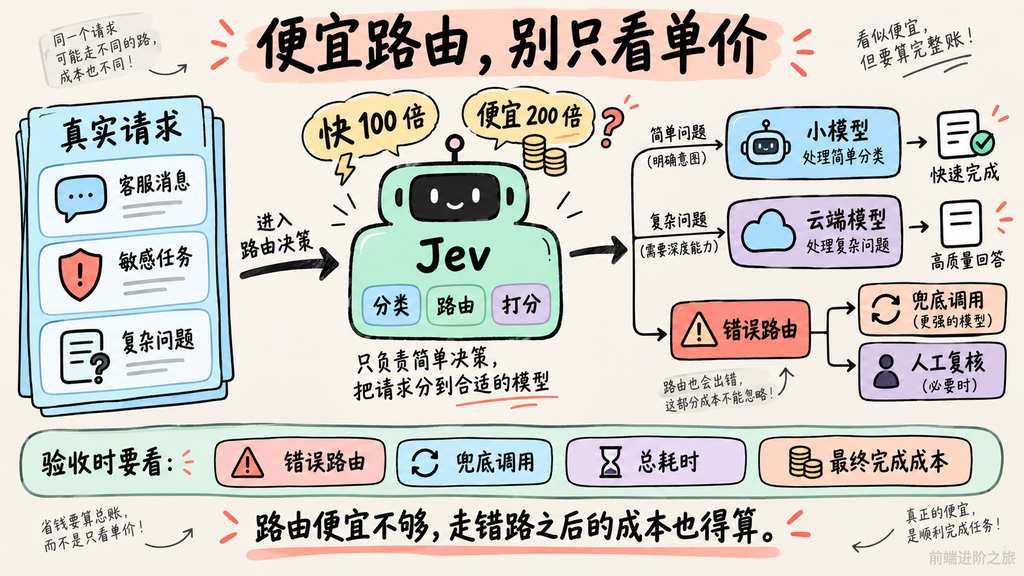
先说结论,我更看好把简单决策拆出去,而不是把所有请求一起迁到一个便宜模型。
Latent Space 对 Jev 的介绍把它称为「System One Model」,范围收得很窄,专门处理决策、分类、路由和打分。报道给出的说法是,相比小型前沿模型,速度和成本分别有超过 100 倍、200 倍的优势。
这个数我先打个问号。现有摘录没交代具体对手、输入长度、并发条件和准确率门槛,不能拿来估算整套应用的账单,更不能理解成复杂任务也能获得同样提升。
不过,任务拆分的方向很实在。
比如一个客服助手,收到消息后要判断是查订单、问退货还是投诉。这个入口未必需要完整的长文本生成能力。假如分类结果足够稳定,就可以把预算留给后面的查询和回答。但如果它把投诉错分成普通咨询,后续再强的模型也可能沿着错误流程继续执行。
路由便宜不够,走错路之后的成本也得算。
DinoDesk 桌面机器人项目提供了另一种分工方式。它让树莓派通过统一接口访问主 PC 上的网关,本地 Gemma 4 与云端 Gemini 引擎由网关切换。这里别看岔了,本地模型运行在 PC 网关上,不是已经证明树莓派能独立承担同样的推理负载。
项目强调本地聊天不消耗云端调用额度,这很好理解,但硬件、电力和维护不会一起归零。没有摄像头,也只能说明少了一条视觉采集路径,不能顺手推导成所有数据都不会离开本地。
回到这块,前端和全栈项目真正能借走的是统一入口与明确分工。简单分类用专门的能力,敏感任务控制数据去向,复杂问题再决定是否调用云端。
生产模型选型文章也提醒,便宜的 token 遇到多次重试和人工复核,就不一定便宜了。该文依据的是 9 月 3 日的目录快照,不是认证基准,模型目录里写着可用,也不等于你的账号已经拿到权限。
真要判断值不值得拆,我会拿 50 条真实请求,保留人工确认的分类结果,让两个候选跑同一份输入。把错误路由、兜底调用、总耗时和最终完成成本一起记下来,这比只盯单次调用价格更接近业务账单。
二、Claude Code 和 Cursor 怎么选,测试通过就能合并吗?
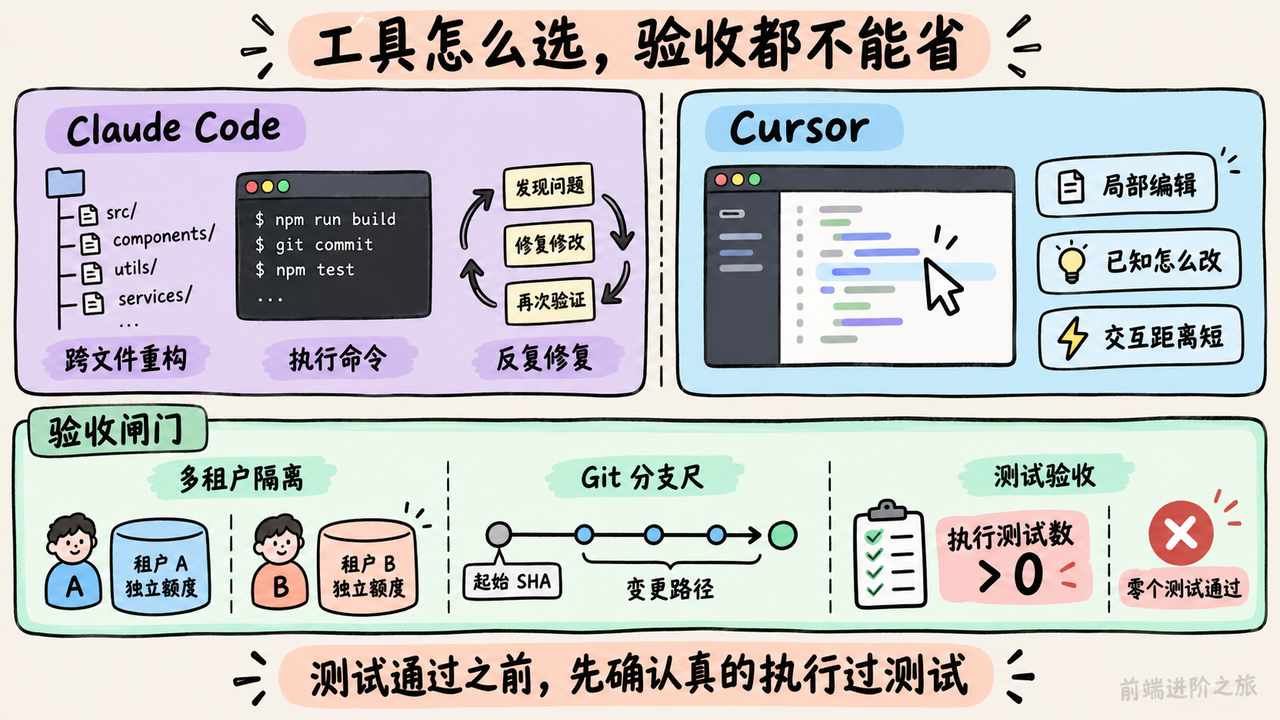
Claude Code 与 Cursor 的任务对比给出的倾向很清楚。跨文件重构、执行命令并反复修复的问题,更偏向 Claude Code;已知怎么改的局部编辑和补全,更偏向 Cursor。
我认可按任务选工具,但不会把这个倾向当成能力边界。文章自己也提到 Cursor 有 agent 面板,Claude Code 有 IDE 扩展。它们有重叠,不能简化成一个会自主工作,另一个只会补全。
对天天写业务的程序员来说,选择可以更具体一点。调整一个组件的空状态文案,交互距离短更舒服;迁移十几个模块的配置读取方式,能持续执行、检查和修正更关键。
说实话,选完工具只是开始。你让它改得越多,就越需要知道「通过」究竟通过了什么。
多租户限流器的面试案例讨论了一个很有代表性的缺口。公开用例看起来都正常,按 IP 或全局状态保存额度的实现,却可能让租户 A 消耗掉租户 B 的配额。这是一份测试题设计,不该包装成已经发生的大规模生产事故,但测试思路值得拿走。
下面这段 JavaScript 专门检查两个租户是否相互挤占额度,约定 check 返回包含 allowed 的决策对象,且每个租户在该路由的额度均为一次。
async function assertTenantIsolation(createFreshLimiter) {
  const limiter = createFreshLimiter(); // 每次使用空存储和固定时钟
  const request = tenantId => ({
    tenantId,
    route: "/export",
    subject: "same-user", // 故意相同,避免用户维度掩盖租户问题
  });

  const firstA = await limiter.check(request("tenant-a"));
  const secondA = await limiter.check(request("tenant-a"));
  const firstB = await limiter.check(request("tenant-b"));

  if (!firstA.allowed || secondA.allowed || !firstB.allowed) {
    throw new Error("租户额度隔离失败");
  }
}
最容易翻车的是创建限流器的那一行,如果测试工厂偷偷给每个租户单独建了实例,就绕开了共享实例下真正需要检查的问题。
另一个坑藏在 Git 里。squash merge 后基线选错的分析描述了一条失败链,Agent 用 HEAD~1 理解「上一次变更」,修到了无关文件,测试筛选又返回空集,最终被算成成功。
这里也别反着背口诀。HEAD~1 仍然是当前提交的第一父提交;当任务就是检查某个 squash 提交引入的变化时,它可能正是合适的比较基线。问题在于任务没有明确比较谁和谁,运行器也没有检查实际改动与测试范围。机械换成 merge-base,同样可能拿到不符合任务意图的结果。
零个测试通过,不能证明修复有效。
要我选,我会拿仓库里最近三个已完成的修改,让工具按原任务重做一次,同时记录起始 SHA、实际变更路径和执行测试数。只要其中一次出现无关改动或空测试集,就先修验收流程,再讨论换哪个 AI 编程工具。
三、Agent 总答错,应该换模型还是重做上下文?
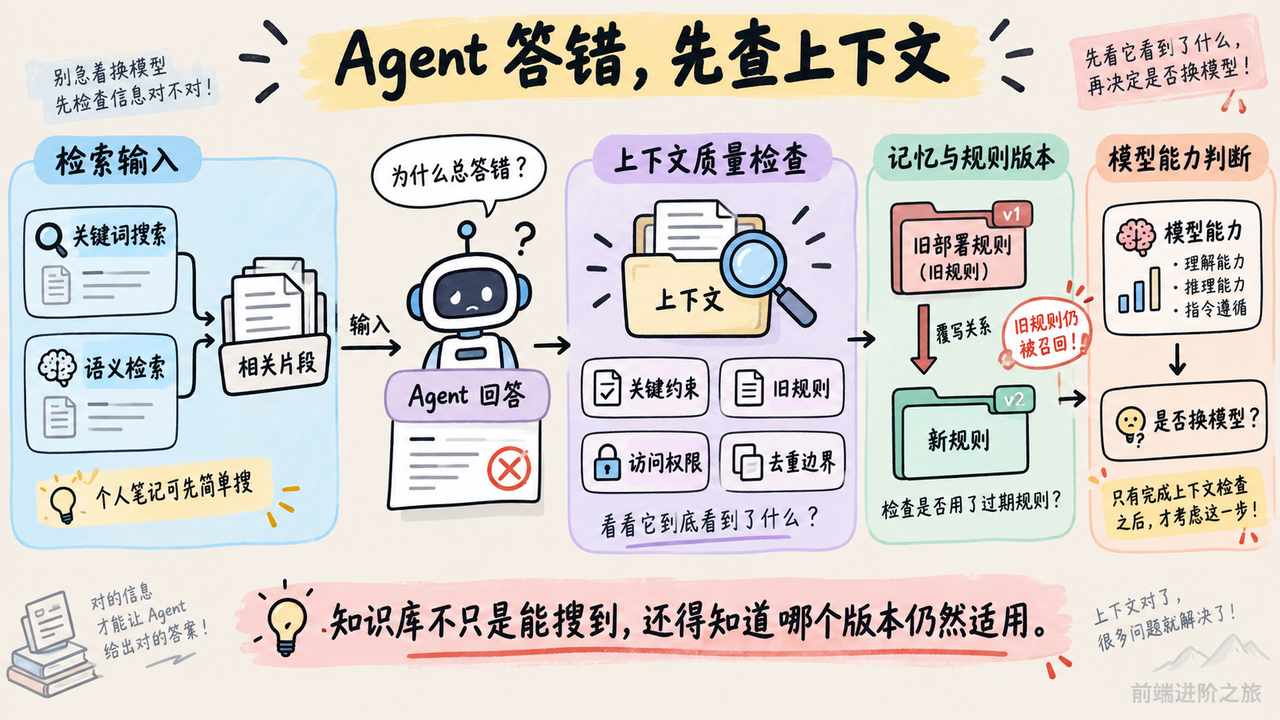
生产级 Agent 上下文工程指南列出的几个问题很眼熟。检索到旧文档,提示词保留过时规则,工具列表太宽,对话历史越滚越长,外部文本里的指令混进可信上下文。
文章把很多失败归到上下文设计。我觉得这个排查顺序合理,但不能据此说所有错误都与模型能力无关。有些任务确实超出模型能力,只是排查之前,先看看它到底读到了什么,通常更容易得到明确答案。
顺着上面聊,个人 RAG 那篇文章正好给了一个轻量的对照。
不用 embeddings 的个人笔记检索实验持续约八个月,作者用日期标注的 Markdown 笔记、关键词搜索和人工筛选,为模型提供相关片段。语料只有几千行,而且本人写过、读过,也知道该搜哪些词。
这点不能省略。他不是证明了简单搜索普遍胜过向量检索,而是把相关性判断交给了熟悉资料的人。
人工筛选也有成本。
如果只是整理自己的技术笔记、会议结论,或者做个人 AI 办公提效,这个成本可能很低。换成几百人共同维护、术语不统一、还有访问权限区别的知识库,作者依赖的熟悉程度就很难复制。
所以我的读法是,先把检索需求说清楚,再决定要不要上复杂组件。能用明确字段和关键词定位的内容,没必要默认让模型猜;真正需要语义匹配、跨文档发现的部分,再评估更复杂的检索方案。
Agent 记忆层测试文章又往前推进了一步。拿到了相关内容,也可能拿到已经失效的相关内容。比如一条旧部署规则已被新规则覆盖,召回结果却仍优先返回旧条目。
摘录里能看到的检查包括覆写关系双向一致、无环、无悬空引用,以及已覆写条目的召回比例、排序确定性和去重行为。我尤其在意去重边界,「使用 Postgres」和「仅计费服务使用 Postgres」不能随便揉成一句。
这就把问题拉回了业务。知识库不只是能搜到,还得知道哪个版本仍然适用。
当天就能做的验证很小。挑十个最近答错的问题,把模型实际看到的片段保存下来,逐条看有没有漏掉关键约束、混入旧规则,或者根本没检索到正确文档。再只替换上下文重跑一次,通常就能缩小排查范围。
四、多 Agent 怎么协作,接上共享频道就能放心执行吗?
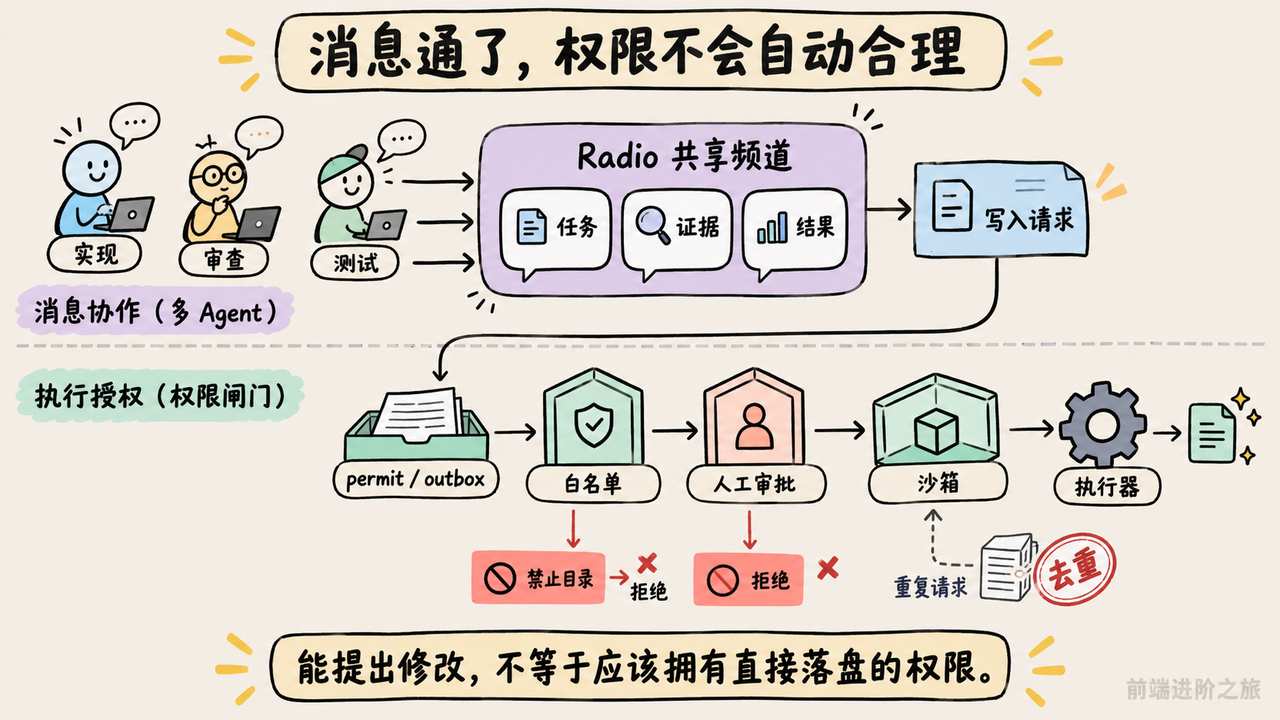
Radio 的介绍解决的是一个具体麻烦。多个 Agent 各忙各的,人类负责在它们之间复制消息、转发结论。Radio 提供共享实时频道,让本地、云端和不同位置的 Agent 参与同一段对话。
这个方向我喜欢,但文章里「一个实现、一个审查、一个跑测试」属于作者设想的工作流,并没有给出协作前后的完成率和耗时对照。共享频道减少人工搬运,是否减少总成本,还得看 Agent 会不会重复调查、反复讨论或互相传播错误判断。
这里有个坑,消息通了,权限可不会自动变得合理。
Pi Agent 项目把多提供商 API、Agent 运行时和编程 CLI 分开,适合研究怎么搭自己的工具链。与此同时,项目明确说明不内置文件系统、进程、网络和凭证的权限限制,默认继承启动它的用户与进程权限,需要更强隔离时另行容器化或沙箱化。
这个边界比支持多少模型更影响接入方式。如果它运行在拥有部署凭证的环境里,工具层面的执行范围就不能只靠一句提示词约束。
LibreChat v0.8.8-rc3 的说明则展示了另一组值得研究的设计,包括 beta 阶段的 Agent 管理 API、角色访问控制、代码审批和上下文使用情况。附加工作区被明确标为高度实验性,不能看到它支持文件读写和 Bash,就直接当成熟远程执行平台用。
对周末项目来说,permit 文件与 outbox 的实践更容易理解。Agent 先提出写入请求,记录到磁盘队列,再由执行环节按白名单处理。那篇文章也明确把实现称为本地实验草图,不是生产级运行时。
能提出修改,不等于应该拥有直接落盘的权限。
我会让共享频道传递任务、证据和结果,把真正执行写入的入口单独收住。这样审查 Agent 说「通过」时,执行器仍然可以根据路径、权限和当前状态拒绝操作,而不是把一条聊天消息当授权。
你要是也在做多 Agent,今天可以拿一个临时仓库试三次写入,分别写允许目录、禁止目录,以及重复提交同一请求。看最终文件和执行记录,比看几个 Agent 聊得多热闹更有用。
五、实时语音 AI 怎么上线,模型升级能解决浏览器中断吗?
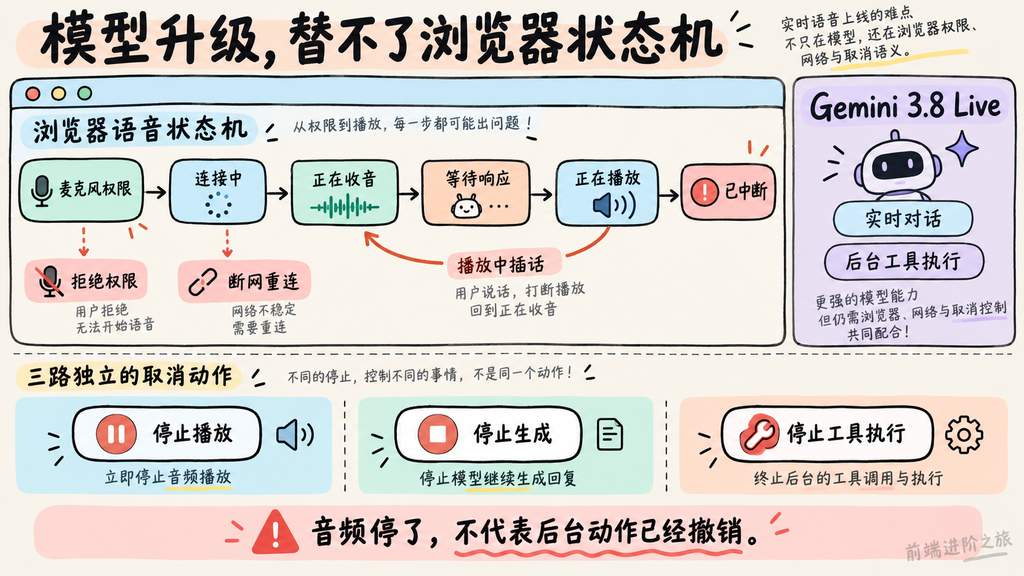
Gemini 3.8 Live 的发布介绍把实时对话、视觉上下文、后台工具执行和扩展思考放在了一起。按文中描述,两种版本分别偏向规模化流畅对话与复杂任务处理。
对前端而言,吸引人的地方是用户说话期间,系统还能推进任务,而不是每次都等一整段回答结束才进入下一步。
但榜单得和用户体验分开看。摘录列出的 82.6 分来自 Speech to Speech Quality Index,68.6% 和 35.1% 分别来自两个语音代理任务基准。它们不是同一种指标,也不能拿其中一个百分比当成自己客服系统的解决率。
模型会处理复杂对话,浏览器仍然可能没拿到麦克风权限。
生产级语音 SDK 集成文章讨论的恰恰是这些零碎又绕不过去的问题。网络在音频传输中途断开,移动系统中断播放,浏览器限制未经用户交互的音频启动,用户又可能在合成语音播放时插话。
这些问题不是在提示词里加一句「保持流畅」就能解决的。界面至少得区分连接中、正在收音、等待响应、正在播放和已中断。否则用户按下停止后,旧请求还在返回音频,页面看起来已经停止,声音却又冒出来了。
我会把取消语义放在 SDK 选型的前面。停止播放、停止生成、停止工具执行是不同动作,产品需要明确用户按一次按钮到底取消了哪些环节。尤其涉及写操作时,音频停了不代表后台动作已经撤销。
DinoDesk的统一网关也给了一个可参考的切入点。模型可以在网关后面切换,但前端仍要接住同一套连接和交互状态。接口形状统一,只是减少接入差异,不保证不同引擎的打断行为完全一致。
要做语音助手,我会在已有 demo 上连续试一轮拒绝权限、断网重连和播放中插话,记录从用户动作到实际静音的时间,以及恢复后是否重复播放。把这些跑顺,再比较扩展思考版本带来的任务收益,顺序会更踏实。
六、AI 生成结果怎么验收,为什么答案和补丁都要能追溯?
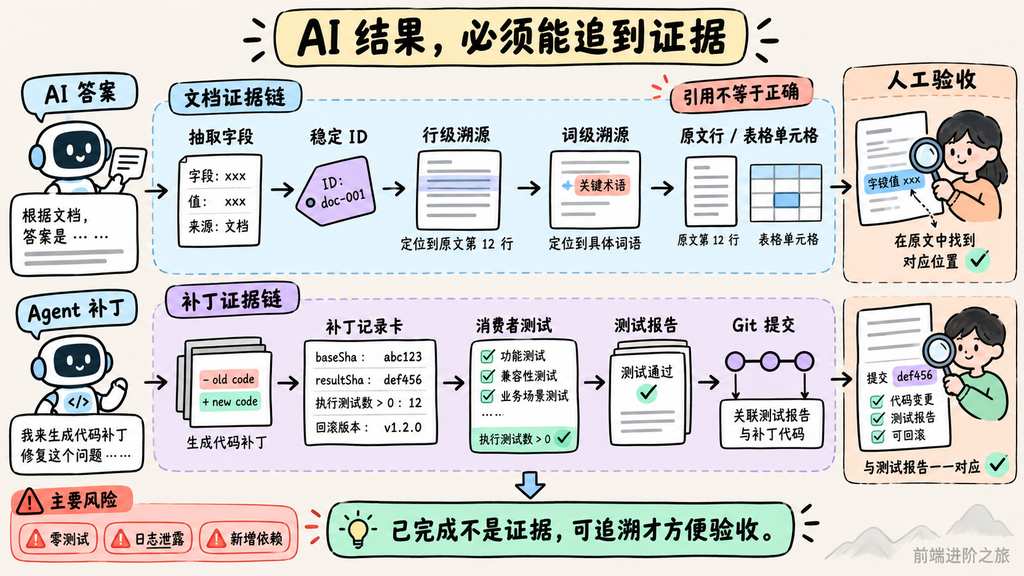
LandingAI ADE Gen2 的介绍把文档抽取输出改成带稳定 ID 的 Block,并细化引用位置。按文中说明,DPT-3 Pro 提供行级溯源,Verity 提供词级溯源,表格单元格也有对应边界框。
我更关心的不是宣传里的「原子级」,而是审核页面能不能把字段值和原文位置连起来。用户发现一个金额不对,点击之后直接看到对应的行或单元格,才有机会迅速判断是识别错、字段映射错,还是源文件本身有问题。
当然,有引用不等于抽取正确。指到了某一行,也可能理解错了那一行。稳定 ID 还需要结合文档版本使用,不能默认文件重新上传后所有标识都继续有效。
计费也一样。按返回字符数收费,比按页收费多了另一种估算方式,但长表格、重复内容会返回多少字符,仍然影响最终成本,不能直接得出一定更便宜。
把这条放到 AI 编程旁边看,验收思路其实相通。
Schema 变更文章用一个明确标注为复合故障演绎的场景,讨论 Agent 修改共享协议后,为什么本地检查不足以证明外部调用方仍然兼容。它提到的 OpenAPI、工具参数、数据库迁移等文件,都需要考虑对话之外的消费者。
我不赞成只凭代码来自哪个工具或什么付费档位就拒绝合并。更可靠的条件是具体变更内容、消费者测试,以及能不能回到已知版本。同一个模型写补丁又自评,也不能代替这些证据。
下面这个 JavaScript 对象适合记录一次 Agent 修改的验收信息,让结果能追到具体提交和测试,而不是只留下「已完成」。
const changeEvidence = {
  taskId: "quota-isolation-fix",
  baseSha: null, // 执行器读取并锁定,不能让模型猜
  resultSha: null,
  changedPaths: [],
  verification: {
    executed: 0,
    passed: 0,
    failed: 0,
    reportPath: null,
  },
  rollbackSha: null, // 指向已知版本,不靠临时生成反向补丁
};

function hasPassingTests(record) {
  const { executed, passed, failed } = record.verification;
  return executed > 0 && passed === executed && failed === 0;
}
最容易翻车的是测试数量的填写环节,它必须来自测试运行器;这个函数也只判断记录中的测试是否全过,不判断测试覆盖是否充分。
重试 helper 的结对审查案例补上了另一面。代码在编辑器里看着合理,却引入了锁文件没有的依赖、错误的环境变量,还把原始业务数据写进日志。这类问题光看函数主体很容易漏掉。
所以我会把验收范围扩到依赖、配置和日志,而不只是「生成代码能不能跑」。当天拿一个最近的 Agent 补丁,核对新增 import、环境变量读取和日志参数,再跑对应消费者测试,就已经比让模型重复说一次「没有问题」更有信息量。
总结
今天读下来,我愿意优先投入的方向是小模型分工、可检查的上下文,以及带执行证据的验收流程。它们都能拆成一天内完成的小实验,不需要先重建整套平台。
从所给项目说明里能明确读到的,是 Pi 默认继承运行权限、LibreChat 的相关功能仍带 beta 或实验性标记,以及个人笔记检索依赖作者的人工筛选。这些边界足够具体,可以直接影响技术方案。
我的判断是,团队接下来更应该比较每个通过验收任务的总成本。模型费、重试、人工复核和故障恢复放在一起,才能解释一种方案究竟有没有省事。
Jev 的倍数优势能否迁移到你的流量,Radio 能否提高多 Agent 完成率,语音榜单成绩能否变成更好的浏览器体验,目前都不能替你下结论。这篇也没有实测这些项目。
至于那条 Anthropic Fable 停服消息,摘录写的是 6 月事件,还缺少这里能核对的官方依据,我不会把它当成 9 月 16 日已经确认的新消息。推理计费那条的正文摘录则变成了一段助手反问,支撑不了标题里的具体结论,也先不采用。
对我们写业务的人来说,最有用的 AI 热点,是读完能更准确地决定下一次改动,而不是又多记住几个模型名字。
参考
- Jev 极简分类与路由模型|Latent Space
- DinoDesk 混合 LLM 桌面机器人|Google AI · DEV
- 生产模型选型框架|DEV Community
- Claude Code 与 Cursor 任务级对比|DEV Community
- Agent 限流器的多租户隔离测试|DEV Community
- Squash merge 后的基线选择问题|DEV Community
- 生产级 Agent 上下文工程|DEV Community
- 不用 embeddings 的个人 RAG 实验|DEV Community
- Agent 记忆层的有效性测试|DEV Community
- Radio 多 Agent 共享频道|DEV Community
- Pi Agent 工具链|GitHub
- LibreChat|GitHub
- Permit 与 outbox 写操作实践|DEV Community
- Gemini 3.8 Live 与扩展思考版本|Google DeepMind
- 生产级语音 SDK 集成|DEV Community
- LandingAI ADE Gen2 文档抽取|LandingAI · DEV
- AI 生成 Schema 变更的审查边界|DEV Community
- AI 重试补丁的结对审查案例|DEV Community
- Fable 停服说法的来源文章|DEV Community
- 推理模型计费讨论|DEV Community
- 前端进阶之旅