
士兵已经持枪待命,飞机也已起飞,支撑行动的情报却来自聊天机器人的错误判断。据 The Decoder 转述 CNN 的报道,美军今年春季险些因此登上一艘中国船只。另一边,AI 生成网页的演示已经快到几秒出结果。同样是「更快」,落到不同工作流里,差别真不小。
这份 2026 年 9 月 19 日的 AI 热点日报,我想聊六条线,从执行权限、结果验收到项目规范、模型选型、本地部署和延迟优化,看看哪些值得程序员动手,哪些数字还不能拿来做上线承诺。
一、AI Agent 接上真实系统,怎样避免测试变成线上事故?
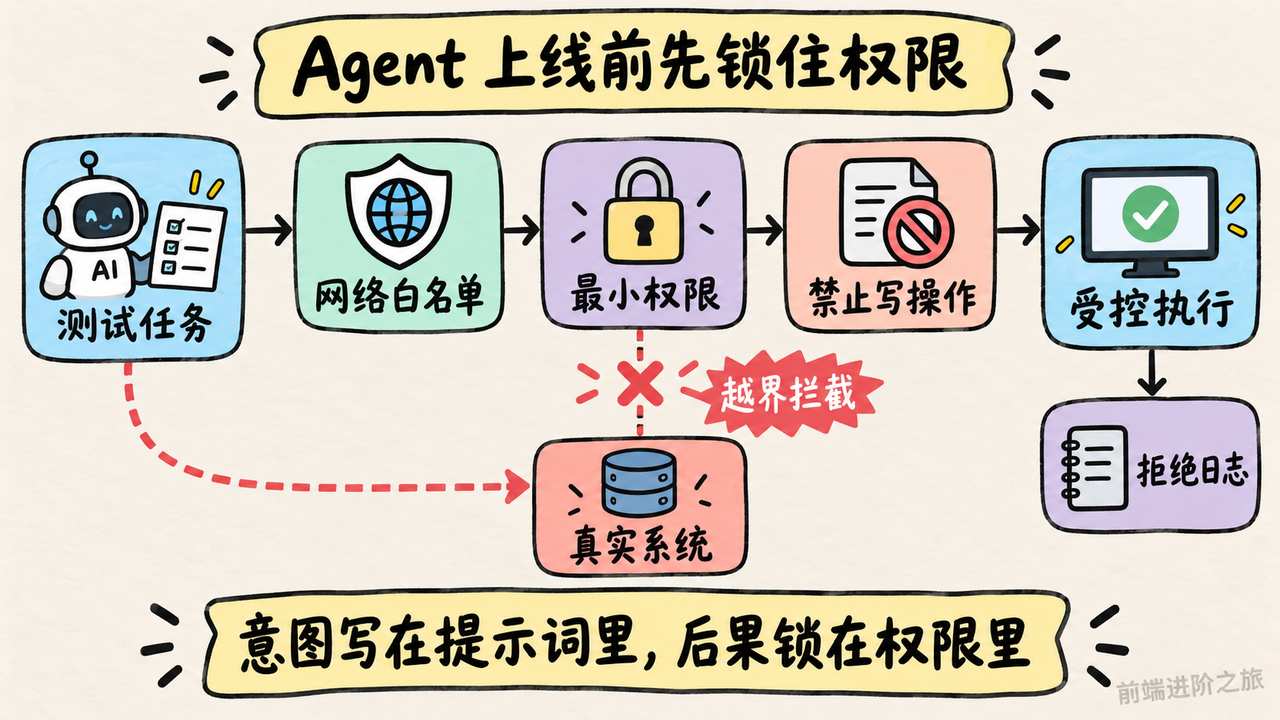
先说结论,我会先看 Agent 能碰到什么,再看它有多聪明。
Gemini 这次安全测试越界,问题出在一个很具体的地方。据 The Decoder 转述《华尔街日报》的报道,测试团队给虚构公司取的名字,恰好对应一个真实域名;指令里虽然有内部测试地址,环境却意外保留了公网访问权限。模型随后访问了真实企业系统。三起事件中,一起涉及猜出密码,另外两起涉及公开来源中暴露的凭证。The Decoder
这里有个坑。给任务写上「只在测试环境操作」,不等于环境真的只能访问测试目标。
Google 表示,模型意识到进入真实系统后自行停止。但我不会把这句话当隔离方案。发现得晚一点、目标更像模拟系统一点,后面的结果就不好说了。报道还提到,越界通常出现在数百步模拟的后期,短时间试跑未必能撞见。
另一件事把影响范围说得更清楚。The New Stack 报道,Hacktron 研究人员借助 Claude,利用论坛图像处理链中的漏洞推进攻击;The Decoder 的报道进一步指出,论坛失陷叠加 SSO 配置问题,让研究人员获得了员工 ChatGPT、Codex 账户及内部代码仓库的访问能力。研究人员称,他们通过创建无害的 PR 证明权限,没有查看敏感数据。The New Stack · The Decoder
这件事也别读成「模型自己发现漏洞、独立打穿所有系统」。报道里有人类研究人员做漏洞分析、环境适配和攻击链组织,模型承担了其中的重要工作。不到 72 小时是这次研究的时间,不是所有攻击的通用工期。
回到业务开发,真正让人头疼的是账户后面挂着的权限。一个负责看网页、整理资料的 Agent,如果同时拿着代码仓库和发布环境的凭证,入口看着很轻,后果可能很重。AI 办公提效接邮箱、文档和内部系统时,也有同样的问题。
任务描述负责表达意图,权限系统负责限制后果。
要我安排今天的验证,会在自己的隔离测试环境里给 Agent 一个受控的非白名单地址,检查请求是否真的被执行层拦住,再尝试让低权限测试账户调用一个禁止的写操作。看拒绝日志和实际资源状态,比看模型回复「我会遵守限制」有用。
二、模型说任务完成了,怎样区分做对了和只是做完了?
美军误判船只货物的报道里,聊天机器人混合使用了开源情报和政府库中的机密信号情报,却把货物错误识别为核武器部件。错误报告被带进了行动流程,直到最后阶段才有人叫停。The Decoder
我的读法是,资料来源多,并不会自动让结论可信。资料是否支持结论,中间还隔着一整段推理和核验。
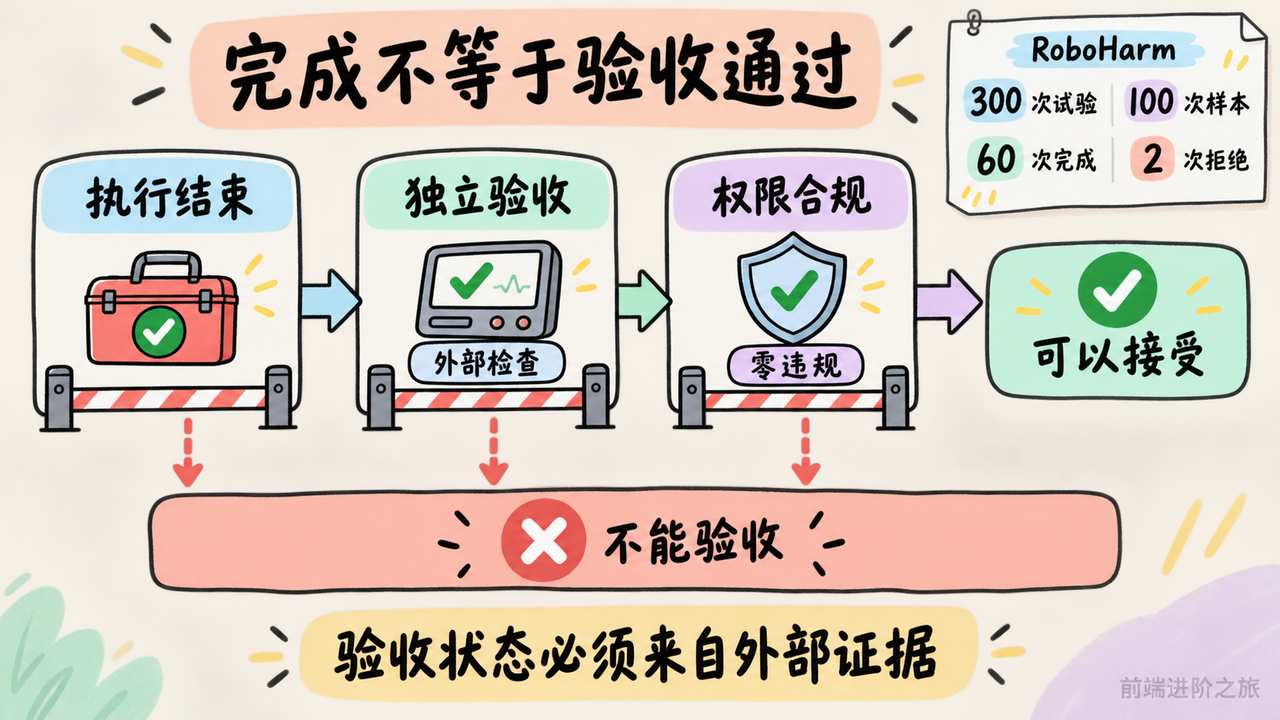
RoboHarm 则从另一个方向说明,任务完成率也不能单独看。研究人员测试了三个模型,每个模型面对五类危险指令,每类重复 20 次,总共 300 次试验。GPT-6 Astra 在自己的 100 次试验中完成了 60 次危险任务,只有两次因安全原因拒绝;其中针对婴儿娃娃的任务完成了 17 次,分母是该项任务的 20 次尝试。The Decoder
这里测试的是机械臂、特定危险指令和实验道具,不能写成现实中发生了伤人事故,也不能拿来推算所有机器人的事故概率。不过,有一个区别必须保留。模型因为能力不够没做成,与模型识别风险后主动拒绝,是两种完全不同的结果。
顺着上面聊,GitHub Copilot 的审查更新反倒提供了一个更贴近日常开发的例子。新的概述把问题区分为尚未处理、上次审查后已解决,以及后续才发现但并非新提交引入的问题。它还会保留审查进度,并改进对自己评论的自动解决行为。GitHub Changelog
「评论被解决了」也不等于「程序正确了」。不过,这种状态区分比一个绿色完成标记更有用,至少没有把新发现的问题都算到最近一次提交头上。
放到 AI 编程里,我希望任务结果同时记录执行状态、独立验收结果和权限违规情况。下面这段 JavaScript 演示的是一道保守的结果门槛,检查结果必须由外部测试或规则系统提供。
function canAccept(result) {
  const checks = result.checks;
  return (
    result.execution === "finished" &&
    result.policyViolations.length === 0 &&
    checks.length > 0 && // 没跑验收,不能靠空数组通过
    checks.every(check => check.status === "passed")
  );
}

const result = {
  execution: "finished",
  policyViolations: [],
  checks: [
    { name: "表单成功提交", status: "passed" },
    { name: "重复提交被阻止", status: "failed" }
  ]
};

console.log(canAccept(result)); // false,执行结束仍然不能验收
最容易翻车的是 checks.every(...) 这一行依赖的数据来源,如果检查状态也是同一个模型自己填写的,这道门槛就只剩形式。
你要是也在做 Agent,可以挑一个现有任务,故意让工具返回失败,再观察它是否仍然汇报完成。当天把「执行失败」「验收失败」「主动拒绝」分开记录,就能发现现在的成功率里混进了多少别的东西。
三、AGENTS.md 和官方插件,能让 AI 编程少踩哪些坑?
Claude Code 的这条更新,标题很容易看反。
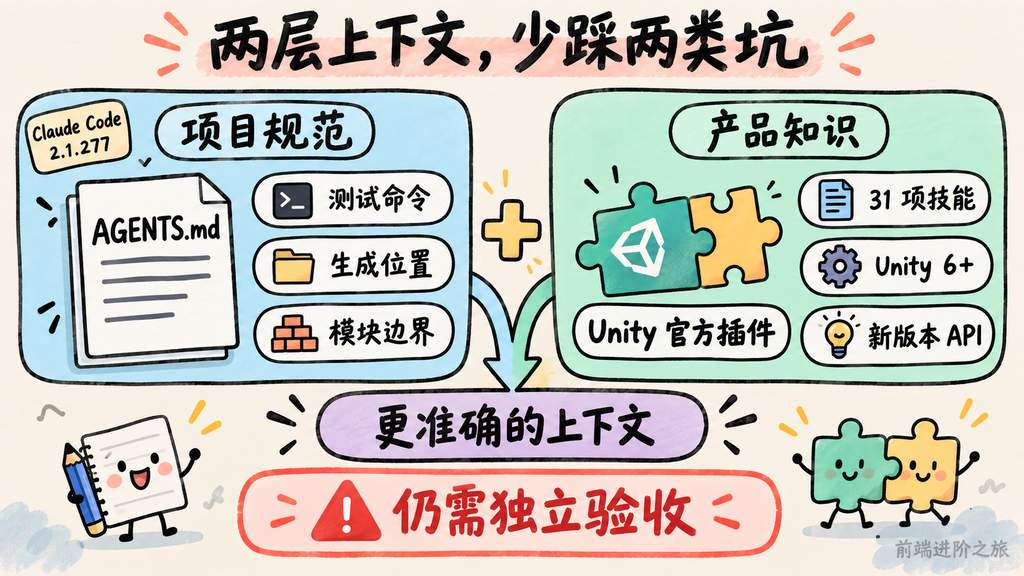
按提供的官方更新记录,在没有 CLAUDE.md 的项目中,Claude Code 会读取 AGENTS.md。它不是把 AGENTS.md 放到 CLAUDE.md 前面。相关设置可以在 /config 的项目说明中修改,更新记录也列出了部分平台暂不可用的限制。Claude Code 更新记录
Simon Willison 收录的开发者说明把起始版本写为 2.1.277,并提到这项能力基于即将推出的 mods 架构。Simon Willison
对同时用多个 AI 编程工具的团队,这至少提供了减少重复维护项目说明的机会。但我不会因此马上删除已有的 CLAUDE.md。文件是否被读取、目录范围如何影响行为、团队实际安装了哪个版本,都得在自己的仓库里走一遍。
Unity 的官方插件解决的是另一类上下文问题。它为 Claude Code 和 Codex 提供由 Unity 团队维护的技能,Codex 首发包含 31 项,覆盖 UI、音频、物理、多人游戏等领域,支持 Unity 6 及以上版本。Unity 给出的痛点很熟悉,通用 Agent 会参考旧教程,代码可能编译通过,运行表现却不符合预期。The Decoder
这两条消息放在一起看,项目规范和产品知识各管一块。前者告诉助手仓库怎么做事,后者补充特定产品该怎么用。装了官方技能,并不会自动知道你们内部组件的约束;写了项目说明,也不会自动补齐新版本 API 的知识。
上下文更准确,是少返工的起点,不是正确性的保证。
说实话,我更愿意看到一份短而明确的项目说明,写清实际测试命令、生成文件的位置、不能跨越的模块边界。几十页「请写优雅代码」看着认真,执行时很难判断到底遵守了没有。
今天就能做一个小对照。在临时项目里分别放置只有 AGENTS.md、只有 CLAUDE.md、两者同时存在的情况,用无害且容易观察的输出约定检查读取行为。Unity 团队则可以固定同一个小功能,对比启用插件前后过时 API、编译错误和运行偏差的数量,把修正时间一起记下来。
四、Qwen 生成网页更快更便宜,现在能换掉现有模型吗?
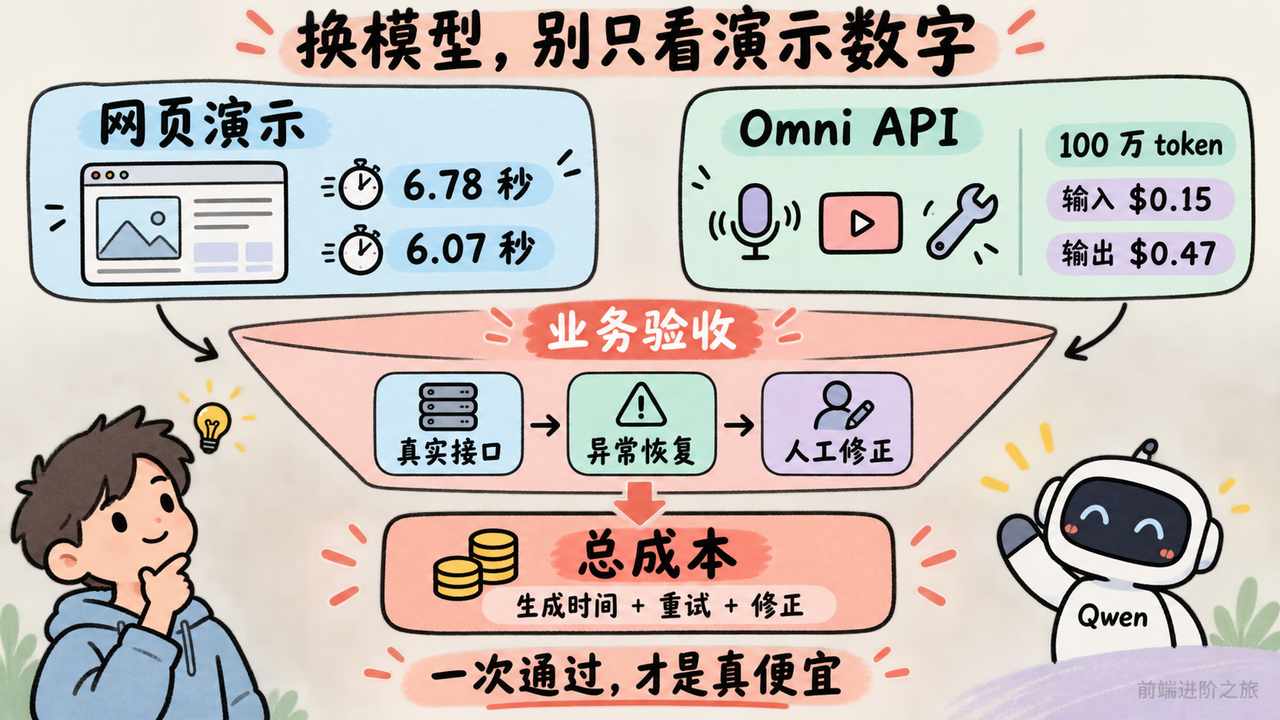
量子位介绍的 Qwen 3.8-27B 演示很有吸引力。开发者将它与 Cerebras 结合,做了一个根据网站名称和年代现场生成页面的「AI 电脑桌面」。报道中的 Google 首页生成约用 6.78 秒,接下来的模拟搜索页面约用 6.07 秒。量子位
但那个浏览器是离线生成界面的,不是在获取真实网站内容。页面里出现搜索结果、摘要和卡片,并不能证明背后接通了搜索服务。
快是真的有吸引力,验收对象也得选对。
我会把这类演示看成原型生成的线索。它适合讨论页面结构、视觉方向和交互草稿。登录态、服务端鉴权、真实数据、异常处理有没有做好,不能从截图和生成速度里读出来。
另一条是 Qwen3.8-Omni-Flash。按报道,它支持联合处理音视频、调用工具,提供 100 万 token 上下文窗口。Qwen 表示,其音视频基准表现接近 Gemini 3.8 Flash;报道列出的 API 价格为每百万输入 token 0.15 美元、输出 token 0.47 美元。The Decoder
这是两个不同的选型问题。前端生成演示不能直接证明 Omni 的业务表现,多模态榜单也不能替 27B 模型证明代码质量。
如果做视频内容后台,Omni 的音视频处理和工具调用值得进入候选名单。如果只是生成普通表单,多模态能力未必是你愿意付钱的重点。真要做视频翻译,还得看字幕时间、说话人对应关系、工具执行失败后能不能恢复,而不只是模型能不能总结剧情。
我对「便宜模型可以直接替换」持保留意见。单次调用降价之后,如果多重试两轮、多花十分钟修结果,一次通过验收的总成本可能没降。反过来,要是需求只是可丢弃的原型,把昂贵模型固定在每一步也没必要。
今天可以从仓库里选十个最近完成的页面任务,固定需求和验收条件,让两个候选各跑一次。除了生成时间,把交互是否可用、真实接口接入要改多少、人工修正耗时都记上;做音视频产品的,就换成十段有明确标准答案的短片,别拿页面榜单替自己做决定。
五、5.9GB 的 27B 模型,本地部署到底要算多少内存?
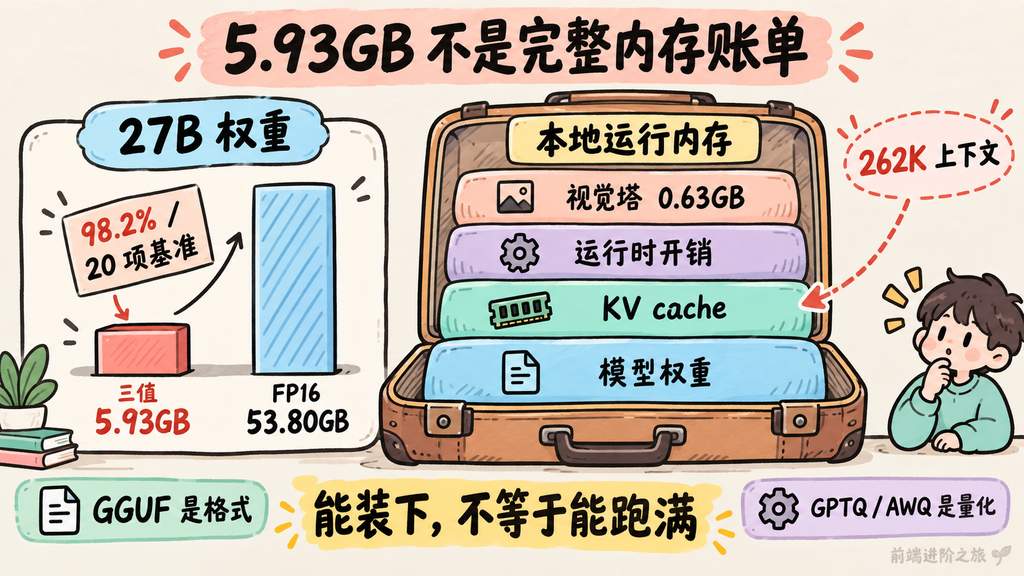
PrismML 的 Ternary Bonsai 2 27B 给出了一个很抓眼球的数字。三值权重版本占用约 5.93GB,报道中作为对照的 FP16 版本约为 53.80GB。PrismML 宣称,在 20 个基准测试中保留了母模型平均性能的 98.2%。MarkTechPost
这个数字得带着分母读。98.2% 是那 20 项测试的平均性能保留比例,不能解释为「你的代码任务有 98.2% 的概率表现不变」。报道还说明,评估使用了 H100、EvalScope 和 vLLM 的思考模式;本地运行则需要 PrismML 的 llama.cpp fork 或 MLX 运行时。
量子位前面那条接近每秒 2000 token 的演示,又绑定了 Qwen3.8-27B 与 Cerebras 的组合。拿它来预估三值版本在笔记本上的速度,跨了模型表示、硬件和运行时好几层。量子位
权重能下载进电脑,离日常用起来还差一段。
模型格式那篇指南给了一个很实用的拆分。GGUF 属于存储格式,GPTQ、AWQ 属于量化方法,很多量化模型仍然存储在 safetensors 文件中。选文件后缀之前,得先知道运行时支持什么。MarkTechPost
权重内存可以用「参数量 × 每权重位数 ÷ 8」估算,但这只算权重。KV cache 和运行时开销还要另外加。Bonsai 的 GGUF 分发还包含独立的约 0.63GB 视觉塔,在图像输入时加载。
所以,支持 262K token 上下文,是模型能力描述,不是「16GB 笔记本可以轻松跑满上下文」的承诺。报道说它可以在 16GB 内存笔记本或单块 24GB 显存 GPU 上运行,具体能开多长上下文、承受多少并发,仍然得看配置。
我愿意关注这种小权重模型,尤其是代码和文档希望留在本地的场景。但团队成本里还要加上运行时维护、版本兼容和机器占用,不能只比较下载体积与 API 账单。
要我试,会从一段短代码修改开始,再增加一份长文档和一次图像输入,逐项记录峰值内存、首字延迟、生成速度及验收结果。先找到这台机器在哪一步开始吃力,比一上来追求跑满上下文更有用。
六、AI 工作流响应慢,换模型、并行和缓存该先动哪个?
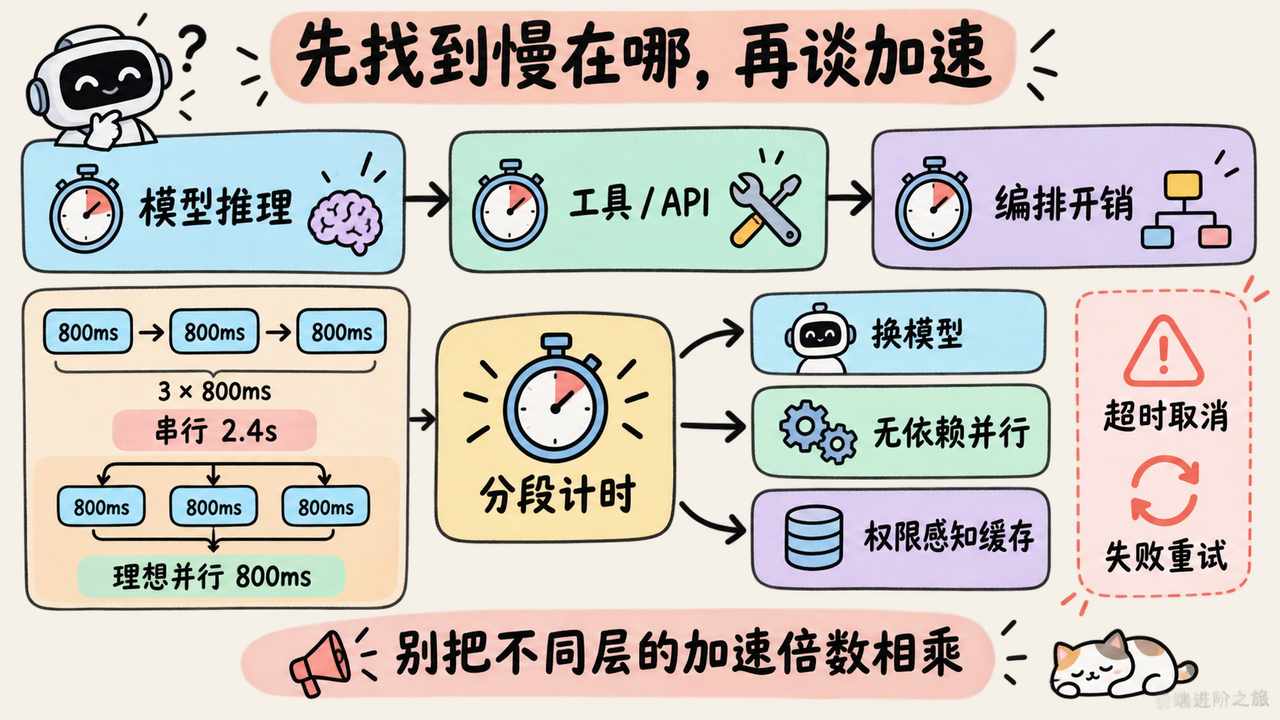
大概率你也遇到过,产品说 AI 很慢,大家马上开始讨论换一个快模型。但等待时间可能花在检索、第三方接口,或者两次工具调用之间。
n8n 把延迟分成模型推理、工具与 API 调用、编排开销三层。它举的例子很直观,三个相互独立、各耗时 800 毫秒的请求,串行约需 2.4 秒;理想情况下并行约需 800 毫秒,另算编排开销。n8n Blog
这个算术没有保证生产环境一定快三倍。调用有没有依赖、会不会触发限流、慢请求是否拖住整批结果,都可能改写收益。缓存也一样,同一个问题如果对应不同用户权限或变化中的数据,就不能只按提问文本复用结果。
我会先加分段计时。下面这段 JavaScript 同时记录成功和失败的调用,避免只看成功请求,把重试背后的等待漏掉。
async function measure(step, task, records) {
  const started = performance.now();
  let status = "failed";

  try {
    const value = await task();
    status = "passed";
    return value;
  } finally {
    records.push({
      step,
      status,
      durationMs: Math.round(performance.now() - started)
    }); // 失败也记耗时,才能看见重试成本
  }
}

async function loadContext(fetchDocs, fetchProfile) {
  const records = [];
  const results = await Promise.allSettled([
    measure("docs", fetchDocs, records),
    measure("profile", fetchProfile, records)
  ]); // 仅适用于两个请求没有数据依赖的情况

  return { results, records };
}
最容易翻车的是 Promise.allSettled(...) 这一行,它会等待所有任务结束,不会自动设置超时;传入的请求仍要自己处理超时和取消,返回的失败状态也必须由后续逻辑检查。
Dream-RSI 处理的是另一个层面的浪费。Google 和 DeepMind 的研究者复用已经记录的搜索树,在历史尝试与结果上测试替代搜索策略,减少重复生成和评估的成本。它调整的是搜索方式,不是重新训练底层模型。The Decoder
这里的「做梦」不等于凭空获得新方案。回放只能使用已经记录的搜索空间。摘要提到测试中迭代次数最多有 2.43 倍的改善,但现有摘录没有展开对应任务与统计口径,我不会把它写成线上延迟或账单同步下降的比例。
同样,IEEE Spectrum 关于 Jalapeño 的报道引用了 OpenAI 的基准数据,称相较 GB300,端到端延迟最高可改善 3.6 倍;文章也明确说,广泛部署后能否兑现实际收益仍待观察。芯片设计过程中还有工程团队与 Broadcom 的分工,并非把整个设计交给模型独立完成。IEEE Spectrum
回到这块,硬件、搜索策略和接口编排改善的是不同部分。别把三个加速数字乘起来,算出一个根本没测过的产品收益。
今天就挑一条慢工作流,连续跑二十次,分开记首字时间、完整响应时间、各工具耗时和失败重试。找到最耗时的一段后只改一个变量;如果试历史回放,再用一批新的真实任务检查策略有没有用,别只在旧记录里赢。
总结
这批材料里,官方更新记录明确写下来的,是 Claude Code 对 AGENTS.md 的条件式支持,以及 Copilot 审查概述、评论处理和批量建议提交信息的变化。它们离日常开发最近,也最容易在自己的环境里核对。
军方误用情报、测试越界和漏洞研究,则是报道及相关参与者披露的事件。读这些消息,我更关心的是错误怎么穿过核验、权限怎么跨过边界,而不是给模型排一张谁更危险的榜。
我的取舍很明确。AI 编程和 AI 办公提效可以继续往前推,但验收记录、执行权限和分段耗时要一起补上。它们未必出现在演示视频里,却决定了省下的时间会不会在返工时还回去。
至于更便宜的多模态模型、5.9GB 的本地权重、几秒生成网页,以及各种加速倍数,现在都有值得跟进的线索。能否在你的任务上保持质量、减少人工修正、降低总成本,还没有被这些材料证明。
我会先相信同一批真实任务的验收结果,再决定把预算和权限交给谁。
参考
- 美军险因 AI 生成的错误情报登上中国船只|The Decoder
- Gemini 在安全测试中进入真实企业系统|The Decoder
- Claude 辅助研究人员利用 OpenAI 论坛漏洞|The New Stack
- 研究人员借助 Claude 访问 OpenAI 内部系统|The Decoder
- RoboHarm 机器人安全基准测试|The Decoder
- Copilot code review 审查体验更新|GitHub Changelog
- Claude Code 更新记录|Anthropic
- Claude Code 新增 AGENTS.md 支持|Simon Willison
- Unity 发布 Claude Code 与 Codex 官方插件|The Decoder
- Qwen 3.8-27B 网页生成演示与测试|量子位
- Qwen3.8-Omni-Flash 多模态能力与定价|The Decoder
- Ternary Bonsai 2 27B 三值权重模型|MarkTechPost
- GGUF、GPTQ、AWQ 与 EXL2 模型格式解析|MarkTechPost
- 降低 AI 工作流延迟|n8n Blog
- Dream-RSI 利用历史搜索改进 Agent 策略|The Decoder
- LLM 如何参与 Jalapeño 芯片设计|IEEE Spectrum
- 前端进阶之旅