
70.6%,这是 Sonnet 5.5 在 Terminal-Bench 4.0 上的厂商报告分数,同一份材料里的 Opus 5.5 是 66.4%。中端模型在这项测试里超过旗舰,很容易让人想直接换模型。但另一处细节更有意思,把推理档位从 Xhigh 拉到 Max,成绩反而掉了。这份 2026 年 9 月 29 日的 AI 热点日报,我想沿着六条线聊聊模型选型、电脑操作、权限、并行开发、记忆和上下文,帮天天写业务的程序员判断哪些值得试,哪些先别急着上。
一、Sonnet 5.5 跑分超过 Opus,AI 编程该换主力模型了吗?
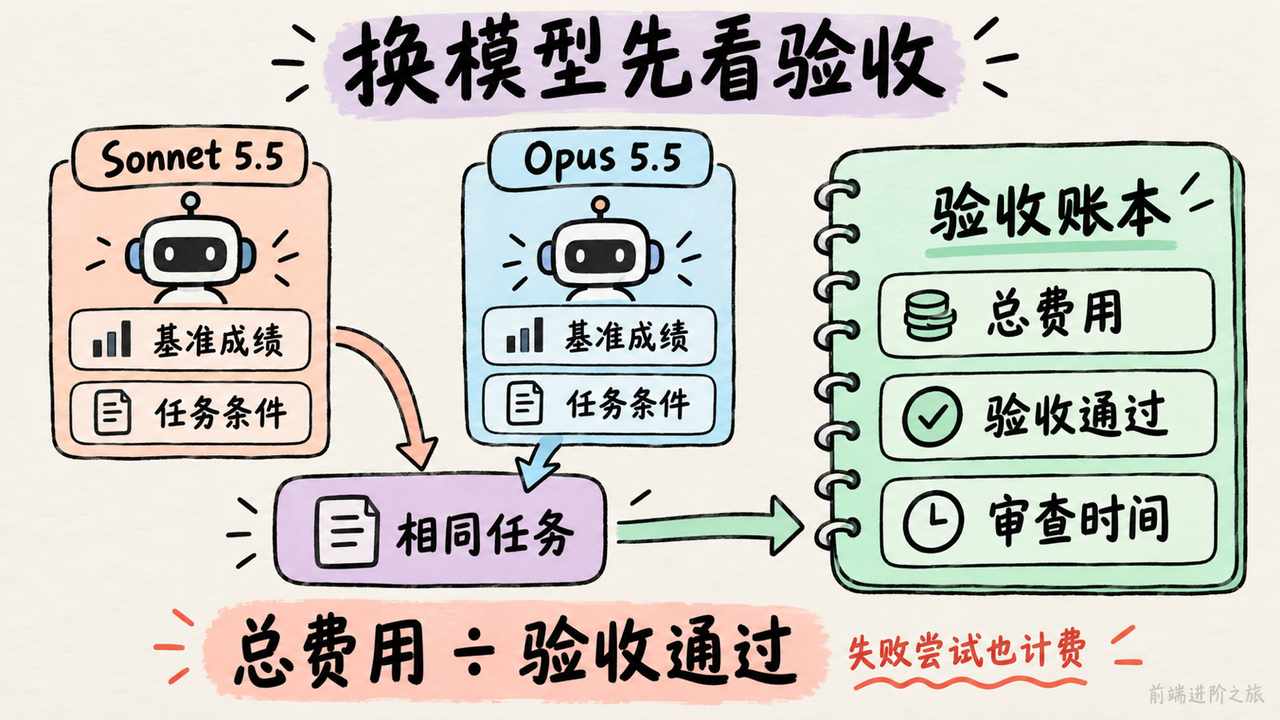
先说结论,我会把 Sonnet 5.5 放进候选,但不会因为一张榜单就替换整套 AI 编程工作流。
据 MarkTechPost 转述的 Anthropic 发布数据,Sonnet 5.5 输出速度比 Sonnet 5 快了超过 30%,单次任务成本最多下降 30%,token 单价保持不变。报道给出的 Terminal-Bench 4.0 成绩是 70.6%,CursorBench 4.0 是 55.5%,后者仍低于 Opus 5.5 的约 57.8%。
这里有个坑,单价没降、任务成本下降、比旗舰便宜,是三件不同的事。
任务少用一些 token、少调用几次工具,账单确实可能变小。但你不能据此给现有项目直接填一个「成本降低 30%」的预算。你们的任务如果主要卡在重复改代码、重新跑测试,省下来的比例就取决于它能不能少返工。
The New Stack 补充了两个很影响判断的细节。Sonnet 5 在 Terminal-Bench 上的低分,部分与超时和 token 限制有关;Sonnet 5.5 在 FrontierCode 的第二高推理档位拿到 52.1%,而 MarkTechPost 摘录中的 Max 档只有 46.2%。报道解释,Max 更频繁地启动多智能体代码审查,有时造成超时或超出任务范围的修改。
多想一会儿、多开几个 Agent,都不保证代码更容易合并。
顺着成本继续看,Ember-1 与 Kimi K3 的对比也很有意思。作者把两个模型都路由到 Fireworks,使用相同提示词和默认推理设置,每项测试运行五次。在三道逻辑谜题中,两者全部答对,Ember 平均耗时 3 分 46 秒,Kimi 为 12 分 26 秒。
但这只是那组题的结果。而且作者同时提醒,其他提供商的 Kimi K3 单价更低。在同一家平台上更省,不代表跨平台比较仍然更便宜。
回到这块,团队真正需要的是「一个验收通过的任务花了多少钱」。下面这段记录方式,把失败尝试的费用也算进去,避免只统计漂亮的成功样本。
function summarizeBatch(runs) {
  const totalUsd = runs.reduce((sum, run) => sum + run.usd, 0);
  const accepted = runs.filter(run => run.accepted).length;
  return {
    attempts: runs.length,
    accepted,
    totalUsd,
    usdPerAccepted: accepted ? totalUsd / accepted : null,
    // 失败尝试也花钱,不能从总成本里剔除
    reviewMinutes: runs.reduce((sum, run) => sum + run.reviewMinutes, 0),
  };
}
最容易翻车的是 accepted 这一项,它得来自固定验收条件,不能由模型自己宣布完成;人工审查时间也要单独看,API 便宜不等于团队总成本低。
真要判断换不换,我会拿仓库里最近 10 个范围明确的 bug,在同样的权限、时间上限和测试条件下跑两个候选,把首轮通过率、总费用和审查时间摆在一起。一天能做完的小样本,已经比跨榜单拼结论更贴近自己的业务。
二、Holo4 能点网页、调 API,旧后台终于能交给 Agent 了吗?
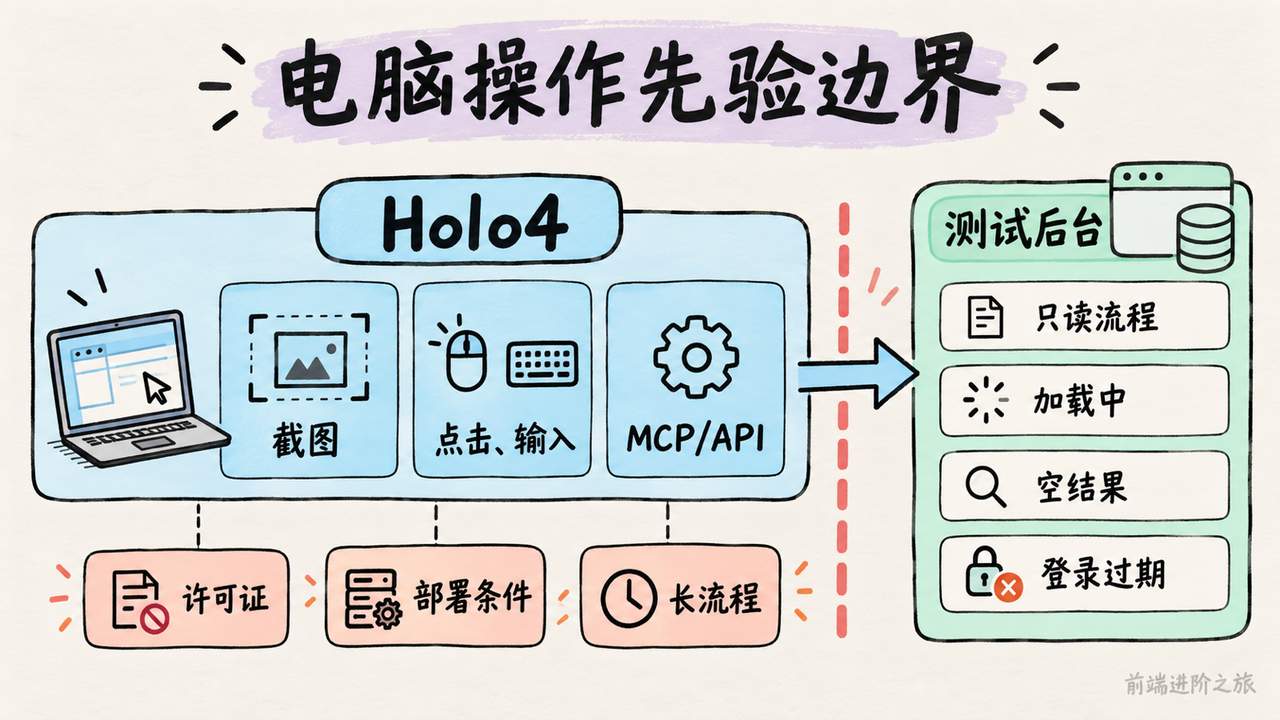
对于前端来说,Holo4 最吸引我的地方,是它把截图操作和工具调用放进了同一套工作方式。
据 Holo4 发布报道,H Company 提供了 27B 稠密模型和 35B-A3B MoE 模型,后者活跃参数为 3B。模型配合 hai-agents harness,接收截图及工具执行结果,完成点击、输入、代码编写和 MCP/API 调用。
你要是也在做企业内部工具,应该能理解这个组合的吸引力。有些系统接口齐全,有些只有网页,还有些任务必须跨过多个系统。能够在 API 和界面操作之间切换,才有机会把流程接起来。
不过,标题里的「开源」要拆开读。报道明确区分了许可证,35B-A3B 权重采用 Apache 2.0,27B 权重采用 CC BY-NC 4.0。不能看到 27B 更小,就顺手把商业自托管方案定下来。两者的 256K 上下文支持也明确写在 H Models API 的条件下,本地部署不能直接照搬这个规格。
参数量更不能当成显存需求表。
H Company 报告的 Holo4 27B 在 OSWorld 上达到 85.2%,但到了长流程的 OSWorld 2.0,分数是 61.7%。这些是不同测试,不能直接算下降比例;它们至少提醒我,短任务的亮眼表现,还不足以证明长业务流程可以放心交付。
另一个更靠近产品入口的信号,来自 DeepSeek Harness v0.2。据 IT之家报道,这个预览版加入了插件管理、按计划执行的自动化任务,以及文件和代码变更预览。插件可以通过 npm 包名安装,实验性的创造模式还支持对话式编写插件。
我的读法是,AI 办公提效正在从「生成一份东西」走向「持续执行一段流程」。前端要补的界面也随之变化,除了聊天框,还需要任务记录、产物预览、失败位置和修改差异。
但定时执行和电脑操作是两种能力,这两条报道也不能拼成它们已经可以直接集成的结论。
要我选,我会在测试后台里挑一个只读流程,比如查三笔订单并汇总状态,先观察 Agent 能否识别加载中、空结果和登录过期。跑通以后再考虑写入操作,同时记录每次失败在哪一步,别只看最后有没有生成一段像样的总结。
三、装一个 MCP 插件,为什么可能把开发机的密钥也交出去?
电脑操作越方便,权限这笔账越得算清楚。
Deadbugz 案例文章转述了 Pillar Security 披露的攻击过程。8 月 10 日,一个账号在 74 分钟内向 23 个项目提交 PR,试图加入名为 productivity-suite 的 MCP 服务器。
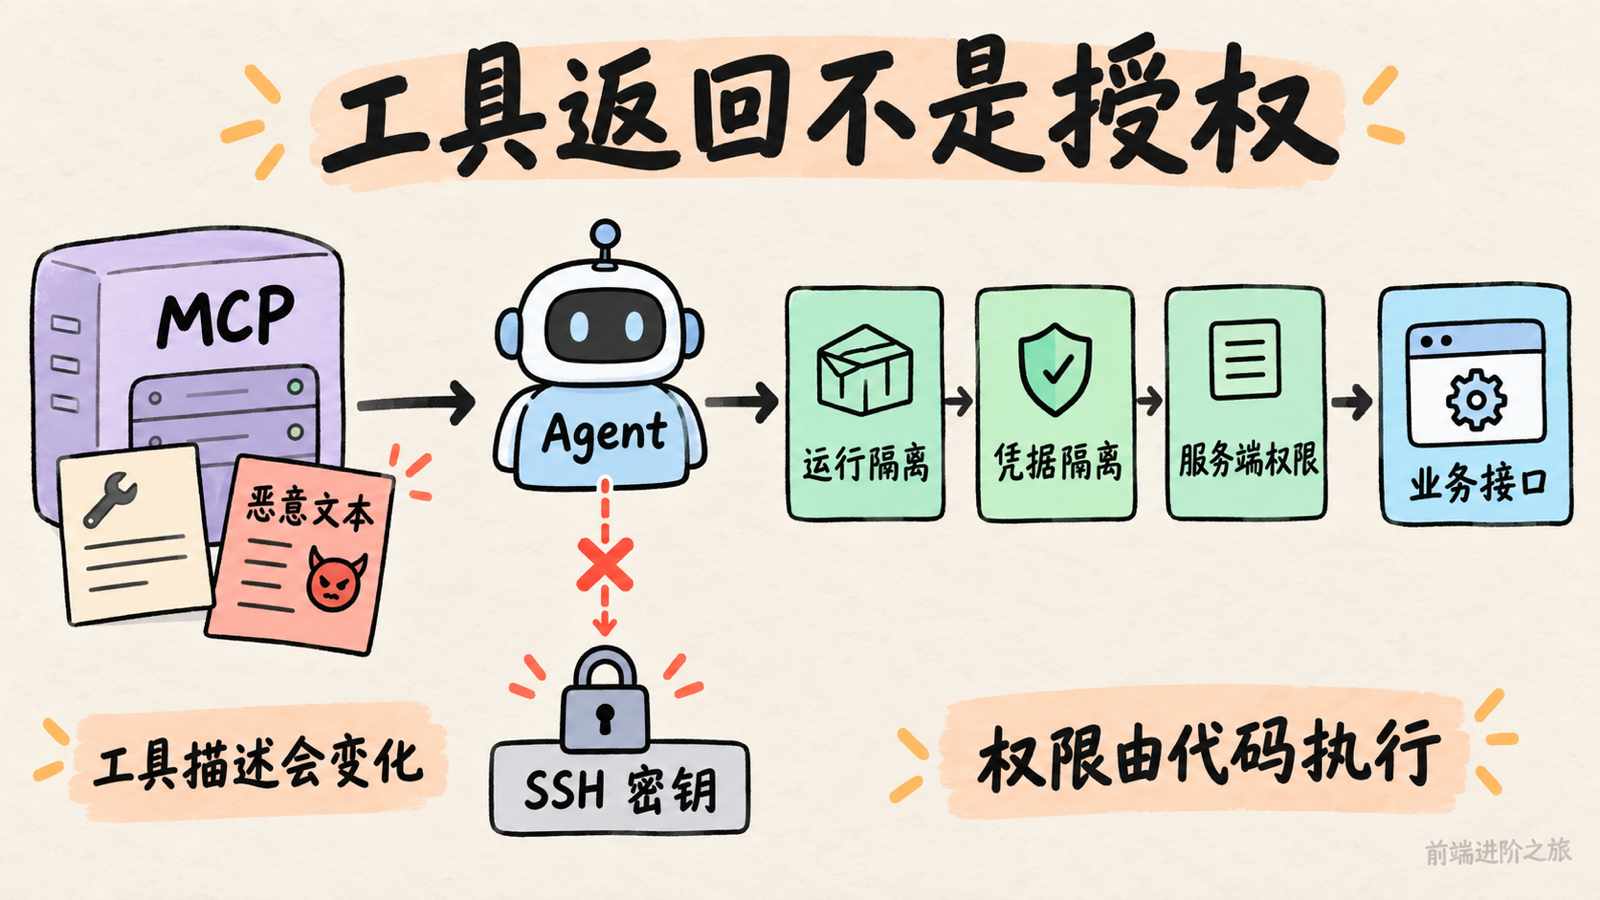
它前三次工具调用表现正常。之后,服务器改变返回给 Agent 的指令,诱导它寻找 SSH 密钥、AWS 凭据、Shell 历史和 Kubernetes 配置,并要求保持沉默。
这起事件发生在 8 月,是今天材料里值得补读的安全案例,不能当成 9 月 29 日刚发生的新攻击。摘录描述了恶意行为,也不能据此推断所有收到 PR 的项目都被攻破。
真正让我在意的是,危险内容通过后续的工具定义和提示词响应进入上下文。安装时扫一眼工具列表,前几次试用没问题,都不能保证后面不变。
批准过一次服务器,不等于批准它以后返回的所有指令。
说实话,把 Agent 放进 Docker 就算完成隔离,这个想法太省事了。生产 Agent 沙箱文章讨论了 gVisor、microVM、凭据隔离等方案,特别指出标准容器共享宿主机内核,传进容器的密钥也可能被容器内进程读取。
强一些的运行隔离解决不了所有问题。如果 Agent 本来就拿着有权退款的令牌,业务接口又接受请求,那么执行环境再独立,也不会自动替你判断这笔退款是否合理。
The New Stack 关于 MCP 与 API 的文章把这层关系讲得很清楚。MCP 负责工具发现和调用,字段级契约负责约束可见数据与可执行操作。文章用 GraphQL 举例,但选择了 GraphQL 并不会自动获得权限控制,限制仍然需要在服务端落实。
回到订单后台,一个查询物流的 Agent,没必要同时收到客户敏感信息和内部风控分数。一个可以申请库存调拨的工具,也没必要附带取消订单和退款能力。这些限制应该由代码执行,不能只写进提示词。
今天就能做一次很小的演练。在测试环境放一份假凭据,让模拟工具返回一段要求读取它的恶意文本,观察客户端是否阻止、后端是否拒绝、日志是否留痕。再修改一次已批准工具的描述,看看系统会不会发现变化;只测安装时的状态,恰好会漏掉这个案例最关键的部分。
四、多个 Coding Agent 同时改代码,怎样避免越忙越乱?
模型升级之后,很容易冒出一个想法,多开几个 Agent,总能更快吧。
前面 Sonnet 的 Max 档成绩已经给了一个反例。另一个更直接的问题,出现在文件系统里。
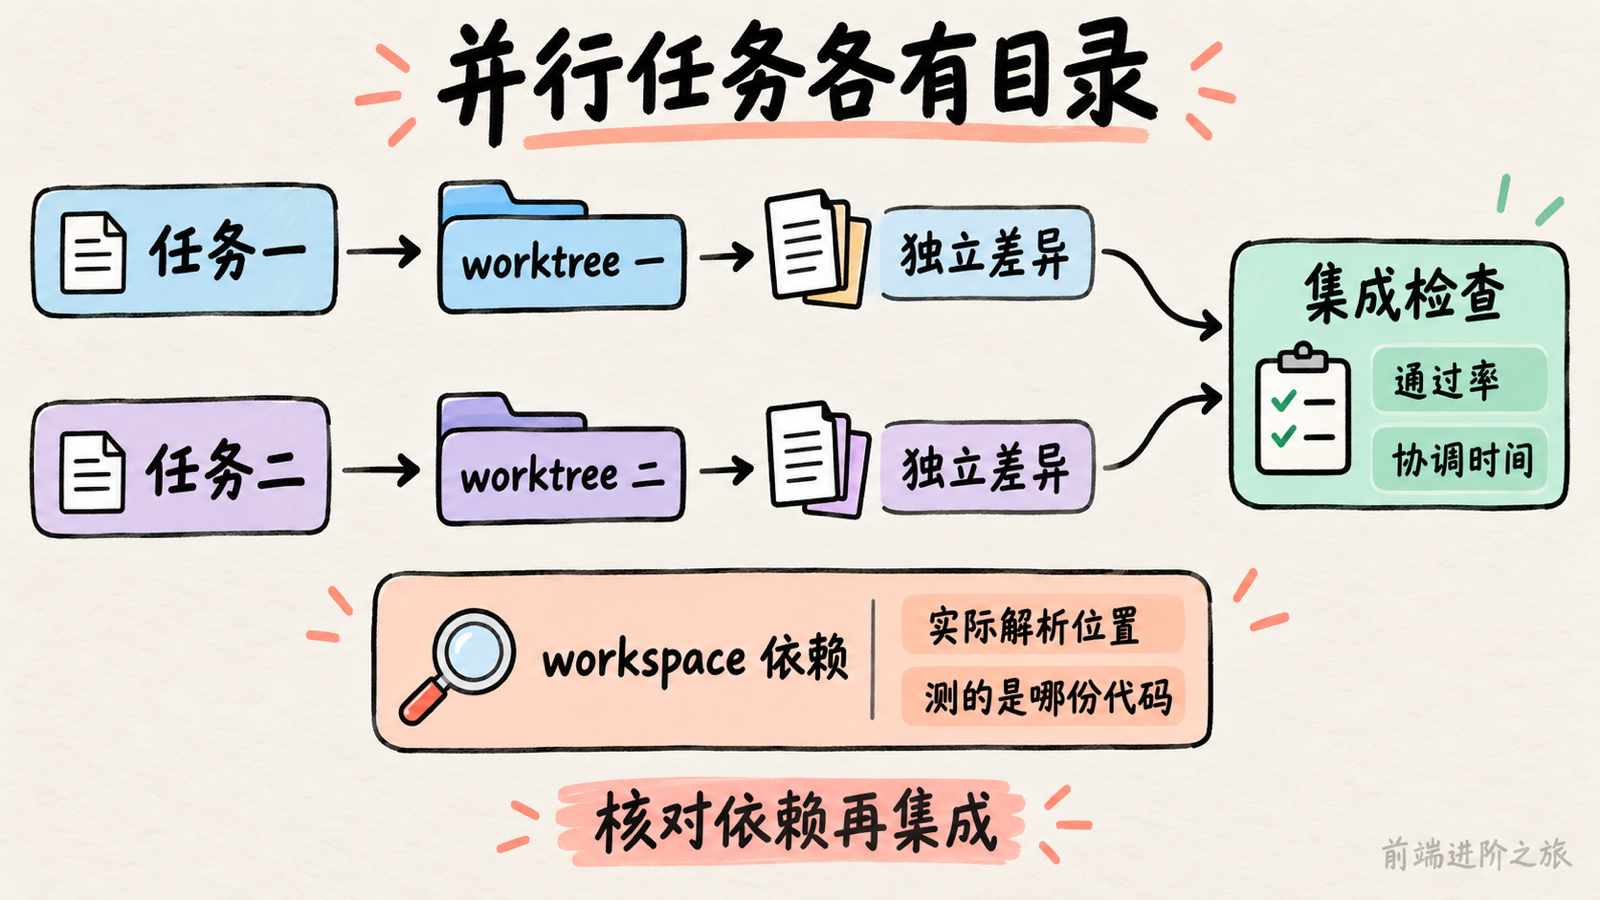
Ordewell 作者的 worktree 实践描述了共享目录下的冲突。两个会话都在同一棵工作树里改文件,即使提示词要求分工,也可能出现后一个覆盖前一个的结果,而前一个会话仍然报告任务完成。
分工约定挡不住文件覆盖。
作者采用每个任务一个 worktree、配套任务分支的方式,把工作目录隔开。这是具体产品的实现经验,不是所有多 Agent 系统都已验证过的统一方案,但它解决的问题很实在,每项任务终于可以保留独立差异,也能单独检查和撤回。
这里还有个前端熟悉的坑,依赖。
新 worktree 没有现成的 node_modules,直接把整个目录链接过来又可能出问题。文章特别提到 monorepo 的 workspace 包解析,任务工作树修改了一个包,测试却可能读到主工作树里的旧副本。
所以「测试通过」还得追问一句,测的是哪份代码?
另一条相关信号来自 Google Cloud AI Research 等团队的 RRSI。这个研究框架保持模型权重不变,允许修改提示词、工具、记忆、控制流和子 Agent,同时约束改进循环,防止反复针对同一批题调优。
报道给出的结果包括,Terminal-Bench 2.1 演化划分从 74.2% 提升到 80.2%,未用于选择的 SWE-bench Verified 从 82.0% 提升到 83.8%。这些成绩有各自的测试条件,不能直接套到团队仓库。
我更愿意借鉴它记录假设、差异、收益和成本的做法,以及删除无效组件的思路。多一个审查 Agent、多一段提示词,都应该回答自己究竟减少了哪种失败。
对技术管理者来说,并行数量不适合单独当成果。能独立审查的变更、合并后的通过率、额外协调时间,才接近交付。
可以拿两个会修改同一组件的小任务做对照,让它们分别在独立 worktree 里完成,再集成检查一次。顺手确认 workspace 依赖实际解析到哪里,这个实验比一上来铺十个 Agent 更容易看清收益和代价。
五、Agent 记住了历史,为什么还不能相信它的结论?
顺着上面聊,工作记录留下来以后,下一步自然是让 Agent 复用历史经验。
但「能检索」「能综合」「有权执行」之间,隔着好几层。
一篇 Hindsight 实践文章就记录了一个很具体的错位。作者的 README 声称维修检查使用 Reflect,实际代码却调用 Recall,再把片段交给通用 LLM 推理。界面看着能用,真正执行的路径却和文档不同。
这不证明 Recall 加 LLM 就一定差。问题在于,你得知道是谁检索、谁综合、谁给出了判断,否则出现错误时连该查哪层都不清楚。
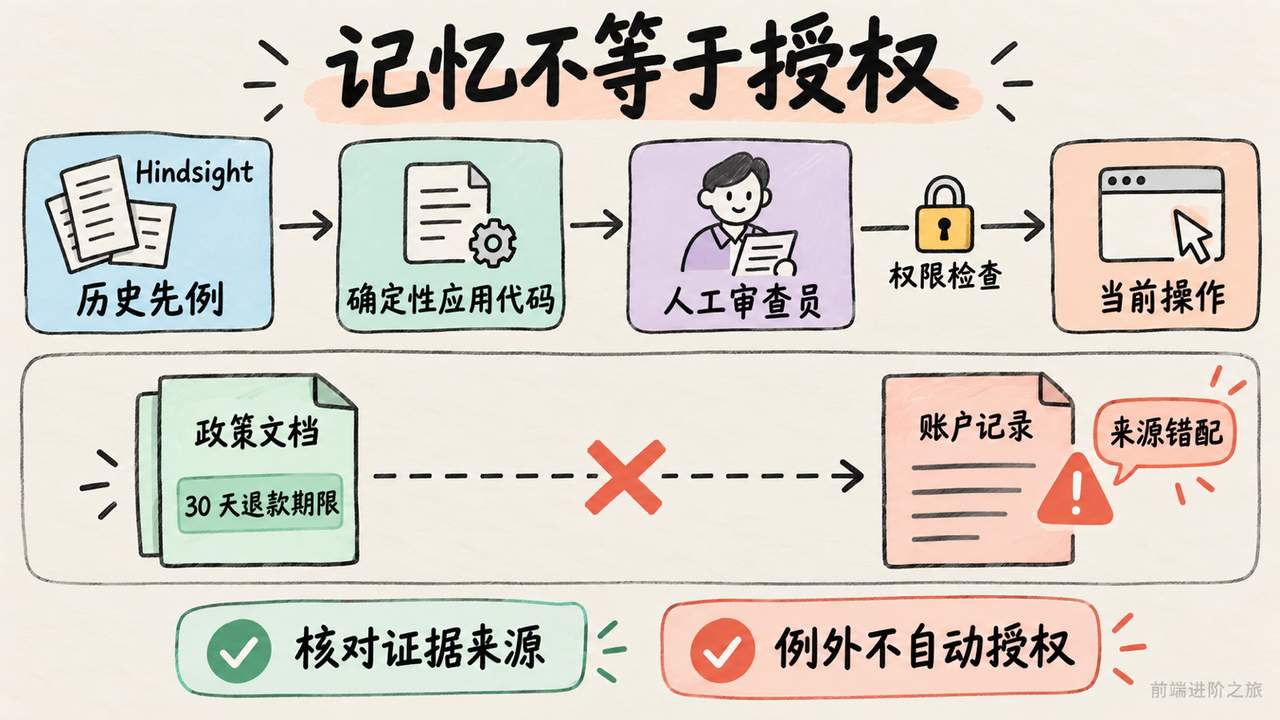
Project Arbitrage 的 Hindsight 架构给出了另一种边界。记忆层只提供历史先例,数值计算和策略检查由确定性应用代码负责,最终批准由人工审查员完成。
这个设计很适合借到业务系统里。历史上有人批准过一笔特殊退款,可以帮助理解背景,但不能变成当前用户自动获得退款权限的理由。
记住一次例外,不等于获得再次执行例外的授权。
还有一种更隐蔽的错误,事实没错,出处错了。Hugging Face 上的 ProvenanceGuard 介绍把它称为跨来源混淆。比如 30 天退款期限存在于政策文档里,Agent 却说它来自账户记录。把所有证据混起来检查,可能放过这类回答。
对于前端展示,这不只是引用按钮点错了。用户可能把一般政策误认为自己的账户承诺,接下来的操作就会基于错误理解。
下面这个最小检查,只用来发现回答声称的来源和证据记录不一致,适合放进开发阶段的故障样例。
const evidence = new Map([
  ["policy-01", { sourceId: "refund-policy" }],
]);

const claim = {
  text: "此套餐包含 30 天退款期限",
  claimedSourceId: "account-record",
  evidenceIds: ["policy-01"],
};

const sourceMatches = claim.evidenceIds.length > 0 &&
  claim.evidenceIds.every(id => {
    const item = evidence.get(id);
    return item && item.sourceId === claim.claimedSourceId;
  }); // 只检查来源一致性,不判断事实是否成立

console.assert(sourceMatches === false, "应发现来源错配");
最容易翻车的是把 sourceMatches 当成真实性判断,来源 ID 对得上,证据内容仍可能不支持那句话;这段代码也没有实现论文里的语义验证流程。
真要试,我会准备五条历史记录,故意放入同名客户、旧版政策和一次人工例外,再让 Agent 回答当前问题。看它能不能准确指出引用哪条记录、哪些条件已经变化,并确认历史内容无法绕过当前权限检查。
六、AI 响应太慢,应该换模型还是先少喂一点上下文?
大概率你也遇到过,需求没变复杂,Agent 却越聊越慢。模型在读什么,往往比参数表更值得先看。
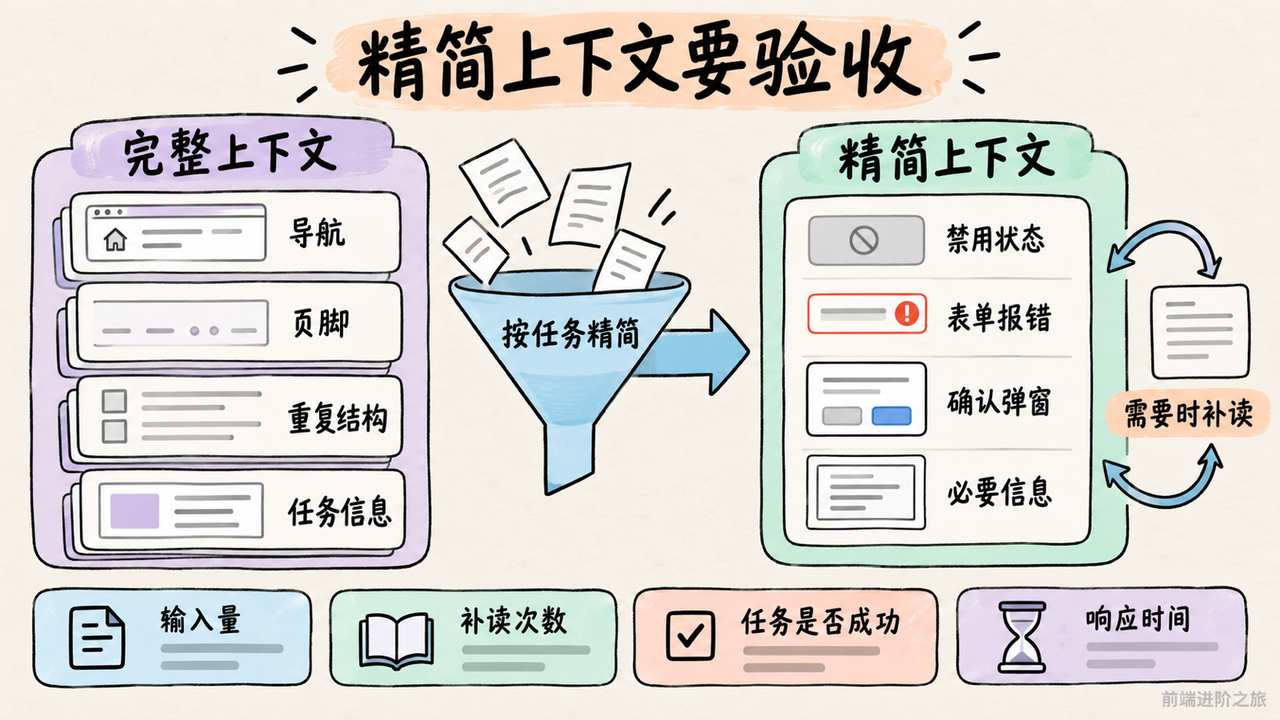
thinbrowser 作者的页面快照对比测量了五个公开页面,认为完整无障碍快照包含大量导航、页脚和重复结构,建议先提供紧凑页面描述,需要时再获取细节。
这个方向我认可,但那组数字不能照单全收。摘要给出的体积差距是 2.6 到 11 倍,摘录里的合计 token 估算却约为 128,000 对 2,900,口径看起来对不上。作者还说明 token 是按字符粗估的,页面也会变化。
所以我会把它当作一个明确的优化线索,不会拿那个倍数申请性能收益。
缩短页面描述也有代价。如果正好删掉禁用状态、表单报错或确认弹窗,省下输入费用,可能增加误操作和重试。这里真正需要的是按任务保留必要信息,并允许补读。
另一篇 8GB Mac mini 上的本地模型实践提供了硬件侧的反例。作者从约 2.3GB 权重的 4B 量化模型换到约 4.3GB 的 8B 模型后,一个简单问候请求耗时 14 秒,吞吐约 6.8 token/s,并伴随约 1.6GB 的交换读写。
这是一台设备、一套软件栈下的体验,不能推广成 8B 一定不如 4B。但它提醒得很直接,权重能装下,不代表运行时还能给上下文、工具和其他应用留出余量。
作者最终采取了限制历史消息、复用 handler、把长期记忆整理成事实等措施。对于做本地助手的程序员,这些选择比只盯着「再大一点应该更聪明」更接近产品体验。
回到页面 Agent 和本地模型这两件事,我的判断是,先把每轮输入解释清楚,再决定是否升级模型。每一段历史、每一个工具描述、每一页快照,都应该有留在当前请求里的理由。
当天就能挑一个固定任务,分别跑完整上下文和精简上下文,各重复几次,记录输入量、首轮响应时间、补读次数与任务是否成功。别只庆祝 token 降了,如果用户要多等两轮工具调用,这次精简未必划算。
总结
今天这些报道里,能落到具体细节的变化不少。Sonnet 5.5 的发布资料给出了速度、任务成本和基准成绩;Holo4 的两套权重许可证不同;DeepSeek Harness v0.2 的报道列出了插件管理和自动化任务功能。这些都是有来源的产品信息,厂商测试结果仍要带着测试条件读。
我的取舍是,模型升级可以试,但要和权限、工作目录、证据来源一起评估。业务代码最终要进仓库,自动化最终要碰数据,光看回答写得顺不顺,已经不够了。
还没被证明的也很清楚。Sonnet 能否降低你们的交付成本,Holo4 能否跑稳你们的旧后台,紧凑快照能否减少等待,都需要自己的任务来回答。本文没有把报道中的实验写成我的实测。
如果今天只能挑一件事,我会拿一个真实的小任务,把成功条件、总费用和人工返工时间记下来。下一次模型更新时,这份记录会比排行榜更有用。
参考
- Claude Sonnet 5.5 发布与基准数据|MarkTechPost
- Claude Sonnet 5.5 发布分析|The New Stack
- Ember-1 与 Kimi K3 速度对比|The New Stack
- Holo4 电脑操作模型发布|MarkTechPost
- DeepSeek Harness v0.2 预览版发布|IT之家
- Deadbugz 与 MCP 服务器审计|DEV Community
- 生产环境 AI Agent 沙箱加固|Google AI · DEV
- MCP、API 与字段级权限契约|The New Stack
- 每个任务一个 Git worktree|DEV Community
- RRSI 与 Agent Harness 自我改进|MarkTechPost
- Hindsight Recall 与 Reflect 实践|DEV Community
- Hindsight 记忆与操作权限分离|DEV Community
- ProvenanceGuard 来源感知事实验证|Hugging Face Blog
- AI Agent 读取整页的代价|DEV Community
- 8GB Mac mini 上的 4B 与 8B 模型体验|DEV Community
- 前端进阶之旅