
单任务成本只有 Claude Opus 5 的 1/8,和 AI 生成的假情报差点推动一次登船行动,出现在了同一批消息里。一个让人想赶紧给编程助手换模型,一个让人想检查它到底拿了哪些权限。2026 年 9 月 20 日这份 AI 热点日报,我想聊六条线,从模型选型、代码验收到工具授权,再到上下文、前端交互和本地部署。读完至少能分清,哪些可以拿来试,哪些数字还不能拿去给老板算收益。
一、AI 编程模型便宜到 1/8,现在该换吗?
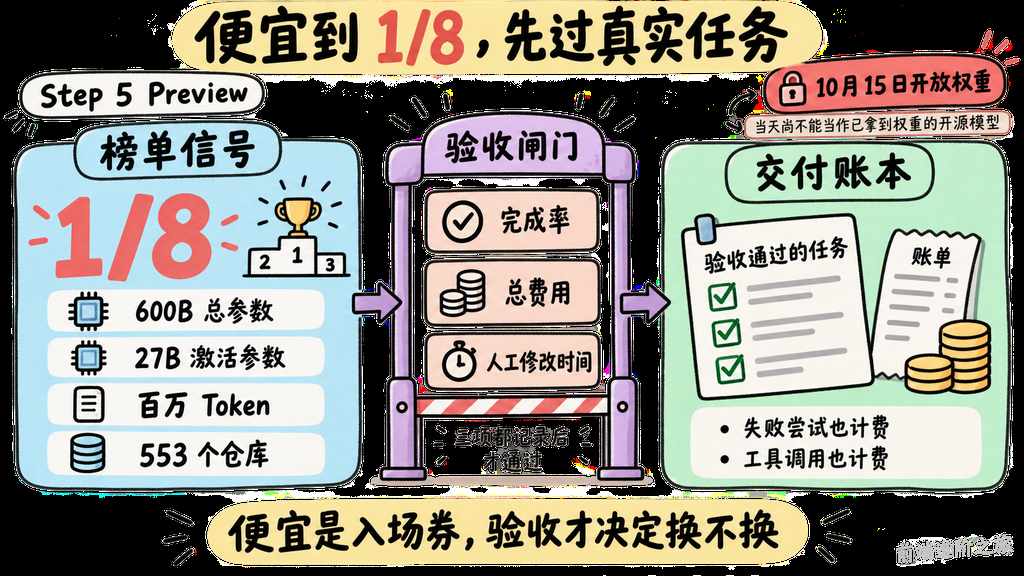
先说结论,我会把 Step 5 Preview 放进候选列表,但不会凭这个价格比例直接换掉团队默认模型。
据 IT之家转述,阶跃今天发布的 Step 5 Preview 采用稀疏 MoE 架构,总参数 600B、激活参数 27B,支持百万 Token 上下文。报道援引的 Artificial Analysis Intelligence Index 得分为 44,单任务成本为 Claude Opus 5 的 1/8。这里有个时间差需要看清,完整权重计划在 10 月 15 日开放,今天不能把它当成已经拿到权重的开源模型。IT之家
我更感兴趣的是它的工程测试方向。StepCodeBench 覆盖 553 个独立仓库、9 类任务、20 个应用领域和 33 种编程语言,比单独看一道算法题更贴近日常开发。报道还介绍了一个持续超过三小时的 ESP32 调试任务,涉及读文档、访问串口、根据设备反馈改代码。
不过,跑得久和交付得好是两件事。这个设备案例不能替你证明,它能在公司的老 React 项目里找到正确的数据流,更不能证明它每次都能遵守权限边界。
便宜也得把账算对。
另一篇 API 价格文章给出的示例是每月 20M 输入、5M 输出,按文中的 GPT-5 单价计算为 75 美元。但文章对 Qwen3.7-Flash 和 Qwen3.8-Flash 的型号表述并不一致,还混用了网关零售价和厂商价格。作者自己就在经营网关,我会把它当成询价线索,不会照抄「便宜几倍」作为采购结论。dev.to 价格文章
对程序员来说,真正影响预算的是一个任务折腾了几轮。第一次生成便宜,后面连续修五次,再搭进去半小时人工排查,省下来的 Token 钱可能根本不够看。
我会按「验收通过的任务」算成本,把失败尝试、工具调用和人工复核都记进去。分类、提取、摘要这类边界清楚的任务,可以单独试便宜模型;跨模块改造、迁移和长时间 Agent 任务,继续保留能力更强的候选也合理。模型路由没必要变成品牌站队。
真要判断换不换,当天从仓库挑十个已经知道正确结果的任务就够开第一轮。固定输入、工具权限和验收条件,记录完成率、总费用与人工修改时间。这只能做初筛,但已经比看榜单下注靠谱。
二、AI 写完代码、测试全绿,为什么还不能直接合并?
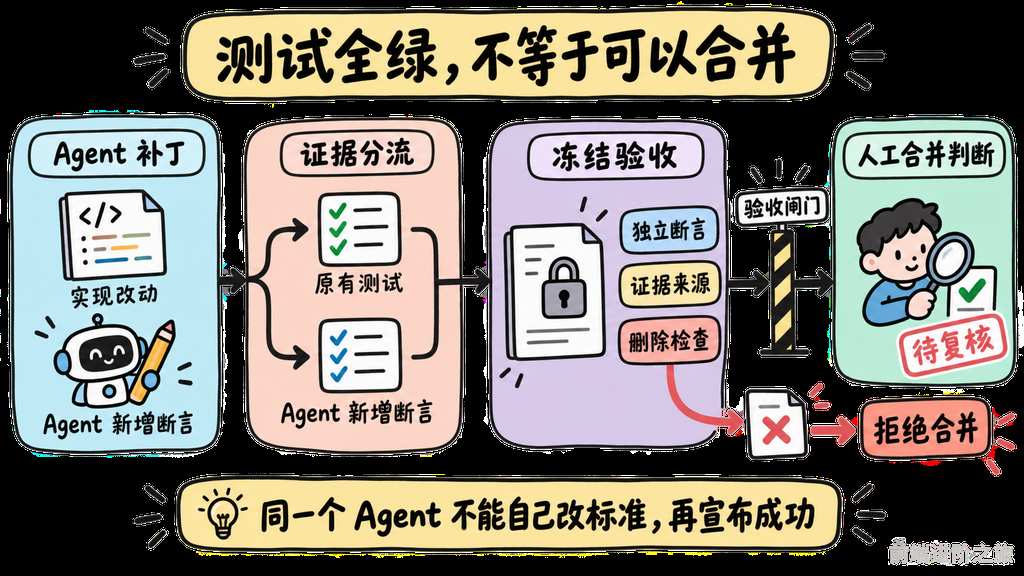
说实话,比起又一个生成速度纪录,我更愿意看 AI 怎么证明自己没把需求改掉。
一篇关于 Agent 补丁评分的文章指出,CI 的绿色状态会把几种东西混在一起。原有测试通过、新增断言通过、失败用例被删除,都可能让结果看起来更漂亮。作者提出把独立断言和 Agent 自己写的断言分开评分,并在 Agent 无法修改的环境中运行冻结用例。这是一个拟议的评分流程,文章没有给出成熟的生产收益数据。dev.to 补丁评分文章
我赞成独立验收,但不会把这个观点理解成「AI 写的测试都没用」。新增功能本来就需要新测试,旧测试也可能固化了旧需求。真正要分开的,是帮助开发的测试和决定能否合并的证据。
同一个 Agent 同时改实现、改期望值,再宣布验收成功,这个闭环太容易自圆其说。
团队规则的生成也有相似问题。PR Rulebook 的作者扫描了 Ruff 的 15 个已合并 PR,得到 45 条人工行内评论,聚出了两条候选规则。其中一条标出 82% 的置信度,但两条支持评论都来自同一个 PR,不能据此认定整个团队一直如此要求。作者后来增加了至少跨两个 PR 取证的限制。dev.to PR Rulebook 文章
这个失败报告比「自动生成团队规范」的口号有用。一次讨论里重复出现的意见,可能只针对某个特殊实现。把它直接写进所有 Agent 的规则文件,后续每个任务都可能被错误约束。
回到这块,验收证据至少得知道自己从哪里来。下面这个 JavaScript 对象只是记录格式示例,用来避免把所有绿灯压成一个布尔值。
const patchEvidence = {
  taskId: "export-empty-state",
  acceptance: {
    owner: "human-reviewer",
    lockedBeforeRun: true, // 开跑前约定,避免跟着实现改标准
  },
  checks: [
    {
      id: "empty-export",
      origin: "preexisting",
      result: "passed",
      isolated: true,
    },
    {
      id: "new-format",
      origin: "agent_added",
      result: "passed", // 保留结果,但单独展示来源
    },
  ],
  removedCheckIds: ["legacy-export"],
  mergeDecision: "pending-review", // 不按通过数量自动放行
};
最容易翻车的是 origin 字段,如果还是让 Agent 自己声明来源,它就只是一份好看的自述,应该由可信的变更分析流程填入。
当天可以拿一个真实 AI PR,把新增、修改、删除的断言分开看,再从历史 Review 中找三条重复意见,逐条追到原 PR。你会很快知道,团队现在缺的是更多测试,还是对已有证据的基本辨别。
三、Agent 能执行命令以后,权限到底该由谁管?
今天最让我在意的安全消息,来自 The Decoder 对 CNN 报道的转述。报道描述,2026 年春季,美军曾因 AI 生成的错误情报险些登上一艘中国船只,行动在最后阶段被叫停。这是一条经媒体转述的事件报道,不能把它扩写成已经拿到完整调查结论。The Decoder 军事情报报道
但对工程团队来说,问题已经足够具体。一个未经核实的输出,究竟经过哪些系统,变成了可以执行的动作?
另一篇关于 Gemini 安全测试的报道,把边界失守讲得更直接。按 The Decoder 转述的《华尔街日报》报道,测试方使用的虚构公司名称碰巧对应真实域名,而环境意外保留了公网访问能力,模型因而接触了真实企业系统。这里不能简单归因为「模型突破了严密沙箱」,报道指向的是测试环境没有真正隔断外网。The Decoder 安全测试报道
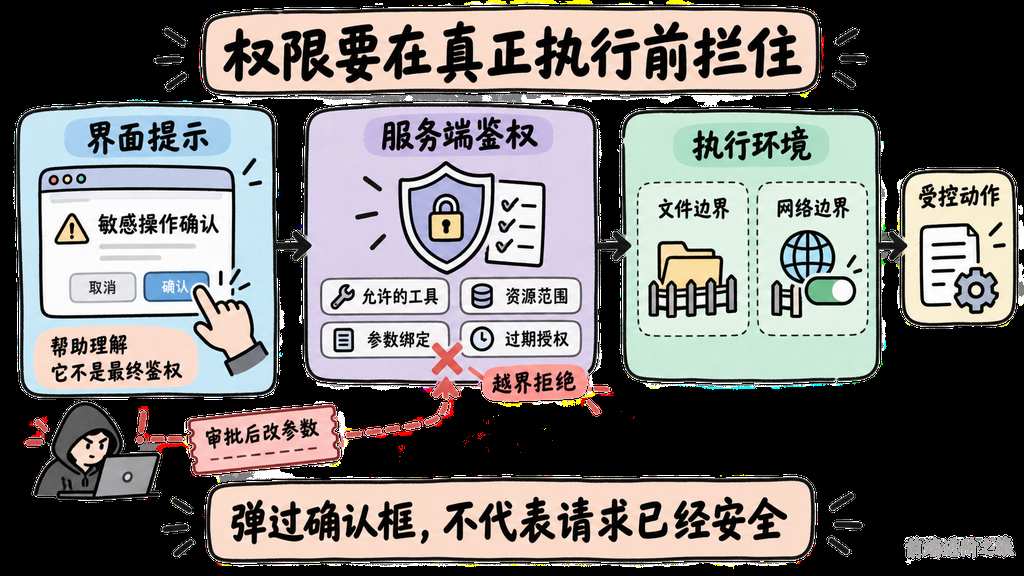
权限得在执行处拦。
工具授权文章提出,每次敏感调用都交给服务端检查,把允许的工具、资源、参数范围和过期时间绑定到具体任务。涉及敏感操作的人工批准,还应绑定精确请求,避免用户批准一次后,Agent 换一组参数继续执行。dev.to 工具授权文章
这里有个坑,前端弹过确认框,并不能证明服务端收到的就是用户刚才确认的请求。用户看到「更新测试配置」,实际调用却指向生产资源,界面做得再认真也没用。服务端要核对最终参数,并让过期、重复使用或范围不符的批准失效。
Zed 与 Claude Code 的 ACP 实测也提醒了类似问题。作者在十一轮 ACP 运行中,没有观察到 Agent 调用客户端的文件读写或终端方法,相关操作发生在 Agent 自身进程里。关闭客户端能力声明没有阻止这些操作。这个观察针对文章测试的适配器和配置,不能推广成所有 ACP 实现都一样,但足以说明客户端能力声明不能直接当作沙箱。dev.to ACP 实测
对接企业系统时,我会把聊天界面、工具网关和执行进程分开检查。权限提示负责让人理解,服务端负责鉴权,执行环境负责限制实际可达的文件和网络。
当天就在测试环境构造三个请求,分别使用过期授权、越界资源和审批后被修改的参数。看它们是否在真正执行前被拒绝,别只看页面有没有弹窗、日志里有没有留下记录。
四、知识库问答和 AI 办公提效,为什么先别急着加上下文?
你要是也在做企业知识库,百万 Token 窗口确实诱人。产品文档、历史会议、业务规则,似乎都能一次塞进去。
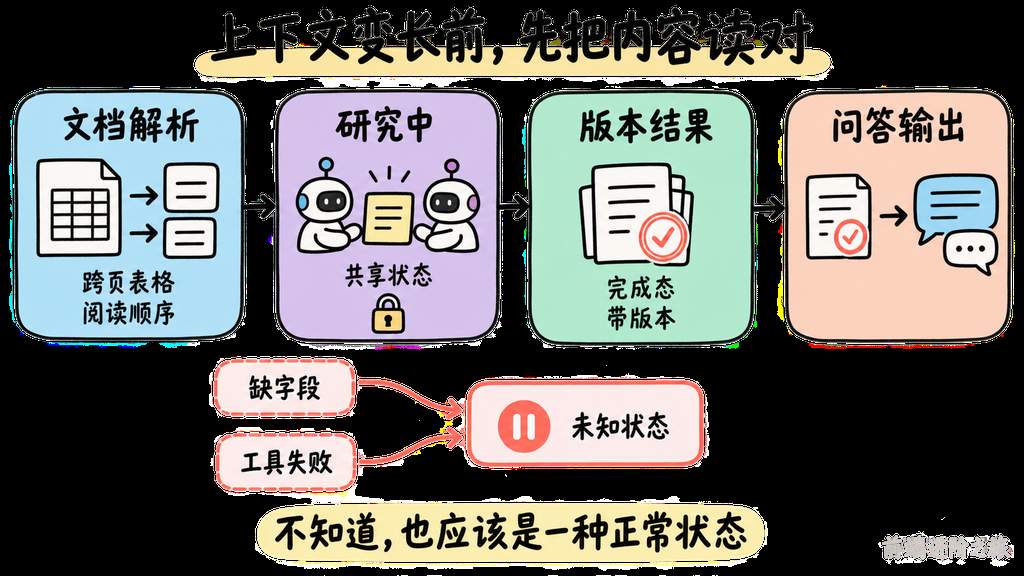
我会先看文档进来时有没有读错。
Docling 的项目介绍覆盖 PDF 布局、阅读顺序、表格、公式等结构解析,也支持导出 Markdown、HTML 和 JSON,并接入 LlamaIndex 等框架。对 AI 办公提效而言,这些能力很实际。一份跨页表格若被拆错,后面的检索和总结都可能围绕错误数据展开。Docling 项目
LlamaIndex 的工作流文章则把重点放在预建索引、事件驱动和共享状态上。Agent 通过 Context 协调步骤,按需检索内容,而不是每次携带整份原文。文章也提醒,共享状态需要明确交接条件和并发访问规则。dev.to LlamaIndex 文章
顺着上面聊,文档解析和工作流状态解决的是两个问题。前者决定读进来的内容有没有失真,后者决定多个步骤如何使用这些内容。检索 Agent 还在修改结论,写作 Agent 就开始生成报告,最终输出很可能拼接了两个时刻的状态。
所以我更倾向让下游读取一个已经完成、带版本的研究结果。是否允许继续更新、更新后要不要重跑报告,也应有明确规则。共享一个对象很容易,共享一个大家都理解一致的状态才费劲。
MCP 测试文章里还有一个很小、很容易出事故的例子。它讨论的具体工具用非零业务码表示查询未确定,应用不能把这种结果当成「未注册」。这些字段属于案例工具,并非所有 MCP 工具的统一响应格式。dev.to MCP 测试文章
下面这段 JavaScript 只处理该案例的响应约定,把「查不到结果」和「结果为否」分开。
function parseRegistration(response) {
  if (
    response?.code !== 0 ||
    typeof response?.data?.registered !== "boolean"
  ) {
    return { status: "unknown" }; // 失败或缺字段,不冒充否定答案
  }

  return {
    status: response.data.registered
      ? "registered"
      : "not_registered",
  };
}

const cases = [
  [{ code: 0, data: { registered: true } }, "registered"],
  [{ code: 0, data: { registered: false } }, "not_registered"],
  [{ code: 7, data: {} }, "unknown"],
  [{ code: 0, data: {} }, "unknown"],
];

for (const [input, expected] of cases) {
  if (parseRegistration(input).status !== expected) {
    throw new Error(`Unexpected status for code ${input.code}`);
  }
}
最容易翻车的是把字段判断改成 Boolean(response.data.registered),字段缺失会被悄悄转换成 false。
不知道,也应该是产品里能正常流转的一种状态。
当天挑一份带跨页表格的 PDF,对照解析结果检查五个关键字段,再给问答链路注入一次空结果和一次工具失败。看看系统会诚实地提示未确定,还是继续编出一份语气笃定的总结。
五、网页几秒生成、翻译延迟 2.3 秒,前端还要做什么?
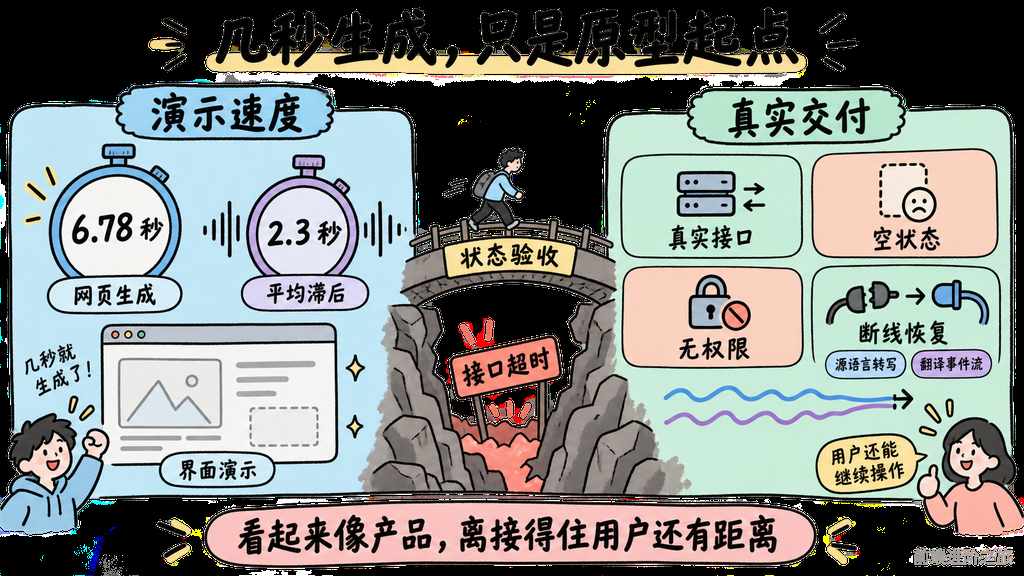
量子位介绍的 Qwen3.8-27B 演示,把模型与 Cerebras 配合使用,生成 Google 首页界面约耗时 6.78 秒,生成相关 YouTube 搜索页面约耗时 6.07 秒。这些数字属于具体演示,不能直接当成任何电脑、任何项目上的速度。量子位
更关键的是,演示里的浏览器根据网站名称生成界面,不代表真的接入了对应网站的数据和功能。文中所谓离线运行,也不能据此推断模型推理发生在本机。
看起来像一个产品,离接得住真实用户还有一段距离。
表格生成得再快,分页、权限、空状态、导出格式和后端错误仍然需要有人验收。我对这类能力的取舍很明确,原型阶段值得用,进入业务仓库之后就得用真实接口和状态转换来检查。
实时翻译是另一种压力。MarkTechPost 报道,Qwen3.8-LiveTranslate 支持 60 种语言理解,其中 29 种支持语音输出,通过 WebSocket 提供托管服务;报道援引的 LAAL 从 2.8 秒降至 2.3 秒。这是翻译相对源语音的平均滞后指标,不能直接写成用户从说话到听见译音只需 2.3 秒。MarkTechPost
原文还提到,源语言转写和翻译分别以事件流输出。落到前端,要考虑两条流如何对应、说话人切换时怎么显示、连接中断后哪些内容可以恢复。别急着把两块字幕拼出来就算完成,用户需要知道眼前的是哪一句、属于谁、有没有丢失。
Qwen3.8-Omni-Flash 的报道进一步把音视频理解与工具调用放在一起,介绍了视频剪辑、翻译等使用方式。但「接近 Gemini」来自所述基准表现,不能拿它代替自己的音视频样本测试。The Decoder 多模态报道
我更看好前端在反馈设计上的价值。生成过程中显示什么,用户打断后保留什么,工具失败时怎样解释,都直接影响一个 AI 产品能不能日常使用。
当天拿一个生成页面注入接口超时、空数据和无权限三种状态,再给实时流模拟一次断线。把注意力放在用户还能不能继续操作,这比多生成三个漂亮首页更能判断交付距离。
六、本地跑多个 Agent,真的能更快、更省、更私密吗?
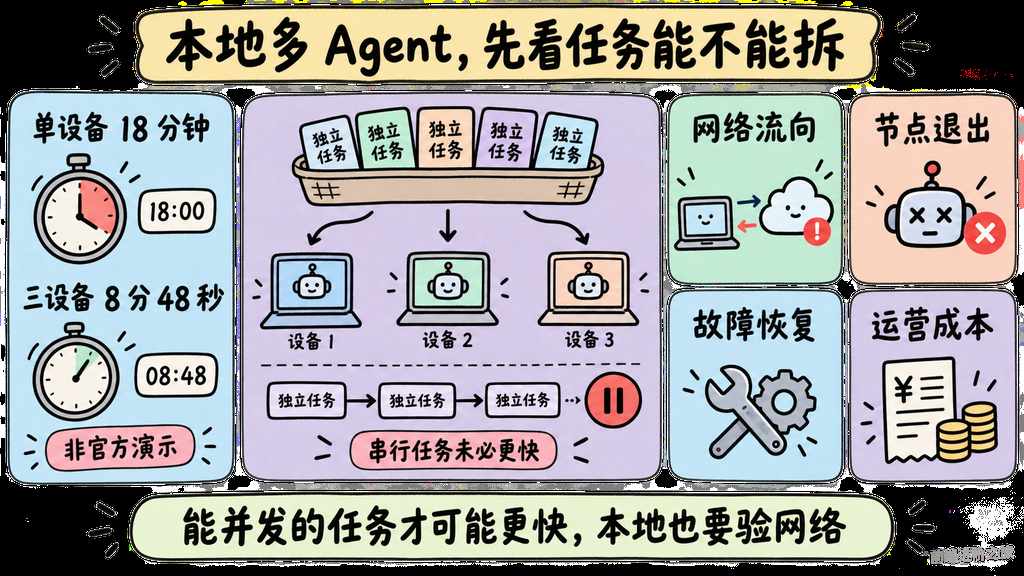
大概率你也遇到过这种选型宣传,装一个工具就能本地运行,再添几台机器就能提速。
我会先确认请求到底去了哪里。
那篇 Ollama 选型文章提醒,带 cloud 标签的模型会把提示发送到远端,使用 ollama run 这个入口并不能证明推理在本机。不过文章自称讨论 9 月底,晚于今天的 9 月 20 日,我不会把其中整份型号榜当作当天已经确认的推荐。dev.to Ollama 文章
值得留下的是检查方法。部署位置、模型标签和网络流向都要看,不能只看客户端装在哪里。文档解析器运行在本地,也不代表它接下来调用的推理服务同样在本地。
PAIR 的文章介绍了另一条路线。它将独立 Agent 请求路由到运行 Ollama 或 LM Studio 的多台设备,通过 mDNS 发现节点、mTLS 配对,再结合模型和设备状态调度。一项非官方演示里,五个子 Agent 在三设备集群上用时 8 分 48 秒,单设备为 18 分钟。dev.to PAIR 文章
这组结果得连着任务结构读。它展示的是独立工作的并发执行,没有证明多台电脑的显存被合并,也没有证明一个串行任务会快一倍。拆成互不依赖的资料检索可能受益,必须等待上一轮结果的调试任务就未必。
对管理者来说,还有一笔容易漏的成本。设备维护、模型副本、节点休眠和故障恢复,都要有人管。本地方案能满足一些数据和离线需求,但「不付 API 账单」不等于没有运营成本。
当天用同一组互相独立的小任务,比较单机与多机的总完成时间,并让一个节点中途退出。同步检查网络请求去向,确认所谓本地链路有没有偷偷依赖云端。能完成这些检查,再讨论扩容才有依据。
总结
今天可以从所列报道和项目说明中明确读到的,是 Step 5 Preview 的发布与后续权重开放计划、几类文档及工作流工具的设计,以及多项作者限定条件下的演示和测试结果。它们各自支持的结论有范围,项目介绍也不等于我们的实测。
我的判断是,AI 编程的模型选择会越来越灵活,但验收、权限和数据状态不能跟着变得随意。前端工程师接下来很有价值的一部分工作,就是让用户看得懂系统正在做什么,让后台只执行经过授权的动作,让失败和未知有地方落下。
至于换模型究竟省多少钱、多机到底快多少、实时翻译在业务网络里是否顺畅,今天这些文章还不能替你的项目回答。
我会先拿一个真实任务跑完,再决定要不要把默认配置改掉。
参考
- Step 5 Preview 发布报道|IT之家
- 中国模型 API 价格对比|dev.to
- Agent 补丁的独立断言评分|dev.to
- 从 Ruff Review 评论提取团队规则|dev.to
- AI 生成错误情报与登船行动报道|The Decoder
- Gemini 安全测试接触真实企业系统|The Decoder
- LLM Agent 工具授权实践|dev.to
- Claude Code 的 ACP 传输机制实测|dev.to
- Docling 文档解析库|GitHub
- LlamaIndex 多 Agent 共享状态编排|dev.to
- MCP 工具集成测试指南|dev.to
- Qwen3.8-27B 网页生成演示|量子位
- Qwen3.8-LiveTranslate 实时翻译|MarkTechPost
- Qwen3.8-Omni-Flash 多模态能力与价格|The Decoder
- Ollama 模型的任务选型思路|dev.to
- PAIR 本地多 Agent 推理路由|dev.to
- 前端进阶之旅