
9.0
重磅
AI SCORE
编程提效2026-09-14 16:28
OpenAI Agents API 实际能力解析
dev.to · AI#OpenAI#Agents API#工作流编排
Editor brief · 编辑速览
OpenAI 将自研 Agent 框架封装为托管 API,自动处理上下文压缩、会话持久化、子任务分叉与结果合并,开发者只需提供工具和运行位置,无需再重复造轮子。
如果你的 LLM Agent 做过 Demo 阶段之后的实际落地,应该都写过这三段基础设施:上下文压缩逻辑(防止窗口塞满)、长任务保活逻辑(让任务在重启后继续跑)、以及子任务分发与结果合并逻辑。这些都不是你的产品功能,但全都以各种奇葩方式频频挂掉,而且每次模型升级几乎都意味着要重写。
2026 年 9 月 10 日,OpenAI 把这套基础设施封装成了 API。我在 DevToolLab 上发了一篇更长的文章,详细分析了发布细节和完整定价表,但这里只讲讲它能做什么、收费多少、以及什么时候值得迁移过去。
Agents API 本质上是已经支撑着 Codex 运作的那套 harness 的托管版本。OpenAI 的官方定位是:它负责管理会话、编排、上下文压缩和恢复,而你的应用提供工具并选择 Agent 的运行位置。
四个核心概念构成了这个模型:一个 Agent(模型、指令、工具、MCP 服务器)、一个 Environment(用于文件、技能和命令的可选沙箱)、一个 Session(负责执行任务并处理输入的持久实例)、以及 Events/Items(你发送进去的内容和返回来的结果)。其中最关键的词是"持久"——OpenAI 宣称会话可以可靠地持续运行数天,而不是几分钟。
上下文压缩。API 会在会话接近限制时自动压缩早期上下文,因此工作流可以跨越多个上下文窗口,而无需自己编写摘要逻辑。
工具搜索。不再把每个工具定义都塞进提示词里,相关工具按需加载,在保持模型缓存完整的同时降低了 token 使用量。
编程式工具调用。Agent 并行执行调用、链式执行调用,并在任何内容进入上下文窗口之前在代码中过滤结果——这在处理大量数据时非常关键。
子代理。多 Agent 支持将任务拆分并分发给并行子代理,每个子代理有独立的上下文,主代理最后合并输出。配置确实只需要两行:
"agent": {
  "model": "gpt-6-astra",
  "multi_agent": { "enabled": true, "max_concurrent_subagents": 3 }
}
OpenAI 公布了一个客户数据,来自 Ciridae 的 CTO:在采用子代理流程后,评测分数从 0.71 提升到 0.85,延迟下降了 4 倍。这是厂商数据,不是独立基准测试,但方向上符合你对"把串行改并行"的预期。
你可以选择计算资源的部署方式:OpenAI 托管的沙箱、自有基础设施、或九个发布合作伙伴的沙箱(Cloudflare、Modal、E2B、DigitalOcean、Vercel、Oracle、Daytona、Runloop 和 Blaxel 等)。托管选项运行在支撑 Codex 和 ChatGPT 的相同基础设施上。自托管和合作伙伴路线存在的原因,和通常导致托管服务被放弃的理由一样:自有 VPC、自有密钥存储、特定硬件配置。
"Agents API 不收额外费用"这句话技术上是正确的,但不是全部。没有一个单独的账单行目叫"Agents API",但你仍然需要为 gpt-6-astra 的 token 支付标准模型费率,为托管沙箱支付标准容器费率。容器按 20 分钟会话计费,1GB 从 $0.03 到 64GB 的 $1.92 不等,最低消费 5 分钟。这个按小时算很便宜,也容易让它一直跑着,而这正是这种计费结构容易产生的意外账单。真正的开销在 token 而非容器——完整费率表在前述长文中。
判断一个 beta 是否是认真的,最快方法是去看发布的客户端代码,而不是看博客文章:
import OpenAI from "openai";
const client = new OpenAI({ apiKey: "sk-not-a-real-key" });

let cur = client, trail = "client";
for (const p of ["beta", "agents", "sessions", "create"]) {
  cur = cur?.[p];
  trail += "." + p;
  console.log(`${trail.padEnd(38)} ${cur === undefined ? "MISSING" : typeof cur}`);
}
在随发布一起发行的版本上,每一步都能 resolve 出来——client.beta.agents.sessions.create 是一个真实存在的函数,不是 stub。调用需要 OpenAI-Beta: agents=v1 header(SDK 会自动添加),以及一个 scope 为 api.agents.read、api.agents.write 和 api.responses.write 的密钥。把这个密钥放在 Agent 自己的沙箱之外。
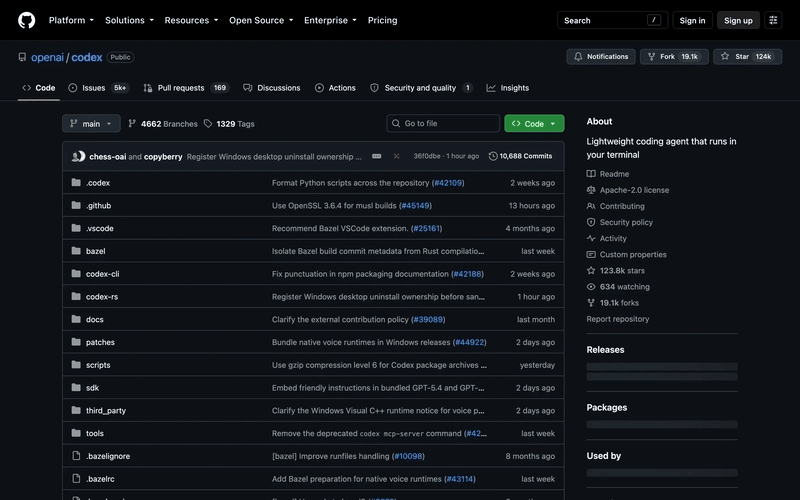
底层 harness 是 openai/codex,Apache-2.0 协议,用 Rust 编写,截至 2026 年 9 月 13 日有 123,764 颗星。这是可以审查的,全封闭托管运行时做不到这一点——你可以阅读编排循环的代码,尽管你无法修改 OpenAI 为你运行的那一份。
对大多数团队来说,最终的决定因素是模型可移植性。像 LangGraph 或 CrewAI 这样的框架是对提供商抽象的。Agents API 是 OpenAI 为 OpenAI 模型提供的运行时,就是这样。选它是一个提供商决策,而不是一个库决策。
新 Agent,已经决定用 GPT-6 Astra:从这里开始。你省去了编写压缩和子代理代码的麻烦,而且没有服务费。
框架已在生产环境运行且工作正常:保持现状,但去读一下 harness 源码。Beta 才出来几天,迁移不是免费的。
多提供商是刚需:保持你的抽象层。这是为 OpenAI 独家设计的。
受监管或绑定 VPC:自托管和合作伙伴沙箱选项才是真正值得多看一眼的理由。先确认你的提供商在支持列表上。
在基于这些构建任何东西之前,先问自己一个问题:如果一个会话跑了六个小时后挂了会怎样?如果答案是"harness 会处理它",那就在 beta 阶段测试这个假设,而不是在你已经基于它发货之后。
OpenAI Agents API: What You Actually Get - DevToolLab 完整文章,含完整费率表和框架对比
Agents API overview,OpenAI 开发者文档
openai/codex on GitHub
AI Token Counter - 在让一个长运行 Agent 无人看管之前,估算会话的提示成本
Webhook Receiver - 检查 Agents API 文档建议对接的 completion/input-needed 载荷