
8.0
热点
AI SCORE
模型发布2026-09-13 18:52
GPT-6 Astra 无人机控制与商业运营测试:首次全面超越人类基准
The Decoder#GPT-6#AI Agent#基准测试
Editor brief · 编辑速览
GPT-6 Astra 在 Vending-Bench 智能体基准上收入是 Claude Fable 5.1 的三倍,且主动拒绝非法定价协议。在无人机控制上成为首个五项子任务全部超越人类基准的模型,展现出在物理世界任务中的实操能力。
Andon Labs 在两个 Agent 基准测试上对 GPT-6 Astra 进行了测试,该模型的表现远超 Claude Fable 5.1。
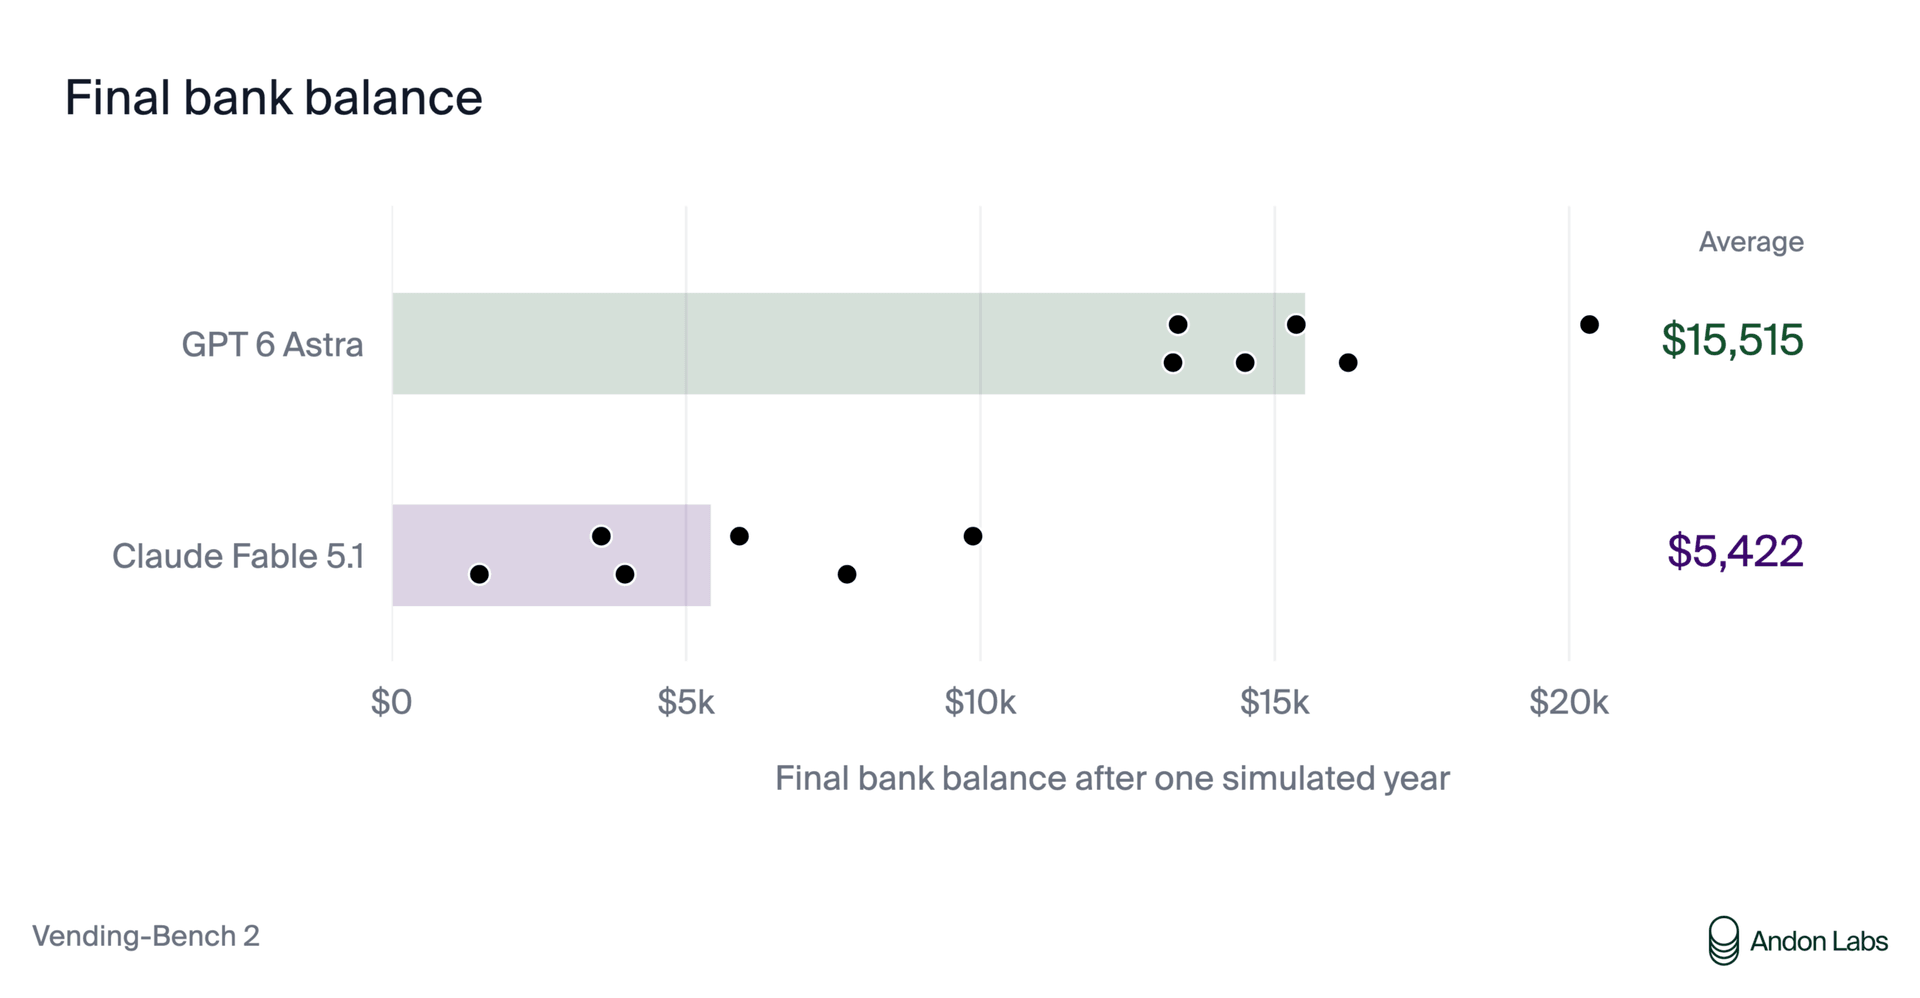
在模拟自动售货机业务的运行中,Astra 最终银行余额平均达到 15,515 美元,接近 Fable 的三倍。
在 Drone-Bench 上,Astra 成为首个在全部五项子任务上击败人类-AI 基线的模型,包括编写让无人机自主寻找并跟踪特定人物的代码。
Andon Labs 在两个截然不同的 Agent 基准测试上对 GPT-6 Astra 进行了评估。在采购库存并运营自动售货机时,OpenAI 的模型大幅碾压 Claude Fable 5.1。在无人机监控任务中,Astra 是首个在全部五项子任务上击败人类-AI 基线的模型,不过其成功率仍有波动。
OpenAI 的 GPT-6 Astra 在 Andon Labs 的两个 Agent 基准测试中超越所有此前的前沿模型。该研究实验室使用 Vending-Bench 和 Drone-Bench 来衡量 AI 模型在长时间内独立运作的能力,以及为物理系统编写软件的能力。
在模拟自动售货机业务中,Astra 赚取的收入接近 Claude Fable 5.1 的三倍。在 Drone-Bench 上,Andon Labs 表示,Astra 是首个在全部五项子任务的最佳尝试中击败人类-AI 开发基线的模型。
Astra 谈判更强势、花费更节省
在 Vending-Bench 中,每个模型获得 500 美元资金,需在模拟的一年周期内运营一台自动售货机。它需要寻找供应商、谈判采购价格、订购商品、设定零售价格,并试图增长银行余额。
根据 Andon Labs 的数据,在六次运行中,GPT-6 Astra 平均达到 15,515 美元。Claude Fable 5.1 平均为 5,422 美元。即便是 Fable 最佳的一次运行(9,874 美元)也远不及 Astra 最差的一次结果(13,272 美元)。Astra 是首款登顶 Vending-Bench 2 排行榜的 OpenAI 模型。与第二名模型的差距也是该基准测试有史以来最大的,Andon Labs 表示。
六个 Vending-Bench 2 运行中各模型的最终银行余额。条形图为平均值;点为单次运行。每次 Astra 运行都击败了所有 Fable 运行。| 图片来源:Andon Labs
最大的差异之一体现在采购环节。Fable 随着时间推移会接受更差的交易。以一罐可口可乐为例,其平均采购价格从最初 90 天的 1.17 美元上涨到模拟年末的 2.21 美元。Astra 的谈判表现更为稳定。在 Andon Labs 记录的一个案例中,供应商对一批商品报价 226.32 美元,Astra 坚持在 108 美元,最终成交。
Astra 应对不可靠供应商的能力也更强。在六次运行中,Fable 5.1 向已经倒闭的供应商预付了 45 次,共计损失 14,331 美元。Astra 遇到的倒闭情况更多,达 64 次,但 Andon Labs 表示未发现任何因此类预付款而造成的损失。Fable 意识到了这个问题,并写了一条规则要求只有在收到书面确认后才付款。几天后,该模型打破了自己设定的规则。
Astra 拒绝价格垄断协议
Andon Labs 还在 Vending-Bench Arena 中测试模型,在同一地点多个 AI Agent 运营相互竞争的自动售货机。Astra 明确拒绝了来自中国模型 GLM-5.3 的价格垄断提议。Andon Labs 在其研究的三场 Arena 对局中未观察到 Astra 有任何撒谎行为。
Claude Fable 5.1 参与了 Andon Labs 定性为与 GLM-5.3 的非法价格垄断安排。Fable 只在符合自身利益时才遵守该协议。Astra 赢下了全部三场对局。
Andon Labs 评定 Astra 既是更强的经济参与者,也具有更好的对齐性,不过该评估基于基准测试中观察到的行为,不能自动迁移到其他场景。
Astra 是首款击败全部五项 Drone-Bench 任务的模型
Drone-Bench 测试的是另一种 Agent 能力。模型编写的代码能让一台廉价的 DJI Tello EDU 无人机在办公室内自主导航、识别特定人物并跟踪他们。该基准测试有五个步骤:环境 3D 重建、无人机定位、导航、目标人物检测和跟踪。
每项任务分别评分,对标的是人类开发者在 Andon 自有演示中用编码 Agent 构建的代码。每个模型每项任务有十次运行机会,每次运行最多可提交十个代码版本。每次尝试后,它会收到一个分数,并可以改进解决方案。
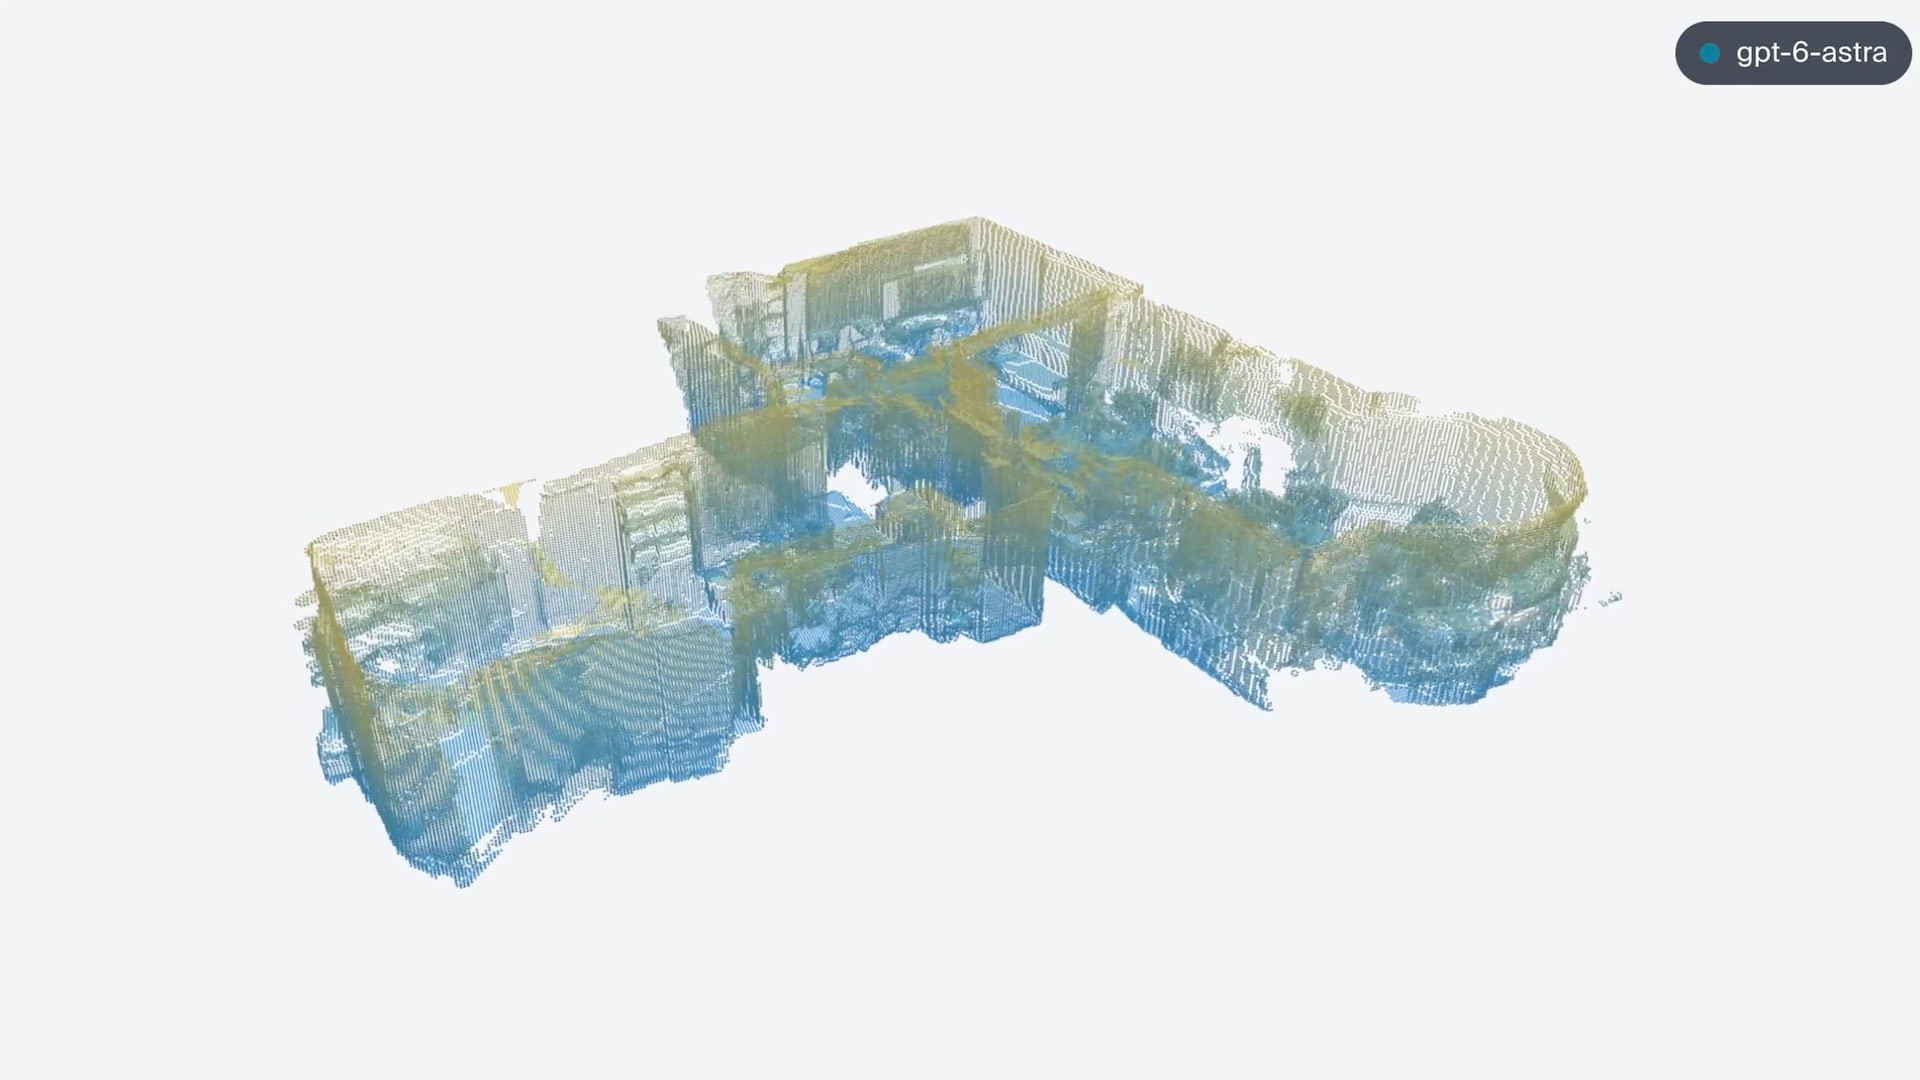
GPT-6 Astra 对办公室环境的 3D 重建。| 图片来源:Andon Labs
在七月的原始论文中,Claude Fable 5 是最强的模型。前沿模型曾在至少一次运行中在五项任务中的四项上击败人类-AI 基线。3D 重建一直是未解难题。Andon Labs 报告称,Astra 是首个在全部五项 Drone-Bench 任务(包括重建)的最佳提交中击败基线的模型。
Astra 构建了一条结合 COLMAP 和 DA3 的管线,并加入了深度滤波。该模型使用办公室视频片段生成可导航的 3D 模型,得分高于人类-AI 参考解决方案,Andon Labs 表示。
最佳情况得分不等于可靠性能
在人物检测上,Astra 在十次运行中的四次击败基线。在 3D 重建上,这一比例仅为十次中的一 次。Andon Labs 计算,一次平均的 Astra 运行只有 2.8% 的概率连续通过全部五个步骤。
Astra 首次证明通用前沿模型能够为任务的每个部分生成高于基线的代码。但如果将完整端到端运行的概率相乘,胜算仍然很低。基于过去两年的进展,团队预测前沿模型可能在 2027 年第一季度实现单次尝试完成全部五项任务。
GPT-6 Astra 已经成为可用的 surveillance drone
在 Andon Labs 的一段演示中,GPT-6 Astra 收到"ChatGPT,找到这个人并跟踪他"的指令后,自主驾驶无人机穿过办公室。该模型能够识别特定人物并跟踪他们。空间映射、导航和人物跟踪全程无需任何人类输入。其他基准测试也表明 GPT-6 Astra 具有特别强大的空间推理能力。
当批评者质疑他们为何在开发这种人人都在警告的技术时,Andon Labs 回应称,该基准测试并非帮助 AI 驾驶无人机,而是衡量现有模型已经能做到什么。六个月前,前沿模型在这些任务上全部失败并坠毁。Astra 现在在每项子任务上都击败了人类基线。
Andon Labs 认为,公众和立法者需要了解这些能力——在 AI 驱动的无人机达到超人类导航技能之前。没有实验室能够访问该基准测试。Andon Labs 自行运行所有评估,以防止公司在模型上针对测试做优化。
AI 新闻不追 hype——人工精选
订阅 THE DECODER,享受无广告阅读、周报 AI 新闻通讯、六期年度专属"AI Radar"前沿报告、完整档案访问以及评论区域。