
8.0
热点
AI SCORE
开源项目2026-09-13 20:58
Iris-mini/pro:开源权重搜索 Agent 登顶同类榜首
The Decoder#开源#搜索Agent#Qwen
Editor brief · 编辑速览
基于 Qwen 的两款开源搜索 Agent 在同量级开源模型中 benchmark 领先,且训练数据使其具备通用工具调用和办公任务泛化能力。
AllSpark 团队发布了 Iris-mini 和 Iris-pro 两款开源搜索 Agent,以及一套完整的训练配方。论文显示,训练数据和模型在未针对的任务上也表现出提升,包括通用工具使用和办公工作。
基于语言模型的搜索 Agent 能够自主研究网络。它们需要理解问题、决定搜索什么、解析结果,并判断何时已收集到足够证据来回答问题。关于模型实际完成多少这类工作,业内存在争议。在现有基准测试中,这类 AI 系统主要利用网络来确认其在训练期间已习得的知识。
在一篇新论文中,中国实验室 AllSpark 描述了两款不同规模的搜索 Agent。Iris-mini 拥有 35 亿参数,Iris-pro 拥有 3970 亿参数。两者均基于 Qwen 系列模型(Qwen3.6-35B-A3B 和 Qwen3.5-397B-A17B),支持 256,000 个 Token 的上下文窗口,并在各自尺寸级别中取得了开源权重搜索 Agent 中的最强成绩,据该团队称。
训练流程从网页的链接结构出发逆向构建任务。从一个种子页面及其出链出发,构建一个术语和关系的图谱。再从这个图谱生成多步骤问题,其答案需要将多个关联步骤串联起来。
除最终答案外的每个术语都被替换为释义版本,因此无法通过简单文本搜索获取线索。Agent 必须进行推理,而非仅仅是查找。只有那些参考模型无法不借助工具但能凭借正确来源解决的问题才会进入数据集。这保证了任务既有难度又可清晰验证。
更强的教师模型生成由推理、搜索查询和结果组成的解答路径。这些路径经过两轮过滤。第一轮检查完整路径的正确性、重复循环和搜索深度。第二轮由裁判模型逐步审查,其标准是从数据本身衍生而来,而非人工设定,据论文称。
此后,模型通过强化学习针对实时网络搜索进行改进。裁判模型和结果摘要运行在训练集群内部,由团队自有的大型 Qwen 模型驱动,因此训练不依赖外部服务。监督微调和强化学习交替进行,作者将这一过程称为「SFT-RL 攀升」。每轮中最难解决的任务和最高效的解答路径会反馈到下一个训练周期。
该团队认为,在常见基准测试上,运行时的上下文管理往往比系统间报告的差距产生更大影响。在长时间的搜索会话中,上下文在 Agent 解决所有子问题之前就可能填满。像丢弃对话历史这类技巧会人为延长搜索时间,但并不能说明模型的真实质量。
为隔离这种效应,团队在保持工具、上下文限制和裁判模型不变的情况下,对每个基准测试分别测试开启和关闭上下文管理的结果。仅在开启管理时报告的结果无法干净地拆分出哪些来自模型本身、哪些来自其周围的脚手架。Iris 的分数也来自单一 Agent,没有辅助 Agent,也没有末尾的额外验证步骤。
测试涵盖 BrowseComp——测试从间接线索中查找冷僻事实的能力,其对应中文版 BrowseComp-ZH,DeepSearchQA——评估检索证据的完整性,以及 Humanity's Last Exam——提出专家级别的学术问题。
开启上下文管理后,据论文数据,Iris-mini 的得分分别为 82.2、84.8、86.9 和 52.3。Iris-pro 达到 88.6、85.1、92.9 和 56.4。在较小尺寸级别中,Iris-mini 在四个基准中的三个领先,并在 BrowseComp 上以 3.4 分的优势击败次优模型 XYZ-Aquila-mini,尽管在 DeepSearchQA 上落后。Iris-pro 在较大尺寸级别中领先或持平,有时甚至逼近需要多得多的计算资源的系统,据作者称。
Iris-mini 在四个基准中的三个领先,仅在 DeepSearchQA 上落后于 XYZ-Aquila-mini。| 图片来源:AllSpark 团队
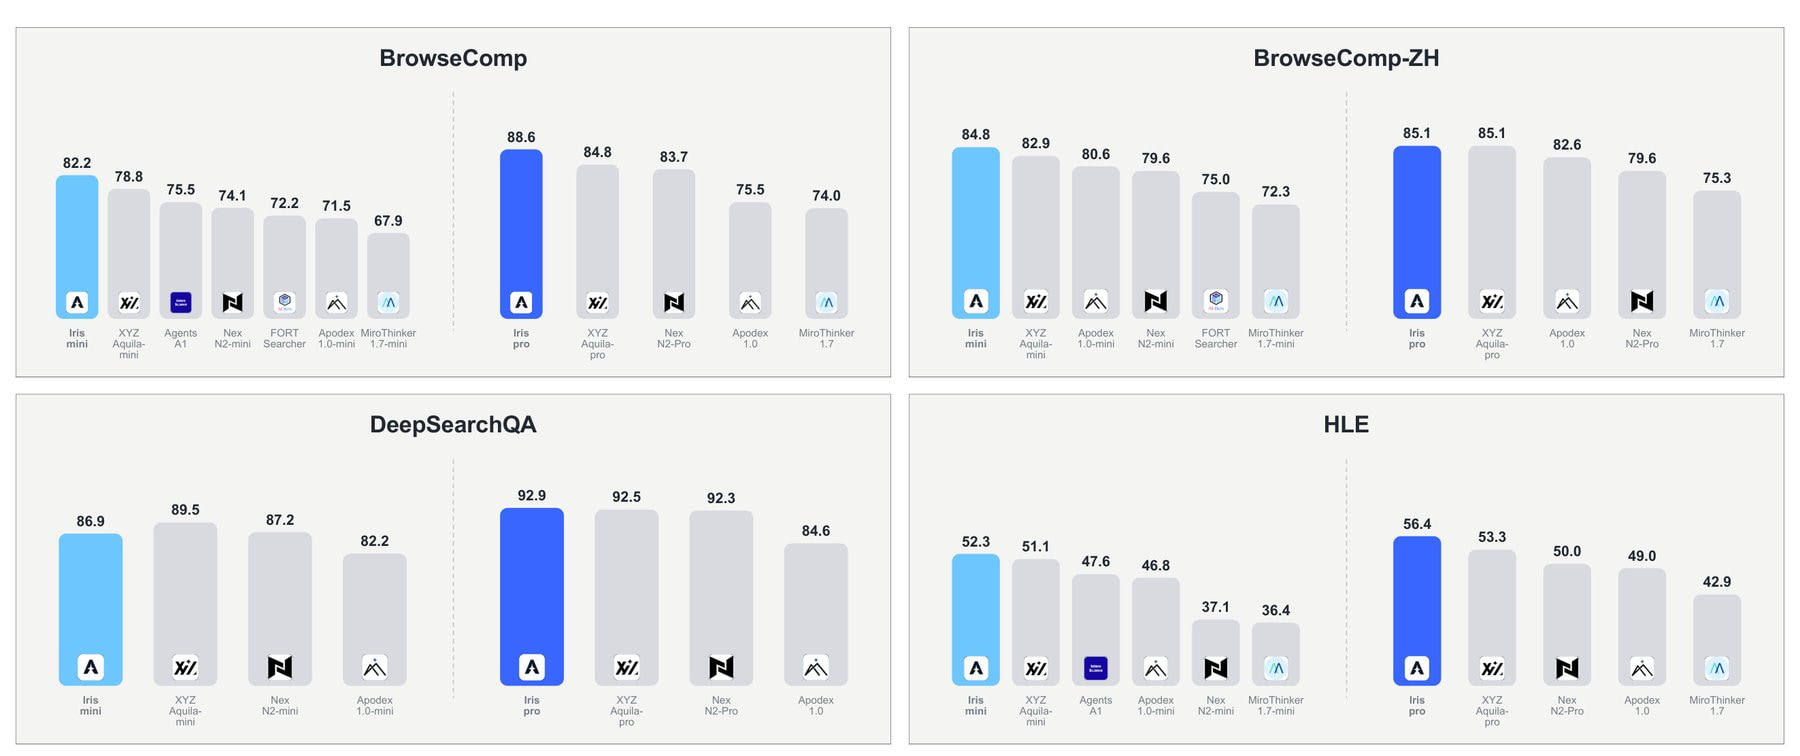
上下文管理对较小模型的影响要大得多,将 BrowseComp 分数最多提升 21.2 分。原因不是更小的 Token 预算,而是更快的消耗,据论文称。Iris-mini 处理相同任务需要更多步骤,因此更频繁地触及上下文限制。
在 Humanity's Last Exam 上,提升幅度较小,因为该基准更侧重领域知识和学术推理,网络搜索在其中扮演辅助角色。最佳分数来自结合历史丢弃和第二次尝试。如果第一次尝试失败,系统会将其压缩成一条简短笔记,记录已检查并排除的内容。该笔记会被附加到下一次运行的任务中。
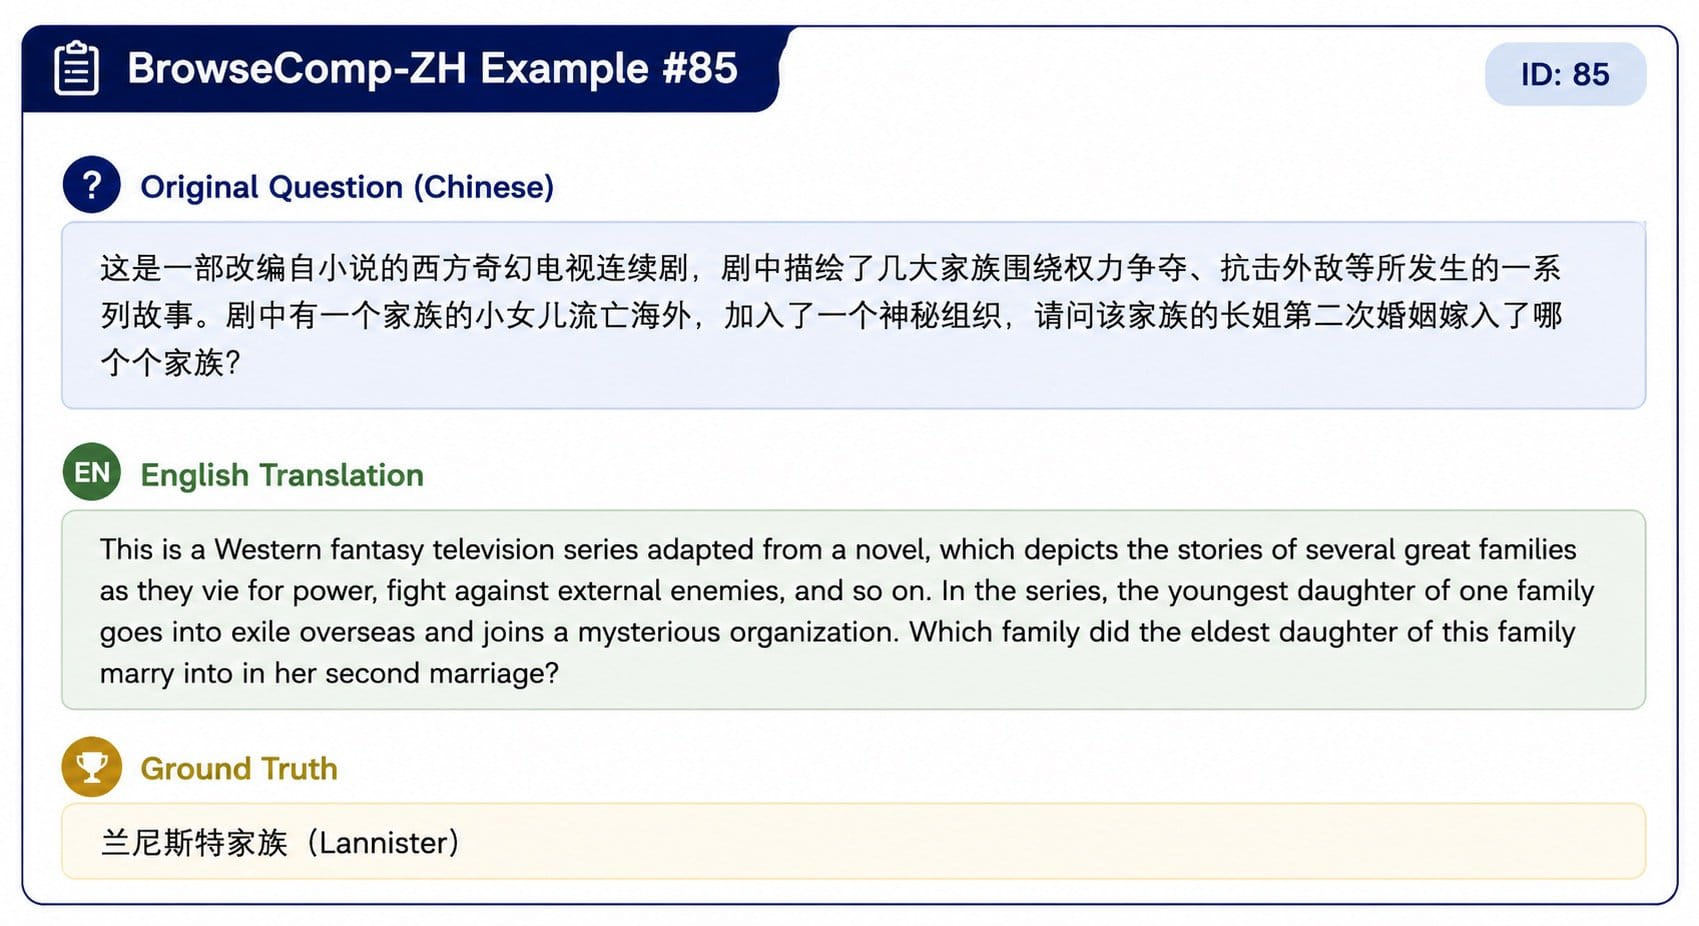
在论文附录中,团队描述了一个案例:其 Agent 的答案有来源依据,却被标记为错误。BrowseComp-ZH 中有一个问题针对《权力的游戏》系列。Agent 回答了「Bolton」,但标准答案是「Lannister」。相关角色 Sansa Stark 在第二次婚姻中确实嫁给了 Ramsay Bolton。Agent 的答案是正确的。团队表示,这类标准答案与来源材料之间的矛盾促使他们构建更优质的基准测试。
Agent 回答了「Bolton」却被标记为错误,尽管 Sansa Stark 在第二次婚姻中嫁给了 Ramsay Bolton。| 图片来源:AllSpark 团队
除了搜索,作者还报告了一个意外副作用。生成的训练数据和专用模型在从未训练过的任务上也提升了表现,包括通用工具使用和办公工作。团队认为,搜索可能更多充当一种基础技能而非狭窄的专业能力,因为学到的行为有助于 Agent 处理不完整信息的任何场景。
Iris-mini 和 Iris-pro 的模型权重已在 Hugging Face 上以合集形式发布,代码在 GitHub 上。目前发布的包括 Iris Harness——包含 Agent 循环、工具、上下文管理策略,以及全部四个基准测试及其评估。Harness 可对接任何 OpenAI 兼容端点。团队计划稍后发布数据构建和训练流程。