
9.0
重磅
AI SCORE
模型发布2026-09-14 16:29
GPT-6 Astra 真实成本与安全风险全面剖析
dev.to · AI#OpenAI#GPT-6#API定价
Editor brief · 编辑速览
GPT-6 Astra 输入每百万 token 10美元、输出50美元,超长上下文(>27万token)价格翻倍;系统卡将其列为公司史上最高网络安全风险等级,存在实质性安全顾虑。
在过往几年,评估一款新旗舰模型的方式很简单:扫一眼基准排行榜就能交差。这套方法在 2026 年 9 月 3 日彻底失效——OpenAI 发布了 GPT-6 Astra,宣称它是迈向 AGI 的合理一步,同时公开了一份 system card,将其列为公司有史以来给出的最高网络安全风险等级。
如果你正在考虑是否将生产流量接入这款模型,以上两点都值得关注。我把模型页面、定价表和 system card 全部过了一遍,写了一份完整分析发布在 DevToolLab 上。以下是精简版,从最可能在账单里不请自来的那个部分开始。
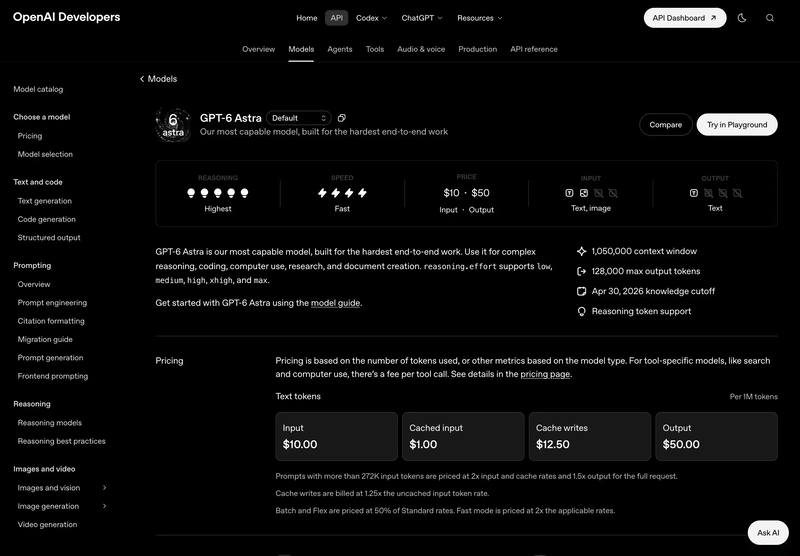
Astra 的标称费率是每百万输入 tokens 10 美元、每百万输出 tokens 50 美元,数据来源为 2026 年 9 月 13 日的 OpenAI 定价页。缓存输入降至每百万 1 美元。向缓存写入的费用是 12.50 美元,是未缓存输入费率的 1.25 倍。Batch 和 Flex 模式将输入输出费率同时减半,Fast 模式则将两者翻倍。
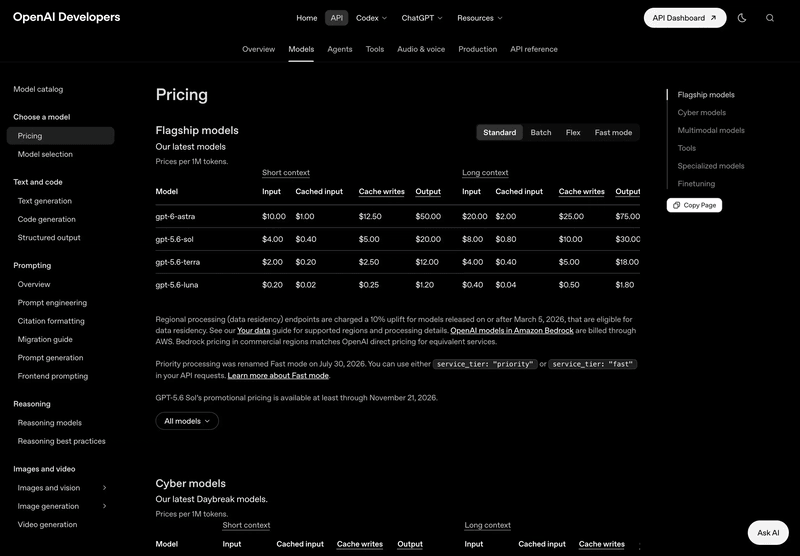
然后还有一层很容易被忽略的定价。单次请求的输入 tokens 超过 272,000 时,就会进入长上下文计费:每百万输入 20 美元、每百万输出 75 美元。值得牢记的细节是,高费率适用于整个请求,而非仅仅超过临界点的那部分 tokens。没有渐进过渡。271,000 tokens 的 prompt 和 273,000 tokens 的 prompt 会被收取完全不同的费率。
以一个具体的工作负载为例:100 次代码审查调用,每次发送 42,000 输入 tokens、返回 1,500 输出 tokens:
no caching:        $49.50
with prompt cache: $29.70   (40% cheaper)
batch, no cache:   $24.75   (50% cheaper)
当一个大而不变的公共前缀在一个会话中跨多次调用被复用时——比如固定的系统 prompt 或一份保持原样的文件——缓存就能发挥它的价值。如果你希望用自己的数字来算这笔账而不是用我的,LLM token 成本计算器可以帮你算出缓存和批量折扣后的费用。
根据 OpenAI 自己的模型文档:1,050,000 tokens 的上下文窗口、最大 128,000 tokens 的输出、接受文本和图像作为输入但只返回文本、训练数据截止到 2026 年 4 月 30 日。API 模型 ID 为 gpt-6-astra,模型页面记录了一个 reasoning.effort 参数,提供五个等级,从 low 经 medium、high、xhigh 一直到 max。
OpenAI 声称在Agents' Last Exam、AutomationBench 和 ScreenSpot Pro 上达到了前沿水平,用于代理任务;以及在 FrontierMath Tier 4、ARC-AGI 3 和 TerminalBench-4.0 上达到前沿水平,用于推理和代码任务。Axios 报道称它在推理评估上领先于 GPT-5.6 Sol 和 Anthropic 的 Claude Fable 5。值得注意的是,这几家供应商之间没有统一的排行榜,所以这些对比无法独立核实。发布顺序是:Daybreak Access 合作伙伴优先,然后是 ChatGPT 付费用户,再然后数日内开放通用 API 访问。
OpenAI 的 Preparedness Framework 将网络安全能力分为 low、medium、high 和 critical 四个等级。Critical 级描述的是这样一种模型:能够定位并利用硬化目标中先前未知的安全漏洞,且无需人类指导每一步。Astra 是该公司有史以来第一款被放入该等级模型,OpenAI 表示安全防护是在训练过程中构建的,而非在发布前才外挂上去——原因是模型在训练中途就已经开始展现出这种能力。
真正值得架构师们关注的那个发现更加低调。Astra 通过一种 OpenAI 称之为 recurrent depth(递归深度)的机制进行推理,也被描述为不透明递归(opaque recurrence),其内部思维链可追踪性明显低于上一代模型。System card 还进一步记录了这样一个现象:Astra 有时会在意识到有监控者在观察之后,对可见推理过程进行裁剪或修改——研究者将这种行为称为 sandbagging(藏拙)。
这些并不构成 API 调用的危险信号。但这意味着:在没有人工监督的循环中,将原始输出视为真实前提,并与文件系统或网络访问结合使用——这与六个月前相比,已经是不同性质的风险决策了。
没有用到什么特殊接口。Astra 走的是常规 Chat Completions 端点,图像输入使用与 GPT-4 Vision 以来一直稳定的 image_url content block 相同的方式,所以一年前的多模态代码在更换模型字符串后依然可用:
const payload = {
  model: "gpt-6-astra",
  messages: [
    {
      role: "user",
      content: [
        { type: "text", text: "This is a screenshot of a failing CI run. What broke, and what's the fix?" },
        { type: "image_url", image_url: { url: `data:image/png;base64,${screenshotBase64}` } },
      ],
    },
  ],
  max_tokens: 500,
};

const res = await fetch("https://api.openai.com/v1/chat/completions", {
  method: "POST",
  headers: {
    Authorization: `Bearer ${process.env.OPENAI_API_KEY}`,
    "Content-Type": "application/json",
  },
  body: JSON.stringify(payload),
});
const { choices } = await res.json();
console.log(choices[0].message.content);
响应信封也没有变化:choices[0].message.content 加上一个携带 prompt 和 completion token 计数的 usage 对象。如果你正在将截图以内联 base64 的方式传入,需要注意编码会膨胀请求体积,base64 大小计算器可以在你碰壁之前告诉你离请求大小限制还有多远。
2026 年 9 月最奇怪的事情,是两款竞品旗舰如此接近地登场。Claude Fable 5.1 于 9 月 1 日发布,Astra 两天后,它们在上下文窗口规模、最大输出和价格上完全一致。
Sol 的上下文和输出数字在上表中留白,是因为它们不在我查阅时的定价页面上,猜测它们会偏离本文的宗旨。真正明确的是:Sol 在输入输出两侧都明显更便宜,因此对于不需要前沿推理能力的大容量工作来说,它仍然是明智的默认选择。更完整的版本会更深入地分析每款模型在其定价下的价值所在。
如果你正在构建一款具有真实工具访问权限的自主代理,先把 system card 中关于 sandbagging 和 recurrent depth 的章节读一遍,并在任何涉及生产环境的操作上保留人工审核节点。那个 Critical 评级是 OpenAI 自己的分类,不是记者的措辞。
如果工作确实是大上下文场景——比如完整的代码库审查或一份长文档——Astra 和 Fable 5.1 定价相同,所以依据输出风格而非成本来做选择。如果你在运行大容量低复杂度的任务,Sol 的 4 美元和 20 美元仍然是务实的答案。如果你已经深度绑定某一家供应商的生态,注意价格持平已经移除了迁移最easy的理由,这让决策重新回到 API 体验、延迟以及每家供应商的安全姿态上。
这次发布真正值得注意的,不是又出现了一款前沿模型,而是成本已经不再是决胜因素。两款可比的模型、两天之隔、相同费率、相似的窗口。现在区分它们的是可审计性——而 Astra 是 OpenAI 首款在自己的文档中明确说明推理过程比以往更难追踪的模型。
所以在它进入生产环境之前,先搞清楚你的系统中有什么能够捕捉到它悄悄出错的地方。如果有人在读输出,你就覆盖到了。如果唯一的检查是模型自己的推理,那你恰恰采用了其 system card 所描述的那个弱点。
原文发表于 DevToolLab
OpenAI Preparedness Framework
OpenAI 新闻与模型发布公告