Claude Code 三种扩展机制对比与避坑指南
Hook 强制执行、Skill 概率触发、Subagent 隔离运行——三者适用场景不同,混用会导致可靠性和 token 成本双重损失。
完整中文译文
我第一次尝试让 Claude Code"总是运行 linter"时,写了一个 Skill。大多数时候它能正常工作。剩下的时候,Claude 认为这个任务不需要 linting,就跳过了。我花了一个尴尬下午来优化 Skill 的描述,之后才理解真正的问题:我选错了机制。"总是做 X"是 Hook。"决定是否做 X"是 Skill。它们不可互换,而当时的文档很乐意让我把它们混为一谈。
Claude Code 现在提供了四种扩展 agent 的方式:Hooks、Skills、Subagents 和 Agent SDK。它们重叠到看起来像是可选项,又差异大到用错地方会让你付出可靠性或 token 的代价,或者两者兼失。我在前三个上面构建过真实的 harness,仔细读过 SDK 文档并知道它接管哪些场景。以下是每个机制实际如何触发、它在上下文中消耗什么,以及各自具体如何反噬。
一行心智模型
在表格之前,我和队友讲的版本是:
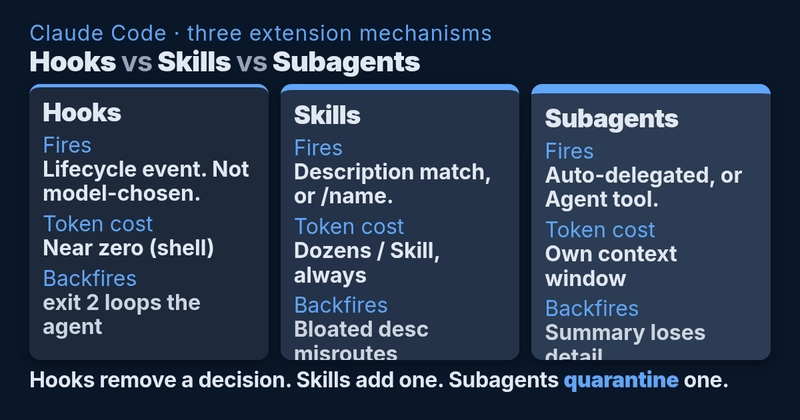
Hooks 是确定性的。无论 Claude 喜欢与否,它们在事件上触发。
Skills 是概率性的。Claude 读取描述后决定是否引入。
Subagents 是隔离。它们在自己的上下文窗口中运行,然后给你返回一个摘要。
Agent SDK 是你亲自掌舵:同一个 agent 循环,运行在你自己的进程中。
如果只记住一件事:Hooks 把决策从模型那里移除,Skills 增加一个决策,Subagents 隔离一个决策。
Hooks:移除模型投票的机制
Hook 是连接到 settings.json 中生命周期事件的 shell 命令。模型没有发言权。这就是它的全部意义,也是全部危险所在。
{
  "hooks": {
    "PostToolUse": [
      {
        "matcher": "Write|Edit",
        "hooks": [{ "type": "command", "command": "prettier --write \"$CLAUDE_FILE_PATHS\"" }]
      }
    ]
  }
}
2026 年事件表面比原始集合要宽得多。除了熟悉的 PreToolUse、PostToolUse、UserPromptSubmit、SessionStart、Stop 和 Notification,现在还有会话事件如 SessionEnd,agent 事件如 SubagentStart/SubagentStop,以及上下文事件如 PreCompact/PostCompact(hooks reference)。
地雷是退出码。Exit 0 是成功。Exit 2 是阻塞错误:stderr 返回给 Claude,action 被拒绝。在 PreToolUse hook 上这是特性:你可以阻止 Claude 触碰 .env。在 Stop 或 SubagentStop hook 上,exit 2 意味着"不允许停止,继续"。我曾经写过一个 Stop hook 检查未提交的变化,如果有未提交就 exit 2。Agent 忠实地拒绝停止,再次尝试,仍然有未提交的变化,再次拒绝停止。我亲手构建了一个循环。教训是:能阻塞的 Hook 就能死锁。在信任它之前测试 exit-2 路径。
因为 Hooks 以你的 shell 权限运行且在上下文窗口之外,token 消耗几乎为零。这就是"总是运行 linter"属于这里而不是 Skill 的原因。你不是在让 Claude 记住;你是在移除这个选择。
Skills:增加模型投票的机制
Skill 是一个带有 frontmatter 的 SKILL.md 文件。Claude 在会话开始时读取每个已安装 Skill 的描述,然后逐轮决定你的提示是否值得引入一个。你也可以用 /name 强制调用。
让 Skills 可扩展的机制是渐进式披露。三个层级在三个不同时间加载:
始终加载:只有名称和描述,每个 Skill 几十个 token。这就是为什么一个 agent 可以知道数百个 Skills 而不会溺水。
调用时加载:SKILL.md 正文。Anthropic 自己的指导将正文保持在 ~500 行以内(skill-development SKILL.md)。
仅在引用时加载:捆绑的脚本和详情文件,在 Claude 用到之前零 token 消耗。
所以失败模式是具体而安静的。每个 Skill 的描述在每轮都存在于上下文中。在那里写一段话,你就对整个会话征收了永久税,而且你让路由决策变得更难,所以模型会更频繁地误触发。我最初的"总是 lint" Skill 失败了,因为我是在让一个概率路由器表现得像确定性的。路由器做了它的工作:它路由了。只是有时候路由走了。
Skills 适用于你真的想让 Claude 做选择的时候。代码审查工作流、"从 git log 起草发布日志"的过程、分诊routine。应该在相关时发生的事情,由模型判断。把描述写成路由键,而不是摘要(Agent Skills overview)。
Subagents:隔离上下文的机制
Subagent 是 .claude/agents/ 中的一个 Markdown 文件,带有 frontmatter,其正文成为那个 agent 的系统提示:
---
name: codebase-explorer
description: Search the codebase for where a symbol is defined and used. Use proactively before refactors.
tools: Read, Glob, Grep
model: sonnet
---

You locate code. Report file paths and line numbers, not full file dumps.
定义性属性:它运行在自己的上下文窗口中。它的系统提示、它的工具调用、它读取的每个 grep 结果和日志行,都不会进入你的主对话。只有最终消息返回(custom subagents)。这是对于那种否则会让上下文泛滥的任务最好的工具:"在 400 个文件中找到这个函数的每个调用者。"在 Subagent 中运行它,你得到的是一份干净的列表,而不是 400 个文件噪音。
这里有两个反噬咬了我。首先,Subagent 不能停下来问你问题。它运行到完成然后报告一次。如果它在半途遇到模糊的决策,它会猜测,然后你从摘要中得知。其次,那个摘要是设计上有损的。细节存在于隔离的窗口中,如果 agent 没有想到要浮出水面就消失了。我曾经有一个 Subagent 自信地报告"未找到用法",而它悄悄地搜错了目录。修复方法是写 agent 的指令让它返回证据(路径、计数),而不仅仅是结论。
一个值得注意的 2026 年陷阱:权限模式从父级继承,可以覆盖 Subagent 自己的 frontmatter。如果你的主会话以宽松的权限运行,Subagent 精心设置的 tools 白名单可能救不了你。把工具列表当作作用域,而不是安全边界。
Agent SDK:把钥匙交给你的机制
当 agent 需要在终端之外运行、在 CI、后端服务、定时任务中时,你用到 Agent SDK。它从 Claude Code SDK 更名而来,因为同样的循环支撑着远不止编程(migration guide)。它为 TypeScript(@anthropic-ai/claude-agent-sdk)和 Python(claude-agent-sdk)都提供。
from claude_agent_sdk import query, ClaudeAgentOptions

async for message in query(
    prompt="Find and fix the failing test in auth.py",
    options=ClaudeAgentOptions(allowed_tools=["Read", "Edit", "Bash"]),
):
    print(message)
你得到同样的 agent 循环、内置工具、hooks、subagents 和 MCP,它们为 CLI 提供动力,但现在运行在你自己的进程中。反噬是 CLI 以前免费做的一切:重试、沙盒、会话持久化和成本控制现在都是你的问题。在用它构建产品之前要知道的一个认证约束:第三方产品不能使用 claude.ai 订阅登录,你通过 API key 认证(直接或通过 Bedrock/Vertex)。先用 SDK 原型,然后决定托管选项是否适合生产。
我实际如何选择
我依次问自己的问题:
这件事每次都必须发生,没有任何例外?用 Hook。
Claude 应该决定何时相关?用 Skill。
这会把一堆垃圾倾倒进我的上下文?用 Subagent。
这件事需要在我不参与的情况下运行?用 Agent SDK。
我大多数错误来自在问题 2 的答案是问题时回答了问题 2。"总是"和"当相关时"在你输入配置时感觉相似。它们在运行时是相反的。
Hooks 移除模型的选择。把它们用于不可协商的规则。观察 exit-2 路径:阻塞性的 Stop hook 可以让你的 agent 循环。
Skills 增加一个选择。渐进式披露保持它们的廉价,但每个描述在每轮都被征税。不要用 Skill 来强制一件必须总是发生的事。
Subagents 隔离上下文。最适合嘈杂的探索。它们不能问后续问题,摘要是有损的,所以让它们返回证据。
Agent SDK 把钥匙交给你。同样的循环,你的进程,你的运营负担。
最大的可靠性提升不是挑选"最好的"机制。而是注意到"总是"什么时候伪装成"当相关时"。
如果你配置 Claude Code 足够久,以至于能感受到一个内聚 harness 的形状——Hooks、Skills、Subagents 和 CLAUDE.md 都坐落在同一个地方并相互强化——那是我写的书。
👉 Claude Code Mastery
Hooks reference — Claude Code Docs
Create custom subagents — Claude Code Docs
Agent Skills overview — Claude Docs
Migrate to the Claude Agent SDK — Claude Docs
Equipping agents for the real world with Agent Skills — Anthropic
Steering Claude Code: skills, hooks, subagents — Claude blog