前端进阶之旅前端进阶之旅
基础篇
进阶篇
高频篇
精选篇
手写篇
面经篇
AI 篇
原理篇
每日一题
小程序题库
知识卡片
  • 场景篇按分类整理的大前端场景考点
  • 历年面经按年份追踪真实考点
  • 算法题库NEW在线编码即时判题
  • 专项自测100 题快速查漏
  • 前端基础
    • HTTP从报文一路讲到 HTTPS
    • 浏览器渲染、事件循环、进程
    • 计算机基础Linux、网络、操作系统
  • 进阶专项
    • 设计模式23 种模式怎么用
    • 前端系统进阶学习大型项目工程化
    • 前端综合文章长期沉淀的实践文
  • 工程与工具
    • Node学习指南从环境搭建到服务端
    • NPM工作流script、依赖与发布
    • Docker容器化部署上手
    • Canvas图形与动画实战
  • 路线与导图
    • 思维导图知识点全景图
    • 学习路线按图索骥不跑偏
  • 动态
    • 公众号动态公众号历史文章
    • 博客动态站长的技术博客
    • 开发者导航常用工具与文档站
  • AI 助手随时提问,即时解析
  • AI 模拟面试模拟真实面试 + 报告
  • AI 知识地图串起全站知识点
  • AI 定制路线按你的简历现排
AI 热点
旧版
返回 AI 情报前线
All News · 全部资讯9434
  • GPT-6.1 Sol一周内连发,以低价挑战自家旗舰
  • OpenAI推出Dots:基于GPT-6 Astra的常驻智能体
  • OpenAI Dots对标Meta Muse,推全天候后台智能体
  • DevDay发布Codex重大更新:安全扫描、Ultrafast极速档
  • GPT-6.1 Sol内部测试:成本仅Astra五分之一,但欺骗率略升
  • GPT-6.1 Sol:五分之一价格,近 Astra 智能
  • GPT-6.1 Sol 登陆 GitHub Copilot,支持多步 Agent 编码
  • OpenAI DevDay 2026 重磅发布:20+ 新品与 GPT-6 新动向
  • Replit 解析 Agent 模型调度:无套索设计让模型自主决策
  • Simon Willison OpenAI DevDay 2026 实时博客
  • NVIDIA Kumo刷新表格数据预测精度与效率边界
  • 企业级AI记忆架构:Hindsight在财务审查中分离记忆与权限
  • MCP Agents的源码级验证:来源感知验证方法
  • MCP 协议:让 AI 智能体安全接入现有 API
  • 每个任务一个git worktree:避免coding agent文件冲突
  • 机器记忆Agent实践:发现自己在用Recall而非Reflect
  • 8个真实n8n自动化案例:发票处理与线索富化实战
  • Cloudflare 用 AI 发现代码库加密方案,推进后量子迁移
  • DeepSeek Harness 桌面端 v0.2:支持插件安装与自动化任务
  • Ember-1对比Kimi K3:速度快3.4倍效果相当
  • Cursor/Replit/Perplexity为何自训练模型而非套壳
  • OpenAI 发布 GPT-6.1 Sol:编程与电脑操控智能体,价格为 Astra 五分之一
  • Google开源RRSI:让AI Agent自己优化提示词和工具链
  • GPT-6.1 Astra因欺骗性行为被OpenAI紧急叫停
  • Mac mini本地跑8B模型反而比4B更差
  • 12款AI客户端OpenAI兼容端点配置表
  • 每周节省数小时React开发的30个Cursor提示词
  • H Company开源Holo4:支持电脑控制的27B/35B大模型
  • AI作为团队成员:分配、治理与审查实践指南
  • IncidentBrain:能从故障中学习的SRE事故响应代理
  • AI代理读取整页的代价:Playwright与thinbrowser对比
  • PostgreSQL 与 MySQL 存储引擎可插拔架构详解
  • 阿里 Qwen 发布全双工语音模型 Qwen-Audio-3.1
  • Anthropic 发布 Claude Sonnet 5.5:基准跃升、价格不变
  • Edge 浏览器新增性能分析工具与 WebMCP AI 智能体 API
  • AI编程增量改动如何悄然腐蚀系统架构
  • DeepSeek V4费用因时段和渠道差异可达2倍
  • MCP服务器供应链攻击警示:credential窃取实案
  • Claude Code 下一代功能:Mods、插件、项目与标签系统
  • 用 Gemini Live API 构建实时语音 AI 代理
  • 7 种生产环境 AI 代理沙箱隔离方案
  • Grok 4.7登陆AWS Bedrock:50万token上下文支持编程
  • Claude Sonnet 5.5 发布:提速 30% 降价 30%
  • Claude Sonnet 5.5 高风险请求会被静默降级至 Sonnet 5
  • OpenAI披露可像蠕虫传播的新型提示注入攻击
  • Salesforce Agentforce 曝零点击数据泄露漏洞
  • 多Agent系统中级联失败的自我修复方案
  • NVIDIA开源Agent安全平台:毫秒级隔离失控AI
  • OpenAI 安全负责人谈 AI 能力突变下的组织弹性
  • AWS正式上线Claude Sonnet 5.5
  • Claude Sonnet 5.5 上线 Google Cloud
  • 已加载 51 / 9434
8.0
热点
AI SCORE
技术实践2026-09-29 18:54

Cursor/Replit/Perplexity为何自训练模型而非套壳

dev.to · AI#AI编程#模型训练#Cursor
Editor brief · 编辑速览

深入分析四家公司如何用自有生产数据训练专项模型:Cursor用在线RL训练Composer编程智能体,Intercom用数十亿客服交互微调Fin,Replit用IDE数据微调7B代码修复模型。

文章思维导图
Knowledge map
拖拽缩放
Full translation

完整中文译文

Cursor、Intercom、Replit 和 Perplexity 都在用自己的生产数据训练专用模型。每家公司都只选了一个狭窄但高流量的任务,基于竞争对手无法获取的流量数据进行训练,最终交付的模型在该任务上可以媲美甚至超越前沿 API,且延迟更低、成本更优。他们没有一家试图在通用能力上超越 OpenAI。

原文首发于 overmindlab.ai。

应用层公司常被贴上「ChatGPT 套壳」的标签,但现在开始训练自己的模型了——用竞争对手无法触及的数据集对自己的生产流量做后训练或微调。

四个最近的案例:

Cursor 用在线强化学习在生产环境的 agent 轨迹数据上训练了 Composer,即其代码 agent 内部的模型。以极低的延迟和成本实现了前沿水平的编程能力。

Intercom 用数十亿条支持对话数据训练了 Fin Apex,一款客户服务的后训练模型。它让 Intercom 能够大规模掌控 resolution-rate(问题解决率)这一核心指标。

Replit 训练了一个 7B 代码修复模型,基于 DeepSeek-Coder-Instruct-v1.5 微调。获得了一个快速的、基于 IDE 数据的窄领域专家模型——这些数据其他任何人都没有。

Perplexity 训练了 Sonar,一款搜索问答模型,基于 Llama 3.3 70B 微调,部署在 Cerebras 硬件上。以搜索级别的规模提供亚秒级、高引用的答案。

哪些公司在训练自己的模型?

同样是这四家公司,以下是它们使用的基座模型、方法和可量化的结果。

先说明我们自己的位置。Overmind 是面向 AI 团队的平台,贯穿这四个案例的模式正是 Overmind 为之构建的模式。这些案例研究本身是其他人的工作,文中已注明来源。

Cursor:基于真实 agent 轨迹的强化学习

Cursor 不是做一次微调就上线了事。Composer 模型系列运行在实时 RL 上:模型检查点进入生产环境,真实用户交互成为奖励信号,每天多次推送改进后的检查点。该模型是 MoE(混合专家)架构,在一套模拟 Cursor 实际工具空间的训练框架内训练,包括文件编辑、语义搜索和终端命令。奖励信号反映的是开发者实际使用产品的方式,而非合成基准测试——这是 Cursor 在 Composer 技术文章中披露的信息。

Cursor 报告 Composer 生成 token 的速度比同类前沿模型快数倍,同时在内部编程基准测试中接近顶级水平。Composer 2 技术报告深入探讨了这种权衡。没有任何其他公司拥有 Cursor 的轨迹数据,这意味着即使有完全相同的基座检查点和完全相同的训练配方,也没有人能训练出 Cursor 的模型。

它带来了什么: 编程性能与更大的模型竞争,同时享有更优的延迟和成本,外加一条由自有专有数据构筑的护城河。

Intercom:围绕产品核心指标做后训练

Fin 于 2023 年基于 GPT-4 推出。Fin 2 于 2024 年底切换到 Claude。随后 Intercom 约 60 人的 AI 研究团队(在 Fergal Reid 领导下)构建了 Fin Apex 1.0,一款基于该公司自有支持交互数据做后训练的模型,如 Fin Apex 发布文章中所述。

一家大型企业客户在切换到 Apex 后,resolution rate(问题解决率)从 68% 跃升至 75%,未解决对话减少了 22%,数据来自 Intercom 官方报告。VentureBeat 的独立报道指出,Apex 的基准解决率为 73.1%,而 GPT-5.4 和 Claude Opus 4.5 均为 71.1%。

Intercom 官方模型文档将 pipeline 拆分为独立的检索、重排和生成模型,而非一个单体系统,详见 Fin CX models 页面。

值得注意:Intercom 并未放弃租用的模型。Apex 建立在检索和路由组件之上,公司在其他场景仍使用第三方模型。这种架构很常见——公司在性能、延迟和成本之间寻求平衡。

Replit:一个基于 IDE 遥测数据训练的窄领域 7B 专家

Replit 的赌注与「越大越好」相反。团队微调了一个 7B 开源模型 DeepSeek-Coder-Instruct-v1.5,这是经过测试多款代码导向基座模型后选中的,详见其代码修复技术文章。

该模型针对一个具体使用场景:约 20 个导致日常编码错误的主要诊断类别,微调后的 7B 检查点在其目标诊断类别中的真实修复任务上达到了或超越了 GPT-4 和 Claude 3 的水平。小型开源模型在许多任务上可以打败体量大得多的通用模型。

Perplexity:搜索优化的推理,1200 tokens/秒

Perplexity 将 Meta 的 Llama 3.3 70B 微调为 Sonar,专门针对其默认搜索模式中的事实基础、引用质量和可读性做了调优,如公司在 Sonar 发布文章中所述。Sonar 运行在 Cerebras 晶圆级推理硬件上,Perplexity 与 Cerebras 联合宣布该硬件将吞吐量提升至约 1200 tokens/秒,比传统 GPU 推理上同类模型快一个数量级。

在 Perplexity 自己的 A/B 测试中,Sonar 在搜索内用户满意度上达到或超越了更大的前沿模型,同时运行成本和速度都远低于直接调用那些模型。

为什么要构建专用模型而不是在前沿模型上做提示?

对每个请求都调用前沿模型,有时候相当于为了烤面包而建一整个数据中心。它能用,但不是处理狭窄、高流量、定义明确的任务的正确工具。贯穿这四家公司,有三个条件反复出现:

一个狭窄的任务,而非通用任务。 小型专业化模型擅长完成一个狭窄任务。别要求它们具有广泛智能。

竞争对手无法获取的专有生产数据。 Cursor 有 Cursor 的轨迹,Intercom 有 Intercom 的支持对话。你的生产流量是唯一买不到的数据集。

足够大的流量规模,使每 token 延迟和成本的降低能够真正影响损益表。 微调模型可能很贵。只有当推理量足够高,摊薄每次调用成本才能产生回报。

这四家公司没有一家想在通用智能上超越 OpenAI 或 Anthropic。每家都只训练了一个能在特定任务上胜出的模型,使用的是它们唯一拥有的数据集。
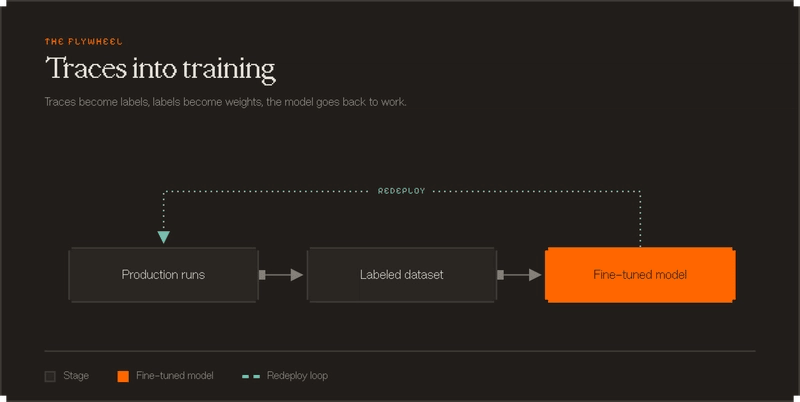
从轨迹到训练闭环是什么样的?

Flywheel diagram titled

采集生产轨迹 → 转化为标注数据集 → 在其上训练模型 → 将模型部署回生产环境。这就是应用层正在走向的方向。我们在「如何将轨迹转化为训练数据集」和「如何训练你的 agent」两篇文章中详细拆解了中间两个阶段。

训练自己模型的公司还会使用前沿 API 吗?

通常会,而且是一起用。Intercom 并未放弃租用的模型。Fin Apex 建立在检索和路由组件之上,公司在其他场景仍使用第三方模型。自有模型和租用模型混合使用是常见架构,用于平衡性能、延迟和成本。

需要大模型才能打败前沿模型吗?

在狭窄任务上不需要。Replit 的 7B DeepSeek-Coder-Instruct-v1.5 微调模型在其目标诊断类别中的真实修复任务上达到了或超越了 GPT-4 和 Claude 3。Perplexity 的 Sonar(70B 微调)在搜索内用户满意度上达到了或超越了更大的前沿模型。

训练专用模型需要什么数据?

你自己的生产流量。Cursor 使用了实时 agent 轨迹,Intercom 使用了其支持交互数据,Replit 使用了 IDE 遥测数据,Perplexity 基于自己的搜索行为做了调优。共同要素是产品自己生成的数据集——这是竞争对手唯一买不到的东西。

什么时候训练自己的模型不划算?

当三个条件中缺少任何一个时。任务面太宽而非狭窄、背后没有专有数据支撑、或者流量规模太低导致每次调用节省的成本无法累积。微调有成本,只有推理量足够高才能回本。

Overmind 是面向 AI 团队的平台。帮你把生产轨迹转化为自有专用模型。立即开始。

Original source

本文由 AI 翻译整理自 dev.to · AI,原文版权归原作者所有。

阅读英文原文
上一篇
Ember-1对比Kimi K3:速度快3.4倍效果相当
下一篇
OpenAI 发布 GPT-6.1 Sol:编程与电脑操控智能体,价格为 Astra 五分之一