
8.0
热点
AI SCORE
编程提效2026-09-29 13:53
IncidentBrain:能从故障中学习的SRE事故响应代理
dev.to · AI#SRE#AI Agent#故障排查
Editor brief · 编辑速览
SRE AI代理IncidentBrain用Hindsight持久记录事故信息,学习「发生了什么-做了什么-结果如何」,下次类似事故可复用经验。
持续运营记忆如何帮助 AI 事故响应智能体从以往的事故中学习,而不是每次都从零开始。
生产事故很少是完全全新的。
支付 API 今天可能因为 Redis 连接问题开始返回 503 错误,而非常类似的事故可能在数周或数月后再次发生。
处理过先前事故的工程师可能记得什么方案有效。
但如果该工程师不在场呢?
如果这些知识埋藏在旧的事故工单、事后分析报告、仪表板或某人的记忆中呢?
这就是 IncidentBrain 背后的想法起源。
IncidentBrain 是一个由 AI 驱动的 SRE 事故响应智能体,围绕一个简单的理念设计:
AI 智能体应该能够从以往的生产事故中学习,并在调查未来事故时运用这些经验。
IncidentBrain 没有将每个事故视为一个全新问题,而是使用 Hindsight 维护持久化的运营记忆。
当一个事故被解决后,系统会记住三件事:
之后,当类似的事故发生时,IncidentBrain 可以检索那些先前的经验,并在调查期间将其作为历史上下文提供。
这创建了一个持续学习循环:
调查 → 解决 → 记忆 → 召回 → 再次调查
目标不是取代 SRE。
目标是让 SRE 的先前经验在下次事故发生时更容易被检索到。
传统的 AI 助手可以分析事故报告并建议可能的原因或修复步骤。
然而,除非明确提供相关的历史信息,否则每次交互实际上都可能从零开始。
对于 SRE 来说,这会在 AI 推理与组织经验之间产生鸿沟。
考虑一个简单的场景。
支付 API 返回 HTTP 503 错误,Redis 连接正接近配置的连接限制。
工程师以前可能遇到过完全相同的模式。
也许先前的事故揭示了 Redis 连接池耗尽是罪魁祸首,增加连接池大小就解决了问题。
但无状态的助手不会自动知道这一点。
这正是 IncidentBrain 旨在解决的问题。
IncidentBrain 不是将每个事故视为孤立的对话,而是为智能体提供了一种从先前事故中检索相关经验的方法。
目标不仅仅是生成另一个 AI 建议。
目标是让建议能够访问之前发生的运营经验。
IncidentBrain 使用 Hindsight 作为其持久化记忆层。
当事故被解决后,智能体会存储一个包含三条重要信息的经验:
例如,一个事故经验可能如下所示:
Incident: Payment API returned HTTP 503 errors.
Action: The Redis connection pool was increased from 100 to 250.
Outcome: The HTTP 503 error rate returned to normal.
这不是简单的对话记录。
它成为了可在未来事故与先前事故相似时被检索的运营经验。
工作流程很简单:
事故 → 记忆 → 未来事故 → 召回先前经验 → 调查
这创建了一个重要的反馈循环。
智能体不只是生成一个答案然后忘记它。
事故的结果成为其未来上下文的一部分。
IncidentBrain 的工作流程有两个主要阶段:
当提交新的事故时,IncidentBrain 首先在 Hindsight 中搜索相关的先前经验。
例如,智能体可以使用以下方式召回先前的事故知识:
memory_result = self.memory.recall(
    bank_id=self.bank_id,
    query=incident
)

memories = []

for result in memory_result.results:
    memories.append(result.text)
检索到的经验随后作为历史上下文提供给 LLM,用于当前调查。当前事故与检索到的记忆在模型生成建议之前会被合并。模型被指示区分四类信息:
这种区分在生产环境中很重要。历史配置值不应自动被视为当前配置。例如,假设先前的事故涉及 Redis 连接池大小为 100。当下一次事故发生时,该值可能不再有效。相反,历史值可以被视为证据,而工程师在做出更改之前验证当前系统状态。这有助于 IncidentBrain 使用先前经验而不会盲目地将其应用到当前事故。
调查事故只是学习过程的一半。
在工程师调查并解决事故之后,IncidentBrain 提供了一种记录两条重要信息的方式:
例如,智能体可以将已解决的事故存储到 Hindsight 中:
experience = f"""
HISTORICAL SRE INCIDENT EXPERIENCE
Incident:
{incident.strip()}

Action that was taken:
{action_taken.strip()}

Observed outcome:
{outcome.strip()}
"""

result = self.memory.retain(
    bank_id=self.bank_id,
    content=experience
)
事故、行动和观察到的结果现在被存储为可重用的经验。这将一个事故的解决转化为可在未来调查中检索的运营知识。下次发生类似事故时,IncidentBrain 可以从 Hindsight 中召回此经验并将其作为历史上下文提供。这创建了完整的学习周期:
完整工作流程可以可视化为:
事故 → 召回 → 建议 → 解决 → 学习
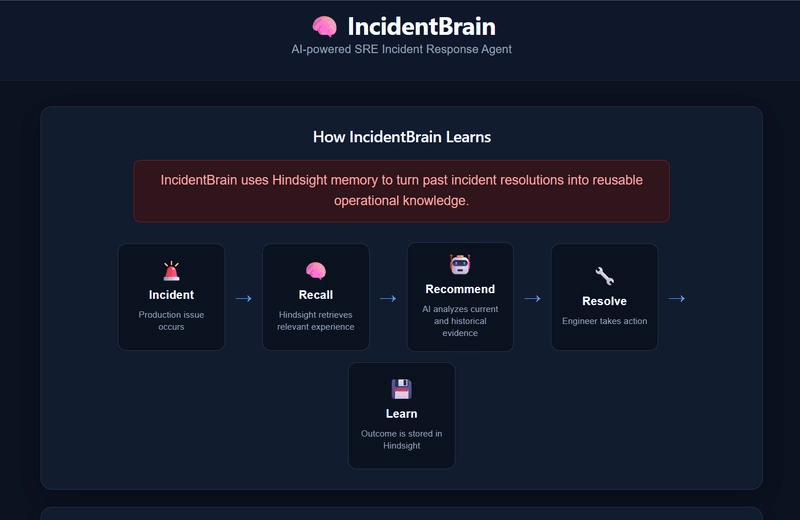
调查 → 解决 → 记忆 → 召回 → 再次调查
重要的是,这个学习过程不需要重新训练底层语言模型。相反,智能体通过积累相关的运营经验来改善其未来上下文。
让我们通过一个真实的事故来了解 IncidentBrain 的记忆循环是如何工作的。
假设支付 API 开始返回 HTTP 503 错误。
同时,Redis 连接已大幅增加,正接近配置的连接限制。
工程团队调查了该事故,确定 Redis 连接池耗尽是可能的原因。
他们将 Redis 连接池从 100 增加到 250。
更改之后,HTTP 503 错误率恢复正常。
IncidentBrain 然后存储该经验:
Incident: Payment API returned HTTP 503 errors because Redis connections were approaching the configured limit.
Action: Increased the Redis connection pool from 100 to 250.
Outcome: The HTTP 503 error rate returned to normal.
此经验被保留在 Hindsight 中。
现在假设数周后,支付 API 再次开始返回 HTTP 503 错误。
Redis 连接再次接近配置的连接限制。
工程师无需手动搜索旧的事故报告来找到先前的解决方案。
IncidentBrain 可以从 Hindsight 中召回先前的经验。
当类似事故发生时,IncidentBrain 从 Hindsight 中检索相关先前事故经验,而不是从空的上下文开始。
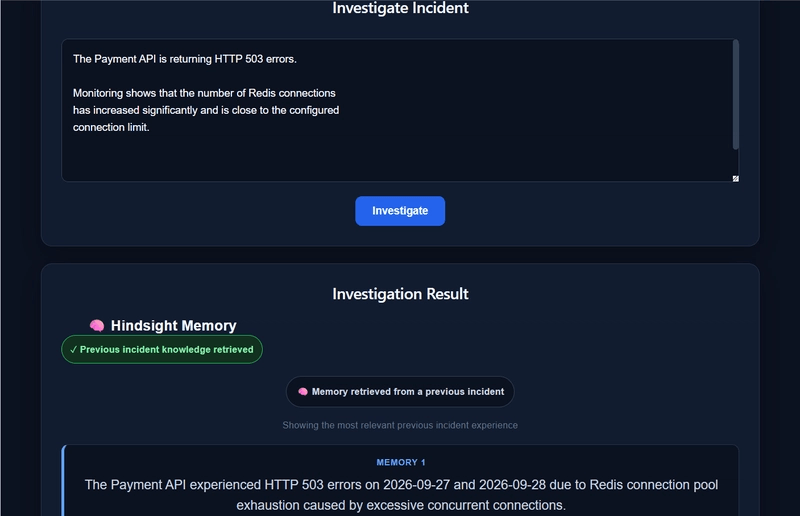
检索到的经验成为新调查的历史证据。
LLM 然后可以考虑:
检索到的历史经验被用作证据,而 LLM 分析当前事故并生成建议。
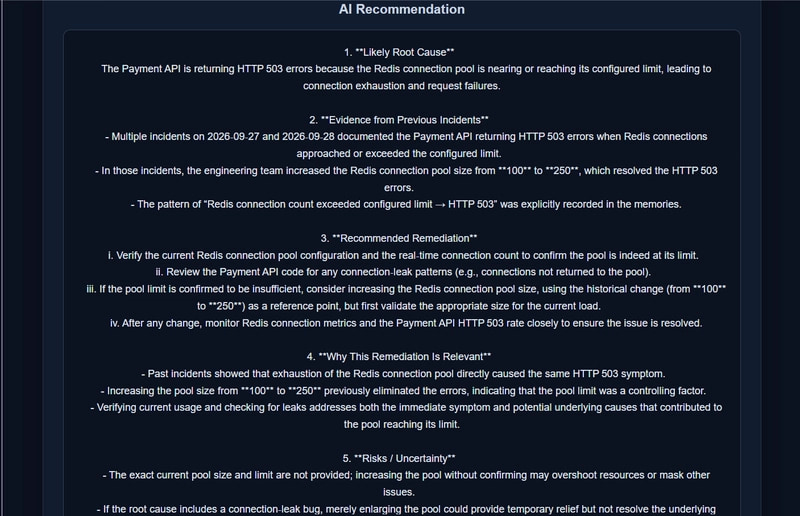
这是第一次调查与第二次调查之间的关键区别。
第一次调查创建了运营知识。
第二次调查可以从中受益。
智能体不再是从空的上下文开始。
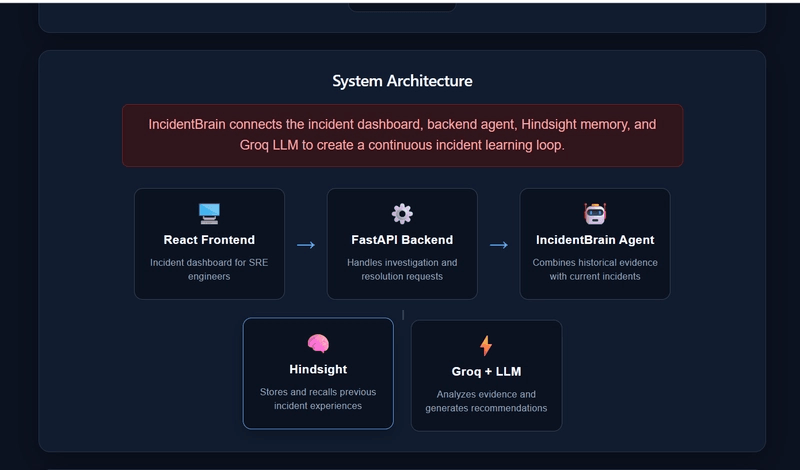
IncidentBrain 采用围绕四个主要组件构建的相对聚焦的架构:
Hindsight + Groq — Hindsight 提供持久化运维记忆,Groq 提供 LLM 推理层。
整体流程如下:
React Dashboard
       │
       ▼
FastAPI Backend
       │
       ▼
IncidentBrain Agent
       │
       ├──────────────► Hindsight Memory
       │                    │
       │                    ▼
       │              Previous Incidents
       │
       ▼
Groq LLM
       │
       ▼
AI Recommendation
       │
       ▼
Engineer Resolution
       │
       ▼
Action + Outcome
       │
       └──────────────► Hindsight Memory
React 前端提供了工程师提交和调查事件的界面。FastAPI 后端暴露了连接前端与 IncidentBrain 智能体的 API。智能体充当协调者角色。它从 Hindsight 检索相关的历史经验,将当前事件与历史经验结合后发送给 LLM,并生成建议。事件解决后,智能体将采取的行动和观察到的结果存回 Hindsight。这就形成了反馈循环,使后续调查能够受益于之前的事件。
该系统将事件仪表盘、后端 API、IncidentBrain 智能体、持久化的 Hindsight 记忆和 Groq LLM 连接成一个持续的事件学习工作流。
当 IncidentBrain 从 Hindsight 检索到相关的历史经验后,当前事件和历史上下文被传递给 LLM。
当前实现中,使用 Groq 作为 LLM 推理层。
集成的简化版本如下:
response = self.groq.chat.completions.create(
    model="openai/gpt-oss-120b",
    messages=[
        {
            "role": "system",
            "content": "You are an experienced SRE incident response assistant."
        },
        {
            "role": "user",
            "content": prompt
        }
    ]
)

recommendation = response.choices[0].message.content
重要的部分并非简单地调用 LLM。重要的是模型收到的上下文。提示词包含当前事件以及从 Hindsight 检索到的相关历史经验。这使得模型能够在推理当前情况的同时,也考虑过去类似事件中发生了什么。换言之:当前事件 + 历史经验 → LLM 推理 → 建议
Hindsight 提供持久化记忆,Groq 提供 LLM 推理层。因此这两个组件在系统中扮演不同的角色:
在使用历史记忆进行生产运维时,有一个重要的设计考量。
过去的经验应该被视为证据,而非绝对真理。
之前的事件可能发生在不同的:
因此,IncidentBrain 被设计为避免盲目地将历史信息应用于当前事件。
智能体被指示:
例如,假设之前某个事件是通过将 Redis 连接池从 100 增加到 250 来解决的。
这并不意味着同样的更改应该自动应用到所有未来的 Redis 相关事件。
当前系统可能有不同的配置、流量模式或潜在问题。
相反,之前的解决方案成为工程师在调查当前状态时可以考虑的一条历史证据。
这种方法使持久化记忆变得有用,而不会将其视为无可置疑的真理来源。
IncidentBrain 有趣的部分并非 LLM 能够分析 Redis 事件。
现代 LLM 已经能够解释技术问题并建议可能的解决方案。
更有趣的能力是经验积累。
当一个事件被解决时,经验可以存储在持久化记忆中。
之后,当类似事件再次发生时,可以检索并使用之前的经验作为上下文。
这就创建了一个持续学习循环:
事件 → 解决 → 记忆 → 回忆 → 更好的调查
随着更多相关经验被存储,智能体可用的组织知识也越来越多。
这为 AI 系统开辟了一种可能性:它们不仅仅是回答问题,而是因为能够记住之前发生的事情而随着时间变得更有用。
IncidentBrain 目前展示了将 AI 推理与持久化运维记忆相结合的核心思想。
该架构可以通过将智能体连接到真实生产系统来进一步扩展。
可能的后续改进包括:
长期目标是从一个独立的事件响应助手走向一个能够更深入地参与生产运维工作流的 AI 系统。
IncidentBrain 探索了一个简单的理念:
当 AI 事件响应系统能够记住之前的运维经验时,它会变得更加有用。
核心工作流是:
调查 → 解决 → 记忆 → 回忆 → 再次调查
IncidentBrain 没有将每个生产事件视为孤立的问题,而是创建了一个反馈循环,使之前的事件能够成为后续调查的有用证据。
Hindsight 提供持久化记忆层,而 LLM 提供对当前事件和检索到的历史上下文的推理能力。
目标不是取代 SRE 工程师。
目标是让之前的运维经验在下一个事件发生时更容易被检索和使用。
AI 推理与持久化运维记忆的结合,是 IncidentBrain 的基础。
Hindsight GitHub repository
Hindsight documentation
Vectorize — Agent Memory
IncidentBrain GitHub repository