
8.0
热点
AI SCORE
模型发布2026-09-29 23:30
NVIDIA Kumo刷新表格数据预测精度与效率边界
Hugging Face Blog#NVIDIA#表格数据#机器学习
Editor brief · 编辑速览
NVIDIA发布Kumo Tabular模型,专为表格预测任务设计,在精度和效率上均实现突破,适合结构化数据场景。
NVIDIA Kumo Tabular 是 NVIDIA Kumo Structured 模型系列的一部分,是一个面向表格数据的开源基础模型,现已在 Hugging Face 上发布。给定一张带有标签的行数据表,它可以在单次前向传播中预测新行的标签,无需训练、无需调参、无需特征工程,同时支持分类和回归任务。该模型仅在人工数据上进行预训练,提供三种规模(28M 到 215M 参数),通过 NVIDIA 的开源库运行,发布于 OpenMDW-1.1 许可证,可用于商业场景。它在 TabArena、BeyondArena、TALENT 和 ScoringBench 四个基准测试中均排名第一。
Model Code: https://github.com/NVIDIA/structured-data-models
Model Weights: https://huggingface.co/nvidia/Kumo-Tabular




表格数据是企业机器学习的基石。客户记录、交易数据、传感器日志、保单、订单都存储在表中,基于这些数据预测客户流失、违约、需求或价格是工业界最常见的机器学习任务之一。二十年来,这类工作一直由梯度提升树(gradient-boosted trees)完成,而且效果不错。但围绕这些模型的生命周期几乎没有改变——每一个新问题都意味着:收集标签、工程化特征、搜索超参数、验证,再部署一个对通用表格一无所知、从头学习每个任务的模型。
大语言模型(Large Language Models)展示了一种处理新任务的不同方式。给定提示中的几个示例,预训练模型就能解决任务,而无需更新任何一个权重。这就是上下文学习(in-context learning),它同样适用于表格:在大规模表格上预训练的模型可以将一张带标签的表格作为上下文来阅读,然后直接预测新行的标签。
今天,NVIDIA 正式发布 NVIDIA Kumo Tabular(GitHub、HuggingFace),这是一个面向表格分类和回归的开源基础模型。给定一张包含标签行的表格以及需要预测的行,Kumo Tabular 可以在单次前向传播中返回类别概率或数值预测。
Kumo Tabular 是一个围绕表格结构构建的 Transformer,采用了 TabICL 和 TabPFN 中引入的列注意力、行注意力和上下文注意力机制。要预测一个标签,它需要完成三件事:(1)理解每个值在其列中的含义;(2)理解一行中各列之间的交互关系;(3)将带标签的上下文行与标签未知的查询行关联起来。Kumo Tabular 通过以下方式实现这些目标:
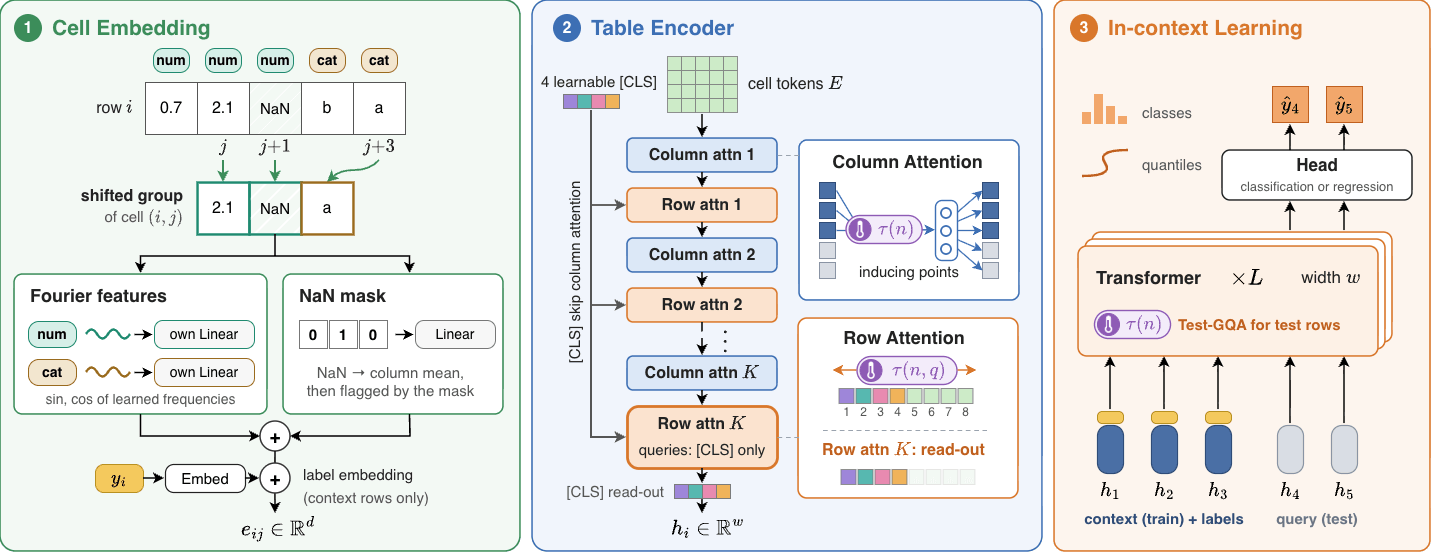
Cell Embedding(单元格嵌入):一组单元格构成一个 token。数值型和类别型值通过傅里叶特征(learned frequencies 的正弦和余弦)传递,每种类型使用独立的权重。缺失值无需填充,会被特殊处理。最后,上下文中的每个 token 都会获得一个标签嵌入。
Row Embedding(行嵌入):然后通过多次交替两种注意力机制将每一行转换为一个嵌入。列注意力(Column attention)沿单列向下查看,学习一个值在其列分布中的含义,例如 42 是典型值还是极端值,通过诱导自注意力实现,因此其计算成本随行数线性增长。行注意力(Row attention)跨单行的 token 进行查看,学习特征之间的交互方式,并通过旋转位置编码来区分不同的列。四个可学习的 [CLS] token 加入到每一行中,充当该行的最终读出(readout)。完成行压缩后,最后阶段的成本不再取决于列数。
In-context Learning(上下文学习):最后的 Transformer 在行嵌入上运作。上下文行之间相互注意力,而查询行只对上下文行进行注意力。因此,每次预测仅取决于上下文和该行本身,而非取决于与它一同被评分的其他行。因为上下文从不查看查询,所以其键(keys)和值(values)只需计算一次,即可被后续预测复用。查询行使用 Test-GQA 来缩小每次预测读取的缓存。预测头(head)将每个查询行转换为分类的类别概率和回归的 999 个分位数,由此得出点预测和不确定性估计。
Length-aware Attention Temperature(长度感知的注意力温度):随着键的数量增长,Softmax 注意力会分散。在几百行上很尖锐的注意力在数万行上可能会消散——而这恰恰就是推理时表格远大于典型训练表格的情况。因此,Kumo Tabular 会对每个查询按一个随键数量对数增长的温度进行缩放,每个注意力头独立学习该系数。其结果是:即使表格变长或变宽,注意力依然保持锐利。
Kumo Tabular 完全在人工表格上进行预训练。每个训练表格都按照下图所示的六个步骤从结构因果模型(Structural Causal Model,SCM)中采样:
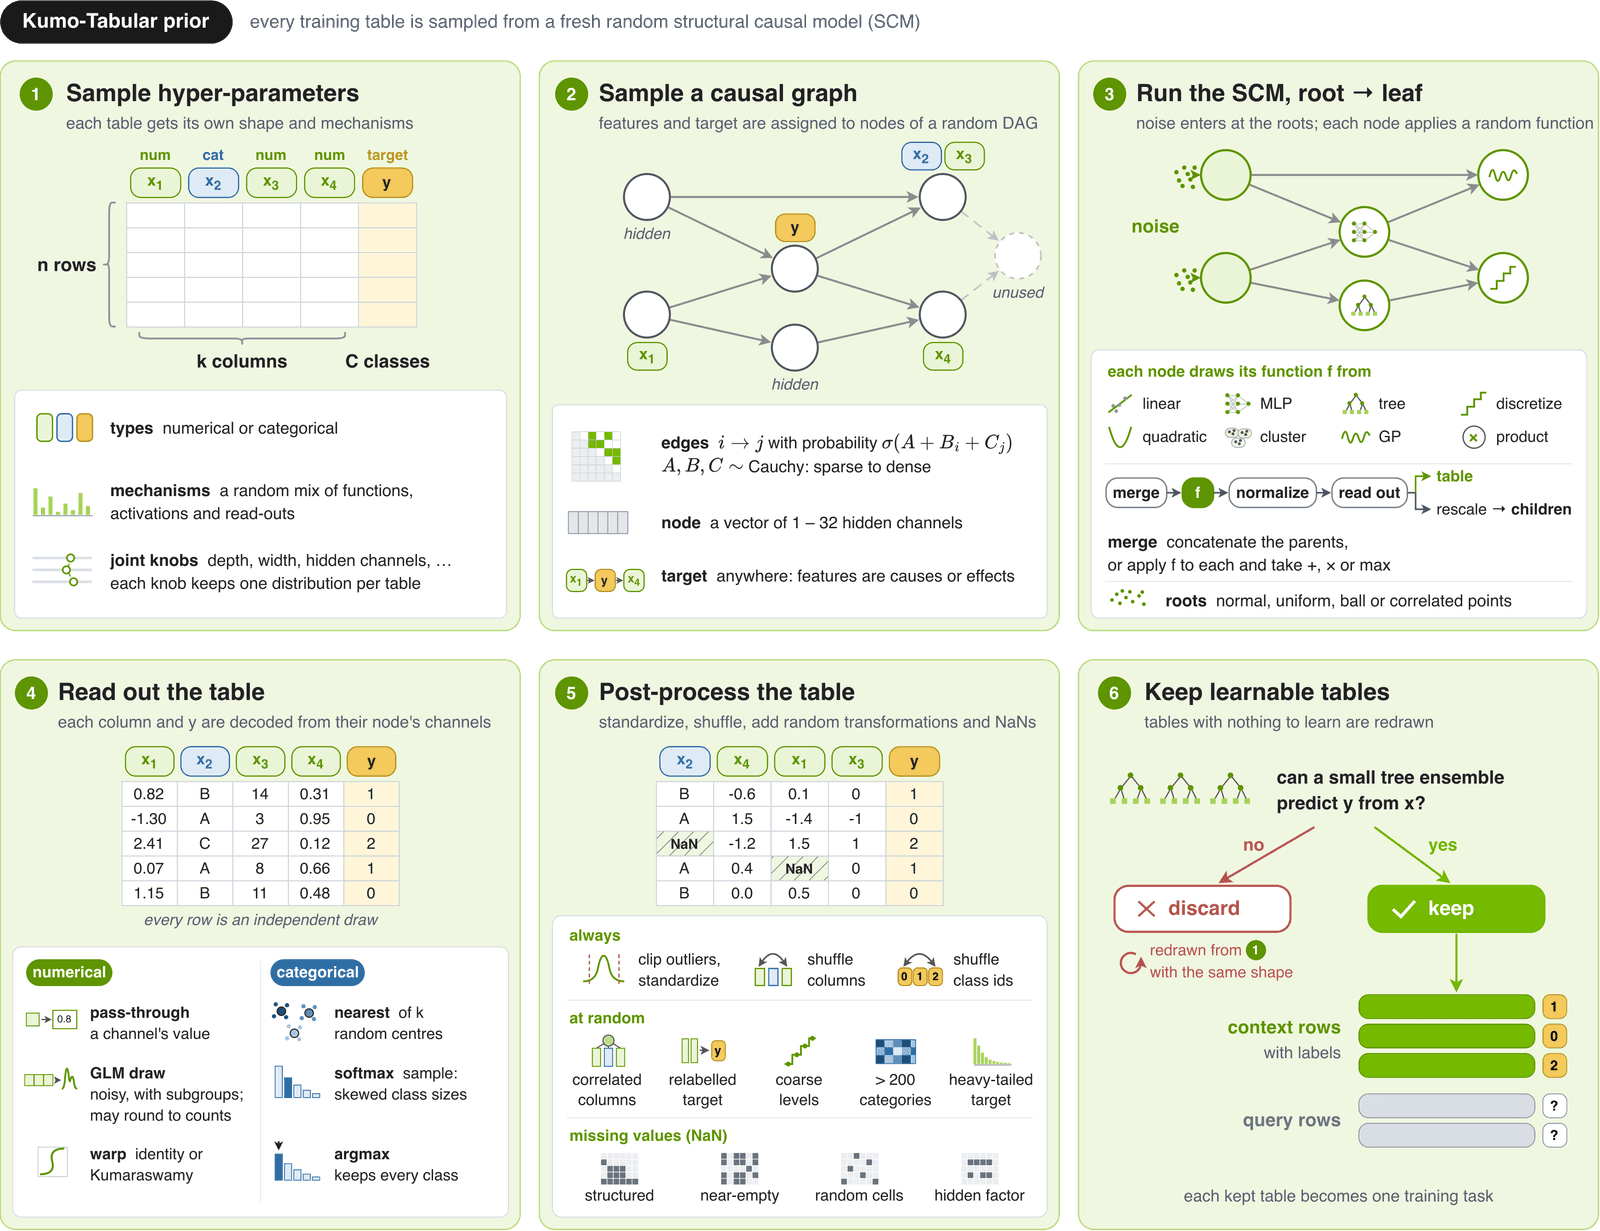
首先,从表的规模、任务、机制和缺失模式等方面为整个表抽取一个配置。然后,一张随机因果图将隐藏变量链接起来,通过在每个节点随机绘制的函数(如线性映射、小型神经网络、树或高斯过程)从根到叶依次求值。一些节点成为数值列或类别列,一个成为目标列,其余保持隐藏,就像真实数据背后未被测量的原因一样。后处理对列组进行关联、裁剪异常值并注入缺失值,然后通过一个快速的树集成检查来丢弃任何没有可学习信号的表格。由于生成器是一个程序化采样器而非训练好的模型,它可以产生无限的表格,每个表格都有新的图和新的机制。
现实世界的表格是混乱的,所以 NVIDIA 在生成器中加入了更多真实世界的缺陷。值会按多种模式缺失,一些特征被粗粒度化,导致重复行可能在标签上不一致,一些类别列携带大量层级,回归目标可能是重尾分布。一个见过数百万张此类表格的模型学会了处理这些缺陷而无需任何清理。
在每张人工表格上,模型将大部分行及其标签作为上下文进行学习,然后预测剩余行的标签,分类使用交叉熵损失,回归使用分位数损失。分类和回归分别作为独立的模型进行训练。与 TabICLv2 类似,训练分三个阶段进行。第一阶段(也是最长的阶段)使用最多 1,024 行和 100 列的表格,教模型认识表格的样子。第二阶段将上下文从 400 行变化到 10,240 行,第三阶段将其扩展到 60,000 行,仍然最多 100 列。总体而言,Kumo Tabular-Small/Medium/Large 大约分别见了 35/71/137 百万张人工表格。
NVIDIA 将很快发布训练配方和人工数据生成器。
NVIDIA 在统一的单 RTX 6000 Pro 评估配置下,将三种规模的 Kumo Tabular 以默认设置在完整的 TabArena 排行榜上进行了评测,基准对手包括调优后的梯度提升树、AutoGluon 以及最新的表格基础模型。Kumo Tabular 以 1950 的 ELO 总分排名第一,且运行速度比 LimiX-2 快 17 倍。在三种模型规模下,Kumo Tabular 在准确率-效率帕累托前沿上均建立了新的业界最佳水平:
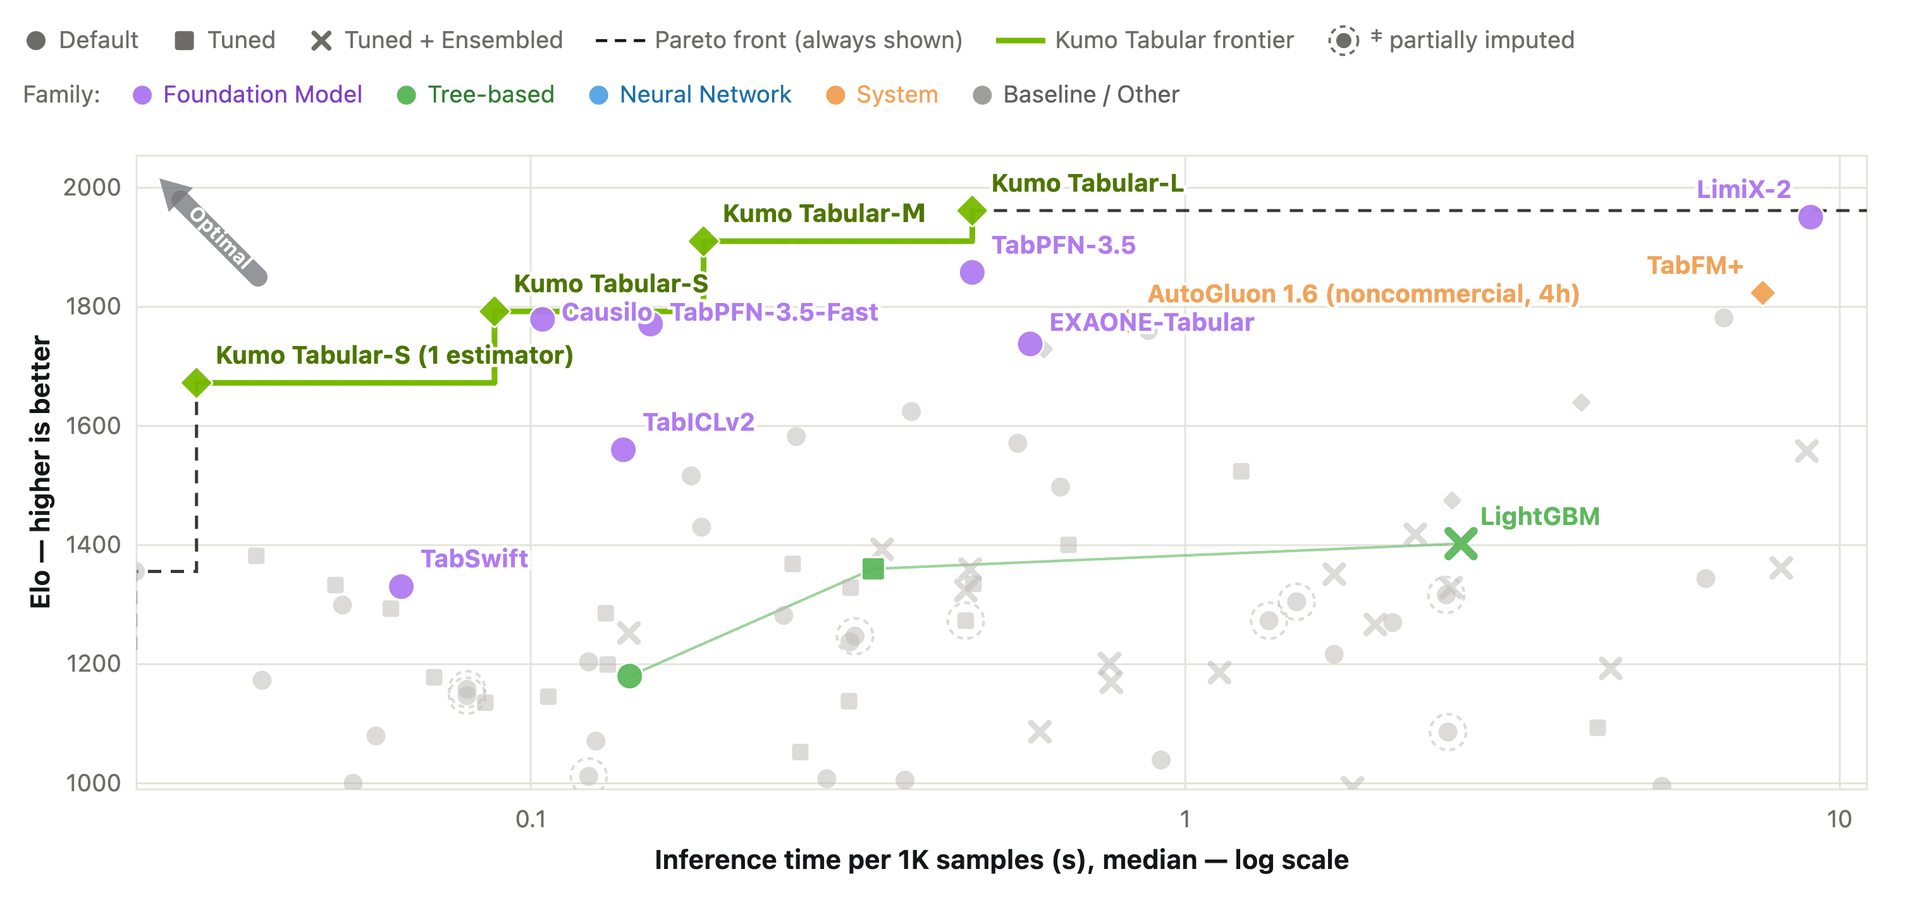
NVIDIA 还在 BeyondArena、TALENT 和 ScoringBench 上对 Kumo Tabular 进行了评估。在 BeyondArena 上,Kumo Tabular 达到 1418 的 ELO,Improvability 分数为 7.78%,位居排行榜首位。在 TALENT 上,它在分类准确率、分类对数损失和回归 RMSE 上均取得总体排名第一,平均排名分别为 6.67、3.98 和 4.22。在 ScoringBench(预测分布基准测试)上,Kumo Tabular-Large 和 Medium 分别排名第一和第二。
Kumo Tabular 仅适用于数值列和类别列,而文本、图像或时间戳可以通过内置的预处理方法转化为特征。单次前向传播最多覆盖 10 个类别,NVIDIA 通过纠错输出码(error-correcting output codes)将类别扩展到任意数量。当表格远超出训练范围,或查询行与上下文行来自不同分布时,准确率可能会下降。因此,与任何预测模型一样,在部署前请在自己的留出数据上验证准确率和校准情况。
Kumo Tabular 通过 NVIDIA 新发布的 GPU 原生库 structured-data-models 运行。该库在首次使用时从 Hub 下载权重,并提供评估中所用的预处理、集成和多类别处理。以下代码展示了从 pandas.DataFrame 到预测所需的全部分工作:
import sdm  # structured-data-models

# Tensorize tabular data:
table = sdm.TableTensor.from_pandas(pd.load_csv(...), device="cuda")
na_mask = table["target"].isnan()

model = sdm.models.KumoTabular(device="cuda")
pred = model(
    # In-context examples (features/targets):
    x_context=table[~na_mask].drop_columns("target"),
    y_context=table[~na_mask, "target"],
    # Prediction examples (features):
    x_query=table[na_mask].drop_column("target"),
)
Kumo Tabular 基于 OpenMDW 许可证协议 1.1 版发布。NVIDIA 认为可信 AI 是一项共同责任,并已建立政策和实践来支持广泛的 AI 应用开发。当根据服务条款下载或使用时,开发者应与其支持的模型团队合作,确保该模型满足相关行业和用例的要求,并应对不可预见的产品滥用。请在此处报告模型质量、风险、安全漏洞或 NVIDIA AI 相关问题。
Model Code: https://github.com/NVIDIA/structured-data-models
Model Weights: https://huggingface.co/nvidia/Kumo-Tabular
感谢 David Holzmüller 为 Kumo Tabular 贡献了重要的想法和消融实验。感谢 Vignesh Kothapalli 在实习期间对 Kumo Tabular 提供的帮助。


