
8.0
热点
AI SCORE
技术实践2026-09-29 21:07
MCP Agents的源码级验证:来源感知验证方法
Hugging Face Blog#MCP#Agent#HuggingFace
Editor brief · 编辑速览
Hugging Face提出MCP agents需要区分信息来源与事实本身,设计来源感知验证机制以提升agent可靠性。
我们的最新论文 ProvenanceGuard: Source-Aware Factuality Verification for MCP-Based LLM Agents(可在 Hugging Face 阅读,或暂时在 arXiv 阅读)正是为了填补这一空白。我们关注的一种失败模式称之为跨来源混淆(cross-source conflation):某个论断在证据的某处为真,但被错误地归因到了另一个来源。忽略来源的验证器可能会通过它,因为该事实在证据池中确实存在。而关注来源的验证器则不会。
以一个客服 Agent 为例,它回复道:"根据账户记录,此套餐包含 30 天退款期限。"退款期限可能是真实存在的,但出现在政策文档中,而非回答中指向的账户记录里。将两者混在一起,该论断看起来是成立的。将它们分开来看,归因就是错误的——在对数据敏感的场景下,错误的归因和错误的事实一样具有危害性。同样的模式也出现在临床 Agent 中:来自患者病史工具的患者特异性用药细节,一旦在回答中被呈现为来自医学文献的发现,就产生了误导。
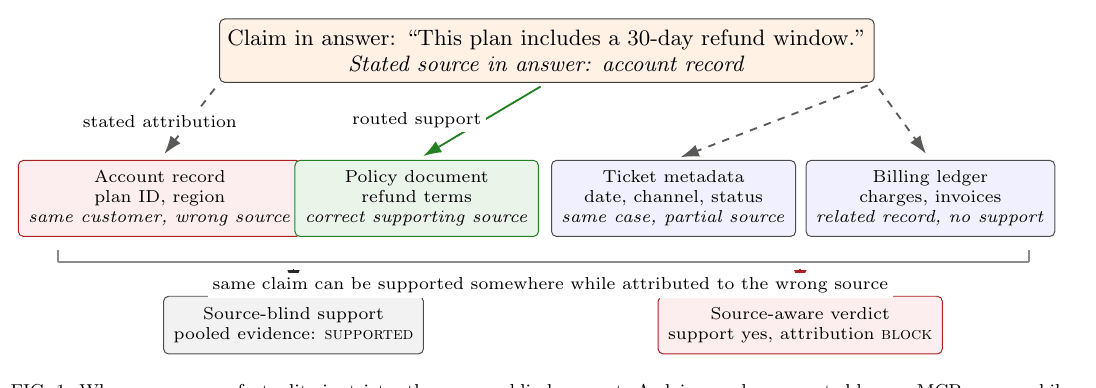
一条论断可以由某个 MCP 来源所支持,而回答却将其归因于另一个来源。忽略来源的评分在混合证据中看到了支持从而通过;ProvenanceGuard 则分别检查支持性来源是否与回答所声称或暗示的来源一致。来源:论文图 1。
这就是为什么忠诚度评分(faithfulness scores)虽然有用,但对 MCP Agent 而言远远不够。一条回答携带着出处,有时是显式的("根据账户记录"),有时是隐式的。ProvenanceGuard 将论断与来源之间的这种联系保留下来,供后续审查。
ProvenanceGuard 是一个后置生成验证层,运行在黑盒 MCP Agent 上方。它在 Agent 生成回答之后运行,不会将证据压缩为一个匿名的上下文,而是将来源身份贯穿整个流程。它读取捕获到的 MCP 追踪记录,包括工具输出及其来源 ID,无需对 Agent 进行重训练。然后它依次执行五个步骤:将回答分解为具体论断、为每条论断找到最相关的来源、检查该来源是否实际支持该论断、将该来源与回答所指名或暗示的来源进行比对,最终输出每条论断的来源裁定以及全局的回答级允许或阻止决策。
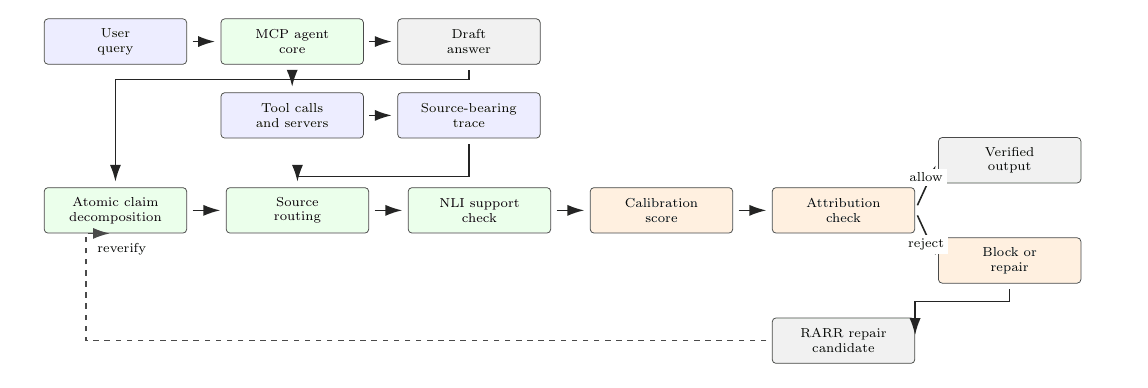
验证流程。来源身份在分解、路由、支持评分、归因检查和修复过程中得以保留,而非被混合。被阻止的回答可以经过 RARR 风格的修复后重新验证。来源:论文图 2。
有几个设计选择值得特别说明。在论文的实验中,我们使用了本地模型,以便在受控的离线环境中处理捕获的追踪:MiniLM 帮助找到相关来源,DeBERTa NLI 验证器模型检查该来源是否支持该论断,本地语言模型帮助将回答分解为论断。验证器还会仔细检查字面量值:来源中不存在的数字、日期或标识符不能仅因句子听起来合理就通过。经过校准的决策步骤将这些信号结合起来。如果一条回答被阻止,RARR 风格的修复步骤可以尝试基于来源的修订或安全降级方案,然后验证器会再次检查。
上述提到的模型是我们用于评估的配置,而非 ProvenanceGuard 的必要条件。同样的论断、来源和决策步骤可以适配到托管模型上,适用于偏好云服务的团队;新配置需要自行测试和校准。我们报告的结果来自本地配置。其保守的决策策略适合数据敏感的审查场景——在这样的场景中,用对来源比快速给出回答更重要。
我们在来自医疗 Agent 的回答上测试了 ProvenanceGuard,该 Agent 使用了患者记录、研究文章和其他工具。这为我们提供了 281 条真实追踪记录用于研究。医学领域是一个有用的测试场景,因为来自患者记录的事实和来自一般研究的事实不能被视为同一来源。当 Agent 保留其工具输出和来源 ID 的记录时,该方法也可用于其他领域。在主要测试中,人类专家检查了 361 条来自 40 个回答的论断,这些回答从开发系统的数据中预留出来。
最直接的结果是:专家表示有 139 条论断不应通过,而 ProvenanceGuard 捕获了其中 138 条。它漏掉了一条。同时它还拦下了 67 条专家认为有支持的论断,将它们送去审查或修复。这反映了我们测试的谨慎设置:它宁可让一些有支持的论断接受二次检查,也不愿让没有支持的论断通过。对于有明确来源的论断,在这项测试中它选对来源的概率约为 86%。
我们在相同的论断上运行了其他四种支持检查器。ProvenanceGuard 在论文衡量指标上得分最高——该指标衡量系统在阻止应被阻止的论断同时避免不必要阻止的综合表现。其他检查器在此比较中没有告诉我们每个论断由哪个工具输出支持。ProvenanceGuard 记录了这一联系,因此审查者可以看到每个论断检查了哪个来源以及产生的决策。
在相同的预留论断包上的二元支持指标。ProvenanceGuard 在阻止能力上与忽略来源的基线持平或更优,同时还能产出每条论断的来源裁定。来源:论文摘要及表 III。
在一项单独的、更难的测试中(包含多个相似来源),ProvenanceGuard 在决定阻止哪些论断上取得了 0.846 的 F1 分数,但在正确识别确切来源方面只有 50.3% 的准确率。在相似来源之间做出区分仍然是需要改进的重要领域。
我们还进行了一项聚焦于错误归因的受控测试:在 50 个案例中,我们更改了命名的来源但保留了支持性证据完整。ProvenanceGuard 捕获了全部 50 次来源篡改。这表明它能够检测出明确的来源错误,而更难的测试则展示了在多个合理来源中进行选择的挑战。
阻止只有在有处理被阻止回答的方案时才有意义。接入 RARR 风格的修复循环后,完整追踪运行解决了全部 173 条被阻止的回答,其中 144 条最终以降级文本收尾而非实质性重写——这是系统选择回避无法验证的回答,而非编造一个。在重建的多来源测试追踪上,一次新的修复运行解决了全部 59 条初始被阻止的回答,仅有两条最终降级。作为离线门控,其开销很小,在报告的本地配置上每条回答约需半秒,其中 NLI 和路由调用本身在几十毫秒量级。
随着 Agent 从单段落 RAG 过渡到多工具 MCP 设置,一个事实在实际上来自哪个来源不再是脚注,而成为事实性的核心组成部分。ProvenanceGuard 使这种来源关联在每条论断层面变得可见。对 Multiverse Computing 而言,这意味着一种在保持敏感追踪于受控环境中的同时检查现有 Agent 的方式。医学研究是一个用例;同样的方法可以适配到任何 Agent 的追踪保留了其工具和来源的场景。
这种适配已经在 NVIDIA NVFlow 中可见,它为其金融 Agent 合并了一个可选的接地验证阶段。它根据 Agent 检索的 SEC 摘录检查已完成的回答,并保存独立决策,不改变原始 rollout 或训练数据。NVFlow 的贡献使用了 ProvenanceGuard 的来源感知验证方法;上文讨论的修复循环属于更广泛的研究系统。
ProvenanceGuard 还在 2026 年 UC Berkeley 举行的 Agentic AI Summit 2026 上以海报形式展示。
想要获取完整的技术细节,包括路由和 NLI 的推导、校准消融实验、多来源压力测试切片以及完整的结果表格?请在 Hugging Face 上阅读完整论文,或联系我们的团队,讨论将来源感知验证应用到你自己的 Agent 上。