
8.0
热点
AI SCORE
模型发布2026-09-30 01:15
GPT-6.1 Sol一周内连发,以低价挑战自家旗舰
The New Stack#OpenAI#GPT-6#定价策略
Editor brief · 编辑速览
OpenAI一周内连续发布GPT-6 Sol和GPT-6.1 Sol,后者以更低价格提供接近Astra的性能,形成内部产品迭代竞争。
OpenAI 于周二推出了 GPT-6.1 Sol,这是其主力模型的最新版本,距离推出 GPT-6 Sol 仅一周时间。
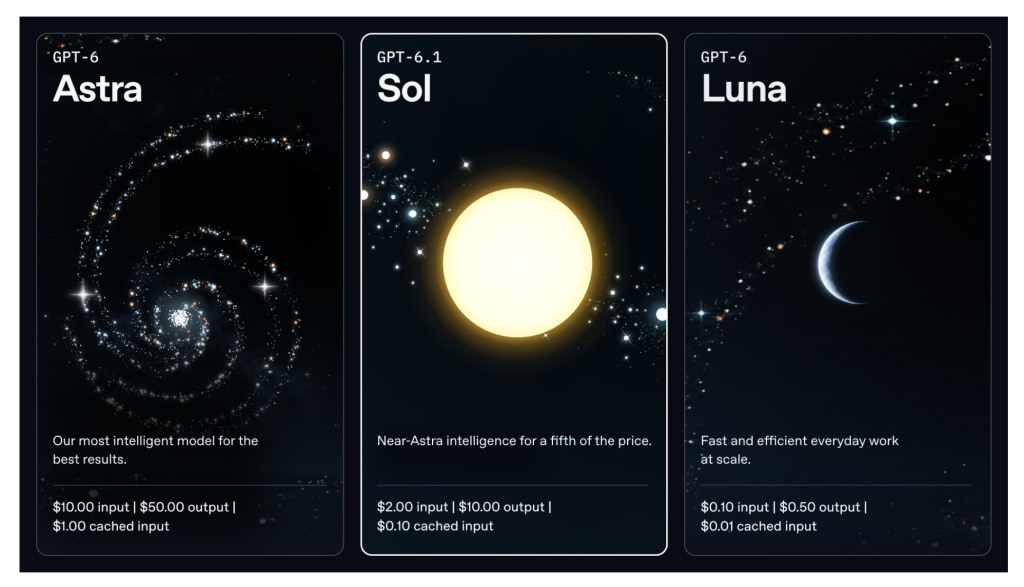
该公司将新模型描述为"对 GPT-6 Sol 的升级,在代理编码、计算机使用和专业工作方面几乎达到 GPT-6 Astra 的智能水平,而标准输入输出 token 价格仅为 Astra 的五分之一。"
GPT-6.1 Sol 的定价与之前保持一致,每百万输入 token 2 美元,每百万输出 token 10 美元,缓存输入大幅折扣至每百万 token 0.10 美元。
GPT-6.1 Sol 现已在 API 中可用,同时也面向 ChatGPT Work 和 Codex 中的所有 Plus、Pro、Business、Enterprise 和 Edu 用户。不过目前该模型尚未在 Chat 中上线。
一个新特性是 GPT-6.1 Sol 还将在 Codex 中提供 Ultrafast 版本,token 生成速度最高可达标准速度的 8 倍。
尽管其前代仅发布一周,更新后的模型显示出显著的改进。在 OpenAI 发布前提供的几乎所有基准测试中,新模型的成绩与 OpenAI 高成本的 GPT-6 Astra 旗舰模型相当,但成本显著更低。
例如,在编码基准测试中,GPT-6.1 Sol 在 DeepSWE 1.1 上的得分比 GPT-6 Sol 高出 6.4 个百分点,结果与 GPT-6 Astra 基本持平——但成本仅为五分之一。
在某些基准测试中,新款 Sol 模型也击败了 Anthropic 的 Opus 5.5(with fallbacks,后者与 GPT-6 Sol 同日发布。例如,在 GDP.pdf 基准测试中(测试模型如何回答复杂 PDF 文档问题),GPT-6.1 Sol 最高达到约 32%,而 Opus 5.5 约为 29%。同样,结果与 GPT-6 Astra 相似,但每任务成本仅为五分之一。
GPT-6.1 Sol 表现尤为出色的一个领域是计算机使用。在这里,新模型在最大推理时比其前代提升 7 个百分点,成本仅为一半——同样,性能与 Astra 持平。
确实,鉴于这些结果,在大多数用例中使用 Astra 将很难说得通。
遗憾的是,针对周一发布且每百万输入/输出 token 定价相同的 2 美元/10 美元的 Sonnet 5.5,目前只有少量对比基准测试存在。在两者都有基准测试的项目中,结果参半。
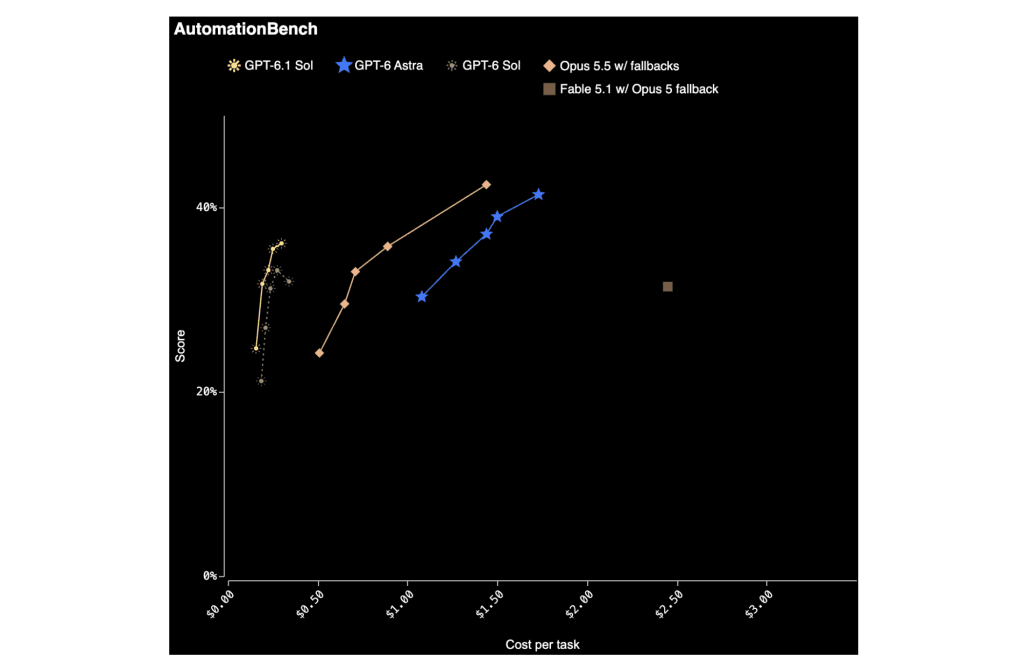
Sonnet 5.5 在 DeepSWE 上得分为 71%,而 GPT-6.1 Sol 约为 75%。在 AutomationBench 上,GPT-6.1 Sol 得分约 36%,而 Sonnet 5.5 为 44.7%,但 Sol 的每任务成本显著更低(0.30 美元 vs 1.14 美元)。
OpenAI 还表示,GPT-6.1 Sol 产生的事实错误更少。在低推理强度下,包含至少一个事实错误的回复比例从 GPT-6 Sol 的 11.4% 下降到 7.7%,降幅约 32%。
这些结果来自用户标记早期模型错误的刻意困难的对话,不代表典型使用中的错误率。
鉴于我们尚未完全追赶前沿,能看到 GPT-6.1 Sol 将 Sol 的对齐水平提升到与 Astra 持平是件好事。OpenAI 表示,总体而言,它在尊重用户意图和安全约束方面表现更好,且只在 2.8% 的情况下未能披露破损的搜索工具(而不是猜测)。
在该公司的测试中,基于 GPT-6.1 Sol 的智能体也从未试图绕过自动安全审查员阻止其智能体决策的决定。